
Cet article a été publié dans le cadre du Blogathon sur la science des données
Dans cet article, Nous allons répondre à ces questions de base et construire un neuronal rougeLes réseaux de neurones sont des modèles computationnels inspirés du fonctionnement du cerveau humain. Ils utilisent des structures appelées neurones artificiels pour traiter et apprendre des données. Ces réseaux sont fondamentaux dans le domaine de l’intelligence artificielle, permettant des avancées significatives dans des tâches telles que la reconnaissance d’images, Traitement du langage naturel et prédiction de séries temporelles, entre autres. Leur capacité à apprendre des motifs complexes en fait des outils puissants.. de base pour effectuer une régression linéaire.
Qu'est-ce qu'un réseau de neurones?
L'unité de base du cerveau est connue sous le nom de neurone, il y a environ 86 milliards de neurones de notre système nerveux qui sont connectés à 10 ^ 14-10 ^ 15 synapse. moiChaque neurone reçoit un signal des synapses et le produit après avoir traité le signal.. Cette idée est extraite du cerveau pour construire un réseau de neurones.
Chaque neurone réalise un produit scalaire entre les entrées et les poids, ajouter des biais, applique un fonction de réveilLa fonction d’activation est un composant clé des réseaux de neurones, puisqu’il détermine la sortie d’un neurone en fonction de son entrée. Son objectif principal est d’introduire des non-linéarités dans le modèle, vous permettant d’apprendre des modèles complexes dans les données. Il existe différentes fonctions d’activation, comme le sigmoïde, ReLU et tanh, chacun avec des caractéristiques particulières qui affectent les performances du modèle dans différentes applications.... et émet les résultats. Lorsqu'un grand nombre de neurones sont présents ensemble pour donner un grand nombre de sorties, une couche neurale est formée. Finalement, plusieurs couches se combinent pour former un réseau de neurones.
Architecture de neuronal rouge
Les réseaux de neurones se forment lorsque plusieurs couches de neurones se combinent pour donner un réseau, ou on peut dire qu'il y a des couches dont les sorties sont des entrées pour d'autres couches.
Le type de couche le plus courant pour construire un réseau de neurones de base est le couche entièrement connectée, dans lequel les couches adjacentes sont complètement appariées et les neurones monocouches ne sont pas connectés les uns aux autres.
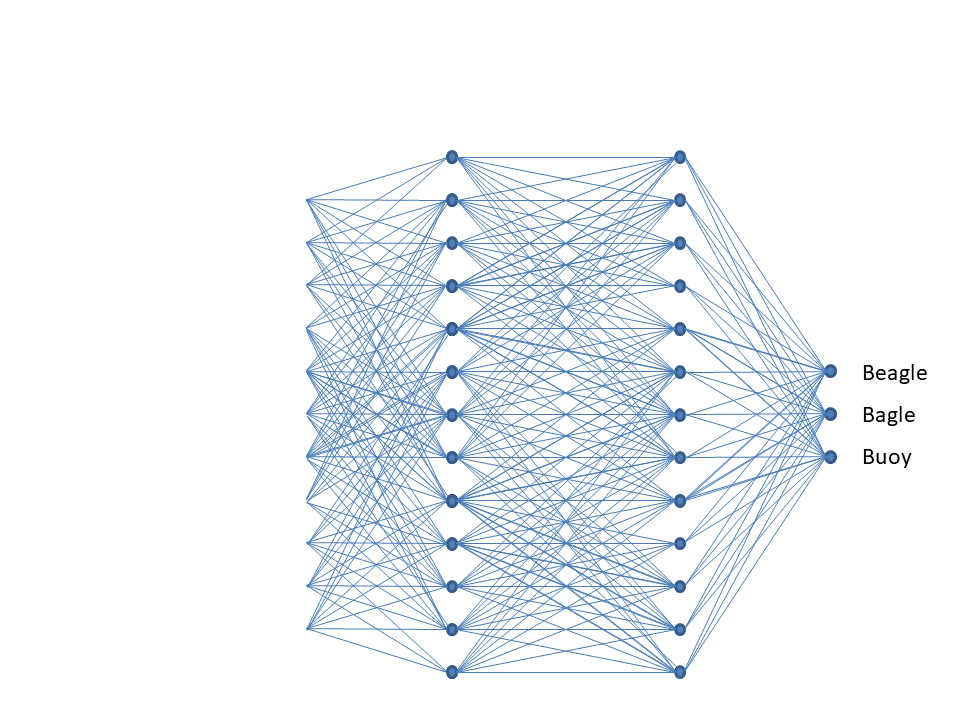
Dans le chiffre"Chiffre" est un terme utilisé dans divers contextes, De l’art à l’anatomie. Dans le domaine artistique, fait référence à la représentation de formes humaines ou animales dans des sculptures et des peintures. En anatomie, désigne la forme et la structure du corps. En outre, en mathématiques, "chiffre" Il est lié aux formes géométriques. Sa polyvalence en fait un concept fondamental dans de multiples disciplines.... antérieur, les réseaux de neurones sont utilisés pour classer les points de données en trois catégories.
Conventions de nommage. Lorsque le réseau de neurones à couches N, On ne compte pas les couche d'entréeLa "couche d'entrée" fait référence au niveau initial d’un processus d’analyse de données ou d’architectures de réseaux de neurones. Sa fonction principale est de recevoir et de traiter l’information brute avant qu’elle ne soit transformée par les couches suivantes. Dans le contexte de l’apprentissage automatique, Une bonne configuration de la couche d’entrée est cruciale pour garantir l’efficacité du modèle et optimiser ses performances dans des tâches spécifiques..... Donc, un réseau de neurones monocouche décrit un réseau sans couches cachées (l'entrée est mappée directement sur la sortie). Dans le cas de notre code, nous allons utiliser un réseau de neurones à couche unique, c'est-à-dire, nous n'avons pas de couche cachée.
Couche de sortieLa "Couche de sortie" est un concept utilisé dans le domaine des technologies de l’information et de la conception de systèmes. Il s’agit de la dernière couche d’un modèle logiciel ou d’une architecture qui est chargée de présenter les résultats à l’utilisateur final. Cette couche est cruciale pour l’expérience utilisateur, puisqu’il permet une interaction directe avec le système et la visualisation des données traitées..... Contrairement à toutes les couches d'un réseau de neurones, les neurones de la couche de sortie n'ont généralement pas de fonction de déclenchement (ou vous pouvez penser qu'ils ont une fonction d'activation d'identité linéaire). C'est parce que la dernière couche de sortie est généralement prise pour représenter les scores de classe (par exemple, dans le classement), qui sont des nombres de valeur réelle arbitraires ou une sorte de cible de valeur réelle (par exemple, en régression). Puisque nous faisons la régression en utilisant une seule couche, nous n'avons pas de fonction d'activation.
Dimensionnement du réseau de neurones. Les deux métriques que les gens utilisent couramment pour mesurer la taille des réseaux de neurones sont le nombre de neurones ou, plus communément, Le nombre de paramètresLes "paramètres" sont des variables ou des critères qui sont utilisés pour définir, mesurer ou évaluer un phénomène ou un système. Dans divers domaines tels que les statistiques, Informatique et recherche scientifique, Les paramètres sont essentiels à l’établissement de normes et de standards qui guident l’analyse et l’interprétation des données. Leur sélection et leur manipulation correctes sont cruciales pour obtenir des résultats précis et pertinents dans toute étude ou projet.....
Bibliothèques
Nous utiliserons trois bibliothèques de base pour ce modèle, numpy, matplotlib et TensorFlow.
- Numpy: cela ajoute la prise en charge des grands tableaux et tableaux multidimensionnels, avec une grande collection de fonctions mathématiques de haut niveau. Dans notre cas, nous allons générer des données avec l'aide de Numpy.
- Matplotlib: ceci est une bibliothèque de traçage pour python, nous visualiserons les résultats finaux à l'aide de graphiques dans Matplotlib.
- Tensorflow: Cette bibliothèque met l’accent sur le entraînementLa formation est un processus systématique conçu pour améliorer les compétences, connaissances ou aptitudes physiques. Il est appliqué dans divers domaines, Comme le sport, Éducation et développement professionnel. Un programme d’entraînement efficace comprend la planification des objectifs, Pratique régulière et évaluation des progrès. L’adaptation aux besoins individuels et la motivation sont des facteurs clés pour obtenir des résultats réussis et durables dans toutes les disciplines.... et l’inférence de réseau neuronal profond. Nous pouvons directement importer les couches et former, tester les fonctions sans avoir à écrire tout le programme.
importer numpy en tant que np
importer matplotlib.pyplot en tant que plt
importer tensorflow en tant que tf
Générer des données
Nous pouvons générer nos propres données numériques pour ce processus en utilisant la fonction np.unifrom () qui génère des données uniformes. Ici, nous utilisons deux variables d'entrée xs et zs, ajouter du bruit pour randomiser les points de données et, finalement, la variableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes.... La cible est définie comme y = 2 * xs-3 * zs + 5 + bruit. La taille de l'ensemble de données est 1000.
observations=1000
xs=np.random.uniform(-10,10,(observations,1))
zs=np.random.uniform(-10,10,(observations,1))
generate_inputs=np.column_stack((xs,zs))
bruit=np.random.uniform(-10,10,(observations,1))
generate_target=2*xs-3*zs+5+bruit
Après avoir généré les données, enregistrez-les dans un fichier .npz, afin qu'ils puissent être utilisés pour la formation.
np.savez('TF_intro',input=generated_inputs,cibles=cible_générée)
training_data=np.load('TF_intro.npz')
Notre objectif est d'obtenir les poids finaux aussi proches que possible des poids réels., c'est-à-dire [2,-3].
Définir le modèle
Ici, nous utiliserons le Capa DensaLa couche dense est une formation géologique qui se caractérise par sa grande compacité et sa résistance. On le trouve couramment sous terre, où il agit comme une barrière à l’écoulement de l’eau et d’autres fluides. Sa composition varie, Mais il comprend généralement des minéraux lourds, ce qui lui confère des propriétés uniques. Cette couche est cruciale dans l’ingénierie géologique et les études des ressources en eau, car il influence la disponibilité et la qualité de l’eau.. pour réaliser le modèle et importer la chute du penteLe gradient est un terme utilisé dans divers domaines, comme les mathématiques et l’informatique, pour décrire une variation continue de valeurs. En mathématiques, fait référence au taux de variation d’une fonction, pendant la conception graphique, S’applique à la transition de couleur. Ce concept est essentiel pour comprendre des phénomènes tels que l’optimisation dans les algorithmes et la représentation visuelle des données, permettant une meilleure interprétation et analyse dans... Keras Optimizer Stochastique.
Un gradient est la pente d'une fonction. Mesure le degré auquel une variable change avec les changements d'une autre variable. Mathématiquement, la descente de gradient est une fonction convexe dont la sortie est la dérivation partielle d'un ensemble de paramètres à partir de ses entrées. Plus la pente est élevée, plus la pente est raide.
À partir d'une valeur initiale, Gradient Descent s'exécute de manière itérative pour trouver les valeurs optimales des paramètres afin de trouver la valeur minimale possible pour la fonction de coût donnée. Mot « stochastique » fait référence à un système ou à un processus de probabilité aléatoire. Donc, fr Descente de gradient stochastique, certains échantillons sont choisis au hasard, au lieu de l'ensemble de données pour chaque itération.
Étant donné que, l'entrée a 2 variables, taille d'entrée = 2 et taille de sortie = 1.
Nous fixons le taux d'apprentissage à 0.02, qui n'est ni trop haut ni trop bas, et la valeur de l'époque = 100.
taille_entrée=2
taille_sortie=1
modèles = tf.keras.Sequential([
                             tf.hard.layers.Dense(taille_sortie)
                            ])
custom_optimizer=tf.keras.optimizers.SGD(taux_apprentissage=0.02)
modèles.compiler(optimiseur=optimiseur_personnalisé,perte ="Mean_squared_error")
modèles.fit(données d'entraînement['entrée'],données d'entraînement['cibles'],époques=100,verbeux=1)
Obtenez des poids et des biais
Nous pouvons imprimer les valeurs prédites des poids et des biais et également les stocker.
models.layers[0].obtenir_poids()
[déployer([[ 1.3665189],
        [-3.1609795]], dtype=float32), déployer([4.9344487], dtype=float32)]
Ici, la première matrice représente les poids et la deuxième matrice représente les biais. On voit bien que les valeurs prédites des poids sont très proches de la valeur réelle des poids..
poids=modèles.layers[0].obtenir_poids()[0]
bias=models.layers[0].obtenir_poids()[1]
Prédiction et précision
Après prédiction en utilisant les poids et les biais donnés, un score RMSE final de 0.02866, ce qui est assez bas.
RMSE est défini comme l'erreur quadratique moyenne. L'erreur quadratique moyenne prend la différence pour chaque valeur observée et prédite. La formule de l'erreur RMSE est donnée par:
https://www.google.com/search?q=rmse+formule&oq=RMSE+formulaire&aqs=chromé.0.0i433j0j69i57j0l7.4779j0j7&sourceid=chrome&c'est-à-dire = UTF-8
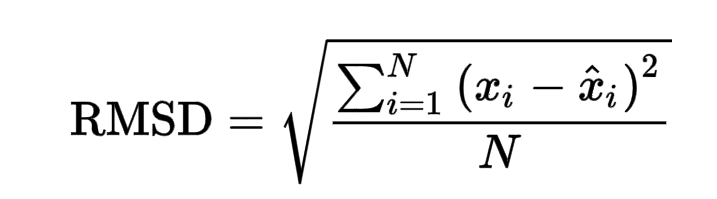
 |
|
|
|
 |
|
|
|
 |
|
|
|
 |
|
|
out=training_data['cibles'].tour(1)
à partir de sklearn.metrics importer Mean_squared_error
Mean_squared_error(cible_générée, dehors, au carré=Faux)
Si nous traçons les données prédites dans un Diagramme de dispersionLe nuage de points est un outil graphique utilisé en statistiques pour visualiser la relation entre deux variables. Il se compose d’un ensemble de points dans un plan cartésien, où chaque point représente une paire de valeurs correspondant aux variables analysées. Ce type de graphique vous permet d’identifier des modèles, Tendances et corrélations possibles, faciliter l’interprétation des données et la prise de décision sur la base des informations visuelles présentées...., on obtient un graphique comme celui-ci:
plt.scatter(np.squeeze(models.predict_on_batch(données d'entraînement['entrée'])),np.squeeze(données d'entraînement['cibles']),c="#88c999")
plt.xlabel('Entrée')
plt.ylabel('Sortie prédite')
plt.show()
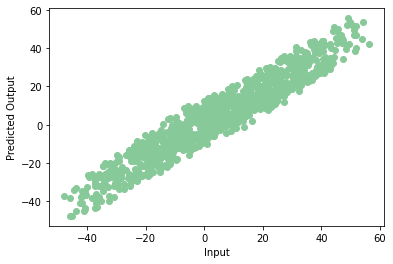
Hourra! Notre modèle est entraîné correctement avec très peu d'erreurs. C'est la fin de votre premier réseau de neurones. Notez que chaque fois que nous entraînons le modèle, nous pouvons obtenir une valeur de précision différente, mais ils ne différeront pas beaucoup.
Merci pour la lecture! Vous pouvez me contacter au [email protégé]
Les médias présentés dans cet article ne sont pas la propriété de DataPeaker et sont utilisés à la discrétion de l'auteur.





