
introduction
Analyse et cartographie d'images dans Earth Engine en utilisant NDVI ", est maintenant un autre article sur l'analyse d'image à nouveau. Contrairement à l'article précédent, cet article analyse général l'analyse d'image, non Image satellite une analyse. L'objectif de cette discussion est de détecter si deux produits sont identiques ou non.. Chacun des deux produits a des noms d'image et de texte. Si la paire de produits a des images ou des noms de texte similaires ou identiques, cela signifie que les deux produits sont les mêmes. Les données proviennent d'un concours organisé à Kaggle.
Il y a 4 packages de base utilisés dans ce script: NumPy, pandas, matplotlib y seaborn. Il existe également d'autres packages spécifiques. « Image » charger et afficher des données d'image. « hachage d'image » calcule la similitude de deux images. « Fuzzywuzzy » détecte la similitude de deux textes. La « métrique » Le package calcule le score de précision de la vraie étiquette et de l'étiquette prédite.
# importer des packages
importer numpy en tant que np
importer des pandas au format pd
importer matplotlib.pyplot en tant que plt
importer seaborn comme sns
à partir de l'image d'importation PIL
importer le hachage d'image
de fuzzywuzzy importer du fuzz
depuis sklearn.tree importer DecisionTreeClassifier
à partir des métriques d'importation sklearn
Similitude d'image
La similitude des deux images est détectée par le package « hachage d'image ». Si deux images sont identiques ou presque identiques, la différence de hachage d'image sera 0. Deux images sont plus similaires si la différence de hachage d'image est plus proche de 0.
Comparer la similitude de deux images avec imagehash consiste à 5 Pas. (1) Les images sont converties en niveaux de gris. (2) Les tailles d'image sont réduites pour être plus petites, par exemple, une 8 × 8 pixels par défaut. (3) La valeur moyenne de la 64 pixels. (4) Il est vérifié si le 64 les pixels sont supérieurs à la valeur moyenne. À présent, chacun de 64 pixels a une valeur booléenne de vrai ou faux. (5) La différence entre les images est le nombre de valeurs différentes entre les deux images. Regardez l'illustration suivante.
Image_1 (moyenne: 71,96875)
|
48 |
20 |
34 |
40 |
40 |
32 |
30 |
32 |
|
34 |
210 |
38 |
50 |
42 |
41 |
230 |
40 |
|
47 |
230 |
33 |
44 |
34 |
50 |
245 |
50 |
|
43 |
230 |
46 |
50 |
36 |
34 |
250 |
30 |
|
30 |
200 |
190 |
38 |
41 |
240 |
39 |
39 |
|
38 |
7 |
200 |
210 |
220 |
240 |
50 |
48 |
|
48 |
8 |
45 |
43 |
47 |
37 |
37 |
47 |
|
10 |
8 |
6 |
5 |
6 |
6 |
5 |
5 |
|
FAUX |
FAUX |
FAUX |
FAUX |
FAUX |
FAUX |
FAUX |
FAUX |
|
FAUX |
VRAI |
FAUX |
FAUX |
FAUX |
FAUX |
VRAI |
FAUX |
|
FAUX |
VRAI |
FAUX |
FAUX |
FAUX |
FAUX |
VRAI |
FAUX |
|
FAUX |
VRAI |
FAUX |
FAUX |
FAUX |
FAUX |
VRAI |
FAUX |
|
FAUX |
VRAI |
VRAI |
FAUX |
FAUX |
VRAI |
FAUX |
FAUX |
|
FAUX |
FAUX |
VRAI |
VRAI |
VRAI |
VRAI |
FAUX |
FAUX |
|
FAUX |
FAUX |
FAUX |
FAUX |
FAUX |
FAUX |
FAUX |
FAUX |
|
FAUX |
FAUX |
FAUX |
FAUX |
FAUX |
FAUX |
FAUX |
FAUX |
Image_2 (moyenne: 78,4375)
|
41 |
20 |
39 |
43 |
34 |
39 |
30 |
32 |
|
35 |
195 |
44 |
46 |
35 |
48 |
232 |
40 |
|
30 |
243 |
38 |
31 |
34 |
46 |
213 |
50 |
|
49 |
227 |
44 |
33 |
35 |
224 |
230 |
30 |
|
46 |
203 |
225 |
44 |
46 |
181 |
184 |
40 |
|
38 |
241 |
247 |
220 |
228 |
210 |
36 |
38 |
|
42 |
8 |
35 |
39 |
47 |
31 |
41 |
21 |
|
3 |
12 |
10 |
18 |
24 |
21 |
6 |
17 |
|
FAUX |
FAUX |
FAUX |
FAUX |
FAUX |
FAUX |
FAUX |
FAUX |
|
FAUX |
VRAI |
FAUX |
FAUX |
FAUX |
FAUX |
VRAI |
FAUX |
|
FAUX |
VRAI |
FAUX |
FAUX |
FAUX |
FAUX |
VRAI |
FAUX |
|
FAUX |
VRAI |
FAUX |
FAUX |
FAUX |
VRAI |
VRAI |
FAUX |
|
FAUX |
VRAI |
VRAI |
FAUX |
FAUX |
VRAI |
VRAI |
FAUX |
|
FAUX |
VRAI |
VRAI |
VRAI |
VRAI |
VRAI |
FAUX |
FAUX |
|
FAUX |
FAUX |
FAUX |
FAUX |
FAUX |
FAUX |
FAUX |
FAUX |
|
FAUX |
FAUX |
FAUX |
FAUX |
FAUX |
FAUX |
FAUX |
FAUX |
La différence d'image de hachage des deux images / au-dessus des matrices est 3. Cela signifie qu'il y a 3 pixels avec différentes valeurs booléennes. Les deux images sont relativement similaires.
Pour plus de clarté, Examinons le hachage d'image appliqué à ce qui suit 3 paires d'images. La première paire se compose de deux images égales et la différence entre les images est 0. La deuxième paire compare deux images similaires. La deuxième photo (image_b) c'est en fait une version modifiée de la première image (image_a). La différence entre les images est 6. La dernière paire montre la comparaison de deux images totalement différentes. La différence d'image de hachage est 30, qui est le plus éloigné de 0.
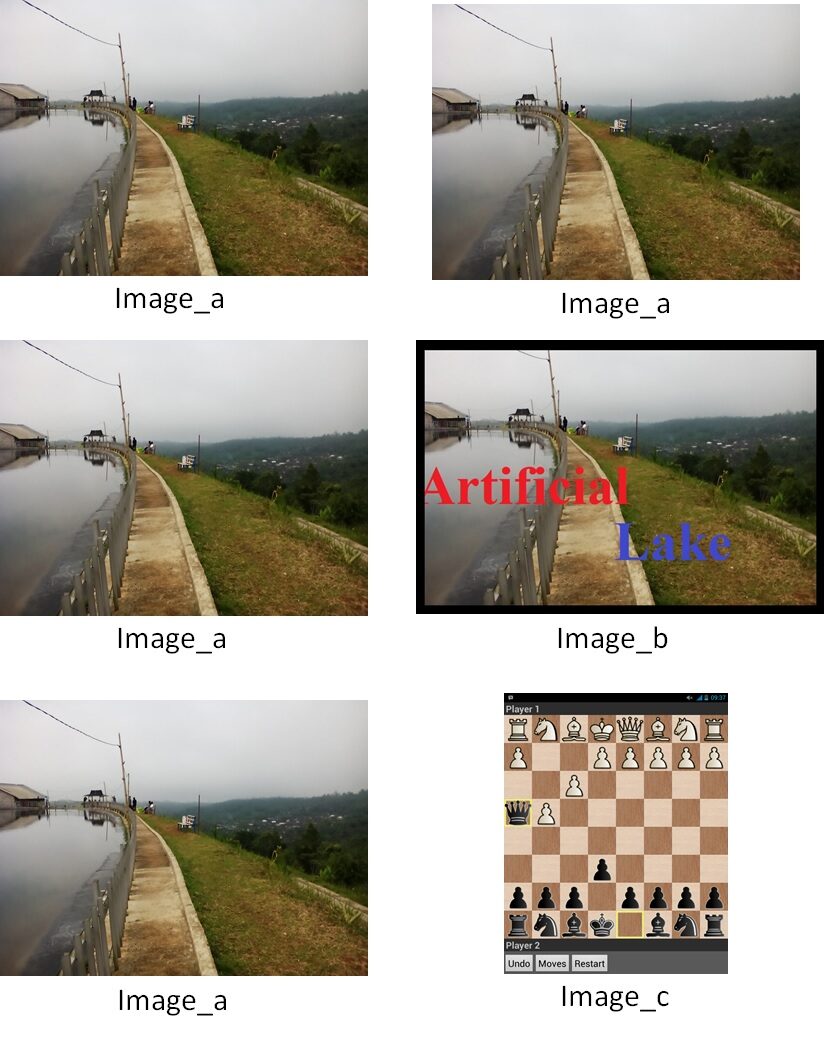
# Première paire
hash1 = imagehash.average_hash(Image.ouverte('D: /image_a.jpg'))
hash2 = imagehash.average_hash(Image.ouverte('D:/ image_a.jpg'))
diff = hachage1 - hachage2
imprimer(différence)
# 0
# Deuxième paire
hash1 = imagehash.average_hash(Image.ouverte('D: /image_a.jpg'))
hash2 = imagehash.average_hash(Image.ouverte('D:/ image_b.jpg'))
diff = hachage1 - hachage2
imprimer(différence)
# 6
# Troisième paire
hash1 = imagehash.average_hash(Image.ouverte('D: /image_a.jpg'))
hash2 = imagehash.average_hash(Image.ouverte('D:/ image_c.jpg'))
diff = hachage1 - hachage2
imprimer(différence)
# 30
Voici à quoi ressemble le hachage d'image moyen
>imagehash.average_hash(Image.ouverte('D:/image_a.jpg'))
déployer([[ Vrai,  Vrai,  Vrai,  Vrai,  Vrai,  Vrai,  Vrai,  Vrai],
       [ Vrai,  Vrai,  Vrai,  Vrai,  Vrai,  Vrai,  Vrai,  Vrai],
       [ Vrai,  Vrai,  Vrai,  Vrai,  Vrai,  Vrai,  Vrai,  Vrai],
       [Faux,  Vrai, Faux, Faux, Faux, Faux, Faux, Faux],
       [ Vrai,  Vrai, Faux, Faux, Faux, Faux, Faux, Faux],
       [Faux, Faux, Faux,  Vrai, Faux, Faux, Faux, Faux],
       [Faux, Faux, Faux,  Vrai, Faux, Faux, Faux, Faux],
       [Faux, Faux, Faux, Faux, Faux, Faux, Faux, Faux]])
>imagehash.average_hash(Image.ouverte('D:/image_b.jpg'))
déployer([[ Vrai,  Vrai,  Vrai,  Vrai,  Vrai,  Vrai,  Vrai,  Vrai],
       [ Vrai,  Vrai,  Vrai,  Vrai,  Vrai,  Vrai,  Vrai,  Vrai],
       [Faux,  Vrai,  Vrai,  Vrai,  Vrai, Faux, Faux, Faux],
       [ Vrai,  Vrai,  Vrai, Faux, Faux, Faux, Faux, Faux],
       [ Vrai,  Vrai, Faux, Faux, Faux, Faux, Faux, Faux],
       [Faux, Faux, Faux,  Vrai, Faux, Faux, Faux, Faux],
       [Faux, Faux, Faux,  Vrai, Faux, Faux, Faux, Faux],
       [Faux, Faux, Faux, Faux, Faux, Faux, Faux, Faux]])
>imagehash.average_hash(Image.ouverte('D:/image_c.png'))
déployer([[Faux, Faux, Faux, Faux, Faux, Faux, Faux, Faux],
       [ Vrai,  Vrai,  Vrai,  Vrai,  Vrai,  Vrai,  Vrai,  Vrai],
       [ Vrai,  Vrai,  Vrai,  Vrai,  Vrai,  Vrai,  Vrai,  Vrai],
       [ Vrai,  Vrai,  Vrai,  Vrai,  Vrai,  Vrai,  Vrai,  Vrai],
       [ Vrai,  Vrai,  Vrai,  Vrai,  Vrai,  Vrai,  Vrai,  Vrai],
       [ Vrai,  Vrai,  Vrai,  Vrai,  Vrai,  Vrai,  Vrai,  Vrai],
       [Faux, Faux, Faux, Faux,  Vrai, Faux, Faux, Faux],
       [Faux, Faux, Faux, Faux, Faux, Faux, Faux, Faux]])
Similitude de texte
La similitude du texte peut être évaluée à l'aide du traitement du langage naturel (PNL). Il y a 4 façons de comparer la similitude d'une paire de textes fournis par le package « floue ». La fonction de ce package renvoie une valeur entière de 0 une 100. La valeur la plus élevée signifie la similitude la plus élevée.
1. rapport.fuzz – est la comparaison la plus simple de textes. La valeur du fuzz.ratio de « t-shirt bleu » Oui « t-shirt bleu ». il est 95. Cela signifie que les deux textes sont similaires ou presque identiques, mais le point les rend un peu différents
de fuzzywuzzy importer du fuzz
rapport.fuzz('blue shirt','blue shirt.')
#95
La mesure est basée sur la distance de Levenshtein (nommé pour Vladimir Levenshtein). La distance de Levenshtein mesure la similitude de deux textes. Mesurer le nombre minimum de modifications, comment insérer, supprimer ou remplacer un texte dans un autre texte. Le texte « T-shirt bleu » ne nécessite qu'une seule modification pour être « t-shirt bleu ». Vous n'avez besoin que d'un seul point pour être le même. Pourtant, la distance de Levenshtein est « 1 ». La relation floue est calculée avec cette équation (longueur (une) + longueur (b) – lev) / ((longueur (une) + longueur (b), où len (une) y len (b) sont les longueurs du premier et du deuxième texte, et lev est la distance de Levenshtein La relation est (10 + 11 – 1) / (10 + 11) = 0,95 O 95%.
2. fuzz.partial_ratio: peut détecter si un texte fait partie d'un autre texte. Mais il ne peut pas détecter si le texte est dans un ordre différent. L'exemple suivant montre que « t-shirt bleu » Cela fait partie de « chemise bleue propre », donc fuzz.partial_ratio est 100. fuzz.ratio renvoie la valeur 74 car il détecte seulement qu'il y a beaucoup de différence entre les deux textes.
imprimer(rapport.fuzz('blue shirt','clean blue shirt.'))
#74
imprimer(fuzz.partial_ratio('blue shirt','clean blue shirt.'))
#100
3. Token_Sort_Ratio: peut détecter si un texte fait partie d'un autre texte, même s'ils sont dans un ordre différent. Fuzz.token_sort_ratio devuelve 100 pour le texte « chapeau propre et chemise bleue » Oui « chemise bleue et chapeau propre » parce qu'ils signifient en fait la même chose, mais ils sont dans l'ordre inverse.
imprimer(rapport.fuzz('clean hat and blue shirt','blue shirt and clean hat'))
#42
imprimer(fuzz.partial_ratio('clean hat and blue shirt','blue shirt and clean hat'))
#42
imprimer(fuzz.token_sort_ratio('clean hat and blue shirt','blue shirt and clean hat'))
#100
4. Token_Set_Ratio: peut détecter une similitude de texte en considérant un texte partiel, l'ordre du texte et les différentes longueurs de texte. Vous pouvez détecter que le texte « bonnet propre » et « chemise bleue » fait partie du texte « Les gens veulent porter une chemise bleue et un chapeau propre » dans un ordre différent. Dans cet atelier, Nous n'utilisons que "Token_Set_Ratio" car c'est le plus approprié.
imprimer(rapport.fuzz('clean hat and blue shirt','People want to wear blue shirt and clean hat'))
#53
imprimer(fuzz.partial_ratio('clean hat and blue shirt','People want to wear blue shirt and clean hat'))
#62
imprimer(fuzz.token_sort_ratio('clean hat and blue shirt','People want to wear blue shirt and clean hat'))
#71
imprimer(fuzz.token_set_ratio('clean hat and blue shirt','People want to wear blue shirt and clean hat'))
#100
La siguiente celda cargará el conjunto de datos de entraînementLa formation est un processus systématique conçu pour améliorer les compétences, connaissances ou aptitudes physiques. Il est appliqué dans divers domaines, Comme le sport, Éducation et développement professionnel. Un programme d’entraînement efficace comprend la planification des objectifs, Pratique régulière et évaluation des progrès. L’adaptation aux besoins individuels et la motivation sont des facteurs clés pour obtenir des résultats réussis et durables dans toutes les disciplines.... y agregará características de hash, ainsi que la proportion du pool de jetons.
# charger l'ensemble d'entraînement
trainingSet = pd.read_csv('D:/new_training_set.csv', index_col=0).reset_index()
# Calculer la différence de hachage d'image
hashDiff = []
pour moi dans trainingSet.index:
    hash1 = imagehash.average_hash(Image.ouverte(chemin_img + trainingSet.iloc[je,2]))
    hash2 = imagehash.average_hash(Image.ouverte(chemin_img + trainingSet.iloc[je,4]))
    diff = hachage1 - hachage2
    hashDiff.append(différence)
trainingSet = trainingSet.iloc[:-1,:]
ensemble d'entraînement['hash'] = hashDiff
# Calculer le jeton_set_ratio
Jeton_test = []
pour moi dans trainingSet.index:
    TokenSet = fuzz.token_set_ratio(trainingSet.iloc[je,1], trainingSet.iloc[je,3])
    Jeu de jetons = (je, Jeu de jetons)
    Token_tes.append(Jeu de jetons)
dfToken = pd.DataFrame(jeton_test)
ensemble d'entraînement['Token'] = jeton df
Vous trouverez ci-dessous l'illustration de l'ensemble de données d'entraînement. En réalité, ce n'est pas l'ensemble de données d'origine car l'ensemble de données d'origine n'est pas en anglais. Je crée une autre donnée en anglais pour la comprendre. Chaque ligne a deux produits. Les colonnes « texte 1 » e « image 1 » appartiennent au premier produit. Les colonnes « texte_2 » e « image_2 » appartiennent au deuxième produit. "Label" définit si les produits correspondants sont les mêmes (1) ou non (0). Notez qu'il y a deux autres colonnes: « hacher » Oui « jetonSet ». Ces deux colonnes sont générées, pas de l'ensemble de données d'origine, mais d'après le code ci-dessus.
| indiceLe "Indice" C’est un outil fondamental dans les livres et les documents, qui vous permet de localiser rapidement les informations souhaitées. Généralement, Il est présenté au début d’une œuvre et organise les contenus de manière hiérarchique, y compris les chapitres et les sections. Sa préparation correcte facilite la navigation et améliore la compréhension du matériau, ce qui en fait une ressource incontournable tant pour les étudiants que pour les professionnels dans divers domaines.... | Texte 1 | image_1 | texte_2 | image_2 | Étiqueter | Hacher | jetonSet |
| 0 | T-shirt bleu | Gdsfdfs.jpg | T-shirt bleu. | Safsfs.jpg | 1 | 6 | 100 |
| 1 | Chapeau propre | Fsdfsa.jpg | Pantalon propre | Yjdgfbs.jpg | 0 | 25 | 71 |
| 2 | Souris | Dfsdfasd.jpg | Souris | Fgasfdg.jpg | 0 | 30 | 100 |
| . . . | . . . | . . . | . . . | . . . | . . . | . . . | . . . |
Appliquer l'apprentissage automatique
À présent, nous savons qu'une différence Imagehash plus faible et un Token_Set_Ratio plus élevé indiquent qu'une paire de produits est plus susceptible d'être la même. La valeur la plus basse de imagehash est 0 et la valeur la plus élevée de Token_Set_Ratio est 100. Mais, la question est de savoir combien sont les seuils. Pour définir les seuils, nous pouvons utiliser le classificateur d'arbre de décision.
Un modèle d'apprentissage automatique de l'arbre de décision est créé à l'aide de l'ensemble de données d'apprentissage. L'algorithme d'apprentissage automatique trouvera le modèle de différence de hachage d'image et le rapport d'ensemble de jetons de produits identiques et différents. L'arbre de décision est affiché pour l'image de couverture de cet article. Le code suivant crée un modèle d'arbre de décision avec Python. (Mais, l'affichage de l'image de couverture est l'arbre de décision généré avec R car, À mon avis, R visualise l'arbre de décision de manière plus agréable). Alors, va reprédire l'ensemble de données d'entraînement. Finalement, nous pouvons obtenir la précision.
# Créer un classificateur d'arbre de décision: jeu de hachage et de jetons
Dtc = DecisionTreeClassifier(profondeur_max=4)
Dtc = Dtc.fit(trainingSet.loc[:,['hash', 'tokenSet']],
              trainingSet.loc[:,'Label'])
Prediction2 = Dtc.predict(trainingSet.loc[:,['hash', 'tokenSet']])
metrics.accuracy_score(trainingSet.loc[:,'Label'], Prédiction2)
L'arbre de décision est utilisé pour prédire à nouveau la classification de l'ensemble de données d'apprentissage. La précision est 0,728. En d'autres termes, les 72,8% de l'ensemble de données d'entraînement est correctement prédit.
De l'arbre de décision, nous pouvons extraire l'information que si la différence Imagehash est inférieure à 12, la paire de produits est classée comme identique. Si la différence Imagehash est supérieure ou égale à 12, nous devons vérifier la valeur Token_Set_Ratio. El Token_Set_Ratio inférieur à un 97 confirmer que la paire de produits est différente. Autrement, vérifiez à nouveau si la valeur de différence de Imagehash. Si la différence d'image de hachage est supérieure ou égale à 22, alors les produits sont identiques. Au contraire, les produits sont différents.
Appliquer pour tester l'ensemble de données
À présent, nous allons charger l'ensemble de données de test, nous allons générer la différence Imagehash et Token_Set_Ratio, et enfin nous prédirons si chaque paire de produits correspond.
# chemin d'accès à l'image
path_img = 'D:/test_img/'
# ensemble de test de charge
test = pd.read_csv('D:/new_test_set.csv', index_col=0).reset_index()
# liste hashDiff
hashDiff = []
# Calculer la différence d'image
pour moi dans test.index[:100]:
    hash1 = imagehash.average_hash(Image.ouverte(chemin_img + test.iloc[je,2]))
    hash2 = imagehash.average_hash(Image.ouverte(chemin_img + test.iloc[je,4]))
    diff = hachage1 - hachage2
    hashDiff.append(différence)
test['hash'] = hashDiff
# Liste Token_set
Jeton_jeu = []
# Calculer la différence de texte à l'aide d'un jeu de jetons
pour moi dans test.index:
    TokenSet = fuzz.token_set_ratio(test.iloc[je,1], test.iloc[je,3])
    Token_set.append(Jeu de jetons)
test['token'] = Token_set
Après avoir calculé la différence entre Imagehash et Token_Set_ratio, la prochaine chose que vous devez faire est d'appliquer l'arbre de décision pour la détection de correspondance de produit.
# Détection de correspondance de produit
test['labelPredict'] = np.où(test['hash']<12, 1,
                               np.où(test['token']<97, 0,
                                        np.où(test['hash']>=22, 0, 1)))
# ou
test['labelPredict'] = Dtc.predict(test[['hash','token']])
| indice | Texte 1 | image_1 | texte_2 | image_2 | Hacher | jetonSet | labelPredict |
| 0 | crayon | Fdfgsdfhg.jpg | à bille | Adxsea.jpg | 8 | 33 | 1 |
| 1 | disque dur | Sgytueyuyt.jpg | un bon disque dur | Erewbva.jpg | 20 | 100 | 1 |
| 2 | Brouillon | Sadssadad.jpg | Stationnaire | Safdfgs.jpg | 25 | 25 | 0 |
| . . . | . . . | . . . | . . . | . . . | . . . | . . . | . . . |
Le tableau ci-dessus est l'illustration du résultat final. L'objectif de cet article est de montrer comment prédire si deux images et deux textes sont similaires ou identiques. Vous constaterez peut-être que le modèle d'apprentissage automatique utilisé est assez simple et qu'il n'y a pas de réglage d'hyperparamètre ou de division des données d'entraînement et de test.. L'autre application d'apprentissage automatique, telles que les méthodes d'ensemble basées sur l'arborescence, peut augmenter la précision. Mais ce n'est pas notre sujet de discussion ici. Si vous souhaitez apprendre un autre apprentissage automatique basé sur un arbre plus précis que l'arbre de décision, cherchez un article ici.
A propos de l'auteur
Connectez-vous avec moi ici https://www.linkedin.com/in/rendy-kurnia/
Les médias présentés dans cet article ne sont pas la propriété de DataPeaker et sont utilisés à la discrétion de l'auteur.





