
Cet article a été publié dans le cadre du Blogathon sur la science des données
Les différentes méthodes de l'apprentissage en profondeurL'apprentissage en profondeur, Une sous-discipline de l’intelligence artificielle, s’appuie sur des réseaux de neurones artificiels pour analyser et traiter de grands volumes de données. Cette technique permet aux machines d’apprendre des motifs et d’effectuer des tâches complexes, comme la reconnaissance vocale et la vision par ordinateur. Sa capacité à s’améliorer continuellement au fur et à mesure que de nouvelles données lui sont fournies en fait un outil clé dans diverses industries, de la santé... Ils utilisent des données pour entraîner des algorithmes de réseaux neuronaux afin d’effectuer diverses tâches d’apprentissage automatique, que la classification de différentes classes d'objets. Les réseaux de neurones convolutifs sont des algorithmes d'apprentissage en profondeur très puissants pour l'analyse d'images. Cet article explique comment construire, entraîner et évaluer les réseaux de neurones convolutifs.
Vous apprendrez également à améliorer votre capacité à apprendre à partir des données et à interpréter les résultats de la formation.. Le Deep Learning a plusieurs applications comme le traitement d'images, traitement du langage naturel, etc. Il est également utilisé dans les sciences médicales, Médias et divertissement, Voitures autonomes, etc.
Qu'est-ce que CNN?
CNN est un algorithme puissant pour le traitement d'images. Ces algorithmes sont actuellement les meilleurs algorithmes dont nous disposons pour le traitement automatisé d'images.. De nombreuses entreprises utilisent ces algorithmes pour faire des choses comme identifier des objets dans une image.
Les images contiennent des données de combinaison RVB. Matplotlib peut être utilisé pour importer une image en mémoire à partir d'un fichier. L'ordinateur ne voit pas d'image, tout ce que vous voyez est un tableau de nombres. Les images en couleur sont stockées dans des tableaux tridimensionnels. Les deux premières dimensions correspondent à la hauteur et à la largeur de l'image (le nombre de pixels). Le dernier dimension"Dimension" C’est un terme qui est utilisé dans diverses disciplines, comme la physique, Mathématiques et philosophie. Il s’agit de la mesure dans laquelle un objet ou un phénomène peut être analysé ou décrit. En physique, par exemple, On parle de dimensions spatiales et temporelles, alors qu’en mathématiques, il peut faire référence au nombre de coordonnées nécessaires pour représenter un espace. Sa compréhension est fondamentale pour l’étude et... Correspond aux couleurs rouge, vert et bleu présents dans chaque pixel.
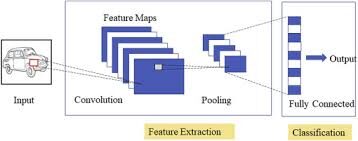
Trois couches de CNN
Réseaux de neurones convolutifs spécialisés pour les applications de reconnaissance d'images et de vidéos. CNN est principalement utilisé dans les tâches d'analyse d'images telles que la reconnaissance d'images, détection d’objets et segmentationLa segmentation est une technique de marketing clé qui consiste à diviser un large marché en groupes plus petits et plus homogènes. Cette pratique permet aux entreprises d’adapter leurs stratégies et leurs messages aux spécificités de chaque segment, améliorant ainsi l’efficacité de vos campagnes. Le ciblage peut se faire sur des critères démographiques, Psychographique, géographique ou comportementale, Faciliter une communication plus pertinente et personnalisée avec le public cible.....
Il existe trois types de couches dans les réseaux de neurones convolutifs:
1) couverture convolutiveLa couche convolutive, Fondamental dans les réseaux de neurones convolutifs (CNN), Il est principalement utilisé pour le traitement de données avec des structures de type grille, comme images. Cette couche applique des filtres qui extraient les caractéristiques pertinentes, tels que les bords et les textures, permettant au modèle de reconnaître des motifs complexes. Sa capacité à réduire la dimensionnalité des données et à maintenir les informations essentielles en fait un outil clé dans les tâches de vision par ordinateur..: dans une neuronal rougeLes réseaux de neurones sont des modèles computationnels inspirés du fonctionnement du cerveau humain. Ils utilisent des structures appelées neurones artificiels pour traiter et apprendre des données. Ces réseaux sont fondamentaux dans le domaine de l’intelligence artificielle, permettant des avancées significatives dans des tâches telles que la reconnaissance d’images, Traitement du langage naturel et prédiction de séries temporelles, entre autres. Leur capacité à apprendre des motifs complexes en fait des outils puissants.. typique, chaque neurone d'entrée est connecté à la couche cachée suivante. Et CNN, seulement une petite région des neurones de la couche d'entréeLa "couche d'entrée" fait référence au niveau initial d’un processus d’analyse de données ou d’architectures de réseaux de neurones. Sa fonction principale est de recevoir et de traiter l’information brute avant qu’elle ne soit transformée par les couches suivantes. Dans le contexte de l’apprentissage automatique, Une bonne configuration de la couche d’entrée est cruciale pour garantir l’efficacité du modèle et optimiser ses performances dans des tâches spécifiques.... Se connecte à la couche cachée des neurones.
2) Couche de regroupement: la couche de regroupement est utilisée pour réduire la dimensionnalité de la carte des caractéristiques. Il y aura plusieurs couches d'activation et de regroupement au sein de la couche cachée de CNN.
3) Couche entièrement connectée: Couches entièrement connectées forme le dernier couvre sur le réseau. L'entrée de la couche entièrement connectée est la sortie du groupement final ou de la convolution Couverture avant, qui est aplati puis introduit dans le couche entièrement connectée.
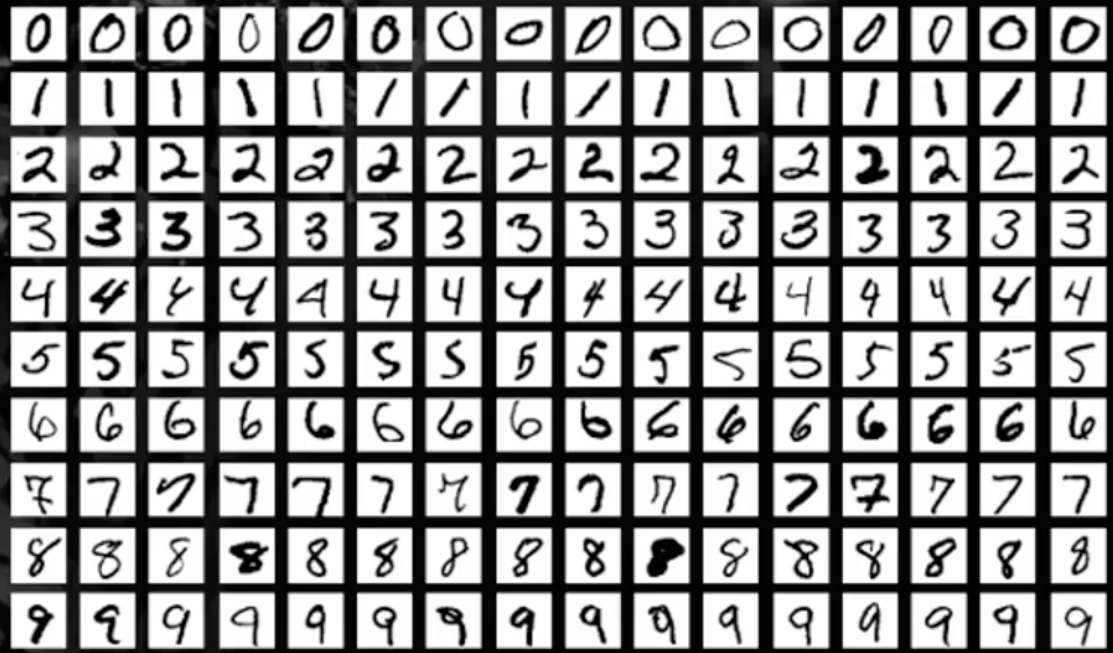
Ensemble de données MNIST
Dans cet article, nous allons travailler sur la reconnaissance d'objets dans les données d'image en utilisant le jeu de données MNIST pour la reconnaissance des chiffres manuscrits.
L'ensemble de données MNIST se compose d'images numériques provenant d'une variété de documents numérisés. Chaque image est un carré de 28 X 28 pixels. Dans cet ensemble de données, ils s'utilisent 60.000 images pour entraîner le modèle et 10.000 photos pour tester le modèle. Il y a 10 chiffres (0 une 9) O 10 cours à prévoir.
Chargement du jeu de données MNIST
Installez la bibliothèque TensorFlow et importez le jeu de données en tant que entraînementLa formation est un processus systématique conçu pour améliorer les compétences, connaissances ou aptitudes physiques. Il est appliqué dans divers domaines, Comme le sport, Éducation et développement professionnel. Un programme d’entraînement efficace comprend la planification des objectifs, Pratique régulière et évaluation des progrès. L’adaptation aux besoins individuels et la motivation sont des facteurs clés pour obtenir des résultats réussis et durables dans toutes les disciplines.... et tester.
Tracer la sortie de l'échantillon d'image
!pip installer tensorflow
à partir de keras.datasets importer mnist
importer matplotlib.pyplot en tant que plt
(X_train,y_train), (X_test, y_test)= mnist.load_data()
plt.sous-intrigue()
plt.imshow(X_train[9], cmap=plt.get_cmap('gray'))
Production:
Modèle d'apprentissage profond avec des perceptrons multicouches utilisant MNIST
Dans ce modèle, nous allons créer un modèle de réseau de neurones simple avec une seule couche cachée pour l'ensemble de données MNIST pour la reconnaissance des chiffres manuscrits.
Un perceptron est un modèle de neurone unique qui est la pierre angulaire des plus grands réseaux de neurones. Le perceptron multicouche se compose de trois couches, c'est-à-dire, la couche d'entrée, le calque caché et le Couche de sortieLa "Couche de sortie" est un concept utilisé dans le domaine des technologies de l’information et de la conception de systèmes. Il s’agit de la dernière couche d’un modèle logiciel ou d’une architecture qui est chargée de présenter les résultats à l’utilisateur final. Cette couche est cruciale pour l’expérience utilisateur, puisqu’il permet une interaction directe avec le système et la visualisation des données traitées..... La couche cachée n'est pas visible du monde extérieur. Seules la couche d'entrée et la couche de sortie sont visibles. Pour tous les modèles DL, les données doivent être de nature numérique.
Paso 1: importer des bibliothèques de clés
importer numpy en tant que np
à partir de keras.models Importation séquentielle
de keras.layers importer Dense
de keras.utils importer np_utils
Paso 2: remodeler les données
Chaque image est de taille 28X28, il y a donc 784 pixels. Ensuite, la couche de sortie a 10 départs, la couche cachée a 784 neurones et la couche d'entrée a 784 billets. Alors, l'ensemble de données est converti en un type de données flottant.
number_pix=X_train.shape[1]*X_train.shape[2]
X_train=X_train.remodeler(X_train.shape[0], nombre_pix).astype('float32')
X_test=X_test.remodeler(X_test.shape[0], nombre_pix).astype('float32')
Paso 3: normaliser les données
Les modèles NN nécessitent généralement des données à l'échelle. Dans cet extrait de code, les données sont normalisées à partir de (0-255) une (0-1) et la variableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes.... est encodé en une seule utilisation pour une analyse ultérieure. La variable cible a un total de 10 cours (0-9)
X_train=X_train/255
X_test=X_test/255
y_train= np_utils.to_categorical(y_train)
y_test= np_utils.to_categorical(y_test)
num_classes=y_train.shape[1]
imprimer(nombre_classes)
Production:
10
À présent, nous allons créer une fonction NN_model et la compiler
Paso 4: définir la fonction de modèle
def nn_model():
    modèle=Séquentiel()
    model.ajouter(Dense(nombre_pix, input_dim=number_pix, activation='relu'))
    mode.ajouter(Dense(nombre_classes, activation='softmax'))
    modèle.compile(perte ="catégorique_crossentropie", optimiser="Adam", métriques=['précision'])
    modèle de retour
Il y a deux couches, l’un est un calque caché avec l’icône Fonction d’activation ReLuLa fonction d’activation ReLU (Unité linéaire rectifiée) Il est largement utilisé dans les réseaux neuronaux en raison de sa simplicité et de son efficacité. est défini comme ( F(X) = max(0, X) ), ce qui signifie qu’il produit une sortie de zéro pour les valeurs négatives et un incrément linéaire pour les valeurs positives. Sa capacité à atténuer le problème de l’évanouissement en pente en fait un choix privilégié dans les architectures profondes.... et l’autre est la couche de sortie qui utilise la fonction Fonction SoftMaxLa fonction softmax est un outil mathématique utilisé dans le domaine de l’apprentissage automatique, Surtout dans les réseaux de neurones. Convertit un vecteur de valeur en une distribution de probabilité, Attribution de probabilités à chaque classe dans les problèmes multi-classifications. Sa formule normalise les sorties, s’assurer que la somme de toutes les probabilités est égale à un, permettre une interprétation efficace des résultats. Il est essentiel dans l’optimisation de....
Paso 5: exécuter le modèle
modèle=nn_modèle()
model.fit(X_train, y_train, validation_data=(X_test,y_test),époques=10, taille_lot=200, verbeux=2)
score= modèle.évaluer(X_test, y_test, verbeux=0)
imprimer('The error is: %.2f%%'%(100-But[1]*100))
Production:
Époque 1/10
300/300 - 11s - perte: 0.2778 - précision: 0.9216 - perte_val: 0.1397 - valeur_précision: 0.9604
Époque 2/10
300/300 - 2s - perte: 0.1121 - précision: 0.9675 - perte_val: 0.0977 - valeur_précision: 0.9692
Époque 3/10
300/300 - 2s - perte: 0.0726 - précision: 0.9790 - perte_val: 0.0750 - valeur_précision: 0.9778
Époque 4/10
300/300 - 2s - perte: 0.0513 - précision: 0.9851 - perte_val: 0.0656 - valeur_précision: 0.9796
Époque 5/10
300/300 - 2s - perte: 0.0376 - précision: 0.9892 - perte_val: 0.0717 - valeur_précision: 0.9773
Époque 6/10
300/300 - 2s - perte: 0.0269 - précision: 0.9928 - perte_val: 0.0637 - valeur_précision: 0.9797
Époque 7/10
300/300 - 2s - perte: 0.0208 - précision: 0.9948 - perte_val: 0.0600 - valeur_précision: 0.9824
Époque 8/10
300/300 - 2s - perte: 0.0153 - précision: 0.9962 - perte_val: 0.0581 - valeur_précision: 0.9815
Époque 9/10
300/300 - 2s - perte: 0.0111 - précision: 0.9976 - perte_val: 0.0631 - valeur_précision: 0.9807
Époque 10/10
300/300 - 2s - perte: 0.0082 - précision: 0.9985 - perte_val: 0.0609 - valeur_précision: 0.9828
L'erreur est: 1.72%
Dans les résultats du modèle, est visible à mesure que le nombre d'époques augmente, améliore la précision. L'erreur vient de 1,72%, mineur est l'erreur, plus la précision du modèle est élevée.
Modèle de réseau de neurones convolutifs utilisant MNIST
Dans cette section, nous allons créer des modèles CNN simples pour MNIST qui démontrent des couches convolutives, regroupement de calques et dépose de calques.
Paso 1: importer toutes les bibliothèques nécessaires
importer numpy en tant que np
à partir de keras.models Importation séquentielle
de keras.layers importer Dense
de keras.utils importer np_utils
à partir de keras.layers importer Dropout
à partir de keras.layers importer Aplatir
à partir de keras.layers.convolutional import Conv2D
à partir de keras.layers.convolutional import MaxPooling2D
Paso 2: Configurer la graine pour la reproductibilité et charger les données MNIST
graine=10
np.random.seed(la graine)
(X_train,y_train), (X_test, y_test)= mnist.load_data()
Paso 3: convertir les données en valeurs flottantes
X_train=X_train.remodeler(X_train.shape[0], 1,28,28).astype('float32')
X_test=X_test.remodeler(X_test.shape[0], 1,28,28).astype('float32')
Paso 4: normaliser les données
X_train=X_train/255
X_test=X_test/255
y_train= np_utils.to_categorical(y_train)
y_test= np_utils.to_categorical(y_test)
num_classes=y_train.shape[1]
imprimer(nombre_classes)
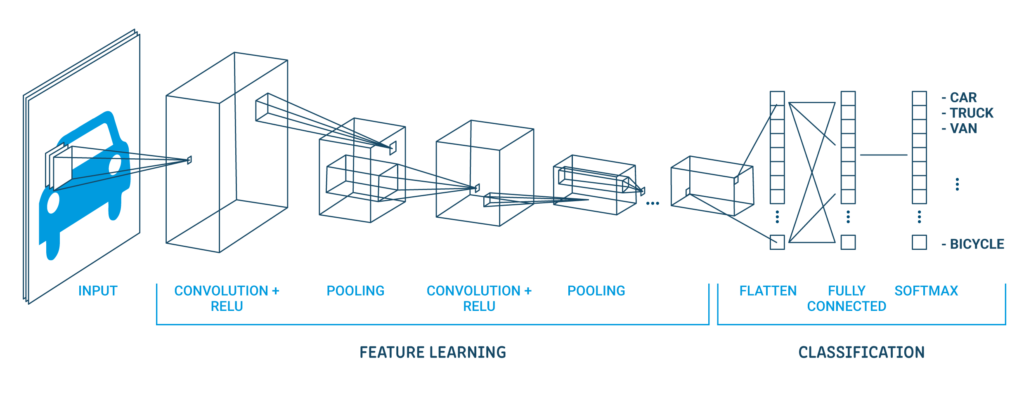
Une architecture CNN classique ressemble à ci-dessous:
| Couche de sortie (10 départs) |
| Cape cachée (128 neurones) |
| Couche plate |
| Cape d'abandon 20% |
| Couche de regroupement maximale 2 × 2 |
| couverture convolutive 32 Plans, 5 × 5 |
| Couche visible 1x28x28 |
La première couche cachée est une couche convolutive appelée Convolution2D. Il dispose de 32 cartes de caractéristiques avec la taille 5 × 5 et fonction de broyage. C'est la couche d'entrée. Ce qui suit est la couche de pooling qui prend la valeur maximale appelée MaxPooling2D. Dans ce modèle, est configuré comme une taille de pool de 2 × 2.
Dans la couche d’abandon, le régularisationLa régularisation est un processus administratif qui vise à formaliser la situation de personnes ou d’entités qui opèrent en dehors du cadre légal. Cette procédure est essentielle pour garantir les droits et les devoirs, ainsi que pour promouvoir l’inclusion sociale et économique. Dans de nombreux pays, La régularisation est appliquée dans les contextes migratoires, Droit du travail et fiscalité, permettre aux personnes en situation irrégulière d’accéder à des prestations et de se protéger d’éventuelles sanctions..... Il est défini pour exclure aléatoirement le 20% neurones en couches pour éviter le surapprentissage. La cinquième couche est la couche aplatie qui convertit les données de la matrice 2D en un vecteur appelé Flatten. Permet à la sortie d'être entièrement traitée par une couche standard entièrement connectée.
Ensuite, la couche entièrement connectée est utilisée avec 128 neurones et le fonction de réveilLa fonction d’activation est un composant clé des réseaux de neurones, puisqu’il détermine la sortie d’un neurone en fonction de son entrée. Son objectif principal est d’introduire des non-linéarités dans le modèle, vous permettant d’apprendre des modèles complexes dans les données. Il existe différentes fonctions d’activation, comme le sigmoïde, ReLU et tanh, chacun avec des caractéristiques particulières qui affectent les performances du modèle dans différentes applications.... du redresseur. Finalement, la couche de sortie a 10 neurones pour 10 classes et une fonction de déclenchement softmax pour générer des prédictions de type probabilité pour chaque classe.
Paso 5: exécuter le modèle
def cnn_model():
    modèle=Séquentiel()
    model.ajouter(Conv2D(32,5,5, padding='same',input_shape=(1,28,28), activation='relu'))
    model.ajouter(MaxPooling2D(pool_size=(2,2), padding='same'))
    model.ajouter(Abandonner(0.2))
    model.ajouter(Aplatir())
    model.ajouter(Dense(128, activation='relu'))
    model.ajouter(Dense(nombre_classes, activation='softmax'))
    modèle.compile(perte ="catégorique_crossentropie", optimiseur="Adam", métriques=['précision'])
    modèle de retour
modèle=cnn_modèle()
model.fit(X_train, y_train, validation_data=(X_test,y_test),époques=10, taille_lot=200, verbeux=2)
score= modèle.évaluer(X_test, y_test, verbeux=0)
imprimer('The error is: %.2f%%'%(100-But[1]*100))
Production:
Époque 1/10
300/300 - 2s - perte: 0.7825 - précision: 0.7637 - perte_val: 0.3071 - valeur_précision: 0.9069
Époque 2/10
300/300 - 1s - perte: 0.3505 - précision: 0.8908 - perte_val: 0.2192 - valeur_précision: 0.9336
Époque 3/10
300/300 - 1s - perte: 0.2768 - précision: 0.9126 - perte_val: 0.1771 - valeur_précision: 0.9426
Époque 4/10
300/300 - 1s - perte: 0.2392 - précision: 0.9251 - perte_val: 0.1508 - valeur_précision: 0.9537
Époque 5/10
300/300 - 1s - perte: 0.2164 - précision: 0.9325 - perte_val: 0.1423 - valeur_précision: 0.9546
Époque 6/10
300/300 - 1s - perte: 0.1997 - précision: 0.9380 - perte_val: 0.1279 - valeur_précision: 0.9607
Époque 7/10
300/300 - 1s - perte: 0.1856 - précision: 0.9415 - perte_val: 0.1179 - valeur_précision: 0.9632
Époque 8/10
300/300 - 1s - perte: 0.1777 - précision: 0.9433 - perte_val: 0.1119 - valeur_précision: 0.9642
Époque 9/10
300/300 - 1s - perte: 0.1689 - précision: 0.9469 - perte_val: 0.1093 - valeur_précision: 0.9667
Époque 10/10
300/300 - 1s - perte: 0.1605 - précision: 0.9493 - perte_val: 0.1053 - valeur_précision: 0.9659
L'erreur est: 3.41%
Dans les résultats du modèle, est visible à mesure que le nombre d'époques augmente, améliore la précision. L'erreur est 3.41%, erreur plus faible précision du modèle plus élevée.
J'espère que vous avez apprécié la lecture et n'hésitez pas à utiliser mon code pour le tester à vos fins. En outre, s'il y a un commentaire sur le code ou juste sur le blog, n'hésitez pas à me contacter au [email protégé]
Les médias présentés dans cet article sur le traitement d'images de CNN ne sont pas la propriété de DataPeaker et sont utilisés à la discrétion de l'auteur.





