
introduction
Pour une raison quelconque, les problèmes de régression et de classification finissent par attirer l'attention dans le monde de l'apprentissage automatique. Les gens ne réalisent pas la grande variété de problèmes d'apprentissage automatique qui peuvent exister.
À moi, d'un autre côté, J'aime explorer différents types de problèmes et partager mon apprentissage avec la communauté ici.
Précédemment, partagé mes apprentissages sur les algorithmes génétiques avec la communauté. Continuer ma recherche, J'ai l'intention de couvrir un sujet qui a un problème beaucoup moins répandu mais qui est un problème persistant dans la communauté de la science des données, quelle est la classification de plusieurs balises.
Dans cet article, Je vais vous donner une explication intuitive de ce qu'implique le tri multi-tags, avec une illustration de la façon de résoudre le problème. J'espère que cela vous montre l'horizon de ce que recouvre la science des données. Alors allons de l'avant!
Table des matières
- Qu'est-ce que le tri multi-tags?
- Multi-classe v / s Multi-étiquette
- Chargement et génération de plusieurs ensembles de données d'étiquettes
- Techniques pour résoudre un problème de classification d'étiquettes multiples
- Méthode de transformation de problème
- Méthode de l'algorithme adapté
- Approches d'ensemble
- Études de cas
1. Qu'est-ce que le tri multi-tags?
Regardons l'image ci-dessous.
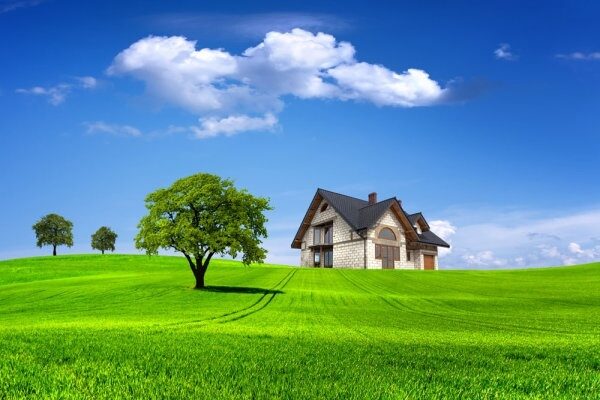
Et si je vous demandais si cette image contient une maison? L'option sera OUI O NON.
Considérons un autre cas, comme quoi toutes les choses (ou des étiquettes) sont pertinents pour cette image.
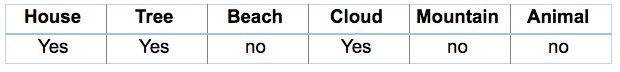
Ce genre de problèmes, où nous avons un ensemble de variables cibles, sont connus comme classification de plusieurs balises problèmes. Ensuite, Y a-t-il une différence entre ces deux cas? Clairement, Oui, car dans le second cas, toute image peut contenir un ensemble différent de ces balises multiples pour différentes images.
Mais avant de plonger dans les multiples balises, je voulais juste préciser une chose, car beaucoup d'entre vous pourraient être confus quant à la différence avec le problème des classes multiples.
Ensuite, essayons de comprendre la différence entre ces deux ensembles de problèmes.
2. Multi-étiquette v / s multi-classe
Prenons un exemple pour comprendre la différence entre ces deux. Pour cela, J'espère que l'image ci-dessous rend les choses assez claires. Essayons de le comprendre.
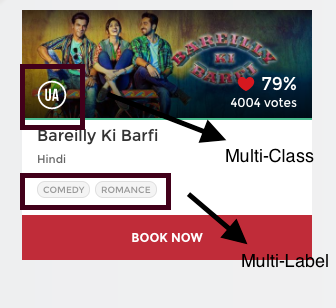
Pour n'importe quel film, le Conseil central de certification des films, délivre un certificat basé sur le contenu du film.
Par exemple, si tu regardes, ce film a été classé comme ‘U / UNE’ (Que signifie ‘supervision parentale pour les enfants de moins de 12 ans’) certificat. Il existe d'autres types de classes de certificats comme ‘UNE’ (Réservé aux adultes) O ‘U’ (Affichage public illimité), mais il est certain que chaque film ne peut être catégorisé qu'avec un seul de ces trois types de certificats.
En résumé, il y a plusieurs catégories mais chaque instance n'en est affectée qu'une, donc, ces problèmes sont connus comme classification de plusieurs classes problème.
Encore, si tu regardes en arrière la photo, ce film a été classé dans le genre de la comédie et de la romance. Mais il y a une différence en ce que cette fois, chaque film pourrait tomber dans un ou plusieurs ensembles de catégories différentes.
Donc, chaque instance peut être affectée à plusieurs catégories, c'est pourquoi ces types de problèmes sont appelés classification de plusieurs balises problème, où nous avons un ensemble d'étiquettes de destination.
Excellent! Vous pouvez maintenant faire la distinction entre un problème multi-label et multi-classe. Ensuite, commençons à traiter ce genre de problèmes.
3. Chargement et génération de plusieurs ensembles de données d'étiquettes
Scikit-learn a fourni une bibliothèque séparée scikit-multilearn pour le tri de plusieurs balises.
Pour une meilleure compréhension, commençons à nous entraîner avec un ensemble de données multi-étiquettes. Vous pouvez trouver un ensemble de données du monde réel dans le dépôt fourni par le forfait MULAN. Ces jeux de données sont présents au format ARFF.
Ensuite, pour commencer avec l'un de ces ensembles de données, regardez le code python ci-dessous pour le charger dans votre notebook jupyter. Ici, j'ai téléchargé l'ensemble de données de levure à partir du référentiel.
importer scipy
depuis scipy.io importer arff
Les données, méta = scipy.io.arff.loadarff(/Users/shubhamjain/Documents/yeast/yeast-train.arff)
df = pd.DataFrame(Les données)
Voici à quoi ressemble l'ensemble de données.
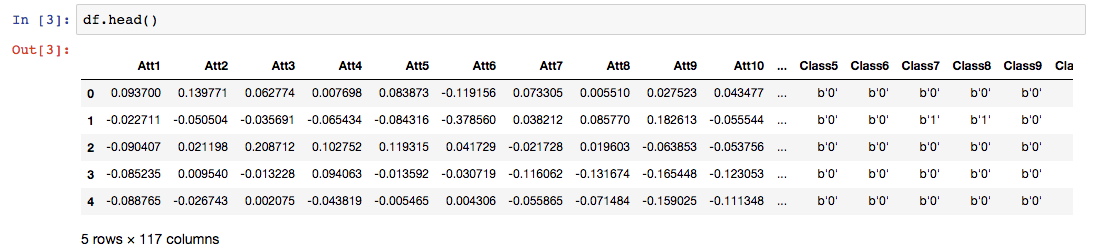
Ici, À représente les attributs ou les variables indépendantes et Classe représente les variables cibles.
A des fins pratiques, nous avons une autre option pour générer un jeu de données artificiel à plusieurs balises.
à partir de sklearn.datasets importer make_multilabel_classification

# cela générera un jeu de données aléatoire multi-étiquettes
X, y = make_multilabel_classification(clairsemé = vrai, n_étiquettes = 20,
return_indicator="clairsemé", allow_unlabeled = Faux)
Comprenons les paramètres utilisés ci-dessus.
rare: C'est vrai, renvoie un tableau clairsemé, où matrice creuse signifie une matrice qui a un grand nombre d'éléments zéro.
n_étiquettes: Le nombre moyen d'étiquettes dans chaque instance.
return_indicator: Et ‘rare’ Revenir Oui au format d'indicateur binaire clairsemé.
allow_unlaoted: Et Certain, certaines instances peuvent n'appartenir à aucune classe.
Vous avez dû remarquer que nous avons utilisé une matrice clairsemée partout, et scikit-multilearn recommande également d'utiliser les données avec parcimonie car il est très rare qu'un jeu de données du monde réel soit dense. Généralement, le nombre d'étiquettes attribuées à chaque instance est beaucoup plus faible.
Bien, maintenant nous avons nos ensembles de données prêts, Apprenons donc rapidement les techniques pour résoudre le problème multi-tags.
4. Techniques pour résoudre un problème de classification d'étiquettes multiples
Essentiellement, il existe trois méthodes pour résoudre un problème de classification d'étiquettes multiples, a savoir:
- Transformation de problème
- Algorithme adapté
- Approches d'ensemble
4.1 Transformation de problème
Dans cette méthode, nous allons essayer de transformer notre problème d'étiquettes multiples en problèmes d'étiquette unique.
Cette méthode peut se faire de trois manières différentes ::
- Pertinence binaire
- Chaînes de tri
- Etiquette de puissance
4.1.1 Pertinence binaire
C'est la technique la plus simple, qui traite essentiellement chaque balise comme un problème de classification de classe unique distinct.
Par exemple, considérons un cas comme indiqué ci-dessous. Nous avons l'ensemble de données comme celui-ci, où X est la caractéristique indépendante et Y est la variable cible.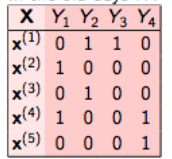
En pertinence binaire, ce problème est divisé en 4 différents problèmes de classification de classe unique, comme le montre la figure ci-dessous.
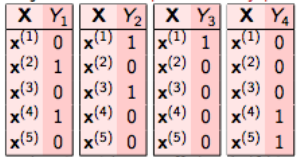
Nous n'avons pas à le faire manuellement, la bibliothèque multi-apprentissage fournit son implémentation en Python. Ensuite, voyons rapidement sa mise en oeuvre sur des données générées aléatoirement.
# utiliser la pertinence binaire
de skmultilearn.problem_transform importer BinaryRelevance
de sklearn.naive_bayes importer GaussianNB

# initialiser le classificateur multi-étiquettes de pertinence binaire
# avec un classificateur de base bayésien naïf gaussien
classificateur = BinaryRelevance(GaussienneNB())

# former
classificateur.fit(X_train, y_train)

# prédire
prédictions = classifier.predict(X_test)
REMARQUE: Ici, nous avons utilisé l'algorithme de Naive Bayes, mais vous pouvez utiliser n'importe quel autre algorithme de tri.
À présent, dans un problème de classification de balises multiples, nous ne pouvons pas simplement utiliser nos métriques normales pour calculer la précision de nos prédictions. Dans ce but, nous utiliserons note de précision métrique. Cette fonction calcule la précision du sous-ensemble, ce qui signifie que l'ensemble prédit d'étiquettes doit correspondre exactement au véritable ensemble d'étiquettes.
Ensuite, calculons l'exactitude des prédictions.
de sklearn.metrics importer precision_score
score_précision(y_test,prédictions)
Pourtant, nous avons obtenu un score de précision de 45%, ce n'est pas si mal. Voyons rapidement ses avantages et inconvénients.
C'est la méthode la plus simple et la plus efficace, mais le seul inconvénient de cette méthode est qu'elle ne prend pas en compte la corrélation des étiquettes car elle traite chaque variableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes.... cible de manière indépendante.
4.1.2 Chaînes de tri
Dans ce, le premier classificateur est entraîné uniquement sur les données d'entrée, puis chaque classificateur suivant est entraîné sur l'espace d'entrée et tous les classificateurs précédents de la chaîne.
Essayons de comprendre cela avec un exemple. Dans l'ensemble de données ci-dessous, nous avons X comme espace d'entrée et Y comme étiquettes.
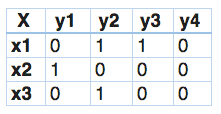
Dans les chaînes de classificateurs, ce problème deviendrait 4 différents problèmes de balise unique, comme il est montré dans ce qui suit. Ici la couleur jaune est l'espace de saisie et la partie blanche représente la variable cible.
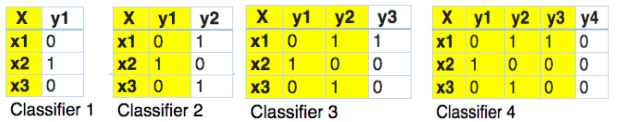
Ceci est assez similaire à la pertinence binaire, la seule différence est qu'il forme des chaînes pour préserver le mappage des étiquettes. Ensuite, essayons de l'implémenter en utilisant la bibliothèque multi-apprentissage.
# utiliser des chaînes de classificateurs
de skmultilearn.problem_transform importer ClassifierChain
de sklearn.naive_bayes importer GaussianNB

# initialiser les chaînes de classificateur classificateur multi-étiquettes
# avec un classificateur de base bayésien naïf gaussien
classificateur = ClassifierChain(GaussienneNB())

# former
classificateur.fit(X_train, y_train)

# prédire
prédictions = classifier.predict(X_test)

score_précision(y_test,prédictions)
0.21212121212121213
Nous pouvons voir qu'en utilisant cela, nous avons obtenu une précision d'environ 21%, ce qui est beaucoup moins que binaire Pertinence. Cela peut être dû à l'absence de corrélation de balises, puisque nous avons généré les données au hasard.
4.1.3 Etiquette de puissance
Dans ce, nous transformons le problème en un problème multi-classes avec un classificateur multi-classes formé sur toutes les combinaisons d'étiquettes uniques trouvées dans les données d'apprentissage.
Comprenons avec un exemple.
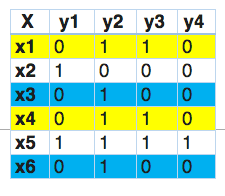
Dans ce, on trouve que x1 et x4 ont les mêmes labels, de la même manière, x3 et x6 ont le même ensemble d'étiquettes. Donc, l'assemblage d'alimentation d'étiquettes transforme ce problème en un seul problème multi-classes, comme il est montré dans ce qui suit.
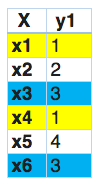
Donc, label powerset a attribué une classe unique à chaque combinaison d'étiquettes possible présente dans l'ensemble d'apprentissage.
Voyons son implémentation en Python.
# à l'aide de Label Powerset
de skmultilearn.problem_transform importer LabelPowerset
de sklearn.naive_bayes importer GaussianNB

# initialiser le classificateur multi-étiquettes Label Powerset
# avec un classificateur de base bayésien naïf gaussien
classificateur = LabelPowerset(GaussienneNB())

# former
classificateur.fit(X_train, y_train)

# prédire
prédictions = classifier.predict(X_test)

score_précision(y_test,prédictions)
0.5757575757575758
Cela nous donne la plus grande précision parmi les trois que nous avons discutées jusqu'à présent.. Le seul inconvénient est qu'à mesure que les données d'entraînement augmentent, augmenter le nombre de cours. Donc, augmente la complexité du modèle et conduirait à moins de précision.
À présent, Regardons la deuxième méthode pour résoudre le problème de classification multi-label.
4.2 Algorithme adapté
Algorithme adapté, comme le nom le suggère, adapter l'algorithme pour effectuer directement la classification de plusieurs étiquettes, au lieu de transformer le problème en différents sous-ensembles de problèmes.
Par exemple, la version multi-tags de kNN est représentée par MLkNN. Ensuite, implémentons rapidement cela dans notre ensemble de données généré aléatoirement.
de skmultilearn.adapt importer MLkNN

classificateur = MLkNN(k=20)

# former
classificateur.fit(X_train, y_train)

# prédire
prédictions = classifier.predict(X_test)

score_précision(y_test,prédictions)
0.69
Excellent! Il a obtenu un score de précision de 69% dans vos données de test.
Sci-kit learn fournit une prise en charge intégrée de la classification multi-tags dans certains des algorithmes tels que la régression Random Forest et Ridge. Donc, peut les appeler directement et prédire la sortie.
Vous pouvez vérifier le bibliothèque d'apprentissage multiple pour plus d'informations sur d'autres types d'algorithmes sur mesure.
4.3 Approches d'ensemble
Ensemble produit toujours de meilleurs résultats. La bibliothèque Scikit-Multilearn fournit différentes fonctions de classification d'ensembles, que vous pouvez utiliser pour de meilleurs résultats.
Pour une mise en œuvre directe, vous pouvez consulter ici.
5. Études de cas
Les problèmes de classification de balises multiples sont très courants dans le monde réel. Ensuite, examinons quelques-uns des domaines où nous pouvons les utiliser.
1. Catégorisation audio
On a déjà vu des chansons classées dans différents genres. Ils sont également classés sur la base des émotions ou des humeurs comme « calme relaxant », « tristesse-solitude », etc.
La source: Relier
2. Catégorisation des images
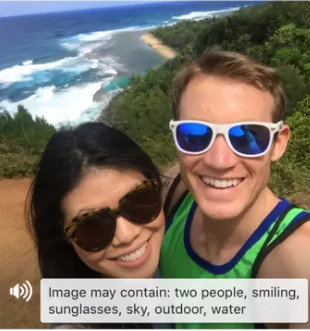
Le tri de plusieurs étiquettes à l'aide d'images a également un large éventail d'applications. Les images peuvent être étiquetées pour indiquer différents objets, personnes ou concepts.
3. Bioinformatique
La classification multi-label est largement utilisée dans le domaine de la bioinformatique, par exemple, la classification des gènes dans l'ensemble de données de levure.
Il est également utilisé pour prédire plusieurs fonctions protéiques à l'aide de diverses protéines non marquées.. Vous pouvez vérifier ceci papier pour plus d'informations.
4. Catégorisation du texte
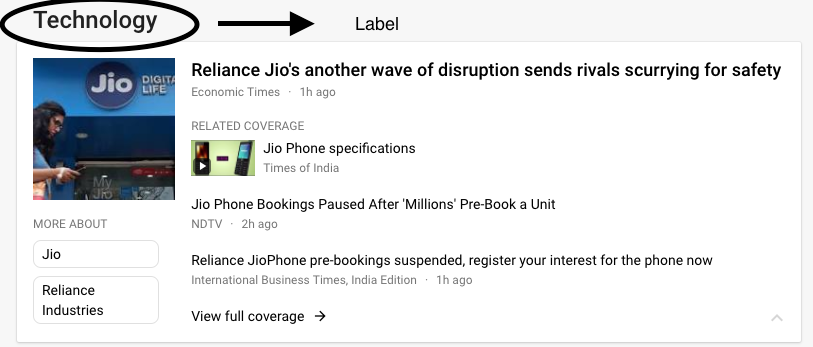
Tout le monde devrait consulter les actualités de Google une fois. Ensuite, ce que Google News fait, c'est marquer toutes les nouvelles dans une ou plusieurs catégories afin qu'elles soient affichées dans différentes catégories. Par exemple, Regardez l'image ci-dessous.
Source de l'image: Actualités de Google
Cette même nouvelle est présente dans les catégories de l'Inde, La technologie, Dernier, etc. car il a été classé dans ces différents labels. Donc, c'est un problème de classification de balises multiples.
Il y a bien d'autres domaines, alors explorez et commentez ci-dessous si vous souhaitez le partager avec la communauté.
6. Remarques finales
Dans cet article, vous a présenté le concept de problèmes de classification de balises multiples. J'ai également couvert des approches pour résoudre ce problème et des cas d'utilisation pratiques où vous devrez peut-être le gérer à l'aide de la bibliothèque multi-apprentissage en Python.
J'espère que cet article vous donne une longueur d'avance lorsque vous êtes confronté à ce genre de problèmes. Si vous avez des doutes / suggestion, N'hésitez pas à me contacter ci-dessous!





