
Cet article a été publié dans le cadre du Blogathon sur la science des données.
introduction
Les principaux objectifs de la validation d'un modèle comprennent le test de la solidité conceptuelle du modèle et de son adéquation continue à l'objectif., y compris l'identification des risques potentiels et des limites. Ces tests doivent constituer une remise en cause effective du modèle de production existant au profit de son amélioration., atténuation des risques. Les données de cet exercice sont tirées de ici.
Cadre de validation
Les tests suivants ont été effectués pour valider les résultats du modèle:
- Variables du modèle: IV, linéarité et VIF
- 3. Ajustement du modèle: Graphiques AUROC, Gini, KS et gain et lift
- 4. Essais sur modèle: analyse de sensibilité
- 5. Coefficient de stabilité: stabilité du signal et stabilité du coefficient
2.1 Vérifications des données
Variables dépendantes
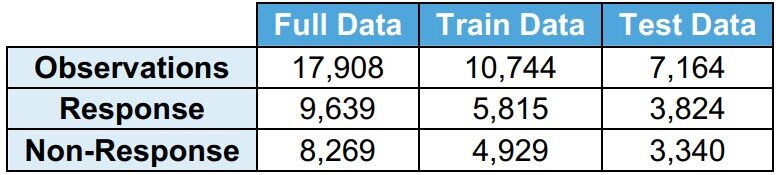
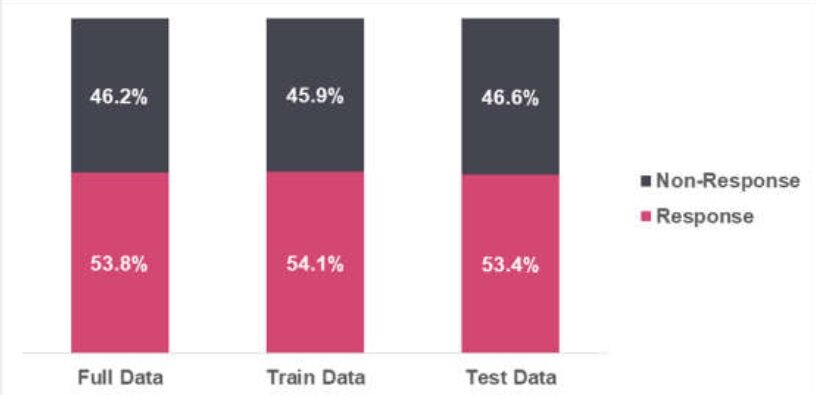
On constate que la distribution des réponses (Y = 1) et pas de réponse (Y = 0) c'est très similaire entre les données complètes, données de train et données de test.
· La réponse (Y = 1) indique que le demandeur a demandé le prêt
· Sans réponse (Y = 0) indique que le demandeur n'a pas demandé le prêt
Variables indépendantes
Les variables indépendantes incluent des informations personnelles et financières. Les scores de risque sont utilisés pour développer le modèle. Il y a 5 variables indépendantes dans le modèle.
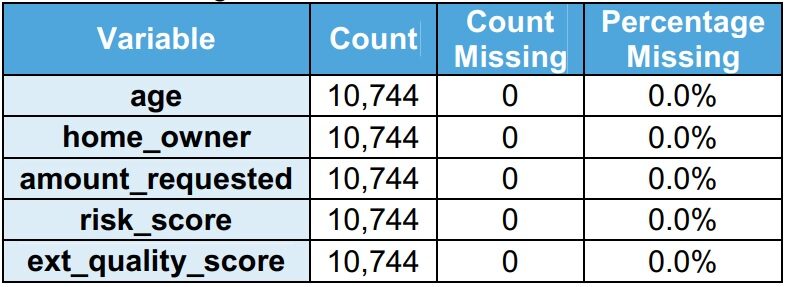
On observe qu'il n'y a pas de valeurs manquantes dans l'ensemble de données du train.
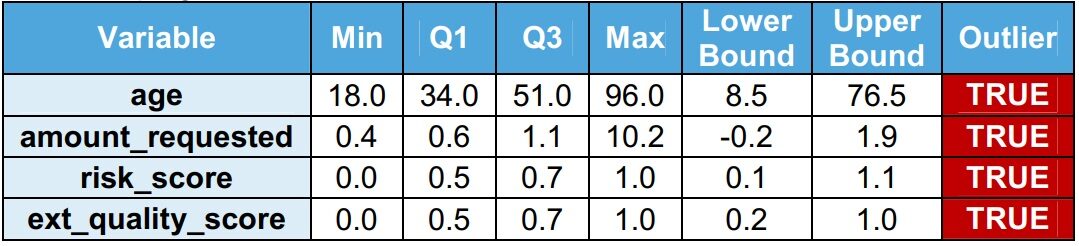
Il est observé qu'il y a des valeurs aberrantes dans l'ensemble de données de train. L'écart entre les quartiles (IQR = Q3 – T1) sert à identifier les points de vente. Les valeurs aberrantes sont des valeurs supérieures à la limite supérieure (T1 + 1,5 x IQR) ou des valeurs inférieures à la limite inférieure (T1 – 1,5 x IQR). L'équipe de validation recommande que les valeurs aberrantes soient traitées avant de développer le modèle.
2.2. Variables du modèle
Valeur informative (IV)
de statsmodels.stats.outliers_influence importer variance_inflation_factor
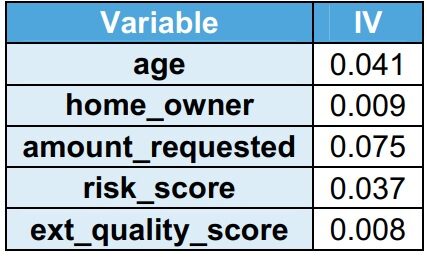
Le pouvoir explicatif de la variableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes.... est capturé par IV. Au fur et à mesure que le pouvoir explicatif de la variable augmente, augmente IV. On observe que toutes les variables ont IV <0.1, indiquant qu'ils ont un faible pouvoir explicatif dans l'ensemble de données du train.
Linéarité
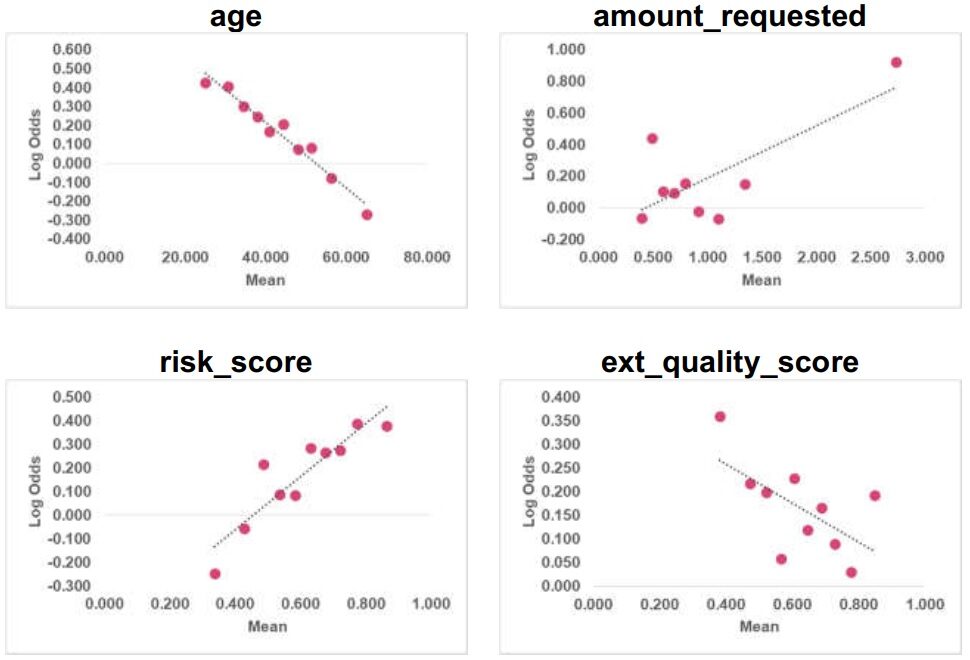
Paso 1: Fabriquer 10 conteneurs pour chaque variable numérique
Paso 2: pour chaque intervalle, calculer la moyenne de la variable et les probabilités log correspondantes
La linéarité des variables numériques est vérifiée (âge, Quantité exigée, risk_score et quality_score_ ext) dans les données du train. on constate qu'il agit & risk_score fils lineales y montant_requested & ext_quality_score pas de fils linéaires. L'équipe de validation recommande de tester les transformations pour obtenir une relation linéaire.
Facteur d'information sur l'écart (VIF)
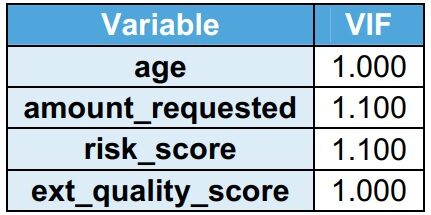
VIF indique la multicolinéarité entre les variables indépendantes. On constate que sa VIF est inférieure à 2 dans l'ensemble de données de entraînementLa formation est un processus systématique conçu pour améliorer les compétences, connaissances ou aptitudes physiques. Il est appliqué dans divers domaines, Comme le sport, Éducation et développement professionnel. Un programme d’entraînement efficace comprend la planification des objectifs, Pratique régulière et évaluation des progrès. L’adaptation aux besoins individuels et la motivation sont des facteurs clés pour obtenir des résultats réussis et durables dans toutes les disciplines..... VIF inférieur à 2 indique aucune multicolinéarité. Home_owner est un drapeau, donc, non pris en compte pour VIF.
2.3 Ajustement du modèle
AU-ROC
sklearn.metrics.auc(X, Oui)
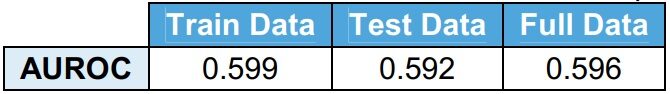
L'aire sous la courbe de l'opérateur récepteur (AUROC) est utilisé pour mesurer le pouvoir prédictif du modèle. AUROC = 0,50 indique qu'il n'y a pas de pouvoir prédictif et AUROC = 1,00 indique un pouvoir prédictif parfait. Le modèle développé avec des données de train est exécuté avec des données de test et des données complètes. On observe qu'il n'y a pas d'écart significatif dans les valeurs AUROC.
On constate que l'AUROC est inférieure à 0,6. Cela indique que le modèle n'a pas un bon pouvoir prédictif.. L'équipe de validation recommande d'utiliser des variables supplémentaires pour améliorer l'ajustement du modèle.
Gini
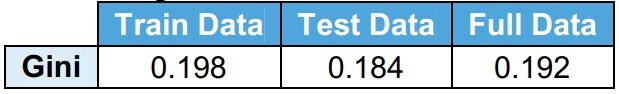
Formule: Gini = 2 x AUROC – 1
Gini se deriva de AUROC. Gini = 0.0 indique qu'il n'y a pas de pouvoir prédictif et Gini = 1.0 indique un pouvoir prédictif parfait. Le modèle développé avec des données de train est exécuté avec des données de test et des données complètes. On observe qu'il n'y a pas d'écart significatif dans les valeurs de Gini.
Kansas
scipy.stats.ks_2samp
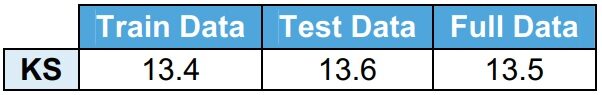
Le test de Kolmogorov-Smirnov (KS) mesure la séparation entre le % cumulé d'événements et le % cumulé d'aucun événement. On observe que les statistiques des tests KS sont inférieures à 40, ce qui indique que le modèle n'est pas capable de séparer les événements et les non-événements.
Graphiques de gain et d'altitude
Paso 1: Calculer la probabilité de chaque observation.
Paso 2: Classez ces probabilités par ordre décroissant.
Paso 3: Construisez des déciles avec chaque groupe ayant presque le 10% des constats.
Paso 4: Calculer le taux de réponse dans chaque décile pour Bien (répondeurs), Un peu (non-répondeurs) et totale.
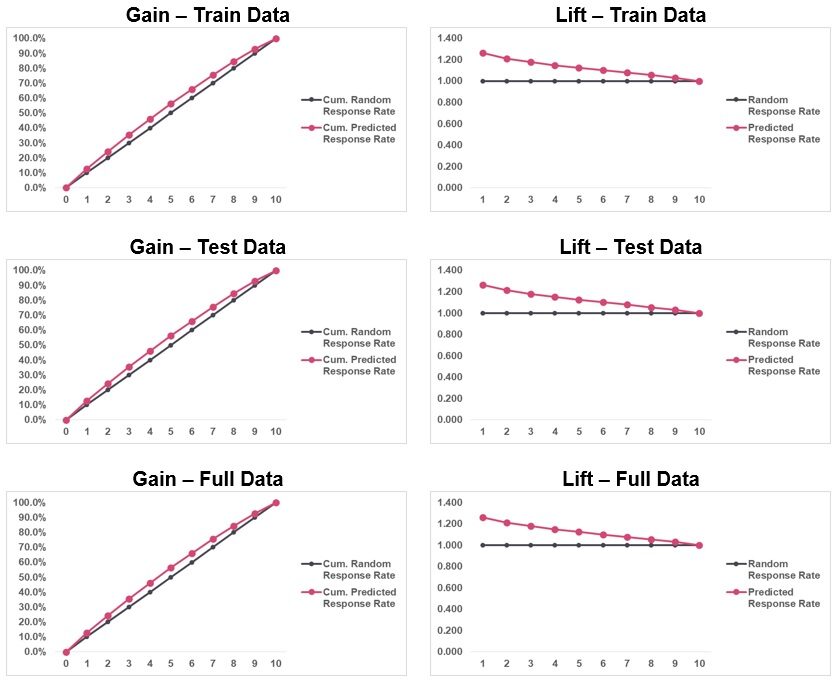
Les graphiques de gain et d'élévation sont des outils de visualisation de données qui comparent la capacité du classificateur à capturer le taux de réponse. On observe que le taux de réponse cumulé prédit est très proche du taux de réponse aléatoire cumulé. Indique que le modèle a un faible pouvoir prédictif. L'équipe de validation recommande d'utiliser des variables supplémentaires pour améliorer l'ajustement du modèle.
2.4 Essais sur modèle
Analyse de sensibilité
Paso 1: normaliser toutes les variables
Paso 2: exécuter la régression logistique entre la variable dépendante et la première
Paso 3: exécuter la régression logistique entre la variable dépendante et la seconde
Paso 4: répéter l'étape précédente pour le reste des variables
Paso 5: le coefficient de la variable indique la sensibilité entre la variable et les probabilités logarithmiques de la variable dépendante
La sensibilité du modèle vis-à-vis des variables numériques indépendantes est testée. La sensibilité est vérifiée sur les données du train. L'objectif de cet exercice est d'identifier les variables les plus sensibles. On observe que age et risk_score sont les variables les plus sensibles et ext_quality_score est la variable la moins sensible.

2.5. Coefficient de stabilité
Coefficient de stabilité
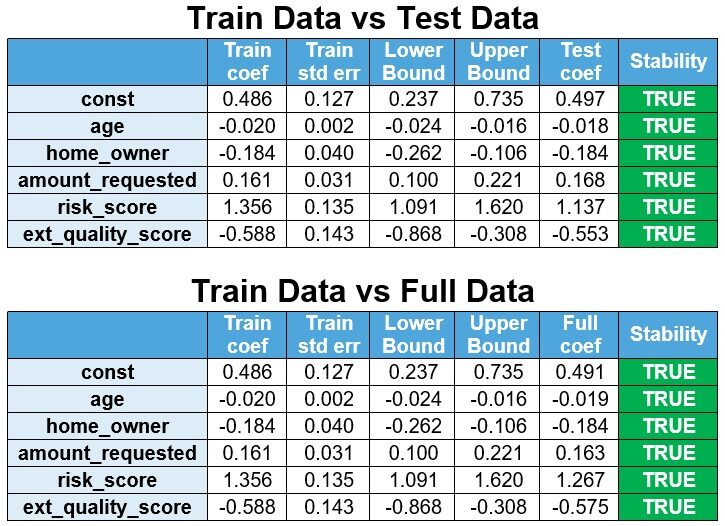
Le modèle est ré-estimé à partir des données de test et les données complètes et les coefficients sont comparés aux données du train. Si les coefficients du modèle réestimé sont dans l'intervalle de confiance du 95% (Coefficient de train ± 1,96 x Err std de tren), alors les coefficients sont stables.
La limite inférieure est définie comme Train Coef – 1,96 x Err std of train et la limite supérieure est définie comme Coef of train + 1,96 x Err std de tren. On constate que les coefficients sont stables.
Stabilité du signal
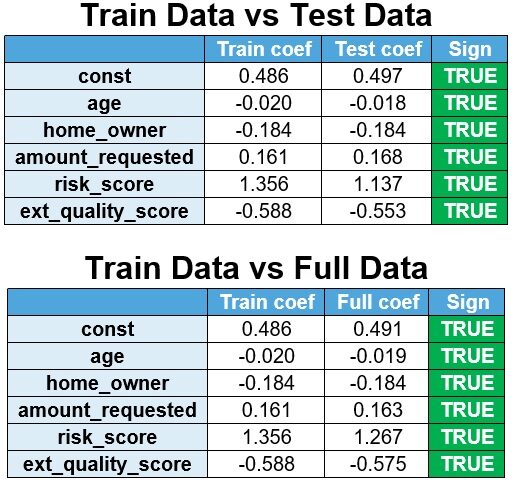
Le modèle est ré-estimé à partir des données de test et les données complètes et les coefficients sont comparés aux données du train.
Les signes sont stables.
conclusion
La validation a trouvé que le modèle était stable. Cependant, trois conclusions sérieuses ont été soulevées:
· Découverte 1 (des données d'entrée) – Il est observé qu'il y a des valeurs aberrantes dans l'ensemble de données de train. L'équipe de validation recommande que les valeurs aberrantes soient traitées avant de développer le modèle.
· Découverte 2 (des données d'entrée) – Notez que montant_demandé & ext_quality_score pas de fils linéaires. L'équipe de validation recommande de tester les transformations pour obtenir une relation linéaire.
· Résultat 3 (ajustement du modèle) – L'AUROC est faible, Gini est faible et KS est faible, ce qui indique que le modèle n'est pas capable de séparer les événements et les non-événements. L'équipe de validation recommande d'utiliser des variables supplémentaires pour améliorer l'ajustement du modèle.
Les médias présentés dans cet article ne sont pas la propriété de DataPeaker et sont utilisés à la discrétion de l'auteur.





