
Vue d'ensemble
- Hadoop fait partie des outils les plus populaires dans le domaine de l'ingénierie des données et du Big Data
- Voici une introduction à tout ce que vous devez savoir sur l'écosystème Hadoop.
introduction
Actuellement, nous avons plus de 4 un milliard d'internautes. En termes de données brutes, voilà à quoi ressemble la photo:
9.176 Tweets par seconde
1.023 Images Instagram téléchargées par seconde
5.036 Appels Skype par seconde
86,497 Recherches Google par seconde
86,302 Vidéos YouTube vues par seconde
2.957.983 E-mails envoyés par seconde
beaucoup plus…
C'est la quantité de données que nous traitons en ce moment: incroyable! On estime qu'à la fin de 2020 aura produit 44 zettaoctets de données. Voilà 44 * 10 ^ 21!
Cette énorme quantité de données générées à un rythme effréné et dans toutes sortes de formats est ce que nous appelons aujourd'hui Big Data. Mais il n'est pas possible de stocker ces données dans les systèmes traditionnels que nous utilisons depuis plus de 40 ans. Pour gérer ces mégadonnées, nous avons besoin d'un cadre beaucoup plus complexe composé non pas d'un seul, mais dans plusieurs composants qui gèrent différentes opérations.
Nous nous référons à ce cadre comme Hadoop et avec tous ses composants, appel Ecosistema HadoopL'écosystème Hadoop est un cadre open source conçu pour le traitement et le stockage de grands volumes de données. Il est composé de plusieurs composants clés, comme le Hadoop Distributed File System (HDFS) pour le stockage et MapReduce pour le traitement. En outre, il comprend des outils complémentaires tels que Hive, Pig et HBase, qui facilitent la gestion, l'analyse et la requête des données. Cet écosystème est fondamental dans le domaine du Big Data et le.... Mais parce qu'il y a tellement de composants dans cet écosystème Hadoop, Parfois, il peut être très difficile de vraiment comprendre et de se souvenir de ce que fait chaque composant et de sa place dans ce grand monde.
Ensuite, dans cet article, nous essaierons de comprendre cet écosystème et de décomposer ses composants.
Table des matières
- Problème avec les systèmes traditionnels
- Qu'est-ce que Hadoop?
- Composants de l'écosystème Hadoop
- HDFSHDFS, o Système de fichiers distribués Hadoop, Il s’agit d’une infrastructure clé pour stocker de gros volumes de données. Conçu pour fonctionner sur du matériel commun, HDFS permet la distribution des données sur plusieurs nœuds, Garantir une disponibilité élevée et une tolérance aux pannes. Son architecture est basée sur un modèle maître-esclave, où un nœud maître gère le système et les nœuds esclaves stockent les données, faciliter le traitement efficace de l’information.. (système de fichiers distribuéUn système de fichiers distribué (DFS) permet le stockage et l'accès aux données sur plusieurs serveurs, facilitant la gestion de grands volumes d'informations. Ce type de système améliore la disponibilité et la redondance, car les fichiers sont répliqués à différents endroits, ce qui réduit le risque de perte de données. En outre, permet aux utilisateurs d'accéder aux fichiers depuis différentes plateformes et appareils, favorisant la collaboration et.... Hadoop)
- Petite carte
- HILO
- HBaseHBase est une base de données NoSQL conçue pour gérer de grands volumes de données distribuées dans des clusters. Basée sur le modèle en colonnes, permet un accès rapide et évolutif à l'information. HBase s'intègre facilement avec Hadoop, ce qui en fait une option populaire pour les applications nécessitant le stockage et le traitement de grandes quantités de données. Sa flexibilité et sa capacité de croissance la rendent idéale pour les projets de big data....
- Porc
- Ruche
- SqoopSqoop est un outil open source conçu pour faciliter le transfert de données entre les bases de données relationnelles et l'écosystème Hadoop. Permet l'importation de données à partir de systèmes tels que MySQL, PostgreSQL et Oracle vers HDFS, ainsi que l'exportation de données depuis Hadoop vers ces bases de données. Sqoop optimise le processus grâce à la parallélisation des opérations, ce qui en fait une solution efficace pour le...
- Canal artificiel
- Kafka
- gardien de zoo
- Étincelle – étincelle
- Étapes du traitement des mégadonnées
Problème avec les systèmes traditionnels
Par les systèmes traditionnels, Je veux dire des systèmes comme les bases de données relationnelles et les entrepôts de données. Les organisations les utilisent depuis le passé 40 ans pour stocker et analyser vos données. Mais les données générées aujourd'hui ne peuvent pas être traitées par ces bases de données pour les raisons suivantes:
- La plupart des données générées aujourd'hui sont semi-structurées ou non structurées. Mais les systèmes traditionnels ont été conçus pour gérer uniquement des données structurées comportant des lignes et des colonnes bien conçues.
- Les bases de données de relations sont évolutives verticalement, ce qui signifie que vous devez ajouter plus de traitement, mémoire et stockage sur le même système. Cela peut coûter très cher
- Les données stockées aujourd'hui sont dans différents silos. Les collecter et les analyser à la recherche de modèles peut être une tâche très difficile.
Ensuite, Comment traitons-nous le Big Data? C'est là qu'intervient Hadoop !!
Qu'est-ce que Hadoop?
Les employés de Google ont également été confrontés aux défis mentionnés ci-dessus lorsqu'ils voulaient classer des pages sur Internet.. Ils ont trouvé que les bases de données relationnelles étaient très chères et inflexibles. Ensuite, ont trouvé leur propre solution originale. Ils ont créé le Système de fichiers Google (GFS).
GFS est un système de fichiers distribué qui surmonte les inconvénients des systèmes traditionnels. Fonctionne sur du matériel peu coûteux et fournit la parallélisation, évolutivité et fiabilité. Cela a servi de tremplin à l'évolution de Apache Hadoop.
Apache Hadoop est un framework open source basé sur le système de fichiers de Google qui peut gérer le Big Data dans un environnement distribué.. Cet environnement distribué est composé d'un groupe de machines travaillant en étroite collaboration pour donner l'impression d'une seule machine en fonctionnement..
Voici quelques-unes des propriétés Hadoop importantes que vous devez connaître:
- Hadoop est hautement évolutif car il gère les données de manière distribuée
- Par rapport à la mise à l'échelle verticale dans le SGBDR, Offres Hadoop échelle horizontale
- Créez et enregistrez des répliques de données en le faisant tolérance de panne
- Est économique puisque tous les nœuds du grappeUn cluster est un ensemble d’entreprises et d’organisations interconnectées qui opèrent dans le même secteur ou la même zone géographique, et qui collaborent pour améliorer leur compétitivité. Ces regroupements permettent le partage des ressources, Connaissances et technologies, favoriser l’innovation et la croissance économique. Les grappes peuvent couvrir une variété d’industries, De la technologie à l’agriculture, et sont fondamentaux pour le développement régional et la création d’emplois.... sont du matériel de base qui n'est rien d'autre que des machines économiques
- Hadoop utilise le concept de localité de données pour traiter les données sur les nœuds où elles sont stockées au lieu de déplacer les données sur le réseau, réduisant ainsi le trafic
- Il peut gérer tout type de données: structuré, semi-structuré et non structuré. Ceci est extrêmement important aujourd'hui car la plupart de nos données (courriers électroniques, Instagram, Twitter, Appareils IoT, etc.) n'ont pas de format défini.
À présent, Regardons les composants de l'écosystème Hadoop.
Composants de l'écosystème Hadoop
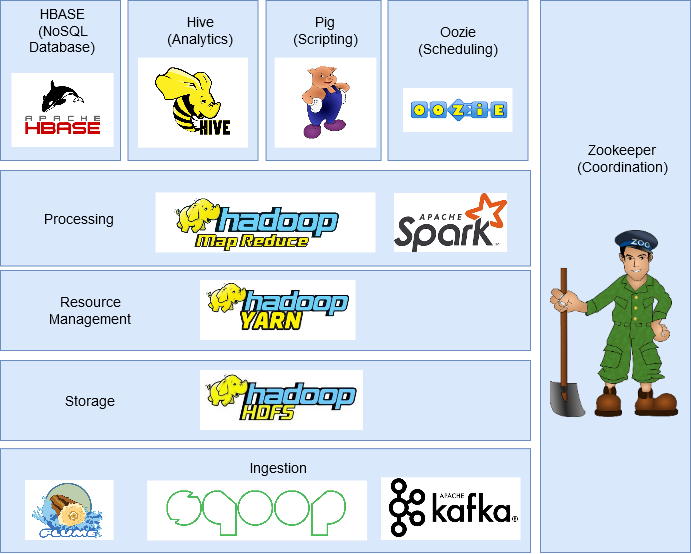
Dans cette section, nous aborderons les différentes composantes de l'écosystème Hadoop.
HDFS (Système de fichiers distribué Hadoop)
C'est le composant de stockage d'Hadoop qui stocke les données sous forme de fichiers.
Chaque fichier est divisé en blocs de 128 Mo (configurable) et les stocke sur différentes machines du cluster.
Il a une architecture maître-esclave avec deux composants principaux: NœudNodo est une plateforme digitale qui facilite la mise en relation entre les professionnels et les entreprises à la recherche de talents. Grâce à un système intuitif, Permet aux utilisateurs de créer des profils, Partager des expériences et accéder à des opportunités d’emploi. L’accent mis sur la collaboration et le réseautage fait de Nodo un outil précieux pour ceux qui souhaitent élargir leur réseau professionnel et trouver des projets qui correspondent à leurs compétences et à leurs objectifs.... de nom et nœud de données.
- Noeud de nom est le nœud principal et il n'y en a qu'un par cluster. Votre tâche est de savoir où se trouve chaque bloc qui appartient à un fichier dans le cluster.
- Nœud de données c'est lui nœud esclaveLe "nœud esclave" est un concept utilisé dans les réseaux et les systèmes distribués qui se réfère à un dispositif ou composant opérant sous la direction d'un nœud principal ou "nœud maître". Ce type d'architecture permet une gestion centralisée, où le nœud esclave exécute des tâches spécifiques, en collectant des données ou en exécutant des processus, pendant que le nœud maître coordonne les opérations de tout le système pour optimiser les performances et l'efficacité.... que almacena los bloques de datos y hay más de uno por clúster. Votre tâche consiste à récupérer les données si nécessaire. Reste en contact permanent avec le nœud de nom à travers les battements de cœur.
Petite carte
Pour gérer le Big Data, Hadoop est basé sur Algoritmo MapReduce introduit par Google et facilite la distribution d'un job et son exécution en parallèle dans un cluster. Essentiellement, divise une seule tâche en plusieurs tâches et les traite sur différentes machines.
En termes simples, fonctionne de manière à diviser pour mieux régner et exécute des processus sur des machines pour réduire le trafic réseau.
Il comporte deux phases importantes: Carte et zoom arrière.
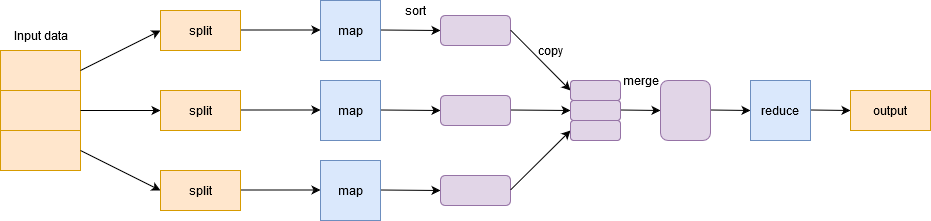
Phase cartographique filtre, regrouper et ordonner les données. Les données d'entrée sont divisées en plusieurs divisions. Chaque tâche de carte fonctionne sur une tranche de données parallèle sur différentes machines et génère une paire clé-valeur. La sortie de cette phase est actionnée par le réduire les devoirs et est connu comme le Réduire la phase. Ajouter les données, résume le résultat et le stocke dans HDFS.
HILO
FILYARN est un gestionnaire de paquets pour JavaScript qui permet l'installation et la gestion efficace des dépendances dans les projets de développement. Développé par Facebook, Il se caractérise par sa rapidité et sa sécurité par rapport à d'autres gestionnaires. YARN utilise un système de cache pour optimiser les installations et fournit un fichier de verrouillage pour garantir la cohérence des versions des dépendances dans différents environnements de développement.... o Yet Another Resource Negotiator administra los recursos en el clúster y administra las aplicaciones a través de Hadoop. Permet aux données stockées dans HDFS d'être traitées et exécutées par divers moteurs de traitement de données, comme traitement par lots, traitement des flux, traitement interactif, traitement graphique et bien d'autres. Cela augmente l'efficacité avec l'utilisation de YARN.
HBase
HBase est une base de données NoSQLLes bases de données NoSQL sont des systèmes de gestion de données caractérisés par leur flexibilité et leur évolutivité. Contrairement aux bases de données relationnelles, elles utilisent des modèles de données non structurés, comme les documents, clé-valeur ou graphes. Elles sont idéales pour les applications nécessitant la gestion de grands volumes d'information et une haute disponibilité, comme dans le cas des réseaux sociaux ou des services cloud. Sa popularité a augmenté dans.... basada en columnas. Il fonctionne sur HDFS et peut gérer tout type de données. Permet des opérations de traitement et de lecture en temps réel / écritures aléatoires effectuées sur les données.
Porc
PorcLe cochon, un mammifère domestiqué de la famille des Suidés, est connu pour sa polyvalence dans l'agriculture et la production alimentaire. Originaire d'Asie, son élevage s'est étendu dans le monde entier. Les cochons sont omnivores et possèdent une grande capacité d'adaptation à divers habitats. En outre, ils jouent un rôle important dans l'économie, fournissant de la viande, du cuir et d'autres produits dérivés. Leur intelligence et leur comportement social sont également... il a été développé pour analyser de grands ensembles de données et surmonte la difficulté d'écrire des fonctions map et reduce. Il se compose des composants: Pig Latin et Pig Engine.
Pig Latin est un langage de script de type SQL. Pig Engine est l'environnement d'exécution sur lequel s'exécute Pig Latin. Intérieurement, le code écrit en Pig est converti en fonctions de CarteRéduireMapReduce est un modèle de programmation conçu pour traiter et générer efficacement de grands ensembles de données. Propulsé par Google, Cette approche décompose le travail en tâches plus petites, qui sont répartis entre plusieurs nœuds d’un cluster. Chaque nœud traite sa partie, puis les résultats sont combinés. Cette méthode vous permet de faire évoluer les applications et de gérer d’énormes volumes d’informations, fondamental dans le monde du Big Data.... et cela le rend très facile pour les programmeurs qui ne maîtrisent pas Java.
Ruche
RucheHive est une plateforme de réseaux sociaux décentralisée qui permet à ses utilisateurs de partager du contenu et de se connecter avec d'autres sans l'intervention d'une autorité centrale. Elle utilise la technologie blockchain pour garantir la sécurité et la propriété des données. Contrairement à d'autres réseaux sociaux, Hive permet aux utilisateurs de monétiser leur contenu via des récompenses en cryptomonnaies, ce qui favorise la création et l'échange actif d'informations.... es un sistema de almacenamiento de datos distribuido desarrollado por Facebook. Permet une lecture facile, écriture et gestion de fichiers dans HDFS. Il a son propre langage de requête à des fins connues sous le nom de langage de requête Hive. (HQL), qui est très similaire à SQL. Cela permet aux programmeurs d'écrire très facilement des fonctions MapReduce à l'aide de simples requêtes HQL..
Sqoop
De nombreuses applications stockent encore des données dans des bases de données relationnelles, lo que las convierte en una Source des donnéesOngle "Source des données" désigne tout lieu ou support où des informations peuvent être obtenues. Ces sources peuvent être à la fois primaires et, tels que les enquêtes et les expériences, en tant que secondaire, comme bases de données, articles universitaires ou rapports statistiques. Le bon choix d’une source de données est crucial pour garantir la validité et la fiabilité des informations dans la recherche et l’analyse.... très important. Donc, Sqoop joue un rôle important dans le transfert des données des bases de données relationnelles vers HDFS.
Les commandes écrites dans Sqoop sont converties en interne en tâches MapReduce qui s'exécutent dans HDFS. Fonctionne avec presque toutes les bases de données relationnelles comme MySQL, Postgres, SQLite, etc. Peut également être utilisé pour exporter des données de HDFS vers RDBMS.
Canal artificiel
BuseFlume est un logiciel open source conçu pour la collecte et le transport de données. Il utilise une approche basée sur les flux, ce qui permet de transférer des données de diverses sources vers des systèmes de stockage tels que Hadoop. Son architecture modulaire et évolutive facilite l'intégration avec de multiples sources de données, ce qui en fait un outil précieux pour le traitement et l'analyse de grands volumes d'informations en temps réel.... es un servicio de código abierto, fiable et disponible qui est utilisé pour collecter, ajouter et déplacer efficacement de grandes quantités de données de plusieurs sources de données vers HDFS. Peut collecter des données en temps réel et en mode batch. A une architecture flexible et est tolérant aux pannes avec plusieurs mécanismes de récupération.
Kafka
Il existe de nombreuses applications qui génèrent des données et un nombre proportionnel d'applications qui consomment ces données. Mais les connecter individuellement est une tâche difficile. C'est là qu'intervient Kafka. Il fait partie des applications qui génèrent des données (producteurs) et les applications qui consomment des données (consommateurs).
Kafka est distribué et partitionné, la réplicationLa réplication est un processus fondamental en biologie et en science, qui se réfère à la duplication de molécules, cellules ou informations génétiques. Dans le contexte de l'ADN, la réplication assure que chaque cellule fille reçoive une copie complète du matériel génétique lors de la division cellulaire. Ce mécanisme est crucial pour la croissance, le développement et le maintien des organismes, ainsi que pour la transmission des caractéristiques héréditaires aux générations futures.... et la tolérance aux pannes intégrée. Il peut gérer les données en streaming et permet également aux entreprises d'analyser les données en temps réel.
Oozie
OozieOozie est un système de gestion des travaux orienté vers les flux de données, conçu pour coordonner les travaux dans Hadoop. Permet aux utilisateurs de définir et de planifier des travaux complexes, en intégrant des tâches MapReduce, Porc, Hive et autres. Oozie utilise une approche basée sur XML pour décrire les flux de travail et leur exécution, facilitant l'orchestration des processus dans des environnements de big data. Sa fonctionnalité améliore l'efficacité du traitement... es un sistema de programación de flujo de trabajo que permite a los usuarios vincular trabajos escritos en varias plataformas como MapReduce, Ruche, Porc, etc. Avec Oozie, vous pouvez planifier une tâche à l'avance et créer un pipeline de tâches individuelles à exécuter séquentiellement ou en parallèle pour accomplir une tâche plus importante.. Par exemple, vous pouvez utiliser Oozie pour effectuer des opérations ETL sur les données, puis enregistrer la sortie sur HDFS.
gardien de zoo
Dans un cluster Hadoop, la coordination et la synchronisation des nœuds peuvent être une tâche difficile. Pourtant, gardien de zoo"gardien de zoo" est un jeu vidéo de simulation lancé en 2001, où les joueurs assument le rôle d'un gardien de zoo. La mission principale consiste à gérer et à prendre soin de diverses espèces d'animaux, en veillant à leur bien-être et à la satisfaction des visiteurs. Tout au long du jeu, les utilisateurs peuvent concevoir et personnaliser leur zoo, en affrontant des défis incluant l'alimentation, l'habitat et la santé des animaux.... es la herramienta perfecta para resolver el problema.
C'est un service open source, distribué et centralisé pour maintenir les informations de configuration, appeler, fournir une synchronisation distribuée et fournir des services de groupe à travers le cluster.
Étincelle – étincelle
Spark est un framework alternatif à Hadoop construit en Scala, mais prend en charge diverses applications écrites en Java, Python, etc. Par rapport à MapReduce, fournit un traitement en mémoire qui représente un traitement plus rapide. En plus du traitement par lots proposé par Hadoop, peut également gérer le traitement en temps réel.
En outre, Spark a son propre écosystème:
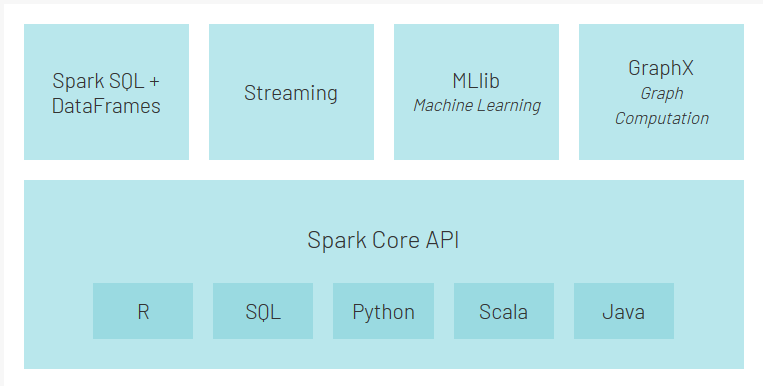
- Noyau d'étincelle est le moteur d'exécution principal de Spark et d'autres API construites dessus
- API de Spark SQL vous permet d'interroger des données structurées stockées dans des DataFrames ou des tables Hive
- API de diffusion en continu permet à Spark de gérer les données en temps réel. Il peut être facilement intégré à une variété de sources de données telles que Flume, Kafka et Twitter.
- MLlib est une bibliothèque de machine learning évolutive qui vous permettra d'effectuer des tâches de science des données tout en profitant des propriétés Spark en même temps
- GraphX est un moteur de calcul graphique qui permet aux utilisateurs de construire, transformer et raisonner de manière interactive sur des données structurées en graphiques à l'échelle et est livré avec une bibliothèque d'algorithmes communs
Étapes du traitement des mégadonnées
Avec autant de composants au sein de l'écosystème Hadoop, peut être assez intimidant et difficile à comprendre à quoi sert chaque composant. Donc, il est plus facile de regrouper certains des composants en fonction de leur emplacement dans la phase de traitement du Big Data.
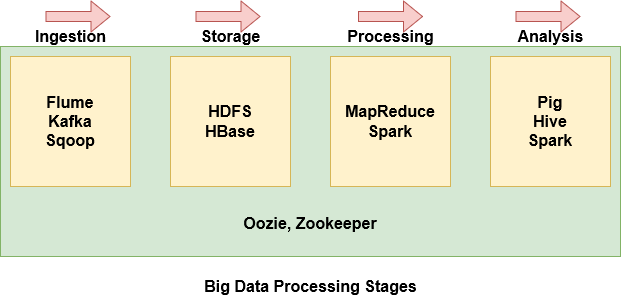
- Buse, Kafka et Sqoop sont utilisés pour ingérer des données de sources externes dans HDFS
- HDFS est le lecteur de stockage d'Hadoop. Même les données importées de Hbase sont stockées dans HDFS
- MapReduce et Spark sont utilisés pour traiter les données dans HDFS et effectuer diverses tâches
- Porc, Hive et Spark sont utilisés pour analyser les données.
- Oozie aide à planifier les tâches. Puisqu'il fonctionne avec différentes plates-formes, utilisé à toutes les étapes.
- Zookeeper synchronise les nœuds du cluster et est également utilisé à toutes les étapes.
Remarques finales
J'espère que cet article a été utile pour comprendre le Big Data, pourquoi les systèmes traditionnels ne peuvent pas le gérer et quels sont les composants importants de l'écosystème Hadoop.
Je vous encourage à consulter d'autres articles sur le Big Data qui pourraient vous être utiles:





