
Cos'è la regressione logistica?
Este artículo asume que posee conocimientos básicos y comprensión de los conceptos de aprendizaje automático, como el vector de destino, la matriz de características y términos relacionados.
Regressione logistica: probablemente uno de los algoritmos de aprendizaje automático supervisado más interesantes en el aprendizaje automático. A pesar de tener “Regressione” en su nombre, Regresión logística es un método supervisado de uso popular. Classificazione Algoritmo. Regressione logistica, junto con sus primos relacionados a saber. Regresión logística multinomial, nos otorga la capacidad de predecir si una observación pertenece a una determinada clase utilizando un enfoque que es sencillo, fácil de entender y sigue.
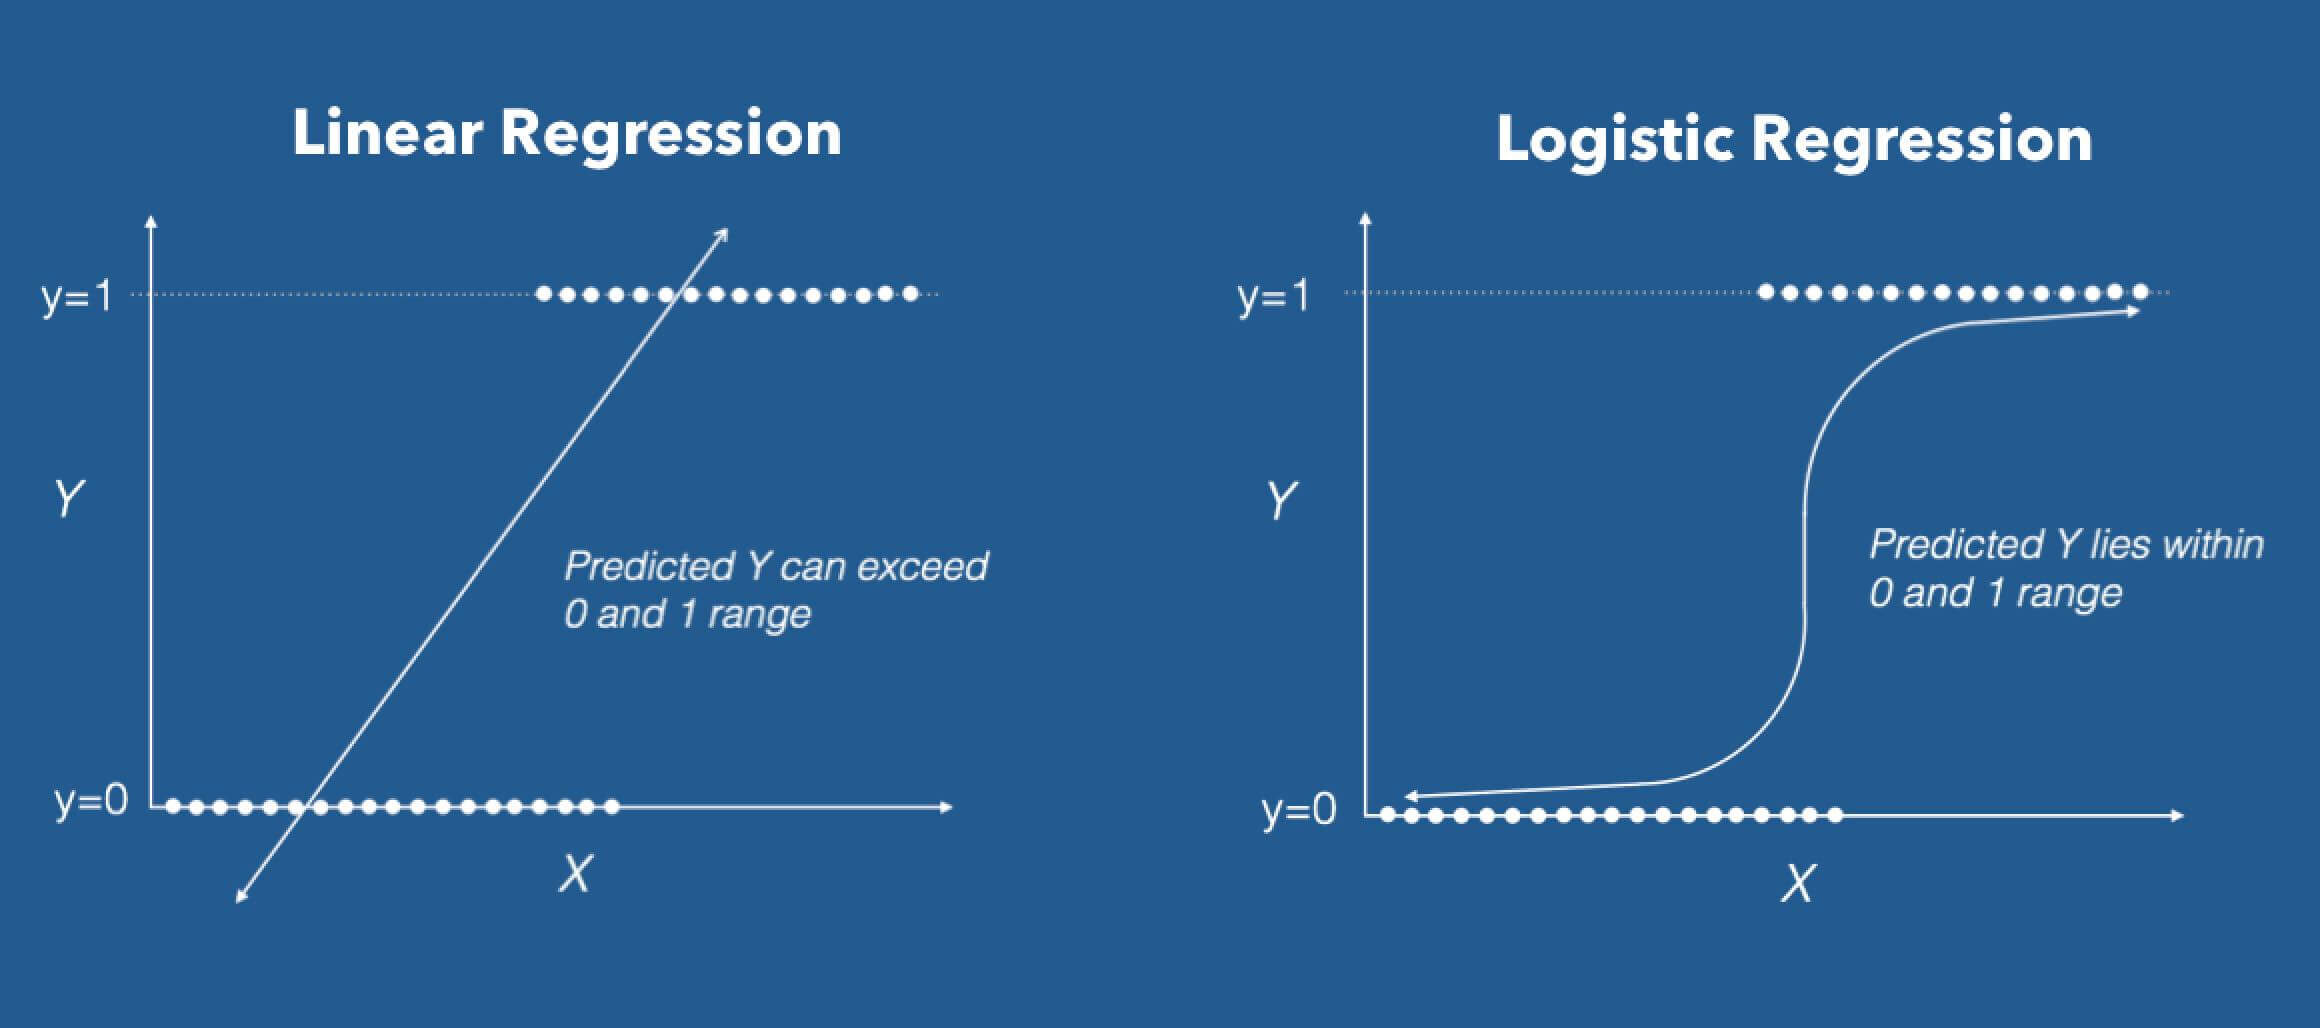
Fonte: DZone
Regresión logística en su forma base (di defecto) è un Clasificador binario. Esto significa que el vector objetivo solo puede tomar la forma de uno de dos valores. En la fórmula del algoritmo de regresión logística, tenemos un modelo lineal, ad esempio, B0 + B1X, que está integrado en una función logística (también conocida como función sigmoidea). La fórmula del Clasificador Binario que tenemos al final es la siguiente:
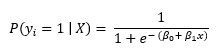

- P (eio = 1 | X) es la probabilidad de la ins Observaciones valor objetivo, eio perteneciente a la clase 1.
- Β0 y1 son los parametriIl "parametri" sono variabili o criteri che vengono utilizzati per definire, misurare o valutare un fenomeno o un sistema. In vari campi come la statistica, Informatica e Ricerca Scientifica, I parametri sono fondamentali per stabilire norme e standard che guidano l'analisi e l'interpretazione dei dati. La loro corretta selezione e gestione sono fondamentali per ottenere risultati accurati e pertinenti in qualsiasi studio o progetto.... que se deben aprender.
- me representa el número de Euler.
Objetivo principal de la fórmula de regresión logística.
La fórmula de regresión logística tiene como objetivo limitar o restringir la salida lineal y / o sigmoidea entre un valor de 0 e 1. La razón principal es para propósitos de interpretabilidad, vale a dire, podemos leer el valor como una probabilidad simple; Lo que significa que si el valor es mayor que 0,5, se predeciría la clase uno; altrimenti, se predice la clase 0.
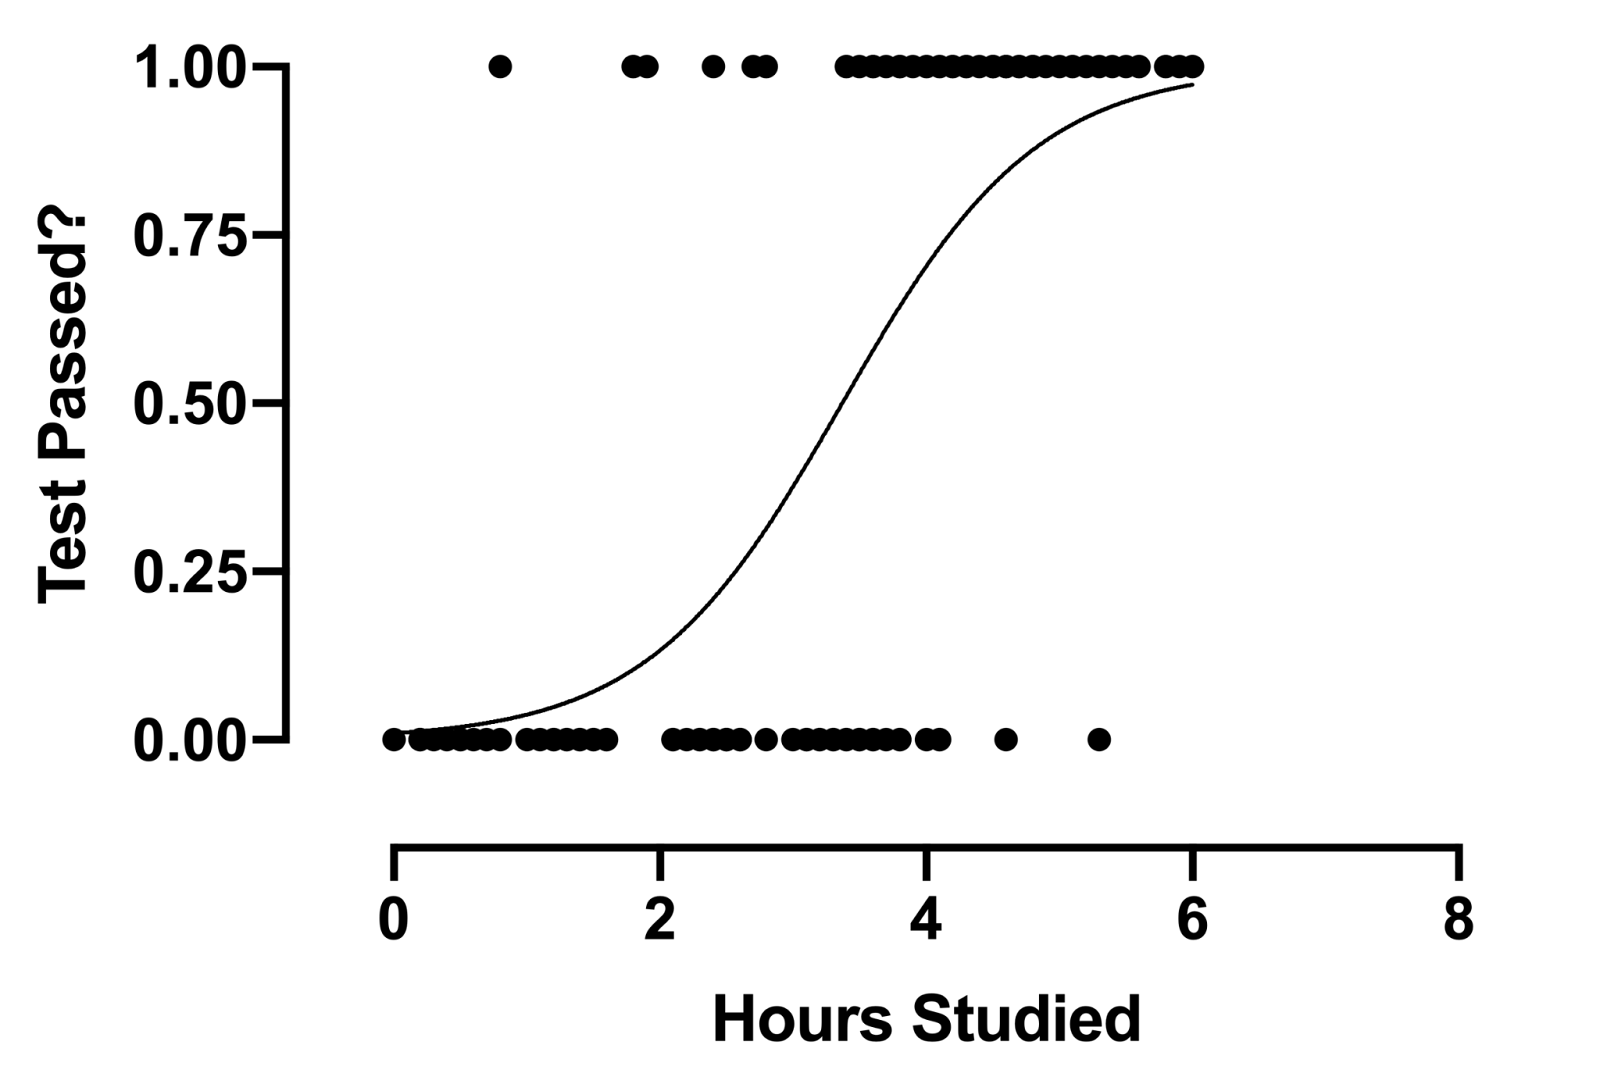
Fonte: GraphPad
Implementazione Python.
Ahora veremos la implementación del lenguaje de programación Python. Para este ejercicio, usaremos el conjunto de datos de la ionosfera que está disponible para descargar desde el Repository di machine learning UCI.
# Iniziamo importando i pacchetti necessari
# to be used for the Machine Learning problem

import pandas as pd
import numpy as np
from sklearn.linear_model import LogisticRegression
from sklearn.preprocessing import StandardScaler

# We read the data into our system using Pandas'
# 'read_csv' method. This transforms the .csv file
# into a Pandas DataFrame object.

dataframe = pd.read_csv('ionosphere.data', header=None)

# We configure the display settings of the
# Pandas DataFrame.

pd.set_option('display.max_rows', 10000000000)
pd.set_option('display.max_columns', 10000000000)
pd.set_option('display.width', 95)

# Vediamo la forma del dataframe. Nello specifico
# il numero di righe e colonne presenti.
Stampa(Questo DataFrame ha %d Righe e %d Colonne'%(dataframe.shape))
La salida al codice anterior sería la siguiente (la forma del marco de datos):

# Stampiamo le prime cinque righe del nostro dataframe.
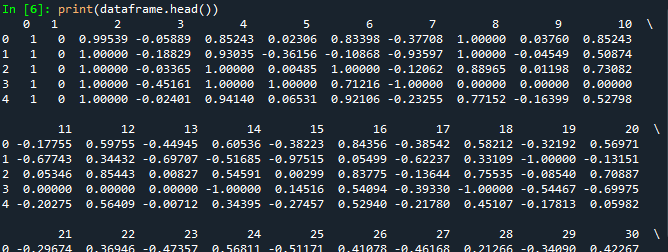
Stampa(dataframe.head())
La salida del codice anterior se verá de la siguiente manera (la siguiente salida está truncada):
# Isolaamo la matrice delle caratteristiche dal DataFrame.
features_matrix = dataframe.iloc[:, 0:34]

# Isolaamo il vettore target dal DataFrame.
target_vector = dataframe.iloc[:, -1]

# Controlliamo la forma della matrice delle caratteristiche, e del vettore target.
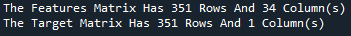
Stampa(La matrice delle caratteristiche ha %d righe e %d colonna(S)'%(features_matrix.shape))
Stampa(La matrice target ha %d righe e %d colonna(S)'%(np.array(target_vector).rimodellare(-1, 1).forma))
L'output per la forma della nostra matrice di caratteristiche e del vettore obiettivo sarebbe il seguente:

# Usiamo lo StandardScaler di scikit-learn per
# preprocessare i dati della matrice delle caratteristiche. Questo servirà a
# assicurare che tutti i valori in input siano sulla stessa
# scala per l'algoritmo.

features_matrix_standardized = StandardScaler().fit_transform(features_matrix)

# Creiamo un'istanza dell'algoritmo LogisticRegression
# Utilizziamo i valori di default per i parametri e
# iperparametri.

algoritmo = LogisticRegression(penalty='l2', dual=False, tol=1e-4,
C=1,0, fit_intercept=True,
intercept_scaling=1, class_weight=Nessuno,
random_state=Nessuno, solver="lbfgs",
max_iter=100, multi_class="auto",
verboso=0, warm_start=False, n_jobs=None,
l1_ratio=None)

# Utilizziamo il metodo 'fit' per condurre la
# processo di addestramento sulla nostra matrice di caratteristiche e vettore target.

Logistic_Regression_Model = algoritmo.fit(features_matrix_standardized, target_vector)
# Creiamo un'osservazione con valori, in ordine
# per testare il potere predittivo del nostro modello.

osservazione = [[1, 0, 0.99539, -0.05889, 0.8524299999999999, 0.02306,
0.8339799999999999, -0.37708, 1.0, 0.0376,
0.8524299999999999, -0.17755, 0.59755, -0.44945, 0.60536,
-0.38223, 0.8435600000000001, -0.38542, 0.58212, -0.32192,
0.56971, -0.29674, 0.36946, -0.47357, 0.56811, -0.51171,
0.41078000000000003, -0.46168000000000003, 0.21266, -0.3409,
0.42267, -0.54487, 0.18641, -0.453]]
# Memorizziamo il valore della classe prevista in una variabile
# chiamata 'previsioni'.

previsioni = Logistic_Regression_Model.prevedere(osservazione)
# Stampiamo la classe prevista del modello per l'osservazione.
Stampa('Il modello ha previsto che l'osservazione appartenesse a una classe %s'%(predizioni))
La salida al bloque de código anterior debe ser la siguiente:


# Vediamo le classi specifiche per cui il modello è stato addestrato a prevedere.

Stampa(L'algoritmo è stato addestrato a prevedere una delle due classi: %s'%(algorithm.classes_))
La salida al bloque de código anterior se verá de la siguiente manera:


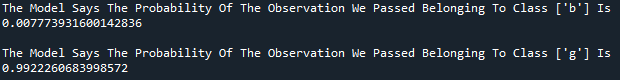
Stampa("""Il modello dice la probabilità dell'osservazione che abbiamo superato appartenga alla classe ['b'] Is %s"""%(algorithm.predict_proba(osservazione)[0][0]))
Stampa()
Stampa("""Il modello dice la probabilità dell'osservazione che abbiamo superato appartenga alla classe ['g'] Is %s"""%(algorithm.predict_proba(osservazione)[0][1]))
El risultato esperado sería el siguiente:
conclusione.
Con esto concluye mi article. Ahora entendemos la logica dietro di questo algoritmo di aprendizaje automático supervisado y sabemos cómo implementarlo en un problema de clasificación binaria.
Grazie per il tuo tempo.
Il supporto mostrato in questo articolo non è di proprietà di DataPeaker e viene utilizzato a discrezione dell'autore.





