
Questo articolo è stato pubblicato nell'ambito del Blogathon sulla scienza dei dati
w
- Questo articolo le fornirà una comprensione di base di come funziona l'analisi del testo.
- Conoscere i diversi passaggi del processo di PLN
- Derivazione del sentimento generale del testo.
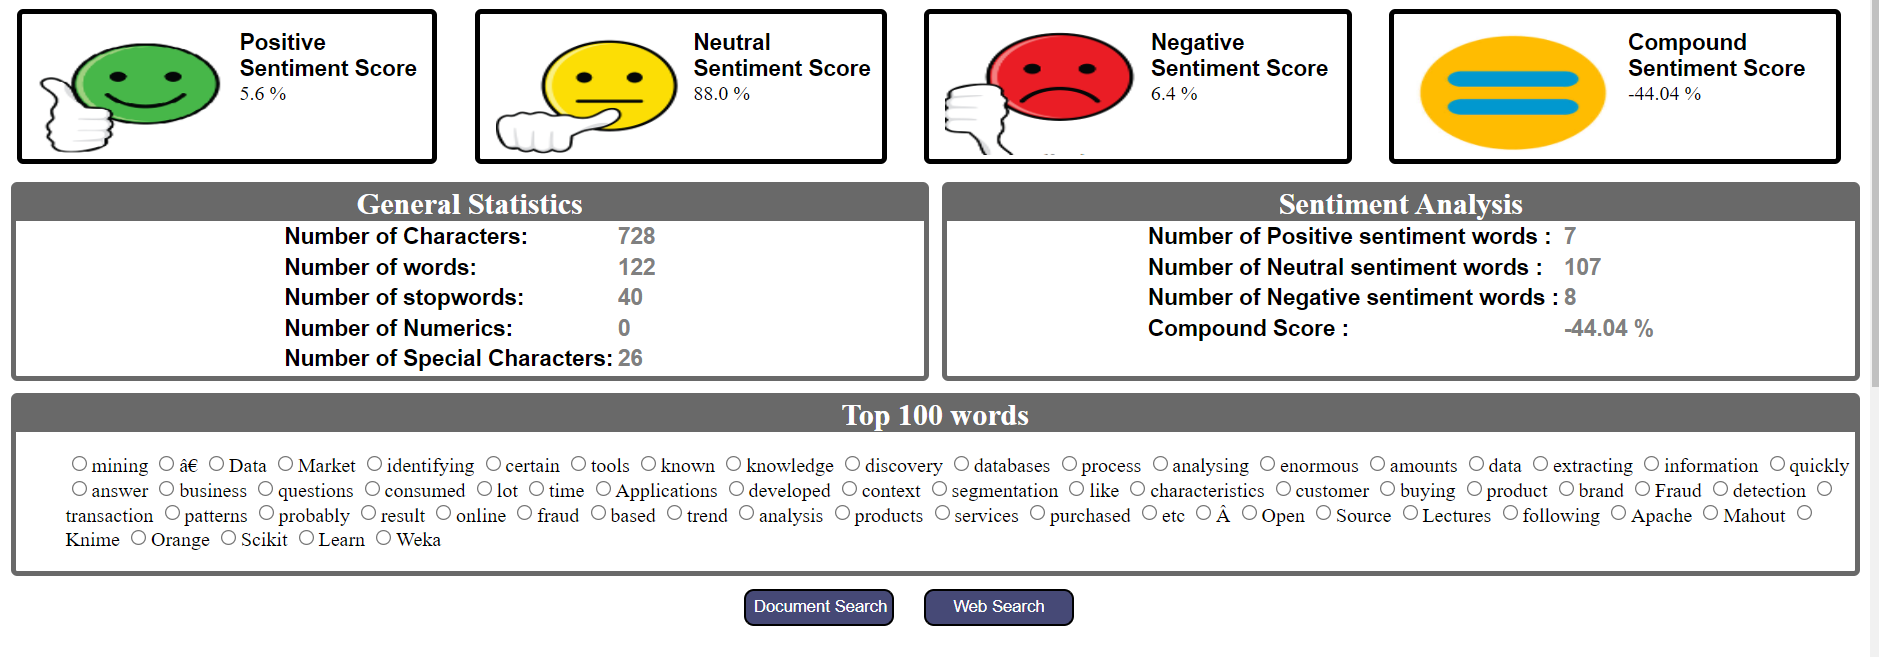
- Cruscotto che mostra le statistiche generali e l'analisi dei sentimenti del testo.
Astratto
In questa era digitale moderna, viene generata una grande quantità di informazioni ogni secondo. La maggior parte dei dati che gli esseri umani generano tramite messaggi, tweet, blog, articoli di notizie, raccomandazioni di prodotti e recensioni di WhatsApp non sono strutturati. Quindi, per ottenere informazioni utili da questi dati altamente destrutturati, dobbiamo prima convertirli in forma strutturata e normalizzata.
Elaborazione del linguaggio naturale (PNL) es una clase de inteligencia artificial que realiza una serie de procesos sobre estos datos no estructurados para obtener información significativa. El procesamiento del lenguaje es de naturaleza completamente no determinista porque el mismo lenguaje puede tener diferentes interpretaciones. Se vuelve tedioso porque algo adecuado para una persona no es adecuado para otra. Cosa c'è di più, el uso de lenguaje coloquial, acrónimos, hashtag con palabras adjuntas, emoticonos posee una sobrecarga para su preprocesamiento.
Si le interesa el poder de la analiticoL'analisi si riferisce al processo di raccolta, Misura e analizza i dati per ottenere informazioni preziose che facilitano il processo decisionale. In vari campi, come business, Salute e sport, L'analisi può identificare modelli e tendenze, Ottimizza i processi e migliora i risultati. L'utilizzo di strumenti avanzati e tecniche statistiche è fondamentale per trasformare i dati in conoscenze applicabili e strategiche.... de redes sociales, este articolo è il punto de partida para usted. Este articolo cubre los conceptos básicos de análisis de texto y le fornisce un tutorial paso a paso para realizar el procesamiento del lenguaje natural sin el requisito de ningún conjunto de datos de addestramentoLa formazione è un processo sistematico volto a migliorare le competenze, conoscenze o abilità fisiche. Viene applicato in vari ambiti, come lo sport, Formazione e sviluppo professionale. Un programma di allenamento efficace include la pianificazione degli obiettivi, Pratica regolare e valutazione dei progressi. L'adattamento alle esigenze individuali e la motivazione sono fattori chiave per ottenere risultati di successo e sostenibili in qualsiasi disciplina.....
Introducción a la PNL
El procesamiento del lenguaje natural es el subcampo de la inteligencia artificial que comprende procesos sistemáticos para converter datos no estructurados en información significativa y extraer conocimientos útiles de los mismos. La PNL se clasifica además en dos categorías amplias: PNL basada en reglas y PNL estadístico. La PNL basada en reglas utiliza un razonamiento básico para procesar tareas, por lo que se requiere un esfuerzo manual sin mucho entrenamiento del conjunto de datos. La PNL estadística, In secondo luogo, allena una grande quantità di dati e ottiene informazioni da essi. Utilizza algoritmi di apprendimento automatico per addestrarlo. In questo articolo, impareremo l'LPN basata su regole.
Applicazioni PNL:
- Riepilogo del testo
- Macchina del traduttore
- Sistemi di domande e risposte
- Controlli ortografici
- Completamento automatico
- Analisi del sentimento
- Riconoscimento vocale
- SegmentazioneLa segmentazione è una tecnica di marketing chiave che comporta la divisione di un ampio mercato in gruppi più piccoli e omogenei. Questa pratica consente alle aziende di adattare le proprie strategie e i propri messaggi alle caratteristiche specifiche di ciascun segmento, migliorando così l'efficacia delle tue campagne. Il targeting può essere basato su criteri demografici, psicografico, geografico o comportamentale, facilitando una comunicazione più pertinente e personalizzata con il pubblico di destinazione.... di argomenti
Canalizzazione NLP:
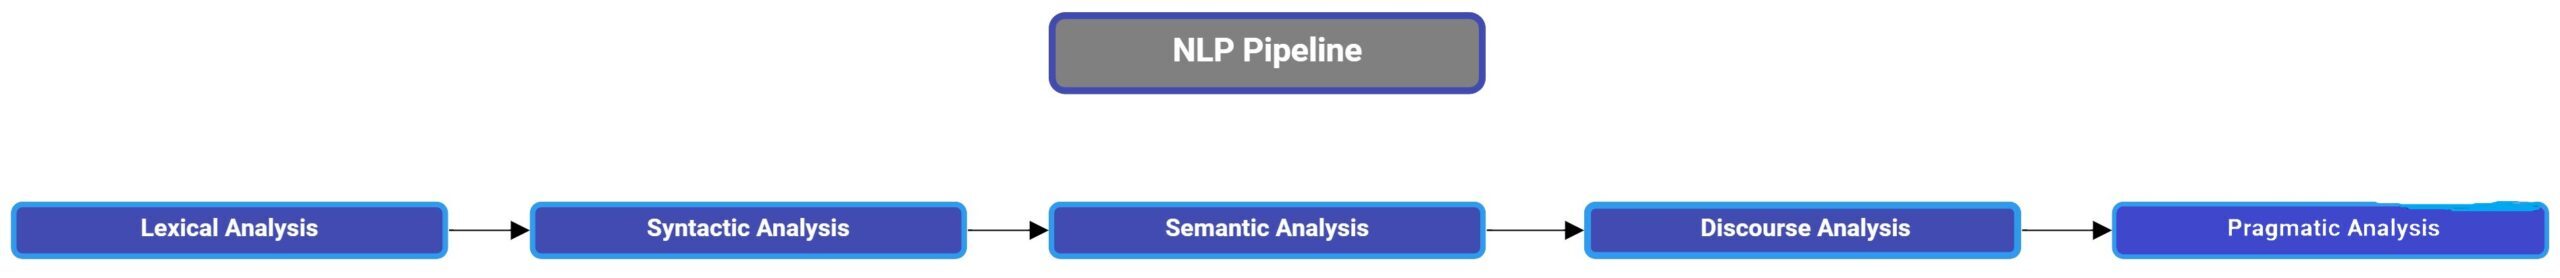
La canalizzazione NLP è suddivisa in cinque sottocompiti:
1. Analisi lessicale: L'analisi lessicale è il processo di analizzare la struttura di parole e frasi presenti nel testo. Il lessico è definito come il frammento identificabile più piccolo del testo. Potrebbe essere una parola, frase, eccetera. Comporta identificare e suddividere tutto il testo in frasi, paragrafi e parole.
2. Analisi sintattica: L'analisi sintattica è il processo di ordinare le parole in un modo che mostri la relazione tra le parole. Implica analizzarle alla ricerca di schemi grammaticali. Ad esempio, la frase “L'università va per la bambina”. è respinta dall'analizzatore sintattico.
3. Analisi semantica: L'analisi semantica è il processo di analizzare il testo per determinarne il significato. Considera le strutture sintattiche per mappare gli oggetti nel dominio del compito. Ad esempio, la frase “Vuole mangiare gelato caldo” è respinta dall'analizzatore semantico.
4. Integrazione di divulgazione: L'integrazione della divulgazione è il processo di studiare il contesto del testo. Le frasi sono organizzate in un ordine significativo per formare un paragrafo, ciò significa che la frase prima di una frase in particolare è necessaria per comprendere il significato generale. Cosa c'è di più, la frase che segue una frase dipende dalla precedente.
5. Analisi pragmatica: L'analisi pragmatica è definita come il processo di riconfermare che ciò che il testo significava davvero è lo stesso di quanto derivato.
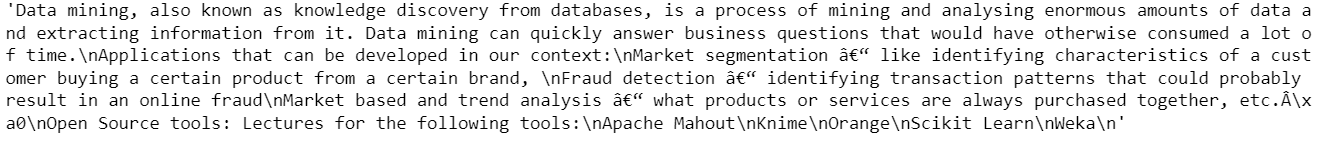
Lettura del file di testo:
filename = "C:UsersDellDesktopexample.txt"
text = open(nome del file, "R").leggere()
Stampare il testo:
Stampa(testo)
Installazione della libreria per NLP:
Useremo la libreria spaCy per questo tutorial. spazio è una libreria software open source per NLP avanzata scritta nei linguaggi di programmazione Python e Cython. La libreria è pubblicata sotto una licenza MIT. A differenza di NLTK, que se usa ampliamente para la enseñanza y la investigación, spaCy se enfoca en proporcionar software para uso en producción. spaCy también admite flujos de trabajo de apprendimento profondoApprendimento profondo, Una sottodisciplina dell'intelligenza artificiale, si affida a reti neurali artificiali per analizzare ed elaborare grandi volumi di dati. Questa tecnica consente alle macchine di apprendere modelli ed eseguire compiti complessi, come il riconoscimento vocale e la visione artificiale. La sua capacità di migliorare continuamente man mano che vengono forniti più dati lo rende uno strumento chiave in vari settori, dalla salute... que permiten conectar modelos estadísticos entrenados por bibliotecas de aprendizaje automático populares como TensorFlow, Pytorch a través de su propia biblioteca de aprendizaje automático Thinc.[Wikipedia]
pip install -U pip setuptools wheel
pip install -U spacy
Ya que estamos tratando con el idioma inglese. Entonces necesitamos instalar el en_core_web_sm paquete para ello.
python -m spacy download en_core_web_sm
Verificando que la descarga fue exitosa e importando el paquete spacy:
import spacy
nlp = spacy.load('en_core_web_sm')
Después de la creación exitosa del objeto NLP, podemos pasar al preprocesamiento.
Tokenizzazione:
La tokenizzazione è il processo di convertire tutto il testo in una serie di parole conosciute come token. Questo è il primo passo in qualsiasi processo di NLP. Divide tutto il testo in unità significative.
text_doc = nlp(testo)
Stampa ([token.text per token in text_doc])
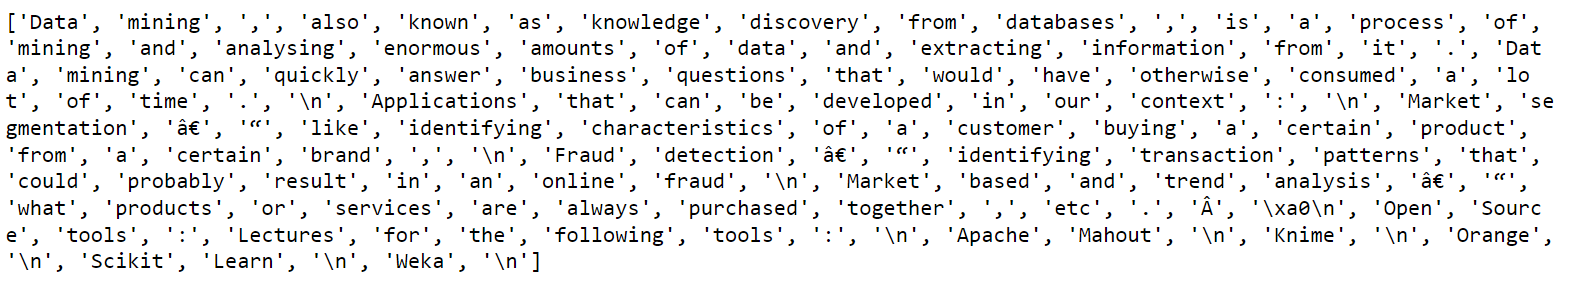
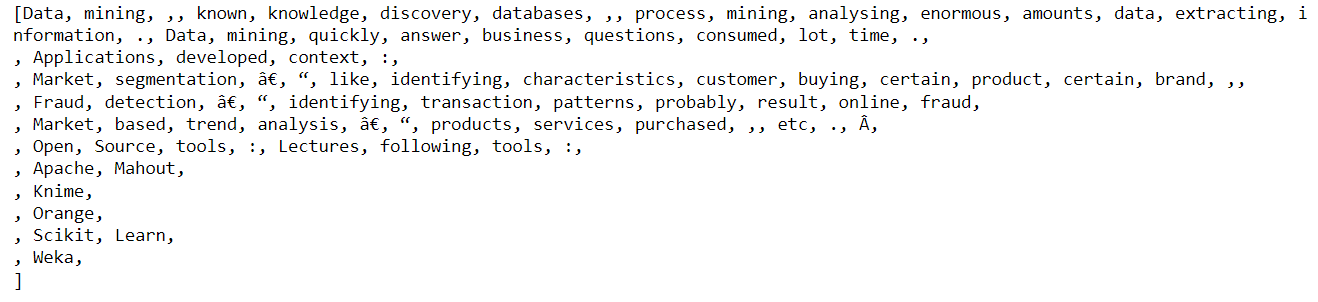
Come possiamo osservare nei token, ci sono molti spazi vuoti, virgole, parole vuote che non servono a nulla da una prospettiva di analisi.
Identificazione della frase
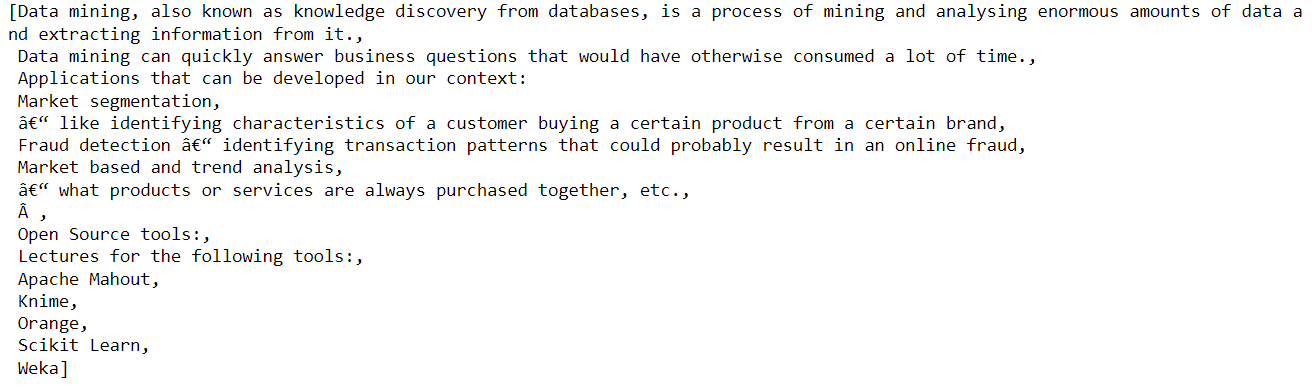
Identificare le frasi del testo è utile quando vogliamo configurare parti significative del testo che avvengono insieme. Per questo è utile trovare frasi.
about_doc = nlp(about_text)
sentences = list(about_doc.sents)
Rimozione di parole irrilevanti
Le parole vuote si definiscono come parole che appaiono frequentemente nel linguaggio. No tienen ningún papel significativo en el análisis de texto y obstaculizan el análisis de distribución de frecuenciasLa distribución de frecuencias es una herramienta estadística que organiza y resume datos en intervalos o categorías, facilitando su análisis. Permite visualizar la frecuencia con la que ocurren diferentes valores en un conjunto de datos, ya sea mediante tablas o gráficos. Esta técnica es fundamental en la estadística descriptiva, ya que ayuda a identificar patrones, tendencias y la dispersión de los datos, apoyando la toma de decisiones informadas..... Ad esempio, il, un, un, oh, eccetera. Perciò, deben eliminarse del texto para obtener una imagen más clara del texto.
normalized_text = [token per token in text_doc if not token.is_stop]
Stampa (normalized_text)
Eliminación de puntuación:
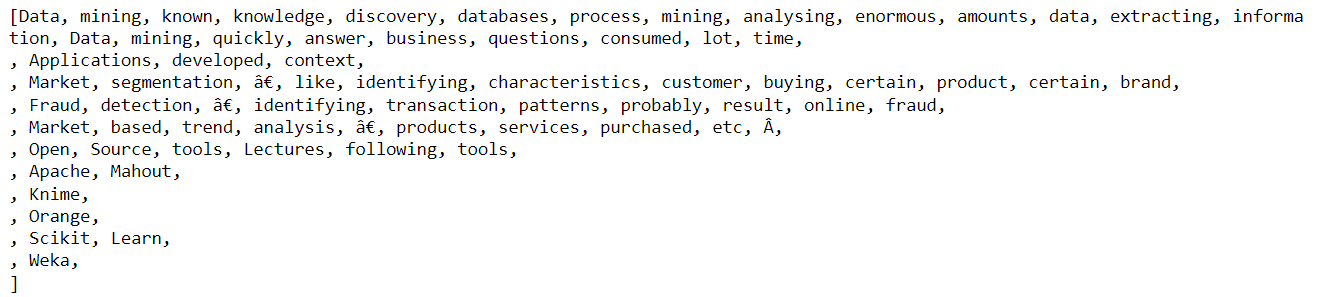
Como podemos ver en el resultado anterior, hay signos de puntuación que no nos sirven. Así que eliminémoslos.
clean_text = [token per token in normalized_text if not token.is_punct]
Stampa (testo_pulito)
Lematizzazione:
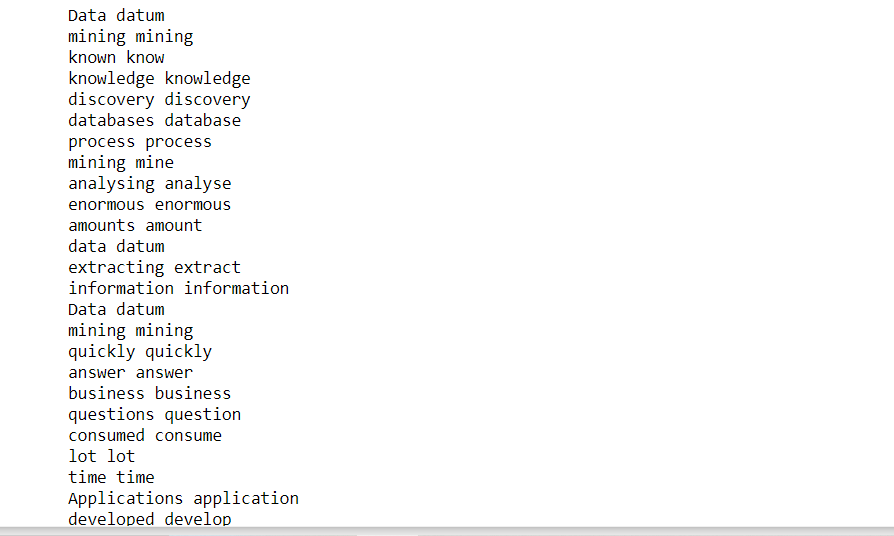
La lematización es el proceso de reducir una palabra a su forma original. Lema es una palabra que rappresenta un grupo de palabras llamadas lexemas. Ad esempio: participar, participar, participar. Todos se reducen a un lema común, vale a dire, participar.
for token in clean_text:
Stampa (gettone, token.lemma_)
Recuento de frecuencia de palabras:
Eseguiamo ora un'analisi statistica del testo. Troveremo le prime dieci parole secondo la loro frequenza nel testo.
from collections import Counter
words = [token.text per token in clean_text se non token.is_stop e non token.is_punct]
word_freq = Counter(parole)
# 10 commonly occurring words with their frequencies
common_words = word_freq.most_common(10)
Stampa (common_words)

Analisi del sentimento
L'analisi del sentimento è il processo di analizzare il sentimento del testo. Un modo per farlo è attraverso la polarità delle parole, sia che esse siano positive o negative.
VADER (Valence Aware Dictionary and Sentiment Reasoner) è una libreria di analisi dei sentimenti basata su regole e lessico in Python. Utilizza una serie di lessici dei sentimenti. Un lessico dei sentimenti è una serie di parole che vengono assegnate alle rispettive polarità, vale a dire, positivo, negativa e neutra secondo il loro significato semantico.
Ad esempio:
1. Parole come buono, grandioso, straordinario, fantastico sono di polarità positiva.
2. Parole come cattivo, peggiore, patetico sono di polarità negativa.
L'analizzatore di sentimenti VADER trova le percentuali di parole di diversa polarità e fornisce punteggi di polarità per ciascuna di esse. L'output dell'analizzatore viene valutato da 0 un 1, che può essere convertito in percentuali. Non parla solo dei punteggi di positività o negatività, ma anche di quanto un sentimento sia positivo o negativo.
Per prima cosa scarichiamo il pacchetto usando pip.
pip install vaderSentiment
Dopo, analizza i punteggi dei sentimenti.
from vaderSentiment.vaderSentiment import SentimentIntensityAnalyzer
analyzer = SentimentIntensityAnalyzer()
vs = analizzatore.polarity_scores(testo)
vs

PannelloUn panel è un gruppo di esperti che si riunisce per discutere e analizzare un argomento specifico. Questi forum sono comuni alle conferenze, seminari e dibattiti pubblici, dove i partecipanti condividono le loro conoscenze e prospettive. I pannelli possono riguardare una varietà di aree, Dalla scienza alla politica, e il suo obiettivo è quello di favorire lo scambio di idee e la riflessione critica tra i partecipanti.... controllo del analizzatore di testo
I passaggi precedenti possono essere riassunti per creare una dashboard per l'analizzatore di testo. Include il numero di parole, il numero di caratteri, il numero di numeri, le N parole principali, l'intenzione del testo, l'opinione generale, il punteggio dell'opinione positiva, il punteggio dell'opinione negativa, il punteggio dell'opinione neutra e il conteggio delle parole dell'opinione.
conclusione
La PNL ha avuto un grande impatto in campi come l'analisi delle recensioni dei prodotti, consigli, analisi dei social media, traduzione del testo e, così, ha ottenuto enormi benefici per le grandi aziende.
Espero que este artículo le ayude a comenzar su viaje en el campo de la PNL.
E infine, … Non c'è bisogno di dire,
Grazie per aver letto!
Il supporto mostrato in questo articolo non è di proprietà di DataPeaker e viene utilizzato a discrezione dell'autore.





