
introduzione
Mi sono imbattuto recentemente in questa virtù strategica di Sun Tzu:
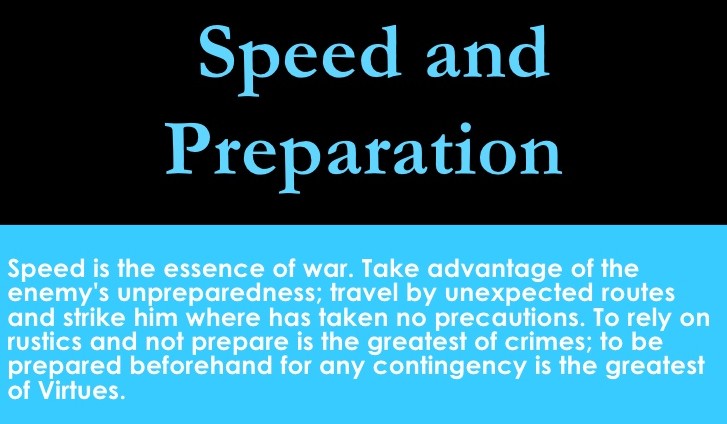
Cosa ha a che fare questo con un blog di data science?? Questa è l'essenza di come si vincono le competizioni e hackatones. Arrivi alla competizione meglio preparato rispetto ai concorrenti, esegui rapidamente, impari e iteri per dare il meglio di te.
La settimana scorsa, abbiamo pubblicato 'Modo perfetto per costruire un modello predittivo in meno di 10 minuti usando R'. Chiunque può fare una rapida previsione seguendo questo post. Dato il boom di Python negli ultimi anni e la sua semplicità, ha senso avere questo kit di strumenti pronto per i Pythonisti nel mondo della scienza dei dati. Seguirò una struttura simile a quella del post precedente con i miei contributi aggiuntivi nelle diverse fasi della costruzione del modello. Estos dos posts le ayudarán a construir su primer modelo predictivo más rápido y con mejor potencia. La mayoría de los mejores científicos de datos y Kagglers construyen su primer modelo eficaz rápidamente y lo envían. Esto no solo les ayuda a tener una ventaja en la tabla de líderes, sino que además les proporciona una solución de referencia para superar.
Ripartizione della procedura di modellazione predittiva
Siempre me concentro en invertir tiempo de calidad durante la etapa inicial de la construcción del modelo, como la generación de hipótesis / sesiones de lluvia de ideas / discussion (S) o la comprensión del dominio. Todas estas actividades me ayudan a relacionarme con el problema, lo que eventualmente me lleva a diseñar soluciones comerciales más poderosas. Ci sono buone ragioni per cui dovresti dedicare questo tempo all'inizio:
- Hai abbastanza tempo da investire e sei fresco (Ha impatto)
- Non è influenzato da altri punti dati o pensieri (Suggerisco sempre di formulare ipotesi prima di approfondire i dati)
- In una fase successiva, Sarebbe di fretta per completare il progetto e non potrebbe dedicare tempo di qualità.
Questa fase richiederà tempo di qualità, quindi non sto menzionando la tempistica qui, Le consiglierei di farlo come prassi standard. Ti aiuterà a costruire modelli predittivi migliori e porterà come conseguenza meno iterazioni di lavoro nelle fasi successive. Vediamo le fasi rimanenti nella prima costruzione del modello con le linee temporali:
- Analisi descrittiva dei dati: 50% tempo metereologico
- Elaborazione dati (Valore perso e correzione dei valori anomali): 40% tempo metereologico
- Modellazione dei dati: 4% tempo metereologico
- Stima delle prestazioni: 6% tempo metereologico
PD: questa è la suddivisione del tempo dedicato solo alla prima costruzione del modello
Ripassiamo la procedura passo dopo passo (con stime del tempo impiegato in ciascun passaggio):
Palcoscenico 1: Analisi descrittiva / Esplorazione dei dati:
Nei miei primi giorni come data scientist, l'esplorazione dei dati mi portava molto tempo. Col tempo, ho automatizzato molte operazioni sui dati. Poiché la preparazione dei dati occupa la 50% del lavoro nella costruzione di un primo modello, i benefici dell'automazione sono evidenti. Puoi consultare i “7 passaggi dell'esplorazione dei dati” per vedere le operazioni di esplorazione dei dati più comuni.
Tavish ha già menzionato nel suo post che con gli strumenti avanzati di apprendimento automatico in corso, il tempo necessario per completare questo compito si è ridotto significativamente. Poiché questo è il nostro primo modello di riferimento, eliminiamo qualsiasi tipo di ingegneria delle caratteristiche. Perché, Il tempo necessario per eseguire un'analisi descrittiva è limitato alla conoscenza dei valori mancanti e delle grandi caratteristiche direttamente visibili. Nella mia metodologia, Bisogno 2 minuti Per completare questo passaggio (Ipotesi, 100.000 osservazioni nel set di dati).
Le operazioni che eseguo per il mio primo modello includono:
- Identificare le caratteristiche identificative, input e destinazione
- Identificare caratteristiche categoriali e numeriche
- Identificare le colonne con valori mancanti
Palcoscenico 2: Elaborazione dati (trattamento dei valori mancanti):
Ci sono diverse alternative per affrontarlo. Per il nostro primo modello, ci concentreremo sulle tecniche intelligenti e veloci per costruire il nostro primo modello efficace (queste sono già state discusse da Tavish nel suo post, sto aggiungendo alcuni metodi)
- Creare indicatori fittizi per i valori mancanti: Funziona, a volte i valori mancanti di per sé contengono una buona quantità di informazioni.
- Imputare il valore mancante con la media / medianoLa mediana è una misura statistica che rappresenta il valore centrale di un insieme di dati ordinati. Per calcolarlo, I dati sono organizzati dal più basso al più alto e viene identificato il numero al centro. Se c'è un numero pari di osservazioni, I due valori fondamentali sono mediati. Questo indicatore è particolarmente utile nelle distribuzioni asimmetriche, poiché non è influenzato da valori estremi.... / qualsiasi altro metodo più semplice: l'imputazione con la media e la mediana funziona bene, la maggior parte delle persone preferisce imputare con il valore medio, ma in caso di distribuzione asimmetrica, le suggerisco di scegliere la mediana. Altri metodi intelligenti consistono nell'imputare i valori attraverso casi simili e l'imputazione mediana usando altre caratteristiche rilevanti o costruendo un modello. Come esempio: nella sfida di sopravvivenza del Titanic, può imputare i valori mancanti di Età usando il titolo del nome dei passeggeri come “Signor”, “Signorina”, “Signora”, “Maestro” e altri, e questo ha dimostrato un buon impatto sulle prestazioni del modello. .
- Imputare il valore mancante di variabileIn statistica e matematica, un "variabile" è un simbolo che rappresenta un valore che può cambiare o variare. Esistono diversi tipi di variabili, e qualitativo, che descrivono caratteristiche non numeriche, e quantitativo, che rappresentano quantità numeriche. Le variabili sono fondamentali negli esperimenti e negli studi, poiché consentono l'analisi delle relazioni e dei modelli tra elementi diversi, facilitare la comprensione di fenomeni complessi.... Categorico: creare un nuovo livello per imputare la variabile categorica in modo che tutti i valori mancanti siano codificati come un valore unico, Dillo “New_Cat” oppure si può guardare la combinazione delle frequenze e imputare il valore mancante con quello che ha la frequenza più alta.
Con metodi così semplici di elaborazione dei dati, può ridurre il tempo di elaborazione dei dati per 3-4 minuti.
Palcoscenico 3. Modellazione dei dati:
Consiglio di utilizzare una qualsiasi delle tecniche GBM / Foresta casuale, a seconda del problema aziendale. Queste due tecniche sono estremamente efficaci per creare una soluzione di riferimento. Ho visto che i data scientist usano spesso questi due metodi come loro primo modello e, in alcuni casi, oltre a ciò funge da modello finale. Questa operazione richiederà la massima quantità di tempo (~ 4-5 minuti).
Palcoscenico 4. Stima delle prestazioni:
Esistono diversi metodi per validare le prestazioni del proprio modello, le sugiero que divida el conjunto de datos de su tren en Train y valide (idealmente 70:30) y cree un modelo basado en el 70% del conjunto de datos del tren. Ora, realice una validación cruzada usando el 30% del conjunto de datos validados y evalúe el rendimiento usando la métrica de evaluación. Questo in conclusione prende 1-2 minuti Esecuzione e documento.
La intención de este post no es ganar la competencia, ma per determinare un punto di riferimento per noi stessi. Veamos los códigos de Python para realizar los pasos anteriores y construir su primer modelo con mayor impacto.
Iniziamo a metterlo in pratica
Supuse que primero ha realizado toda la generación de hipótesis y es bueno con la ciencia de datos básica usando Python. Estoy ilustrando esto con un ejemplo de desafío de ciencia de datos. Veamos la estructura:
passo 1 : Importe las bibliotecas imprescindibles y lea el conjunto de datos de prueba y addestramentoLa formazione è un processo sistematico volto a migliorare le competenze, conoscenze o abilità fisiche. Viene applicato in vari ambiti, come lo sport, Formazione e sviluppo professionale. Un programma di allenamento efficace include la pianificazione degli obiettivi, Pratica regolare e valutazione dei progressi. L'adattamento alle esigenze individuali e la motivazione sono fattori chiave per ottenere risultati di successo e sostenibili in qualsiasi disciplina..... Adjunte ambos.
import pandas as pd
import numpy as np
from sklearn.preprocessing import LabelEncoder
import random
from sklearn.ensemble import RandomForestClassifier
from sklearn.ensemble import GradientBoostingClassifier
train=pd.read_csv('C:/Users/DataPeaker/Desktop/challenge/Train.csv')
test=pd.read_csv('C:/Users/DataPeaker/Desktop/challenge/Test.csv')
treno['Type']='Train' #Create a flag for Train and Test Data set
test['Type']='Test'
fullData = pd.concat([treno,test],asse=0) #Combinato sia Train che Test Set di dati
passo 2: El paso 2 del marco no es necesario en Python. Pasamos al siguiente paso.
passo 3: Visualizzare i nomi delle colonne / Riepilogo del set di dati
fullData.columns # This will show all the column names
fullData.head(10) # Mostra prima 10 records of dataframe
fullData.describe() #Puoi guardare il riepilogo dei campi numerici usando describe() funzione
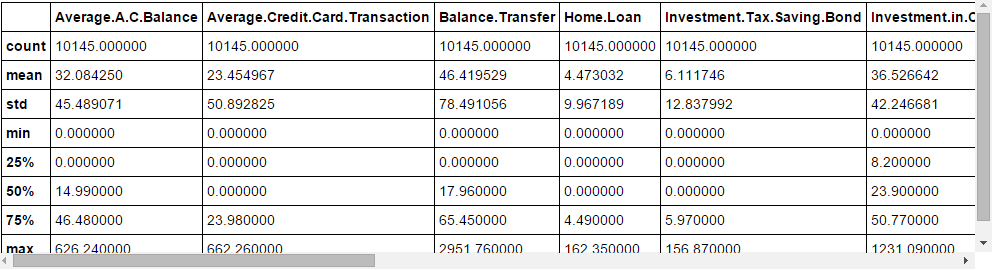
passo 4: Identificar las a) Variables de identificación b) Variables objetivo c) Variables categóricas d) Variables numéricas e) Otras variables
ID_col = ['REF_NO']
target_col = ["Account.Status"]
cat_cols = ['children','age_band','status','occupation','occupation_partner','home_status','family_income','self_employed', 'self_employed_partner','year_last_moved','TVarea','post_code','post_area','genere','region']
num_cols= list(set(elenco(fullData.columns))-set(cat_cols)-set(ID_col)-set(target_col)-set(data_col))
other_col=['Type'] #Test and Train Data set identifier
passo 5 : Identifique las variables con valores perdidos y cree una bandera para esas
fullData.isnull().qualunque()#Will return the feature with True or False,True significa avere un valore mancante, altrimenti Falsenum_cat_cols = num_cols+cat_cols # Combined numerical and Categorical variables #Create a new variable for each variable having missing value with VariableName_NA # e segnala il valore mancante con 1 e l'altro con 0 per var in num_cat_cols: se fullData[dove].è zero().qualunque()==True: fullData[var+'_NA']=fullData[dove].è zero()*1
passo 6 : Imputare i valori persi
#Impute numerical missing values with mean
fullData[num_cols] = fullData[num_cols].riempire(fullData[num_cols].Significare(),inplace=Vero)
#Sostituisci i valori categoriali mancanti con -9999
fullData[cat_cols] = fullData[cat_cols].riempire(valore = -9999)
passo 7 : Crea codificatori di etichette per variabili categoriali e dividi il dataset per addestrare e testare, dividi ulteriormente il dataset di addestramento per addestrare e validare
#create label encoders for categorical features
for var in cat_cols:
 number = LabelEncoder()
 fullData[dove] = number.fit_transform(fullData[dove].come tipo('str'))

#Target variable is also a categorical so convert it
fullData["Account.Status"] = number.fit_transform(fullData["Account.Status"].come tipo('str'))

train=fullData[fullData['Type']=='Train']
test=fullData[fullData['Type']=='Test']

treno['is_train'] = np.random.uniform(0, 1, len(treno)) <= .75
Treno, Validate = train[treno['is_train']==True], treno[treno['is_train']==False]
passo 8 : Pase las variables imputadas y ficticias (indicadores de valores perdidos) al procedimiento de modelado. Estoy usando un bosque aleatorio para predecir la clase.
features=list(set(elenco(fullData.columns))-set(ID_col)-set(target_col)-set(other_col))
x_train = Train[elenco(caratteristiche)].values
y_train = Train["Account.Status"].values
x_validate = Validate[elenco(caratteristiche)].values
y_validate = Validate["Account.Status"].values
x_test=test[elenco(caratteristiche)].valori
random.seed(100)
rf = RandomForestClassifier(n_estimators=1000)
rf.fit(x_treno, y_train)
passo 9 : Verifique el rendimiento y haga predicciones
status = rf.predict_proba(x_validate)
fpr, Tpr, _ = roc_curve(y_validate, status[:,1])
roc_auc = auc(fpr, Tpr)
print roc_auc

final_status = rf.predict_proba(x_test)
test["Account.Status"]=final_status[:,1]
test.to_csv('C:/Users/DataPeaker/Desktop/model_output.csv',colonne=['REF_NO','Account.Status'])
E invia!!
Note finali
Auspicabilmente, este post le permitirá comenzar a crear su propio código de puntuación de 10 minuti. La mayoría de los maestros de Kaggle y los mejores científicos de nuestra hackatones Tenga estos códigos listos y dispare su primer envío antes de realizar un análisis detallado. Una volta che hanno una stima del benchmark, Iniziano a improvvisare di più. Condividi i tuoi codici completi nella casella dei commenti qui sotto.
Questo post è stato utile?? Condividi le tue opinioni / pensieri nella sezione commenti qui sotto.





