
Palcoscenico 1: Qualsiasi banca globale oggi ha più di 100 milioni di clienti che effettuano miliardi di transazioni ogni mese.
Palcoscenico 2: I siti Web di social media o i siti Web di e-commerce tengono traccia del comportamento dei clienti sul sito Web e quindi forniscono informazioni / prodotto pertinente.
I sistemi tradizionali faticano a far fronte a questa scala alla velocità richiesta in modo conveniente.
È qui che vengono in aiuto le piattaforme Big Data.. In questo articolo, vi presentiamo l'affascinante mondo di Hadoop. Hadoop è utile quando si tratta di dati enormi. Potrebbe non rendere il processo più veloce, ma ci dà la possibilità di utilizzare la potenza di elaborazione parallela per gestire i big data. In sintesi, Hadoop ci dà la capacità di affrontare le complessità di volume alto, velocità e varietà di dati (popolarmente noto come 3V).
Notare che, oltre a Hadoop, ci sono altre piattaforme di big data, ad esempio, NoSQL (MongoDB è il più popolare), li vedremo più tardi.
Introduzione a Hadoop
Hadoop è un ecosistema completo di progetti open source che ci fornisce il framework per gestire i big data. Iniziamo con il brainstorming delle potenziali sfide nell'affrontare i big data (nei sistemi tradizionali) e poi vediamo la capacità della soluzione Hadoop.
Le seguenti sono le sfide che mi vengono in mente quando ho a che fare con i big data:
1. Elevato investimento di capitale nell'acquisizione di un server con elevata capacità di elaborazione.
2. Tempo enorme investito
3. In caso di query lunghe, immagina che si verifichi un errore nell'ultimo passaggio. Perderai molto tempo a fare queste iterazioni.
4. Difficoltà a generare query sul programma
Ecco come Hadoop risolve tutti questi problemi:
1. Grande investimento di capitale per l'acquisizione di un server ad alto rendimento: I cluster Hadoop vengono eseguiti su un normale hardware di base e mantengono più copie per garantire l'affidabilità dei dati. Un massimo di 4500 macchine insieme utilizzando Hadoop.
2. Tempo enorme investito : Il processo è diviso in parti e viene eseguito in parallelo, risparmio di tempo. Un massimo di 25 Petabyte (1 PB = 1000 TB) dati utilizzando Hadoop.
3. In caso di query lunghe, immagina che si verifichi un errore nell'ultimo passaggio. Perderai molto tempo a fare queste iterazioni : Hadoop esegue il backup dei set di dati a tutti i livelli. Esegue anche query su set di dati duplicati per evitare la perdita di processo in caso di errore individuale. Questi passaggi rendono l'elaborazione Hadoop più precisa e accurata.
4. Difficoltà a generare query sul programma : Le query in Hadoop sono semplici come la codifica in qualsiasi lingua. Devi solo cambiare il modo in cui pensi alla creazione di una query per consentire l'elaborazione parallela.
Sfondo Hadoop
Con un aumento della penetrazione e dell'utilizzo di Internet, i dati acquisiti da Google sono aumentati esponenzialmente di anno in anno. Solo per darti una stima di questo numero, Su 2007 Google ha raccolto una media di 270 PB di dati ogni mese. Lo stesso numero è aumentato a 20000 PB ogni giorno in 2009. Ovviamente, Google aveva bisogno di una piattaforma migliore per elaborare dati così enormi. Google ha implementato un modello di programmazione chiamato Riduci mappaMapReduce è un modello di programmazione progettato per elaborare e generare in modo efficiente set di dati di grandi dimensioni. Sviluppato da Google, Questo approccio suddivide il lavoro in attività più piccole, che sono distribuiti tra più nodi in un cluster. Ogni nodo elabora la sua parte e poi i risultati vengono combinati. Questo metodo consente di scalare le applicazioni e gestire enormi volumi di informazioni, essere fondamentali nel mondo dei Big Data...., chi potrebbe processarli? 20000 PB al giorno. Google ha eseguito queste operazioni MapReduce su un file system speciale chiamato Google File System (GFS). purtroppo, GFS non è open source.
Doug Cutting e Yahoo! ha eseguito l'ingegneria inversa del modello GFS e ha costruito un sistema di file distribuitoUn sistema di file distribuito (DFS) permette la memorizzazione e l'accesso ai dati su più server, facilitando la gestione di grandi volumi di informazioni. Questo tipo di sistema migliora la disponibilità e la ridondanza, poiché i file vengono replicati in diverse posizioni, il che riduce il rischio di perdita di dati. Cosa c'è di più, permette agli utenti di accedere ai file da diverse piattaforme e dispositivi, promuovendo la collaborazione e... Hadoop (HDFSHDFS, o File system distribuito Hadoop, Si tratta di un'infrastruttura chiave per l'archiviazione di grandi volumi di dati. Progettato per funzionare su hardware comune, HDFS consente la distribuzione dei dati su più nodi, garantire un'elevata disponibilità e tolleranza ai guasti. La sua architettura si basa su un modello master-slave, dove un nodo master gestisce il sistema e i nodi slave memorizzano i dati, facilitare l'elaborazione efficiente delle informazioni..) parallelo. Il software o framework che supporta HDFS e MapReduce è noto come Hadoop. Hadoop è open source e distribuito da Apache.
Forse ti interessa: Introduzione a MapReduce
Framework di elaborazione Hadoop
Facciamo un'analogia con la nostra vita quotidiana per capire come funziona Hadoop. La base della piramide di ogni azienda sono le persone che sono i singoli contribuenti. Possono essere analisti, programmatori, lavoro manuale, chef, eccetera. Gestire il tuo lavoro è il project manager. Il project manager è responsabile del completamento con successo dell'attività. Necessità di distribuire il lavoro, lisciare il coordinamento tra di loro, eccetera. Cosa c'è di più, la maggior parte di queste aziende ha un responsabile del personale, chi è più interessato a mantenere la squadra?.
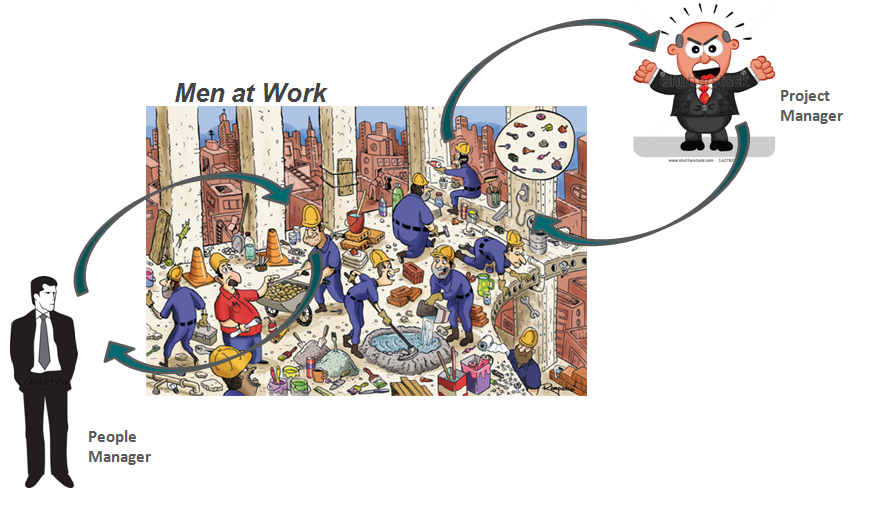
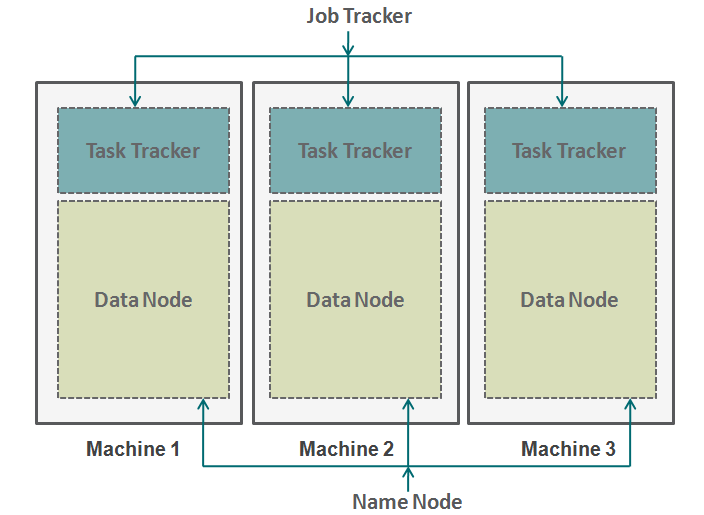
Hadoop funziona in un formato simile. In basso abbiamo le macchine disposte in parallelo. Queste macchine sono analoghe al singolo contribuente nella nostra analogia. Ogni macchina ha un nodoNodo è una piattaforma digitale che facilita la connessione tra professionisti e aziende alla ricerca di talenti. Attraverso un sistema intuitivo, Consente agli utenti di creare profili, condividere esperienze e accedere a opportunità di lavoro. La sua attenzione alla collaborazione e al networking rende Nodo uno strumento prezioso per chi vuole ampliare la propria rete professionale e trovare progetti in linea con le proprie competenze e obiettivi.... di dati e un tracciatore di attività. Il nodo dati è anche noto come HDFS (File system distribuito HadoopIl Sistema di File Distribuito di Hadoop (HDFS) es una parte fundamental del ecosistema Hadoop, diseñado para almacenar grandes volúmenes de datos de manera distribuida. HDFS permite el almacenamiento escalable y la gestión eficiente de datos, dividiendo archivos en bloques que se replican en diferentes nodos. Esto asegura la disponibilidad y la resistencia ante fallos, facilitando el procesamiento de datos masivos en entornos de big data....) e il tracker delle attività è anche noto come riduttori di mappe.
Il nodo dati contiene l'intero set di dati e il task tracker esegue tutte le operazioni. Puoi immaginare il tracker delle attività come le tue braccia e le tue gambe, che ti consente di eseguire un'attività e un nodo di dati come il tuo cervello, contenente tutte le informazioni che si desidera elaborare. Queste macchine lavorano in silos ed è molto importante coordinarle. Tracciatori di attività (project manager nella nostra analogia) su diverse macchine sono coordinate da un job tracker. Monitoraggio del lavoro**Monitoraggio del lavoro: Uno strumento essenziale per la ricerca di lavoro** Job Tracker è una piattaforma progettata per facilitare la ricerca di lavoro, che consente agli utenti di organizzare e monitorare le loro candidature. Con funzionalità come la gestione dei curriculum, avvisi su nuove offerte e analisi delle tendenze del lavoro, Job Tracker aiuta i candidati a ottimizzare il processo di ricerca e aumentare le possibilità di successo nel competitivo.... assicura che ogni operazione venga completata e, in caso di errore in qualsiasi nodo, devi assegnare un'attività duplicata a un tracker di attività. Il job tracker distribuisce anche l'intera attività a tutte le macchine.
In secondo luogo, un nodo denominato coordina tutti i nodi di dati. Governa la distribuzione dei dati che vanno a ciascuna macchina. Verifica inoltre qualsiasi tipo di spurgo avvenuto in una macchina. Se si verifica tale debug, trova i dati duplicati che sono stati inviati a un altro nodo di dati e li duplica di nuovo. Puoi pensare a questo nodo del nome come al gestore delle persone nella nostra analogia, chi si preoccupa di più della conservazione dell'intero set di dati?.
Quando non usare Hadoop?
Fino ad ora, abbiamo visto come Hadoop ha reso possibile la gestione dei big data. Ma in alcuni scenari l'implementazione di Hadoop non è raccomandata. Di seguito sono riportati alcuni di questi scenari:
- Accesso ai dati a bassa latenza: accesso rapido a piccoli pezzi di dati
- Modifica di più dati: Hadoop è più adatto solo se ci occupiamo principalmente di leggere dati e non di scrivere dati.
- Molti piccoli file: Hadoop si adatta meglio agli scenari, dove abbiamo pochi ma grandi file.
Note finali
Questo articolo ti dà un'idea di come Hadoop viene in soccorso quando si tratta di dati enormi. Capire come funziona Hadoop è molto essenziale prima di iniziare a codificarlo. Questo perché devi cambiare il modo in cui pensi a un codice. Ora devi iniziare a pensare all'abilitazione dell'elaborazione parallela. Puoi eseguire molti diversi tipi di processi in Hadoop, ma devi convertire tutti questi codici in una funzione di riduzione della mappa. Nei prossimi articoli, spiegheremo come convertire la tua logica semplice in logica Map-Reduce basata su Hadoop. Prenderemo anche casi di studio specifici del linguaggio R per costruire una solida comprensione dell'applicazione Hadoop..
L'articolo ti è stato utile?? Condividi con noi tutte le applicazioni pratiche di Hadoop che hai incontrato al lavoro. Fateci sapere i vostri pensieri su questo articolo nella casella sottostante..





