
Questo articolo è stato pubblicato nell'ambito del Blogathon sulla scienza dei dati.
introduzione
Molte aziende credono ancora nella creazione di un proprio framework per le pipeline di dati e non utilizzano gli strumenti esistenti anche se ciò richiede un'ampia gamma di competenze.. Il modo tradizionale di fare ETL è farlo manualmente con il codice e non è un lavoro da una sola persona. L'ETL tradizionale può essere considerato un collo di bottiglia, ma questo non significa che non abbia prezzo.. Comprendiamo lo scenario attuale qui!
ETL in poche parole
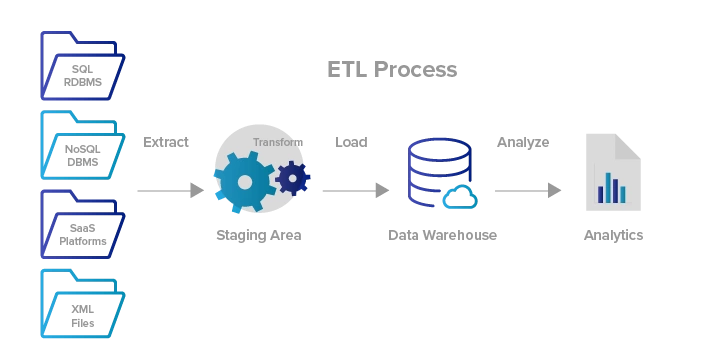
Come appassionati di dati, tutti noi dobbiamo aver incontrato spesso questo termine quando abbiamo a che fare con i dati ogni giorno, verità? Generalmente, i data engineer si occupano di tutto questo lavoro, ma anche analisti di dati, i data scientist e gli ingegneri di business intelligence devono avere esperienza pratica.. Non tutte le aziende forniranno dati puliti per analisi e report diretti; alcuni non vedono l'ora di lavorare in collaborazione con i data engineer per creare pipeline di dati finali scalabili ed efficienti.
Perché è così pubblicizzato??
Le grandi aziende assumono in particolare sviluppatori ETL, Specialisti ETL che gestiscono solo l'integrazione dei dati e progettano il data warehousing per loro. Il processo di 3 i passaggi sembrano semplici, ma dietro le quinte, ci sono centinaia di cose estremamente ingombranti da gestire per estrarre dati da varie fonti, soprattutto i dati stessi sono diventati molto più grandi e disordinati.
È la parte più impegnativa dell'intero flusso di dati e non puoi permetterti di gestire male informazioni cruciali prima di passare al passaggio successivo.. Dopo aver trasformato i dati puliti e convalidati nel modo desiderato, sicuro da archiviare nel data warehouse per scopi di modellazione e analisi dei dati. Vari rischi sono coinvolti durante le fasi iniziali della fase di produzione ed è per questo che se ne pagano di più. Conoscere l'input e l'output dei dati è la base di base per qualsiasi funzione relativa ai dati ed è obbligatorio avere un'idea di base di come utilizzare i dati in modo intelligente con le risorse disponibili..
Come eseguire ETL?
Esistono diversi flussi di lavoro nella pipeline dei dati e possono essere eseguiti in 2 forme:
- Talend
- Informatica
- Alteryx
- SSIS
- Amazon Redshift
- Xplenti
- QlikSense
- Chiodo
- R
- SQL
- Giava
- maiale apache
ETL senza codice vs ETL manuale
Una piattaforma ETL senza codice richiede poca o nessuna codifica. Gli strumenti forniscono una GUI facile da usare con varie funzionalità per creare una mappa dei dati. Una volta completata la mappa dei dati, i team devono solo eseguire il processo e il server farà il suo lavoro. Il processo è di facile comprensione per i clienti e di facile manutenzione. È scalabile e fa risparmiare molto tempo e denaro alle aziende che gestiscono set di dati in tempo reale. La lógica es reutilizable para cualquier Origine datiUN "Origine dati" si riferisce a qualsiasi luogo o supporto in cui è possibile ottenere informazioni. Queste fonti possono essere sia primarie che, come sondaggi ed esperimenti, come secondario, come banche dati, articoli accademici o rapporti statistici. La scelta corretta di una fonte di dati è fondamentale per garantire la validità e l'affidabilità delle informazioni nella ricerca e nell'analisi.... y existen funciones personalizadas de manipulación de datos. Esistono abbonamenti e servizi ETL a consumo che vengono eseguiti su un server cloud con milioni di dati. Perciò, l'azienda dovrebbe scegliere saggiamente lo strumento in base al caso d'uso e alle esigenze del cliente.
Anche i datori di lavoro non tecnici devono essere formati per programmare i flussi di lavoro, lavori e compiti per familiarizzare con lo strumento. Ci sono aziende che incoraggiano pratiche libere da codici per sviluppare vari prodotti..
Secondo la società di ricerca informatica Forrester, il mercato delle piattaforme di sviluppo low-code raggiungerà un valore di $ 21,2 miliardi per 2022, crescendo ad un tasso annuo di 40 per cento. Cosa c'è di più, il 45 la percentuale di sviluppatori ha già utilizzato una piattaforma low-code o prevede di farlo nel prossimo futuro “. [1]
Codificare il proprio tubo di scarico è allettante ma difficile allo stesso tempo. Molte aziende adattano la scrittura di script Python per estrarre, trasformare e caricare i dati anche in un ambiente cloud. È possibile eseguire qualsiasi tipo di personalizzazione del codice se qualcosa non è disponibile nella soluzione ETL esistente. Codificare il nostro ETL può essere di grande beneficio in termini di flessibilità e ottimizzazione delle prestazioni. Se c'è un data engineer esperto a bordo che conosce i processi ETL, il processo ETL può essere regolato per funzionare nel modo più fluido possibile. La codifica noiosa è utile nei self-service in cui è possibile preelaborare i dati in modo indipendente.
Domande? Modificare il codice e mantenere gli script può essere un grosso problema se ETL non funziona bene per schemi complessi. L'automazione dell'ETL manuale richiede altri strumenti come Selenium, el programador de tareas de Windows para ejecutar automáticamente scripts de forma diaria o semanal para almacenar datos en Excel o en una Banca datiUn database è un insieme organizzato di informazioni che consente di archiviare, Gestisci e recupera i dati in modo efficiente. Utilizzato in varie applicazioni, Dai sistemi aziendali alle piattaforme online, I database possono essere relazionali o non relazionali. Una progettazione corretta è fondamentale per ottimizzare le prestazioni e garantire l'integrità delle informazioni, facilitando così il processo decisionale informato in diversi contesti..... Perciò, sono progettati per un insieme specifico di utenti e operazioni sui dati.
Ti piace giocare con dati sporchi e pulirli??
Se ti piace sperimentare con i dati controllando manualmente tutti gli errori e normalizzando i dati, quindi implementare più pacchetti Python e R è un buon modo per farlo. Anche scrivere query SQL può essere interessante e impegnativo per estrarre informazioni da dati disordinati. Questo può aiutarti ad acquisire una comprensione approfondita della logica alla base della gestione dei dati da zero piuttosto che iniziare prima con uno strumento..
Linea di fondo: Todo depende de varios parametriIl "parametri" sono variabili o criteri che vengono utilizzati per definire, misurare o valutare un fenomeno o un sistema. In vari campi come la statistica, Informatica e Ricerca Scientifica, I parametri sono fondamentali per stabilire norme e standard che guidano l'analisi e l'interpretazione dei dati. La loro corretta selezione e gestione sono fondamentali per ottenere risultati accurati e pertinenti in qualsiasi studio o progetto.... como el tamaño de los datos, memoria e budget per scegliere la soluzione ottimale ai problemi aziendali. Cosa c'è di più, la scelta dell'approccio ETL varia a seconda del livello di competenza tecnica e non tecnica di un'azienda.
Pensieri finali
Questo è un argomento piuttosto discutibile ed entrambi hanno i loro vantaggi e svantaggi.. Gli strumenti ETL non sono morti, ma non sono preferibili da tutti. Ora si potrebbe finire con un sovraccarico non necessario nell'utilizzo di uno strumento ETL dove non è necessario, che ospita anche logiche di business non trasferibili al di fuori dello strumento ETL.. Ma le competenze sviluppate creando pipeline ETL utilizzando Python o SQL rimarranno sempre unite negli anni a venire..
Gli attuali strumenti ETL possono passare di moda e adattarsi a quelli nuovi può essere difficile per alcune persone. Perciò, anche gli strumenti possono diventare una seccatura per un'azienda se non utilizzati correttamente. Indipendentemente dall'ETL manuale o senza codice, l'intero processo in sé è complicato ma anche molto interessante da imparare.
Qual è il tuo preferito? Fatemi sapere nei commenti!!
Grazie per aver letto questo articolo.
Riferimento
[1] Come le piattaforme low-code stanno trasformando lo sviluppo del software
Circa l'autore:
Saloni Somaiya lavora come data scientist in una startup sanitaria negli Stati Uniti. Ha conseguito un master in sistemi informativi presso la Northeastern University, Boston. Gli piace leggere articoli ed esplorare nuove tecnologie. È disposta a contribuire maggiormente al campo della scienza e dell'analisi dei dati.
LinkedIn: https://www.linkedin.com/in/saloni-somaiya/
Il supporto mostrato in questo articolo non è di proprietà di DataPeaker e viene utilizzato a discrezione dell'autore.





