
introduzione
GraphLab supuso un avance inesperado en mi plan de aprendizaje. Dopotutto, ‘Suceden cosas buenas cuando se espera que sucedan menos’. Todo empezó con el final de Hack de datos de Black Friday. A partire dal 1200 partecipanti, obtuvimos nuestros ganadores y sus interesantes soluciones.
Los leí y los analicé. Me di cuenta de que me había perdido una increíble herramienta de aprendizaje automático. Una exploración rápida me dijo que esta herramienta tiene un inmenso potencial para reducir nuestros dolores de modelado de aprendizaje automático. Quindi, decidí explorarlo más a fondo. Ahora he dedicado unos días a comprender su ciencia y sus métodos lógicos de uso. Para mi sorpresa, no fue difícil de entender.
¿Estabas intentando mejorar tu modelo de aprendizaje automático? ¿Pero falló en su mayoría? Pruebe esta herramienta avanzada de aprendizaje automático. Un mes de prueba es gratuito y la suscripción de 1 año está disponible GRATIS para uso académico. Dopo, puede comprar una suscripción para los años siguientes.
Para comenzar rápidamente, aquí hay una guía para principiantes sobre GraphLab en Python. Per facilitare la comprensione, he intentado explicar estos conceptos de la manera más sencilla posible.
Tópicos cubiertos
- Cómo empezó todo ?
- ¿Qué es GraphLab?
- Beneficios y limitaciones de GraphLab
- ¿Cómo instalar GraphLab?
- Empezando con GraphLab
Cómo empezó todo ?
GraphLab tiene una historia interesante de sus inicios. Déjame contarte brevemente.
GraphLab, conocido como Dato es fundado por Carlos Guestrin. Carlos tiene un doctorado en Ciencias de la Computación de la Universidad de Stanford. Sucedió hace unos 7 anni. Carlos era professor en la Universidad Carnegie Mellon. Dos de sus estudiantes estaban trabajando en algoritmos de aprendizaje automático distribuidos a gran escala. Ejecutaron su modelo sobre Hadoop y descubrieron que se tardaba bastante en calcular. Las situaciones ni siquiera mejoraron después de usar MPI (biblioteca informática de alto rendimiento).
Quindi, decidieron construir un sistema para escribir más artículos rápidamente. Con questo, GraphLab nació.
PD – GraphLab Create es un software comercial de GraphLab. Se accede a GraphLab Create en Python usando la biblioteca “graphlab”. Perciò, in questo articolo, GraphLab’ connota GraphLab Create. No se confunda.
¿Qué es GraphLab?
GraphLab è un nuovo framework parallelo per l'apprendimento automatico scritto in C ++. È un progetto open source ed è stato progettato considerando la scala, varietà e complessità dei dati del mondo reale. Incorpora vari algoritmi di alto livello come Stochastic Gradient Descent (SGD), Gradient Descent & Locking per offrire un'esperienza ad alte prestazioni. Aiuta scienziati e sviluppatori di dati a creare e distribuire facilmente applicazioni su larga scala.
Ma, Cosa lo rende straordinario? È la presenza di librerie ordinate per la trasformazione, manipolazione e visualizzazione dei modelli di dati. Cosa c'è di più, È composto da kit di strumenti di apprendimento automatico scalabili che hanno tutto (quasi) necessario per migliorare i modelli di apprendimento automatico. El kit de herramientas incluye implementación para apprendimento profondoApprendimento profondo, Una sottodisciplina dell'intelligenza artificiale, si affida a reti neurali artificiali per analizzare ed elaborare grandi volumi di dati. Questa tecnica consente alle macchine di apprendere modelli ed eseguire compiti complessi, come il riconoscimento vocale e la visione artificiale. La sua capacità di migliorare continuamente man mano che vengono forniti più dati lo rende uno strumento chiave in vari settori, dalla salute..., máquinas de factores, modellazione del tema, raggruppamento, vecinos más cercanos y más.
Aquí está la arquitectura completa de GraphLab Create.
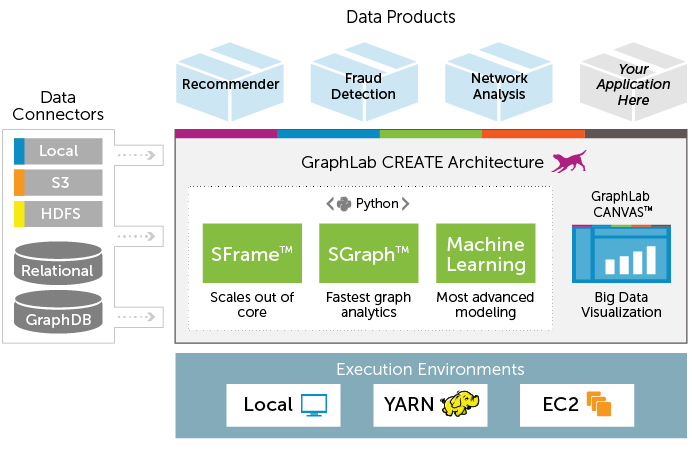
¿Cuáles son los beneficios de usar GraphLab?
Existen múltiples beneficios de usar GraphLab como se describe a continuación:
- Maneja datos grandes: La estructura de datos de GraphLab puede manejar grandes conjuntos de datos que dan como resultado un aprendizaje automático escalable. Veamos la estructura de datos de Graph Lab:
-
- SFrame: Es una estructura de datos tabulares basada en disco eficiente que no está limitada por la RAM. Ayuda a escalar el análisis y el procesamiento de datos para manejar grandes conjuntos de datos (Tera byte), incluso en su computadora portátil. Ha una sintassi simile a quella di pandas o dei dataframe di R. Ogni colonna è una SArray, che è una serie di elementi memorizzati su disco. Questo fa sì che gli SFrame siano basati su disco. Ho discusso i metodi per lavorare con 'SFrames' nelle sezioni seguenti.
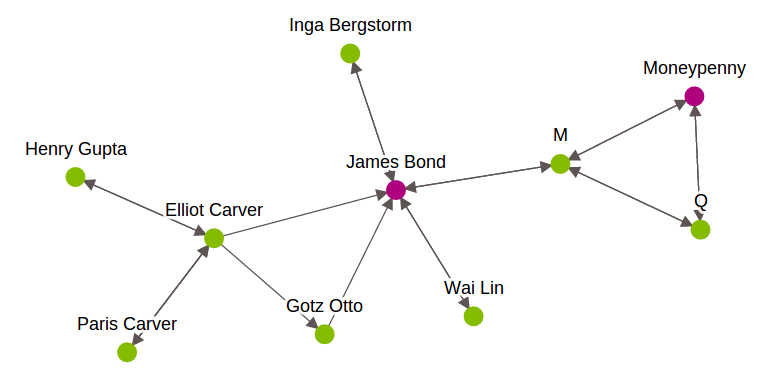
- SGraph: Graph ci aiuta a comprendere le reti analizzando le relazioni tra coppie di elementi. Ogni articolo è rappresentato da un vertice nel grafo. La relazione tra elementi è rappresentata da bordes. In GraphLab, per effettuare un'analisi dei dati orientata ai grafi, usa SGraph oggetto. È una struttura dati di grafo scalabile che memorizza vertici e archi negli SFrame. Per saperne di più su questo, guarda questo Collegamento. Di seguito viene mostrata una rappresentazione grafica dei personaggi di James Bond.
-
- Integración con varias fuentes de datos: GraphLab admite varias fuentes de datos como S3, ODBC, JSONJSON, o Notazione degli oggetti JavaScript, Si tratta di un formato di scambio dati leggero e facile da leggere e scrivere per gli esseri umani, e facile da analizzare e generare per le macchine. Viene comunemente utilizzato nelle applicazioni Web per inviare e ricevere informazioni tra un server e un client. La sua struttura si basa su coppie chiave-valore, rendendolo versatile e ampiamente adottato nello sviluppo di software.., CSV, HDFSHDFS, o File system distribuito Hadoop, Si tratta di un'infrastruttura chiave per l'archiviazione di grandi volumi di dati. Progettato per funzionare su hardware comune, HDFS consente la distribuzione dei dati su più nodi, garantire un'elevata disponibilità e tolleranza ai guasti. La sua architettura si basa su un modello master-slave, dove un nodo master gestisce il sistema e i nodi slave memorizzano i dati, facilitare l'elaborazione efficiente delle informazioni.. e molti altri.
- Exploración y visualización de datos con GraphLab Canvas. GraphLab Canvas es una GUI interactiva basada en navegador que le permite explorar datos tabulares, estadísticas resumidas y gráficos bivariados. Con esta función, dedica menos tiempo a codificar la exploración de datos. Esto le ayudará a concentrarse más en comprender la relación y distribución de las variables. He hablado de esta parte en las siguientes sectiones.
- Ingegneria delle funzioni: GraphLab tiene una opzione incorporada para creare nuevas funciones útiles para mejorar el rendimiento del modelo. Se compone de varias opciones como transformación, raggruppamentoIl "raggruppamento" È un concetto che si riferisce all'organizzazione di elementi o individui in gruppi con caratteristiche o obiettivi comuni. Questo processo viene utilizzato in varie discipline, compresa la psicologia, Educazione e biologia, per facilitare l'analisi e la comprensione di comportamenti o fenomeni. In ambito educativo, ad esempio, Il raggruppamento può migliorare l'interazione e l'apprendimento tra gli studenti incoraggiando il lavoro.., imputazione, una codificación en caliente, tf-idf, eccetera.
- modellazione: GraphLab dispone di diversi set di strumenti per offrire una soluzione facile e veloce ai problemi di ML. Le permette di svolgere vari esercizi di modellazione (regressione, classificazione, raggruppamento) in meno righe di codice. Può lavorare su problemi come il sistema di raccomandazione, la previsione dell'abbandono, l'analisi dei sentimenti, l'analisi delle immagini e molti altri.
- Automazione della produzione: Le pipeline di dati le permettono di assemblare compiti di codice riutilizzabili in lavori. Dopo, eseguiteli automaticamente in ambienti di esecuzione comuni (ad esempio, Servizi Web Amazon, Hadoop).
- GraphLab Create SDK: Gli utenti avanzati possono ampliare le capacità di GraphLab Create utilizzando GraphLab Create SDK. Può definire nuovi modelli / programmi di apprendimento automatico e integrarli con il resto del pacchetto. Vedere il repository di GitHub qui.
- Licenza: Ha limitazioni d'uso. Può scegliere un periodo di prova gratuito di 30 giorni o una licenza di un anno per l'edizione accademica. Per estendere il suo abbonamento, Ti verrà addebitato (vedere la struttura dell'abbonamento qui).
¿Cómo instalar GraphLab?
Può anche utilizzare GraphLab una volta che ha fatto uso della sua licenza. tuttavia, può anche iniziare con la prova gratuita o l'edizione accademica con abbonamento di 1 anno. Perciò, prima dell'installazione, la sua macchina deve soddisfare i requisiti di sistema per eseguire GraphLab.
Requisiti di sistema per GraphLab:
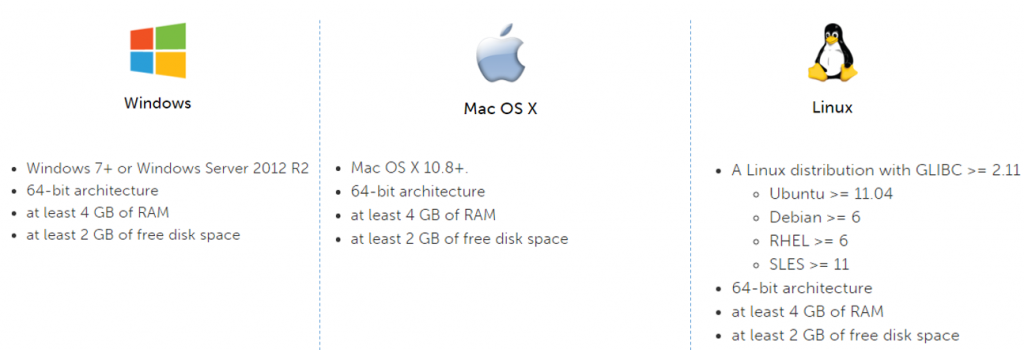
Se il suo sistema non soddisfa i requisiti precedenti, Puoi usare GraphLab Create nello strato gratuito di AWS Cosa c'è di più.
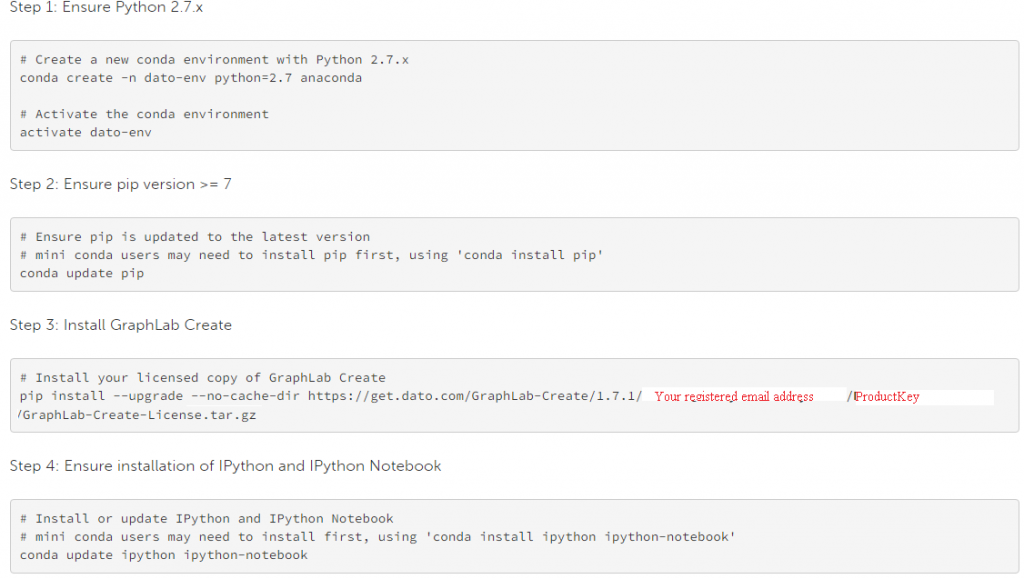
Passaggi per l'installazione:
- Registrarsi per sentiero libero. Dopo la registrazione, recibirá una clave de producto.
- Seleccione su sistema operativo (la selección automática está activada) y siga las instrucciones dadas
- A continuación se muestran las instrucciones de instalación de la línea de comandos (per “Anaconda Python Environment”).
Empezando con Graphlab
Una vez que haya instalado GraphLab correctamente, puede acceder a él usando “importar ”.
import graphlab
or
import graphlab as gl
Qui, demostraré el uso de GraphLab resolviendo un desafío de ciencia de datos. Tengo el conjunto de datos tomado de Hack de datos de Black Friday.
-
-
- Manipolazione di dati: También puede realizar una operación de manipulación de datos con SFrame, como agregar un valor constante a todos los valores, concatenar dos o más variables, crear una nueva variabileIn statistica e matematica, un "variabile" è un simbolo che rappresenta un valore che può cambiare o variare. Esistono diversi tipi di variabili, e qualitativo, che descrivono caratteristiche non numeriche, e quantitativo, che rappresentano quantità numeriche. Le variabili sono fondamentali negli esperimenti e negli studi, poiché consentono l'analisi delle relazioni e dei modelli tra elementi diversi, facilitare la comprensione di fenomeni complessi.... de salida basada en una variable como se muestra a continuación:
- Agregue un valor constante a la variable:
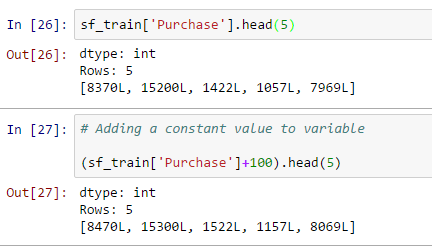
- Concatenar dos cadenas y almacenarlas en una nueva variable:
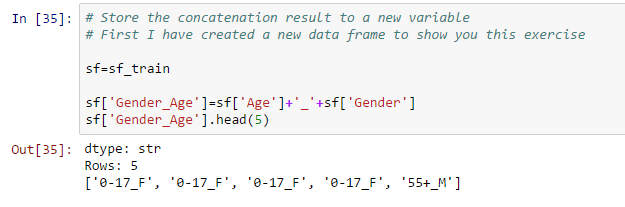
- Actualizar valores de variables existentes: esto se puede hacer usando la función de aplicación. In questo set di dati, he combinado grupos de edad mayores a 50 usando el siguiente código:
# Make a change to existing variable
# Combine all bins of age greater than 50
def combine_age(età):
 if age=='51-55':
 return '50+'
 elif age=='55+':
 return '50+'
 else:
 return age
sf['Età']=sf['Età'].applicare(combine_age)
Ora, observe la visualización previa y posterior de la variable “Età”.
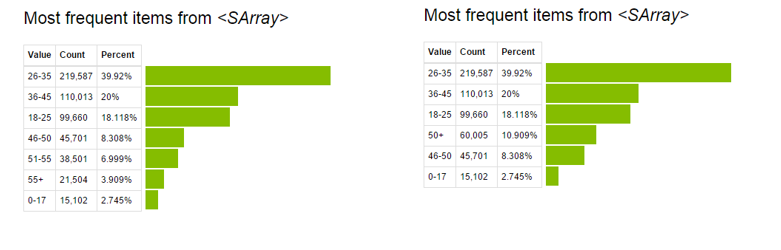 Para obtener más detalles sobre la manipulación de datos con GraphLab, guarda questo Collegamento.
- Agregue un valor constante a la variable:
- Ingegneria delle funzioni: L'ingegneria delle caratteristiche è un metodo efficace per migliorare le prestazioni del modello. Con questa tecnica, possiamo creare nuove variabili dopo la trasformazione o la manipolazione delle variabili esistenti. Infatti, GraphLab ha automatizzato questo processo. Hanno diverse opzioni di trasformazione per caratteristiche numeriche, Categorico, di testo e immagine. Cosa c'è di più, troverai opzioni dirette per raggruppamento delle funzioni, imputazione, una codificación en caliente, soglia di conteggio, TF-IDF, Hasher, Tokenzing e altri. Vediamo l'imputazione della caratteristica categorica “Product_Category_2” basato su “Età” e “Generedel set di dati 'Black Friday'.
# Crea i dati
# Variabili sulla base delle quali vogliamo eseguire l'imputazione e variabile da imputare
# Puoi vedere gli algoritmi dietro l'imputazione qui.

sf_impute = sf_train['Età','Genere','Product_Category_2']
imputatore = graphlab.feature_engineering. CategoricalImputer(feature="Product_Category_2") # Fit and transform on the same data transformed_sf = imputer.fit_transform(sf_impute)#Retrieve the imputed values transformed_sf
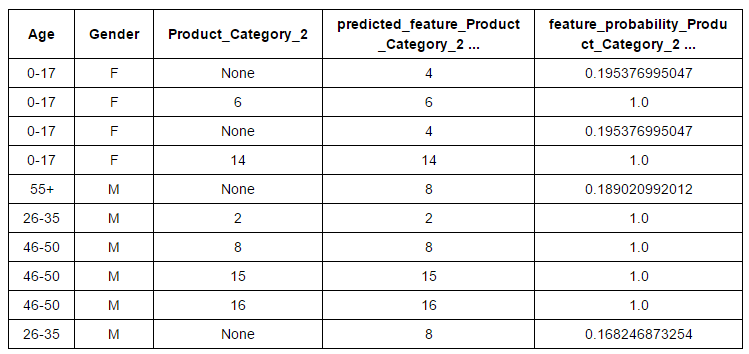
Finalmente, puede llevar esta variable de entrada al conjunto de datos original.
sf_train['Predicted_Product_Category_2']=transformed_sf['predicted_feature_Product_Category_2']
Allo stesso modo, puede applicare otras operaciones de ingeniería de características al conjunto de datos según sus requisitos. Puedes referir esto Collegamento per ulteriori dettagli.
- modellazione: In questa fase, hacemos predicciones a partir de datos pasados. GraphLab crea fácilmente modelos para tareas comunes, Che cosa:
UN) Predicción de cantidades numéricas
B) Sistemas de recomendación de edificios
C) Agrupar datos y documentos
D) Análisis de gráficos
- Manipolazione di dati: También puede realizar una operación de manipulación de datos con SFrame, como agregar un valor constante a todos los valores, concatenar dos o más variables, crear una nueva variabileIn statistica e matematica, un "variabile" è un simbolo che rappresenta un valore che può cambiare o variare. Esistono diversi tipi di variabili, e qualitativo, che descrivono caratteristiche non numeriche, e quantitativo, che rappresentano quantità numeriche. Le variabili sono fondamentali negli esperimenti e negli studi, poiché consentono l'analisi delle relazioni e dei modelli tra elementi diversi, facilitare la comprensione di fenomeni complessi.... de salida basada en una variable como se muestra a continuación:
-
En el desafío del Viernes, estamos obligados a predecir las cantidades numéricas “Acquistare”, vale a dire, abbiamo bisogno di un modello di regressione per prevedere la “Acquistare”.
In GraphLab, abbiamo tre tipi di modelli di regressione:
UN) Regressione lineare
B) Regressione casuale della foresta
C) Regressione guidata dai gradienti
Se hai qualche dubbio nella scelta dell'algoritmo, GraphLab si occupa di questo. Non preoccuparti. Seleziona automaticamente il modello di regressione corretto.
# Make a train-test split
train_data, validate_data = sf_train.random_split(0.8)
# Seleziona automaticamente il modello giusto in base ai tuoi dati.
model = graphlab.regression.create(train_data, obiettivo="Acquista", features = ['Genere','Età','Occupazione','Categoria_Città','Anni_Nella_Città_Attuale',
 'Stato_Civile','Categoria_Prodotto_1'])
# Save predictions to an SArray
predictions = model.predict(validate_data)
# Evaluate the model and save the results into a dictionary
results = model.evaluate(validate_data)
risultati
Produzione:
{'errore_massimo': 13377.561969523947, 'rmse': 3007.1225949345117}
#Do prediction on test data set
final_predictions = model.predict(sf_test)
Para saber más sobre otras técnicas de modelado como agrupamiento, classificazione, sistema de recomendación, analisi del testo, análisis de gráficos, sistemi di raccomandazione, puoi controllare questo Collegamento. In alternativa, aquí está el completo guía del usuario por Dato.
Note finali
In questo articolo, aprendimos sobre “GraphLab Create”, que ayuda a manejar un gran conjunto de datos mientras se crean modelos de aprendizaje automático. También analizamos la estructura de datos de Graphlab que le permite manejar grandes conjuntos de datos como “SFrame” y “SGraph”. Te recomiendo que uses GraphLab. Le encantarán sus funciones automatizadas como la exploración de datos (Canvas, herramienta de exploración de datos web interactiva), la ingeniería de funciones, la selección de los modelos adecuados y la implementación.
Per una migliore comprensione, también demostré un ejercicio de modelado usando GraphLab. Nel mio prossimo articolo su GraphLab, mi concentrerò sull'analisi dei grafici e sul sistema di raccomandazione.
Trovi utile questo articolo ? Condividi con noi la tua esperienza con GraphLab.





