
obbiettivo
- L'impulso è una tecnica di apprendimento congiunto in cui ogni modello cerca di correggere gli errori del modello precedente.
- Impara l'algoritmo di boosting gradienteGradiente è un termine usato in vari campi, come la matematica e l'informatica, per descrivere una variazione continua di valori. In matematica, si riferisce al tasso di variazione di una funzione, mentre in progettazione grafica, Si applica alla transizione del colore. Questo concetto è essenziale per comprendere fenomeni come l'ottimizzazione negli algoritmi e la rappresentazione visiva dei dati, consentendo una migliore interpretazione e analisi in... e la matematica che lo sostiene.
introduzione
In questo articolo, discuteremo un algoritmo che funziona con la tecnica di impulso, l'algoritmo di boosting graduale. È più conosciuto come Gradient Boosting Machine o GBM.
Nota: Se sei più interessato ad apprendere concetti in un formato audiovisivo, abbiamo questo articolo completo spiegato nel video qui sotto. Se non è così, puoi continuare a leggere.
I modelli in Gradient Boosting Machine vengono costruiti sequenzialmente e ciascuno di questi modelli successivi cerca di ridurre l'errore del modello precedente. Ma la domanda è: come ogni modello riduce l'errore del modello precedente? Questo avviene costruendo il nuovo modello sugli errori o residui delle predizioni precedenti.
Esto se hace para determinar si hay algún patrón en el error que el modelo anterior pasa por alto. Capiamolo con un esempio.
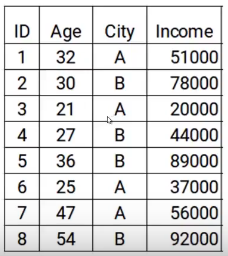
Aquí tenemos los datos con dos características: edad y ciudad, E la variabileIn statistica e matematica, un "variabile" è un simbolo che rappresenta un valore che può cambiare o variare. Esistono diversi tipi di variabili, e qualitativo, che descrivono caratteristiche non numeriche, e quantitativo, che rappresentano quantità numeriche. Le variabili sono fondamentali negli esperimenti e negli studi, poiché consentono l'analisi delle relazioni e dei modelli tra elementi diversi, facilitare la comprensione di fenomeni complessi.... objetivo es el ingreso. Quindi, según la ciudad y la edad de la persona, tenemos que predecir los ingresos. Tenga en cuenta che a lo largo del proceso de aumento de gradiente, actualizaremos lo siguiente: el objetivo del modelo, el residuo del modelo y la predicción.
Pasos para construir el modelo de máquina de aumento de gradiente
Para simplificar la comprensión de la máquina de aumento de gradiente, hemos dividido el proceso en cinco pasos simples.
passo 1
El primer paso es construir un modelo y hacer predicciones sobre los datos dados. Volvamos a nostri datos, para el primer modelo, el objetivo será el valor de Ingresos dado en los datos. Quindi, he establecido el objetivo como valores originales de Ingresos.
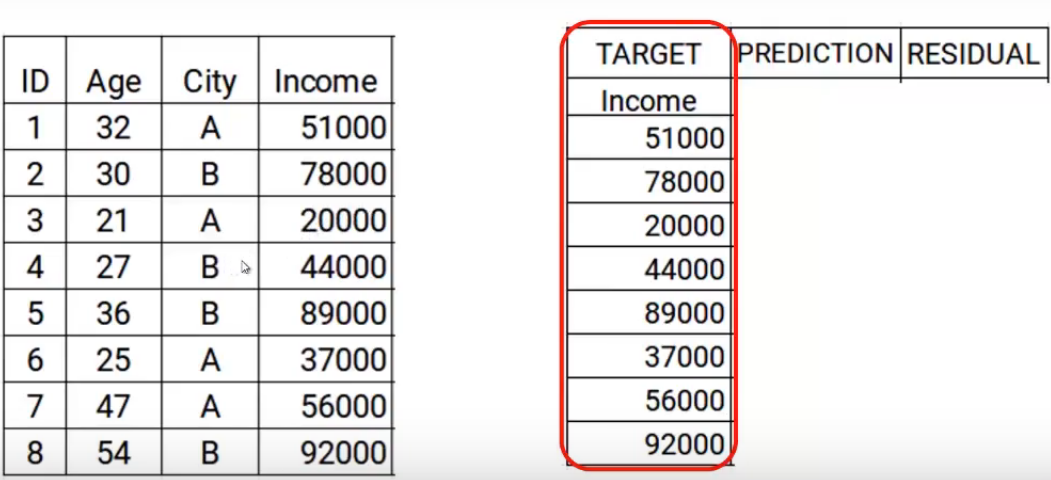
Ahora construiremos el modelo usando las características edad y ciudad con el ingreso objetivo. Este modelo entrenado podrá generar un conjunto de predicciones. Los cuales se suponen como sigue.
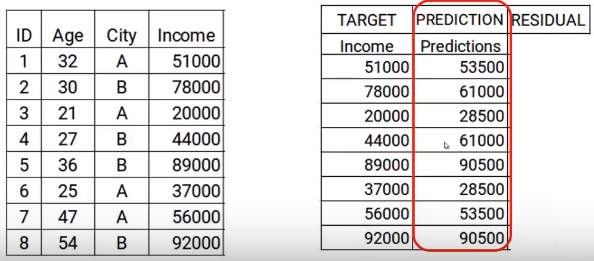
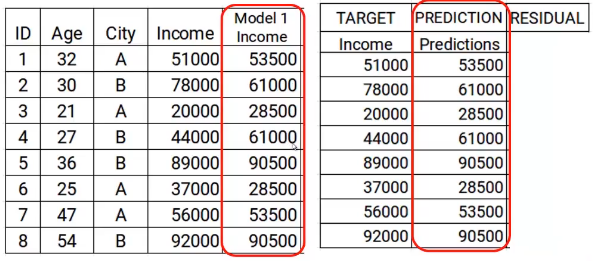
Ahora almacenaré estas predicciones con mis datos. Aquí es donde completo el primer paso.
passo 2
El siguiente paso es utilizar estas predicciones para obtener el error, que se utilizará más adelante como objetivo. Por el momento tenemos los valores de Ingresos reales y las predicciones del modelo1. Usando estas columnas, calcularemos el error simplemente restando los ingresos reales y las predicciones de ingresos. A se muestra a continuación.
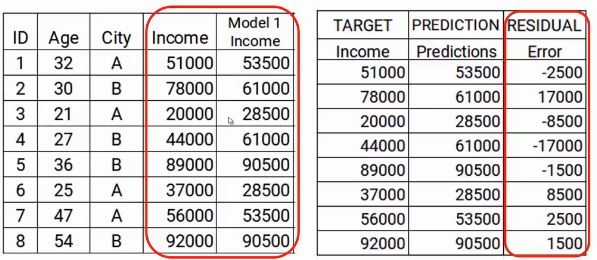
Como mencionamos anteriormente, los modelos sucesivos se centran en el error. Quindi, los errores aquí serán nuestro nuevo objetivo. Eso cubre el paso dos.
passo 3
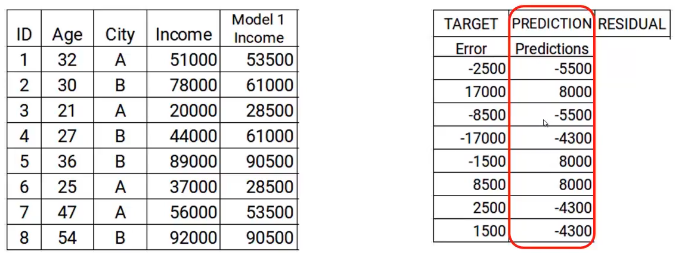
Nel prossimo passo, crearemos un modelo sobre estos errores y realizaremos las predicciones. Aquí la idea es determinar si hay algún patrón oculto en el error.
Quindi, usando el error como objetivo y las características originales Edad y Ciudad, generaremos nuevas predicciones. Tenga en cuenta que las predicciones, in questo caso, serán los valores de error, no los valores de ingresos previstos, ya que nuestro objetivo es el error. Digamos que el modelo da las siguientes predicciones
passo 4
Ora dobbiamo aggiornare le previsioni di model1. Aggiungeremo la previsione del passaggio precedente e la aggiungeremo alla previsione di model1 e la chiameremo Model2 Income.
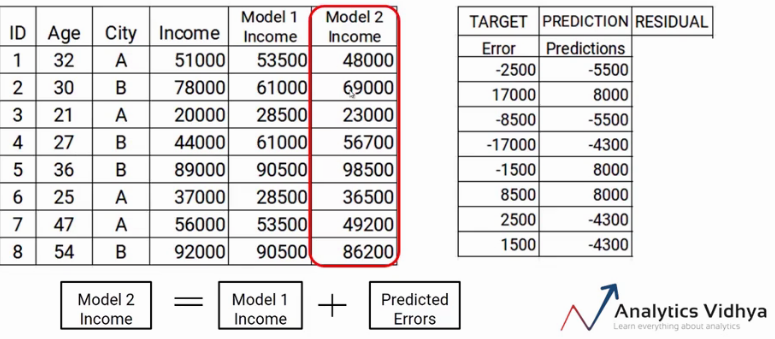
Come potete vedere, le mie nuove previsioni si avvicinano di più ai valori reali dei miei guadagni.
Finalmente, ripeteremo i passaggi 2 un 4, il che significa che calcoleremo nuovi errori e imposteremo questo nuovo errore come obiettivo. Ripeteremo questo processo fino a quando l'errore non sarà zero o avremo raggiunto il criterio di arresto, che indica il numero di modelli che vogliamo costruire. Questo è il processo passo dopo passo per costruire un modello di aumento del gradiente.
In poche parole, costruiamo il nostro primo modello che ha caratteristiche xy obiettivo e, chiamiamo questo modello H0 che è una funzione di xey. Poi costruiamo il modello successivo sugli errori dell'ultimo modello e un terzo modello sugli errori del modello precedente e così via. Fino a quando non costruiamo n modelli.
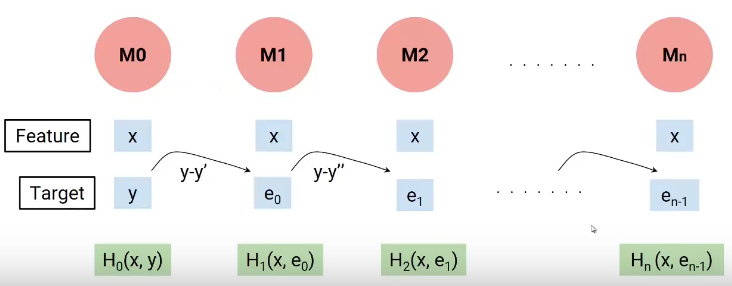
Ogni modello successivo lavora sugli errori di tutti i modelli precedenti per cercare di identificare eventuali schemi nell'errore. Effettivamente, posso dire che ciascuno di questi modelli è una funzione individuale che ha la variabile indipendente x come caratteristica e l'obiettivo è l'errore del modello combinato precedente.
Quindi, per determinare l'equazione finale del nostro modello, costruiamo il nostro primo modello H0, che mi ha dato alcune previsioni e generato alcuni errori. Chiamiamo questo risultato combinato F0 (X).
Ora creiamo il nostro secondo modello e aggiungiamo nuovi errori previsti a F0 (X), questa nuova funzione sarà F1 (X). Allo stesso modo, costruiremo il modello successivo e così via, fino a quando non avremo n modelli come mostrato di seguito.
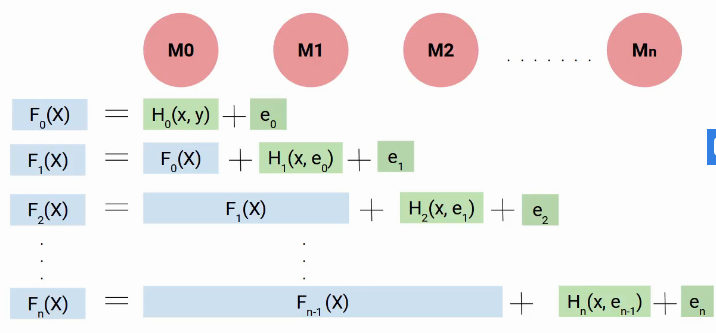
Quindi, in ogni passo, cerchiamo di modellare gli errori, il che ci aiuta a ridurre l'errore generale. Idealmente, vogliamo che questo 'en’ sia zero. Come potete vedere, ogni modello qui sta cercando di aumentare le prestazioni del modello, così, usiamo il termine impulso.
Ma perché usiamo il termine gradiente, ecco il trucco. Invece di aggiungere direttamente questi modelli, li aggiungiamo con un peso o coefficiente, e il valore corretto di questo coefficiente viene deciso utilizzando la tecnica di aumento del gradiente.
Perciò, una forma più generalizzata della nostra equazione sarà la seguente.
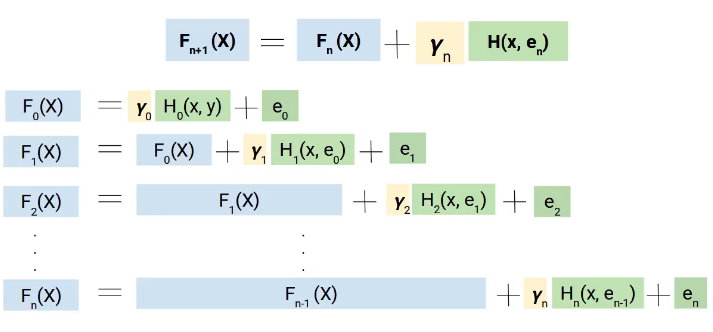
La matematica dietro Gradient Boosting Machine
Spero che ora tu abbia un'idea chiara di come funziona il gradient boosting. Da questo momento in poi, ci concentreremo su come si calcola il valore di Yn.
Useremo la tecnica della discesa del gradiente per ottenere i valori di questi coefficienti gamma (E), in modo da minimizzare il Funzione di perditaLa funzione di perdita è uno strumento fondamentale nell'apprendimento automatico che quantifica la discrepanza tra le previsioni del modello e i valori effettivi. Il suo obiettivo è quello di guidare il processo di formazione minimizzando questa differenza, consentendo così al modello di apprendere in modo più efficace. Esistono diversi tipi di funzioni di perdita, come l'errore quadratico medio e l'entropia incrociata, ognuno adatto a compiti diversi e.... Ora approfondiamo questa equazione e comprendiamo il ruolo della funzione di perdita e di gamma.
Qui, la funzione di perdita che stiamo usando è (y-y') 2. y è il valore reale e y' è il valore finale predetto dall'ultimo modello. Quindi, possiamo sostituire y' con Fn (X) che rappresenta l'obiettivo reale meno le previsioni aggiornate di tutti i modelli che abbiamo costruito fino ad ora.
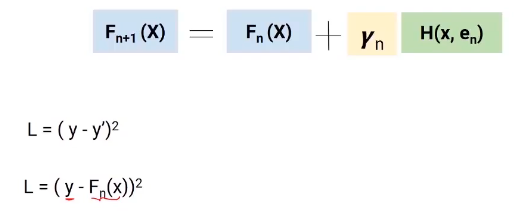
Derivazione parziale
Penso che tu sia familiare con il processo di discesa del gradiente, dato che useremo lo stesso concetto. Deriveremo l'equazione di L rispetto a Fn (X), otterrai la seguente equazione, che è anche conosciuta come pseudo residuo. Qual è il gradiente negativo della funzione di perdita.
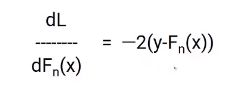
Per semplificare questo, moltiplicheremo entrambi i lati per -1. Il risultato sarà qualcosa del genere.
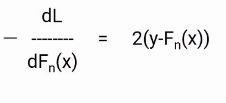
Ora, sappiamo che l'errore nella nostra equazione di Fn + 1 (X) è il valore reale meno le previsioni aggiornate di tutti i modelli. Perciò, podemos reemplazar el en en nuestra ecuación final con estos pseudo residuos como se muestra en la imagen a continuación.
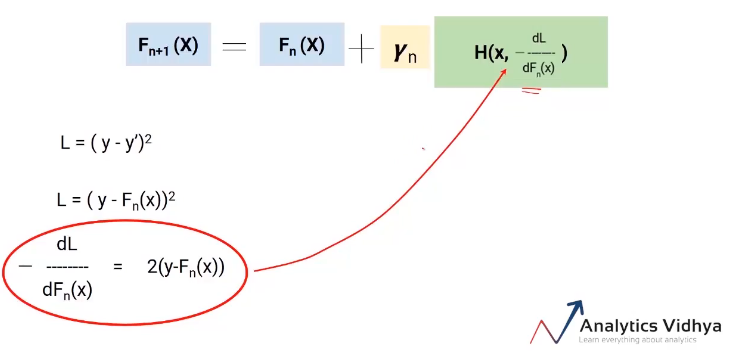
Entonces esta es nuestra ecuación final. La mejor parte de este algoritmo es que le da la libertad de decidir la función de pérdida. La única condición es que la función de pérdida sea diferenciable. Per facilitare la comprensione, usamos una función de pérdida muy simple (y-y') 2 pero puede cambiarla a una pérdida de bisagra o una pérdida logit o cualquier cosa.
El objetivo es minimizar la pérdida total. Veamos cuál sería la pérdida total aquí, será la pérdida hasta el modelo n más la pérdida del modelo actual que estamos construyendo. Aquí está la ecuación.
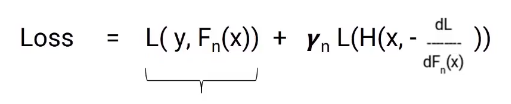
In questa equazione, la prima parte è fissa, ma la seconda parte è la perdita del modello su cui stiamo lavorando attualmente. La perdita di questo modello non può ancora essere modificata, ma possiamo cambiare il valore di gamma. Ora dobbiamo selezionare il valore di gamma in modo che la perdita totale sia minimizzata e questo valore venga selezionato tramite il processo di discesa del gradiente.
Quindi, L'idea è ridurre la perdita complessiva decidendo il valore ottimale di gamma per ogni modello che costruiamo.
Albero decisionale di gradient boosting
Parlo di un caso speciale di gradient boosting, vale a dire, albero decisionale di gradient boosting (GBDT). Qui, ogni modello sarebbe un albero e il valore di gamma verrà deciso a ciascun livello di foglia, non al livello generale del modello. Quindi, come mostrato nell'immagine seguente, ogni foglia avrebbe un valore gamma.
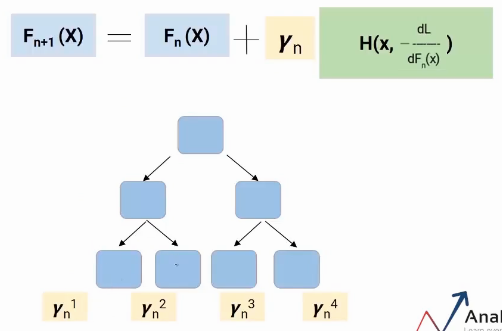
Ecco come funziona l'Albero Decisionale con Gradient Boosting.
Note finali
Boosting è un tipo di apprendimento ensemble. È un processo sequenziale in cui ogni modello cerca di correggere gli errori del modello precedente. Questo significa che ogni modello successivo dipende dai suoi predecessori. In questo articolo, abbiamo visto l'algoritmo di gradient boosting e la matematica dietro di esso.
Ora che abbiamo un'idea chiara dell'algoritmo, provate a costruire i modelli e ottenete un po' di esperienza pratica con esso.
Se stai cercando di iniziare il tuo viaggio nella scienza dei dati e desideri tutti gli argomenti sotto lo stesso tetto, la tua ricerca si ferma qui. Dai un'occhiata alle certificazioni AI e ML BlackBelt di DataPeaker Più Programma
Se hai qualche domanda, fammi sapere nella sezione commenti!
Se hai qualche domanda, fammi sapere nei commenti qui sotto.





