
introduzione
La manipolazione dei dati è una fase inevitabile del modellaggio predittivo. Non si può costruire un modello predittivo robusto semplicemente utilizzando algoritmi di apprendimento automatico. Ma, con un approccio per comprendere il problema aziendale, i dati sottostanti, effettuare le necessarie manipolazioni dei dati e poi estrarre informazioni aziendali.
Tra queste varie fasi della costruzione dei modelli, la maggior parte del tempo di solito viene dedicata a comprendere i dati sottostanti e effettuare le manipolazioni necessarie. Questo sarà anche il tema centrale di questo articolo: pacchetti per effettuare una manipolazione dei dati più rapida in R.
Cos'è la manipolazione dei dati?
Si todavía está confundido con este ‘término’, déjeme explicárselo. La manipulación de datos es un término que se utiliza de forma poco estricta con “Esplorazione dei dati”. Implica ‘manipular’ datos utilizando un conjunto de variables disponibles. Esto se hace para mejorar la exactitud y precisión asociadas con los datos.
In realtà, el proceso de recopilación de datos puede tener muchas lagunas. Hay varios factores incontrolables que conducen a la inexactitud en los datos, como la situación mental de los encuestados, sesgos personales, differenze / errores en las lecturas de las máquinas, eccetera. Para mitigar estas inexactitudes, se manipulan los datos para aumentar la precisión (massimo) posible en los datos.
Qualche volta, esta etapa también se conoce como disputa de datos o limpieza de datos.
Diferentes formas de manipular / gestire i dati:
Non esiste un modo giusto o sbagliato di manipolare i dati, purché li comprendiate e abbiate adottato le azioni necessarie alla fine dell'esercizio. tuttavia, ecco alcuni modi generali in cui le persone cercano di affrontare la manipolazione dei dati. Ecco:
- Generalmente, i principianti in R si sentono a proprio agio a manipolare i dati utilizzando le funzioni di base integrate in R. Questo è un buon primo passo, ma spesso è ripetitivo e richiede molto tempo. Perciò, è un modo meno efficiente di risolvere il problema.
- Uso dei pacchetti per la manipolazione dei dati. CRAN ha più di 7000 pacchetti disponibili attualmente. In parole semplici, questi pacchetti non sono altro che una raccolta di codici pre-scritti di uso comune. Vi aiutano a svolgere le attività ripetitive con facilità, reducen los errores en la codificación y reciben la ayuda del codice escrito por expertos (en todo el ecosistema de código abierto para R) para hacer que su código sea más eficiente. Esta suele ser la forma más común de realizar la manipulación de datos.
- Uso de algoritmos ML para manipulación de datos. Puede utilizar algoritmos de refuerzo basados en árboles para ocuparse de los datos faltantes y los valores atípicos. Si bien estos definitivamente requieren menos tiempo, estos enfoques generalmente lo dejan con ganas de una mejor comprensión de los datos al final.
Perciò, la mayoría de las veces, el uso de paquetes es el método de facto para realizar la manipulación de datos. In questo articolo, ho spiegato diversi pacchetti che facilitano la vita in R’ durante la fase di manipolazione dei dati.
Nota: Questo articolo è più adatto ai principianti del linguaggio R. È possibile installare un pacchetto utilizzando:
install.packages('package name')
Elenco dei pacchetti
Per una migliore comprensione, ho anche mostrato il loro utilizzo eseguendo operazioni di uso comune. Di seguito è riportato l'elenco dei pacchetti discussi in questo articolo:
- dplyr
- tabella dati
- ggplot2
- remodelr2
- lettore
- tidyr
- lubridate
Nota: Capisco che ggplot2 sia un pacchetto grafico. Ma, generalmente, aiuta a visualizzare i dati (distribuzioni, correlazioni) e a eseguire manipolazioni di conseguenza. Perciò, l'ho aggiunto a questo elenco. In tutti i pacchetti, ho trattato solo i comandi più utilizzati nella manipolazione dei dati.
pacchetto dplyr
Questi pacchetti sono creati e mantenuti da Hadley Wickham. Questo pacchetto ha tutto (quasi) per accelerare i tuoi sforzi di manipolazione dei dati. È meglio conosciuto per l'esplorazione e la trasformazione dei dati. La sua sintassi a catena lo rende altamente adattabile da usare. Incluye 5 comandi principali di manipolazione dei dati:
- filtro: filtra i dati in base a una condizione
- selezionare: si utilizza per selezionare colonne di interesse da un insieme di dati
- Organizzare: si utilizza per ordinare i valori dell'insieme di dati in ordine crescente o decrescente.
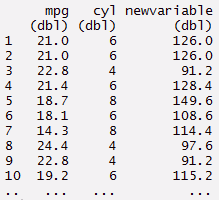
- mutare: si utilizza per creare nuove variabili a partire da variabili esistenti
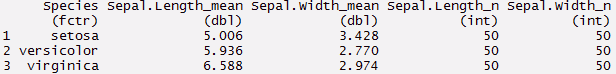
- astratto (con group_by): si utilizza per eseguire analisi tramite operazioni di uso comune, come minimo, massimo, conteggio medio, eccetera.
Concentrati su questi comandi e svolgi un ottimo lavoro nell'esplorazione dei dati. Comprendiamo questi comandi uno per uno. Ho utilizzato 2 insiemi di dati R preinstallati, vale a dire, mtcars e iris.
> biblioteca(dplyr)
> dati("mtcars")
> dati('iris')
> mydata <- mtcars
#leggere dati
> testa(mydata)
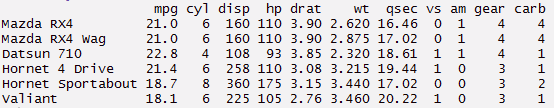
#creare un dataframe locale. I dataframe locali sono più facili da leggere

> mynewdata <- tbl_df(mydata)
> myirisdata <- tbl_df(iris)
#ora i dati saranno in struttura tabellare > mynewdata> myirisdata
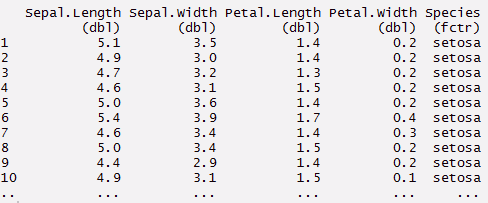
#usa filter per filtrare i dati con la condizione richiesta > filtro(mynewdata, Cil > 4 & gear > 4 )> filtro(mynewdata, Cil > 4)
> filtro (myirisdata, Species% in% c (setosa, virginica'))
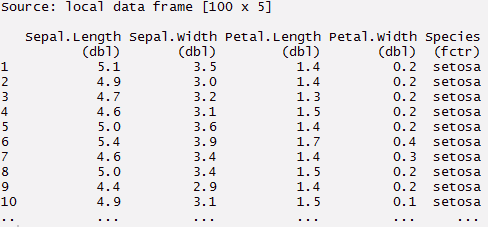
#utilizzo SelezionareIl comando "SELEZIONARE" è fondamentale in SQL, Utilizzato per interrogare e recuperare dati da un database. Consente di specificare colonne e tabelle, filtrare i risultati utilizzando clausole quali "DOVE" e ordinando con "ORDINA PER". La sua versatilità lo rende uno strumento essenziale per la manipolazione e l'analisi dei dati, facilitare l'ottenimento di informazioni specifiche in modo efficiente.... per selezionare colonne per nome > Selezionare(mynewdata, Cil,mpg,hp)#qui puoi usare (-) per nascondere colonne > Selezionare(mynewdata, -Cil, -mpg )
# nascondere un intervallo di colonne> selezionare (mynewdata, -C (Cil, mpg))
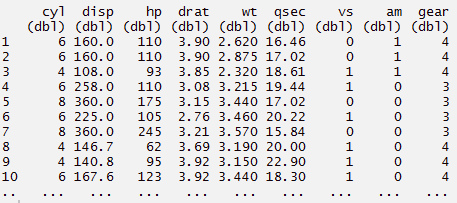
#catena o pipeline - a way to perform multiple operations
#in one line
> mynewdata %>%
     Selezionare(Cil, wt, gear)%>%
     filtro(wt > 2)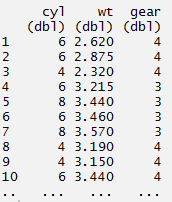
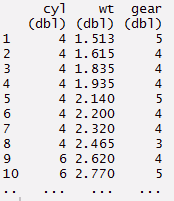
#arrange può essere usato per riordinare le righe
> mynewdata%>%
     Selezionare(Cil, wt, gear)%>%
     arrange(wt)
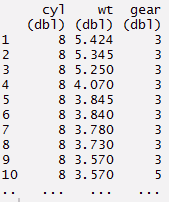
#o
> mynewdata%>%
     Selezionare(Cil, wt, gear)%>%
     arrange(desc(wt))
#mutare - creare nuove variabili

> mynewdata %>%
      Selezionare(mpg, Cil)%>%
      mutare(newvariable = mpg*cyl)
#o
> newvariable <- mynewdata %>% mutare(newvariable = mpg*cyl)
#riassumere - questo è usato per trovare informazioni dai dati
> myirisdata%>%
       group_by(Specie)%>%
       riassumere(Average = mean(Sepal.Length, na.rm = TRUE))
#oppure usa summarise_each
> myirisdata%>%
group_by(Specie)%>%
summarise_each(funs(Significare, n()), Sepal.Length, Sepal.Larghezza)
 #Puoi creare comandi complessi concatenando questi 5 verbi.
#puoi rinominare le variabili usando il comando rename
> mynewdata %>% rinominare(miles = mpg)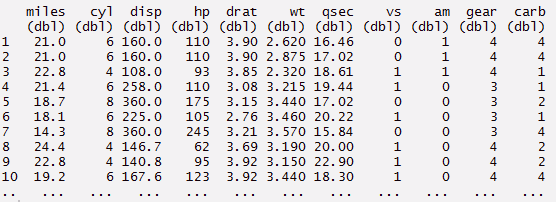
pacchetto data.table
Questo pacchetto le permette di effettuare una manipolazione più rapida su un set di dati. Abbandoni le forme tradizionali di sotto-configurazione di righe e colonne e usi questo pacchetto. Con una codifica minima, può fare molto di più. L'uso di data.table aiuta a ridurre il tempo di calcolo rispetto a data.frame. Rimarrà stupito dalla semplicità di questo pacchetto.
Una tabella di dati ha 3 parti, vale a dire, DT[io,J,di]. Può capire questo come, possiamo dire a R di fare un sottoinsieme delle righe usando ‘i’, per calcolare ‘j’’ che è raggruppato per ‘by’. La maggior parte delle volte, “di” si riferisce a una variabileIn statistica e matematica, un "variabile" è un simbolo che rappresenta un valore che può cambiare o variare. Esistono diversi tipi di variabili, e qualitativo, che descrivono caratteristiche non numeriche, e quantitativo, che rappresentano quantità numeriche. Le variabili sono fondamentali negli esperimenti e negli studi, poiché consentono l'analisi delle relazioni e dei modelli tra elementi diversi, facilitare la comprensione di fenomeni complessi.... Categorico. Nel seguente codice, ho usato 2 set di dati (qualità dell'aria e iris).
#carica dati
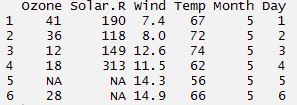
> dati("airquality")
> mydata <- airquality
> testa(airquality,6)
> dati(iris)
> myiris <- iris
#carica pacchetto
> biblioteca(data.table)
> mydata <- data.table(mydata)
> mydata
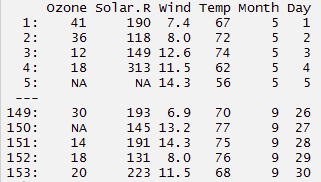
> myiris <- data.table(myiris)
> myiris
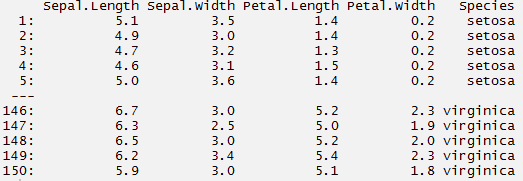
#sottoinsieme di righe - seleziona dalla 2ª alla 4ª riga

> mydata[2:4,]
#seleziona colonne con valori particolari
> myiris[Species == 'setosa']
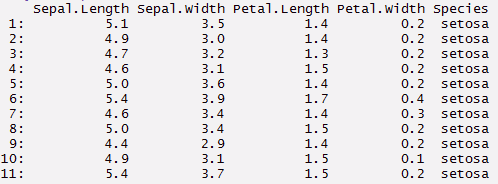
#seleziona colonne con valori multipli. This will give you columns with Setosa
#and virginica species
> myiris[Specie %in% c(setosa, virginica')]

#seleziona colonne. Restituisce un vettore
> mydata[,Temp]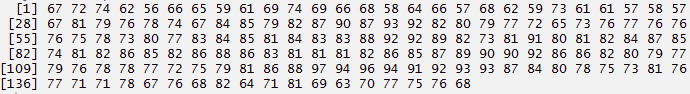
> mydata[,.(Temp,Mese)]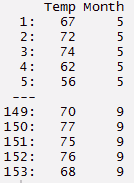
#restituisce la somma della colonna selezionata
> mydata[,somma(Ozono, na.rm = TRUE)]

[1]4887
#restituisce somma e deviazione standard
> mydata[,.(somma(Ozono, na.rm = TRUE), sd(Ozono, na.rm = TRUE))]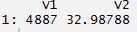
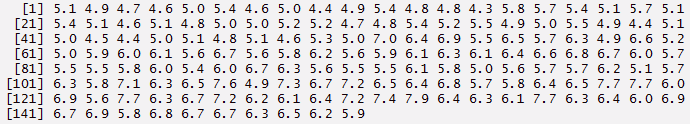
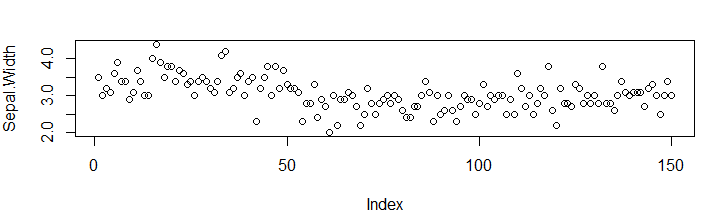
#stampa e traccia
> myiris[,{Stampa(Sepal.Length)
> complotto(Sepal.Larghezza)
 NULLO}]
#raggruppamento per una variabile
> myiris[,.(sepalsum = somma(Sepal.Length)), by=Specie]
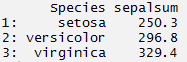
#seleziona una colonna per il calcolo, quindi è necessario impostare la chiave sulla colonna
> setkey(myiris, Specie)

#seleziona tutte le righe associate a questo punto dati
> myiris[setosa]
> myiris[C(setosa, virginica')]
Paquete ggplot2
ggplot ofrece un mundo completamente nuevo de colores y patrones. Si eres un alma creativa, te encantará este paquete hasta el fondo. Ma, si desea aprender lo que es necesario para comenzar, siga los códigos a continuación. Debe aprender las formas de trazar al menos estos 3 grafica: Diagramma di dispersioneIl grafico a dispersione è uno strumento grafico utilizzato in statistica per visualizzare la relazione tra due variabili. Consiste in un insieme di punti in un piano cartesiano, dove ogni punto rappresenta una coppia di valori corrispondenti alle variabili analizzate. Questo tipo di grafico consente di identificare i modelli, Tendenze e possibili correlazioni, facilitare l'interpretazione dei dati e il processo decisionale sulla base delle informazioni visive presentate...., Diagrama de barras, Istogramma.
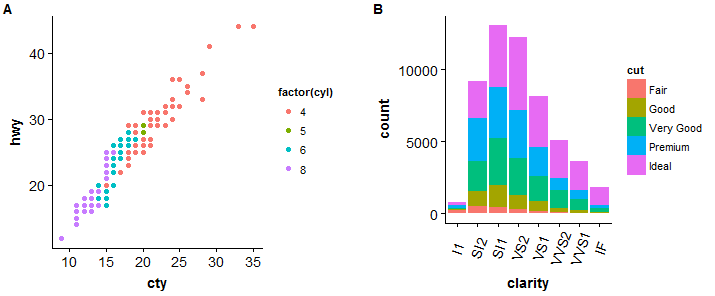
Queste 3 patrones de gráficos cubren casi todos los tipos de representación de datos, excepto mapas. ggplot è arricchito con funzioni personalizzate per rendere la tua visualizzazione sempre migliore. Diventa ancora più potente quando è combinato con altri pacchetti come cowplot, gridExtra. Infatti, ci sono molte funzioni. Perciò, dovresti concentrarti su alcuni comandi e sviluppare la tua esperienza in essi. Ho anche mostrato il metodo per confrontare grafici in una finestra. Richiede il pacchetto 'gridExtra'. Perciò, devi installarlo. Ho usato set di dati preinstallati in R.
> biblioteca(ggplot2)
> biblioteca(gridExtra)
> df <- ToothGrowth
> df$dose <- come.fattore(df$dose)
> testa(df)
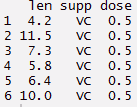
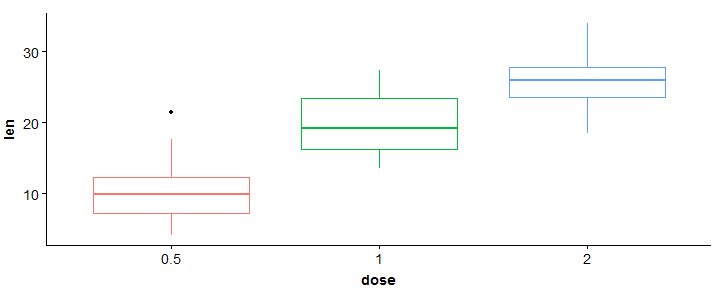
#trama a scatole
> bp <- ggplot(df, aes(x = dose, y = len, color = dose)) + geom_boxplot() + Tema(legend.position = 'none')
> bp
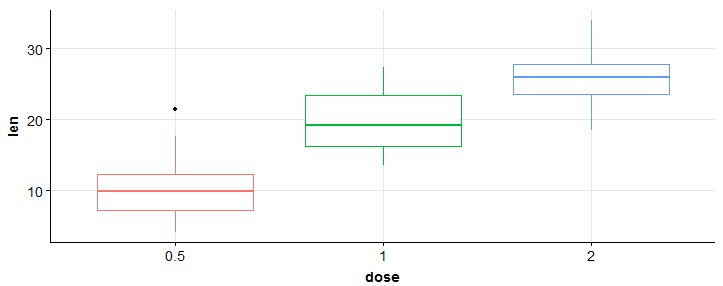
#aggiungi griglie
> bp + background_grid(major = "xy", minor ="nessuno")
#scatterplot
> sp <- ggplot(mpg, aes(x = cty, y = hwy, color = factor(Cil)))+geom_point(dimensione = 2.5)
> sp
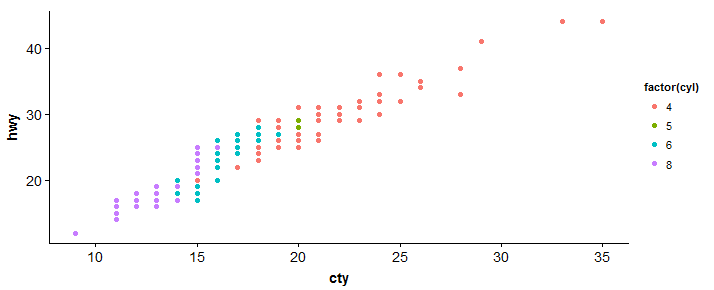
#barplot
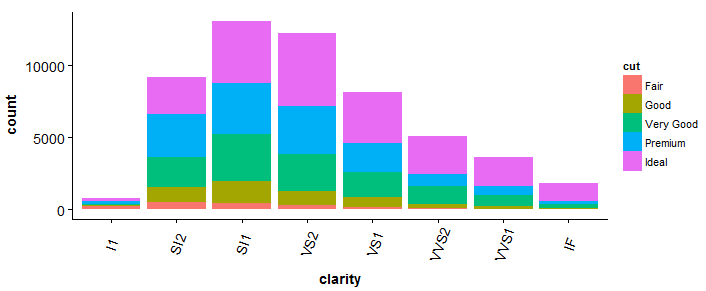
> bp <- ggplot(diamonds, aes(clarity, fill = cut)) + geom_bar() +Tema(axis.text.x = element_text(angle = 70, vjust = 0.5))
> bp
#confrontare due grafici
> plot_grid(sp, bp, labels = c("UN","B"), ncol = 2, nrow = 1)
 #istogramma
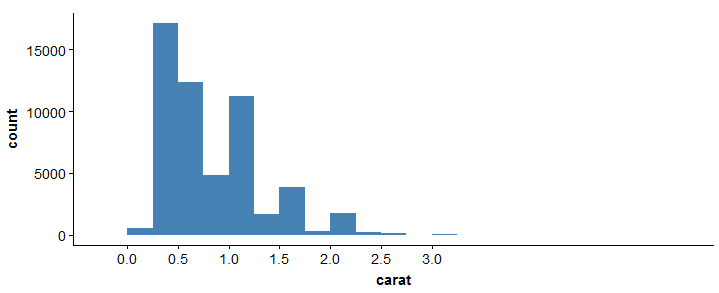
> ggplot(diamonds, aes(x = carat)) + geom_histogram(binwidth = 0.25, riempimento="steelblue")+scale_x_continuous(breaks=seq(0,3, by=0.5))
Per ulteriori informazioni su questo pacchetto, consulta la scheda di riferimento qui: scheda di riferimento di ggplot2
pacchetto reshape2
Come suggerisce il nome, questo pacchetto è utile per rimodellare i dati. Tutti sappiamo che i dati vengono in molte forme. Perciò, siamo obbligati a domarli secondo le nostre esigenze. Generalmente, Il processo di rimodellamento dei dati in R è tedioso e preoccupante. Le funzioni di base di R consistono nell'opzione 'Aggregazione'’ mediante la quale i dati possono essere ridotti e riorganizzati in forme più piccole, ma con una riduzione della quantità di informazioni. L'aggregazione include funzioni di base come tapply,, by e aggregate. Il pacchetto di rimodellamento risolve questi problemi. Qui cerchiamo di combinare caratteristiche che hanno valori unici. Ho 2 funzioni da conoscere fondere e emettere.
fondere : Questa funzione converte i dati da formato largo a formato lungo. È un modo di ristrutturazione in cui più colonne categoriali vengono 'fuse'’ in righe uniche. Comprendiamo usando il codice sottostante.
#creare un dato
> ID <- C(1,2,3,4,5)
> Nomi <- C('Joseph','Matrin','Joseph','James','Matrin')
> DataDiNascita <- C(1993,1992,1993,1994,1992)
> Oggetto<- C('Matematica','Biologia','Scienze','Psicologia','Fisica')
> questi dati <- data.frame(ID, Nomi, DataDiNascita, Oggetto)
> data.table(questi dati)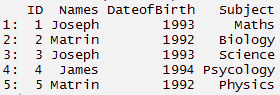
#carica pacchetto
> install.packages('reshape2')
> biblioteca(rimodellare2)
#Fondere
> mt <- Fondere(questi dati, id=(C('ID','Nomi')))
> mt
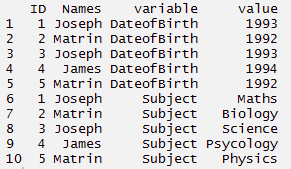
emettere : Questa funzione converte i dati da formato lungo a formato largo. Inizia con dati fusi e cambia in formato largo. È solo l'inverso di fondere funzione. Ha due funzioni da conoscere, dcast e uno stampo. dcast restituisce un data frame come output. acast restituisce un vettore / Sede centrale / matrice come output. Comprendiamo usando il codice sottostante.
#lancio
> mcast <- dcast(mt, DataDiNascita + Subject ~ variable)
> mcast
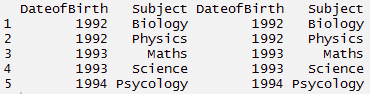
Nota: Durante la ricerca, ho trovato questa immagine che descrive accuratamente il pacchetto di ristrutturazione.
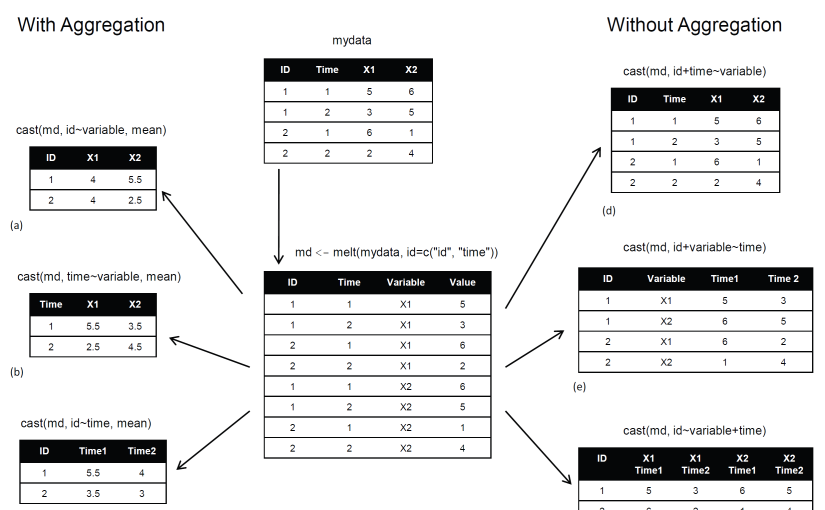 fonte: r-statistiche
Pacchetto readr
Come suggerisce il nome, 'readr'’ Aiuta a leggere varie forme di dati in R. Con una velocità 10 volte più veloce. Qui, i caratteri non vengono mai convertiti in fattori (quindi non più stringAsFactors = FALSE). Questo pacchetto può sostituire le funzioni tradizionali di R base read.csv () e read.table (). Aiuta a leggere i seguenti dati:
- File delimitati con
read_delim(),read_csv(),read_tsv(), eread_csv2(). - File a larghezza fissa con
read_fwf(), eread_table(). - File di registro web con
read_log()
Se il tempo di caricamento dei dati è superiore a 5 secondi, questa funzione mostrerà anche una barra di avanzamento. È possibile sopprimere la barra di avanzamento impostandola su FALSE. Vediamo il seguente codice:
> install.packages('readr')
> biblioteca(readr)
> read_csv('test.csv',col_names = TRUE)
È anche possibile specificare il tipo di dati di ciascuna colonna caricata nei dati utilizzando il seguente codice:
> read_csv("iris.csv", col_types = list(
      Sepal.Length = col_double(),
      Ampiezza.Sepalo = col_double(),
      Lunghezza.Petalo = col_double(),
      Ampiezza.Petalo = col_double(),
      Specie = col_factor(C("setosa", "Versicolor", "virginica"))
))
tuttavia, se si sceglie di omettere colonne non importanti, si occuperà di questo automaticamente. Quindi, il codice precedente può anche essere riscritto come:
> read_csv("iris.csv", col_types = list(
           Specie = col_factor(C("setosa", "Versicolor", "virginica"))
)
PS – readr ha molte funzioni ausiliarie. Quindi, quando si scrive un file csv, usa write_csv al suo posto. È molto più veloce di write.csv.
pacchetto tidyr
Questo pacchetto può rendere i tuoi dati più chiari “organizzato”. Ho 4 funzioni principali per eseguire questo compito. Non c'è bisogno di dire che se ti blocchi nella fase di esplorazione dei dati, puoi usarli in qualsiasi momento (insieme a dplyr). Questo duo forma una squadra formidabile. Sono facili da imparare, codificare e implementare. Sono 4 le funzioni sono:
- raccogliere () – ‘gather’ più colonne. Dopo, le converte in coppie chiave: valore. Esta función se transformará de forma amplia de datos a forma larga. Puede usarlo como una alternativa a ‘derretir’ en el paquete de remodelación.
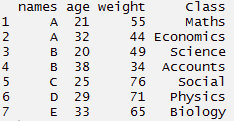
- spread (): se invierte de recopilar. Toma un par clave: valor y lo convierte en columnas separadas.
- spezzare (): divide una columna en varias columnas.
- unite (): se invierte o se separa. Une varias columnas en una sola columna
Entendamos de cerca usando el siguiente código:
#carica pacchetto
> biblioteca(tidyr)
#create a dummy data set
> nomi <- C('A','B','C','D','E','A','B')
> weight <- C(55,49,76,71,65,44,34)
> età <- C(21,20,25,29,33,32,38)
> Classe <- C('Matematica','Scienze','Social','Fisica','Biologia','Economics','Accounts')
#create data frame > tdata <- data.frame(nomi, età, weight, Classe) > tdata#using gather function > long_t <- tdata %>% gather(Chiave, Valore, weight:Classe) > long_t
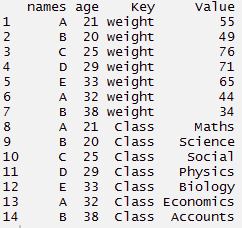
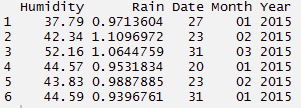
La función separada se usa mejor cuando se nos proporciona una variable de fecha y hora en el conjunto de datos. Dado que la columna contiene información múltiple, tiene sentido dividirla y usar esos valores individualmente. Usando el codice a continuación, ho separato una colonna in data, mese e anno.
#creare un set di dati
> Umidità <- C(37.79, 42.34, 52.16, 44.57, 43.83, 44.59)
> Pioggia <- C(0.971360441, 1.10969716, 1.064475853, 0.953183435, 0.98878849, 0.939676146)
> Ore <- C("27/01/2015 15:44","23/02/2015 23:24", "31/03/2015 19:15", "20/01/2015 20:52", "23/02/2015 07:46", "31/01/2015 01:55")
#costruire un data frame
> d_set <- data.frame(Umidità, Pioggia, Ore)
#usando la funzione separate possiamo separare la data, mese, anno
> separate_d <- d_set %>% separate(Ore, C(Data, 'Mese','Anno'))
> separate_d
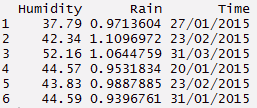
 #usando la funzione unite - il contrario di separate
> unite_d <- separate_d%>% unite(Ore, C(Data, Mese, Anno), SEP = "/")
> unite_d
 #utilizzando la funzione di propagation - l'inverso della raccolta> wide_t % spread (chiave, valore)> wide_t
Pacchetto Lubridate
Il pacchetto Lubridate riduce il fastidio di lavorare con la variabile temporale dei dati in R. La funzione incorporata di questo pacchetto offre un buon modo per facilitare l'analisi di date e ore. Questo pacchetto viene utilizzato frequentemente con dati che comprendono dati puntuali. Qui ho coperto tre compiti di base eseguiti con Lubridate.
Questo include funzione di aggiornamento, funzione di durata e estrazione della data. Come principiante, conoscere queste 3 le funzioni forniranno l'esperienza sufficiente per gestire le variabili temporali. Sebbene, R ha funzioni integrate per gestire le date, ma questo è molto più veloce. Comprendiamo usando il seguente codice:
> install.packages('lubridate')
> biblioteca(lubridate)
#data e ora correnti
> ora()
[1] "2015-12-11 13:23:48 IST"
#assegnare la data e l'ora correnti alla variabile n_time
> n_time <- ora()
#usando la funzione update
> n_update <- aggiornare(n_time, anno = 2013, mese = 10)
> n_update
[1] "2013-10-11 13:24:28 IST"
#aggiungere giorni, mesi, anno, Secondi
> d_time <- ora()
> d_time + ddays(1)
[1] "2015-12-12 13:24:54 IST"
> d_time + dweeks(2)
[1] "2015-12-12 13:24:54 IST"

> d_time + dyears(3)
[1] "2018-12-10 13:24:54 IST"

> d_time + dhours(2)
[1] "2015-12-11 15:24:54 IST"

> d_time + dminutes(50)
[1] "2015-12-11 14:14:54 IST"

> d_time + dseconds(60)
[1] "2015-12-11 13:25:54 IST"
#estrarre la data,tempo
> n_time$hour <- ora(ora())
> n_time$minute <- minuto(ora())
> n_time$second <- secondo(ora())
> n_time$month <- mese(ora())
> n_time$year <- anno(ora())
#controllare le date estratte in colonne separate
> new_data <- data.frame(n_time$hour, n_time$minute, n_time$second, n_time$month, n_time$year)
> new_data
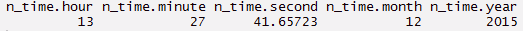
Nota: Il miglior uso di questi pacchetti non è in modo isolato ma insieme. Puoi usare facilmente questo pacchetto con dplyr, dove puoi facilmente selezionare una variabile di dati ed estrarre i dati utili da essa usando il comando in catena.
Note finali
Questi pacchetti non solo migliorerebbero la tua esperienza nella manipolazione dei dati, ma ti darebbero anche motivi per esplorare R in profondità. Ora che abbiamo visto, questi pacchetti facilitano la codifica in R. Non è più necessario scrivere lunghi codici. Anziché, scrivi codici brevi e fai di più.
Ogni pacchetto ha capacità multitasking. Perciò, ti suggerisco di ottenere una funzione importante che può essere usata frequentemente. E, una volta che ti familiarizzerai con essi, potrai approfondire ulteriormente. Inizialmente ho commesso questo errore. Ho provato a esplorare tutte le funzioni di ggplot2 e ho finito per confondermi. Ti suggerisco di praticare questi codici mentre leggi. Questo ti aiuterebbe a guadagnare fiducia nell'uso di questi pacchetti.
In questo articolo, ho spiegato l'uso dei pacchetti di 7 R può rendere l'esplorazione dei dati più semplice e veloce. R è noto per le sue incredibili funzionalità statistiche, con pacchetti recentemente aggiornati, lo rende anche uno strumento preferito dagli scienziati dei dati.





