Questo articolo è stato pubblicato nell'ambito del Blogathon sulla scienza dei dati.
Comprendere il problema dell'overfitting negli alberi decisionali e risolverlo eliminando la complessità e il costo minimo utilizzando Scikit-Learn in Python
Decision Tree è uno degli strumenti più intuitivi ed efficaci nel toolkit di un data scientist.. Ha una struttura ad albero invertita che una volta veniva utilizzata solo nell'analisi delle decisioni, ma ora è anche un brillante algoritmo di apprendimento automatico, soprattutto quando abbiamo un problema di smistamento tra le mani.
Questi alberi decisionali sono ben noti per la loro capacità di acquisire modelli nei dati.. Ma, l'eccesso di qualsiasi cosa è dannoso, verità? Gli alberi decisionali sono famigerati perché possono aggrapparsi troppo ai dati su cui sono addestrati.
Perciò, il nostro albero fornisce scarsi risultati di implementazione perché non può gestire un nuovo insieme di valori.
Ma non preoccuparti! Come un abile meccanico, nella sua cassetta degli attrezzi ha a disposizione chiavi inglesi di tutte le dimensioni, un abile data scientist ha anche il suo set di tecniche per affrontare qualsiasi tipo di problema. Ed è quello che esploreremo in questo articolo..
Il ruolo della potatura negli alberi decisionali
La potatura è una delle tecniche utilizzate per superare il nostro problema di sovradattamento. Potatura, nel suo senso letterale, è una pratica che prevede la rimozione selettiva di alcune parti di un albero (la pianta), come rami, germogli o radici, per migliorare la struttura dell'albero e promuovere una crescita sana. Questo è esattamente ciò che fa anche la potatura con i nostri alberi decisionali. Lo rende versatile in modo che possa adattarsi se gli diamo qualche tipo di nuova informazione, risolvendo così il problema del sovradattamento.
Ridurre le dimensioni di un albero decisionale, lo que puede aumentar ligeramente el error de addestramentoLa formazione è un processo sistematico volto a migliorare le competenze, conoscenze o abilità fisiche. Viene applicato in vari ambiti, come lo sport, Formazione e sviluppo professionale. Un programma di allenamento efficace include la pianificazione degli obiettivi, Pratica regolare e valutazione dei progressi. L'adattamento alle esigenze individuali e la motivazione sono fattori chiave per ottenere risultati di successo e sostenibili in qualsiasi disciplina...., ma diminuisci drasticamente l'errore di test, cosa lo rende più adattabile.
Potatura di minimo costo e complessità è uno dei tipi di potatura degli alberi decisionali.
Questo algoritmo è parametrizzato da α (≥0) noto come parametro di complessità.
Il parametro complessità viene utilizzato per definire la misura della complessità dei costi, Run(T) di un dato albero T: Run(T) = R (T) + un | T |
dove | T | è il numero di nodi terminali in T e R (T) è tradizionalmente definito come il tasso di misclassificazione totale dei nodi terminali.
Nella sua versione 0.22, Scikit-learn ha introdotto questo parametro chiamato ccp_alpha (sì! È l'abbreviazione di Potatura della complessità dei costi – Alfa) ad alberi decisionali che possono essere utilizzati per fare lo stesso.
Costruire l'albero decisionale in Python
Useremo il set di dati Iris per adattarlo all'albero decisionale. Puoi scaricare il set di dati qui.
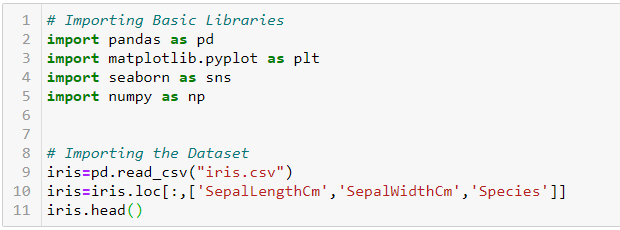
Primo, importiamo le librerie di base e il set di dati richiesti:
Il set di dati è simile a questo:
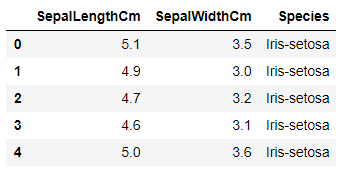
Il nostro obiettivo è prevedere la specie di un fiore in base alla lunghezza e alla larghezza del suo sepalo.
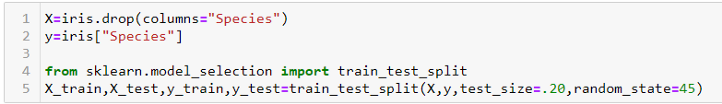
Divideremo il set di dati in due parti: allenati e prova. Lo stiamo facendo in modo da poter vedere come funziona il nostro modello anche su dati invisibili. Useremo il train_test_split funzione di sklearn.model_selection dividere il set di dati.
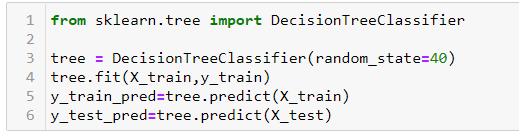
Ora, adattiamo un albero decisionale alla parte del treno e prevediamo sia nel test che nell'allenamento. noi useremo Classificatore albero decisionale a partire dal sklearn.tree per questo scopo.
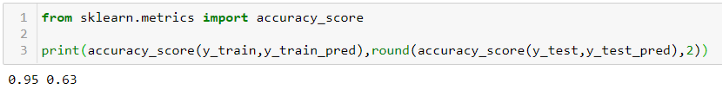
Per impostazione predefinita, la funzione albero decisionale non esegue alcuna potatura e consente all'albero di crescere il più possibile. Otteniamo un punteggio di precisione di 0,95 e 0,63 sul treno e sul provino, rispettivamente, come mostrato di seguito. Possiamo dire che il nostro modello è overfitted, vale a dire, memorizzare la parte del treno, ma potrebbe non funzionare altrettanto bene nella parte di prova.
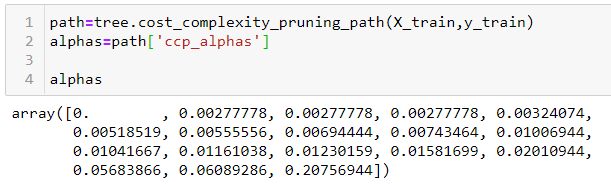
Albero decisionale in sklearn ha una funzione chiamata cost_complexity_pruning_path, che fornisce gli alfa effettivi dei sottoalberi durante la potatura e anche le corrispondenti impurità. In altre parole, possiamo usare questi valori alfa per sfoltire il nostro albero decisionale:
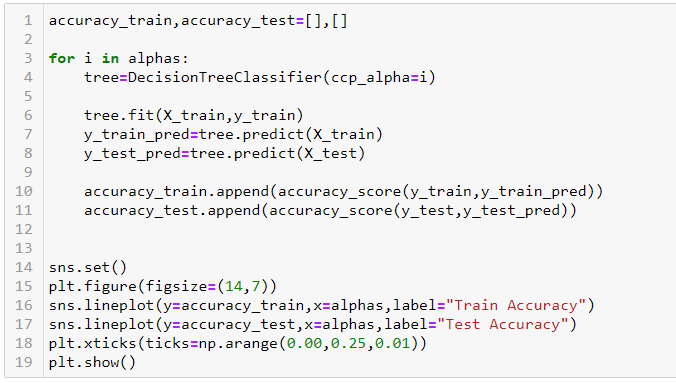
Imposteremo questi valori alfa e li passeremo a ccp_alpha parametro del nostro Classificatore albero decisionale. In loop su di esso alfas Sede centrale, troveremo la precisione nelle parti di addestramento e test del nostro set di dati.
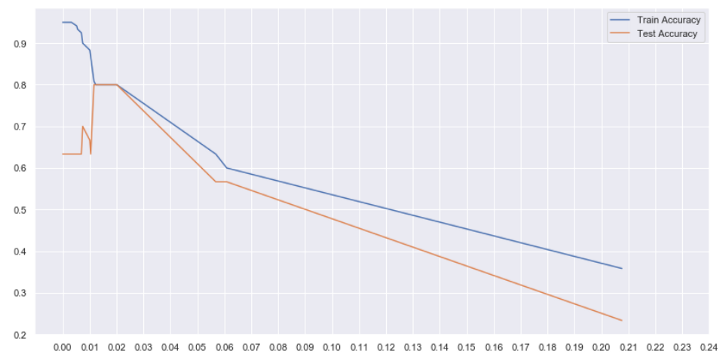
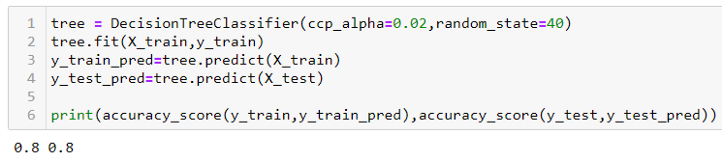
Nel grafico sopra, possiamo vedere che tra alfa = 0.01 e 0.02, otteniamo la massima precisione di prova. Anche se la precisione del nostro treno è diminuita a 0,8, il nostro modello è ora più generalizzato e funzionerà meglio con dati invisibili.