
Introdução
é um componente importante, bem como uma das etapas mais subestimadas em qualquer projeto de ciência de dados. O EDA é essencial para uma análise de dados bem definida e estruturada e deve ser feito antes da fase de modelagem de aprendizado de máquina.
Envolve encontrar ideias a partir dos dados após observação cuidadosa e resumir ainda mais suas características principais.. Geralmente, os dados da vida real com os quais trabalhamos contêm muitos “barulho” e, portanto, realizar a análise de dados manualmente em tais conjuntos de dados torna-se um processo complicado e tedioso.
Tutorial introdutório ao Python: cálculo científico com pandas | por entusiasta de análise de dados | Metade
Piton é uma das línguas mais utilizadas para Ciência de dados particularmente devido à presença de várias bibliotecas e pacotes que facilitam a análise de dados.
Respectivamente, Pandas é uma das bibliotecas Python mais populares que ajuda a apresentar dados de uma forma adequada para análise por meio de seu Série e Quadro de dados Estruturas de dados. Fornece várias funções e métodos para simplificar e acelerar o processo de análise de dados.
Aqui usamos o conjunto de dados "TITANIC" para realizar a implementação prática de todas as funções.
Em primeiro lugar, importamos a biblioteca Numpy e pandas e, em seguida, lemos o conjunto de dados.

Agora vamos começar
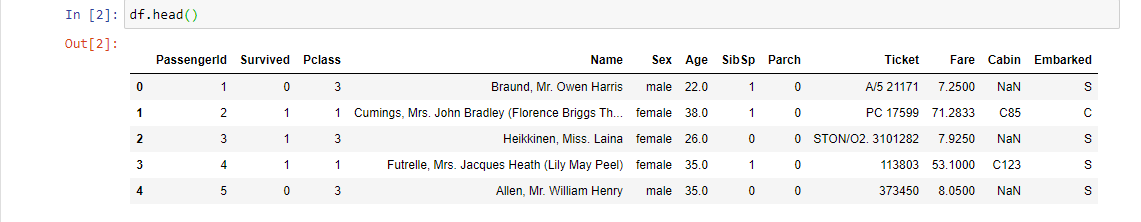
1. df.head (): Por padrão, retorna o primeiro 5 linhas de quadro de dados. Para alterar o valor padrão, você pode inserir um valor entre parênteses para alterar o número de linhas retornadas.
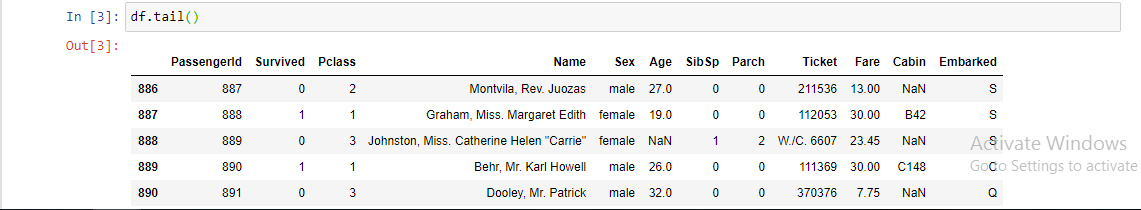
2. df.tail (): Por padrão, retorna o último 5 linhas de quadro de dados. Esta função é usada para obter as últimas n linhas. Esta função retorna as últimas n linhas do objeto de acordo com a posição.
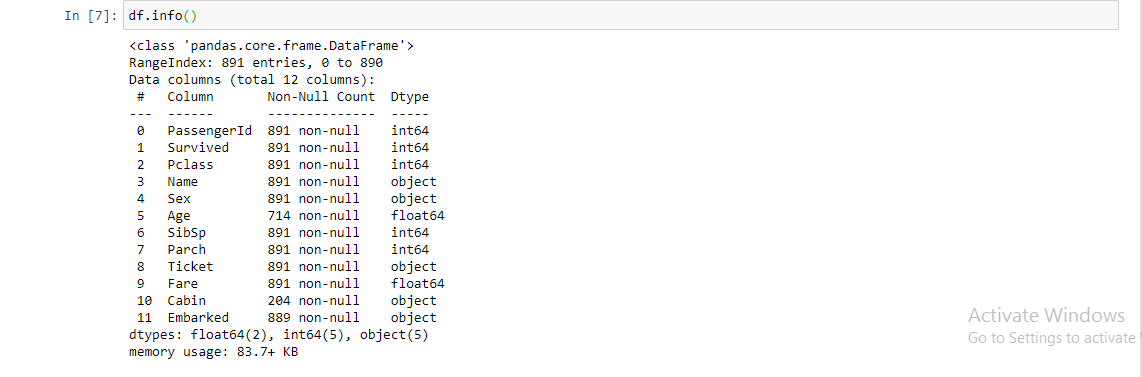
3. df.info (): Ajuda a obter uma visão geral rápida do conjunto de dados. Esta função é usada para obter um breve resumo do quadro de dados. Este método imprime informações sobre um DataFrame, incluído o tipo de índiceo "Índice" É uma ferramenta fundamental em livros e documentos, que permite localizar rapidamente as informações desejadas. Geralmente, é apresentado no início de um trabalho e organiza os conteúdos de forma hierárquica, incluindo capítulos e seções. Sua correta preparação facilita a navegação e melhora a compreensão do material, tornando-se um recurso essencial para estudantes e profissionais de várias áreas.... e os tipos de coluna, valores não nulos e uso de memória.
4. df. Forma: Mostra o número de dimensões assim como o tamanho em cada dimensão"Dimensão" É um termo usado em várias disciplinas, como a física, Matemática e filosofia. Refere-se à extensão em que um objeto ou fenômeno pode ser analisado ou descrito. Em física, por exemplo, fala-se de dimensões espaciais e temporais, enquanto em matemática pode se referir ao número de coordenadas necessárias para representar um espaço. Compreendê-lo é fundamental para o estudo e.... Uma vez que os quadros de dados são bidimensionais, a forma que ele retorna é o número de linhas e colunas.

5. tamanho df.: Retorna um int que representa o número de elementos neste objeto. Retorna o número de linhas se for Série; de outra forma, retorna o número de linhas multiplicado pelo número de colunas se for DataFrame.

6. df.ndim: Retorna a dimensão da moldura / série de dados. 1 para uma dimensão (série), 2 para duas dimensões (quadro de dados).

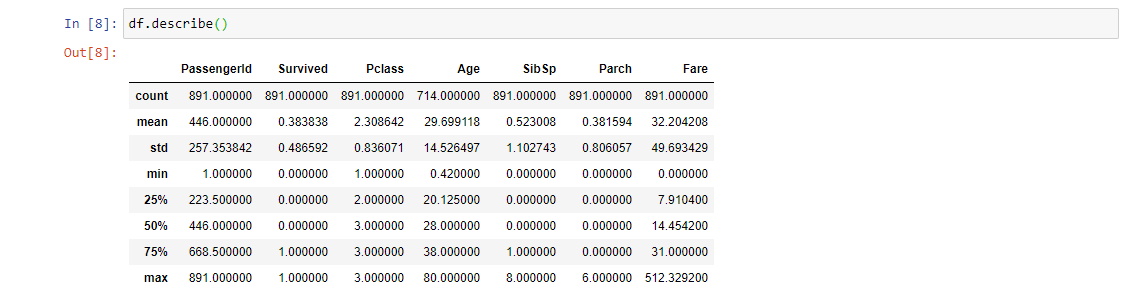
7. df.describe (): Retorna um resumo estatístico das colunas numéricas presentes no conjunto de dados. Este método calcula algumas medidas estatísticas, como o percentil, a média e o desvio padrão dos valores numéricos da Série ou DataFrame.
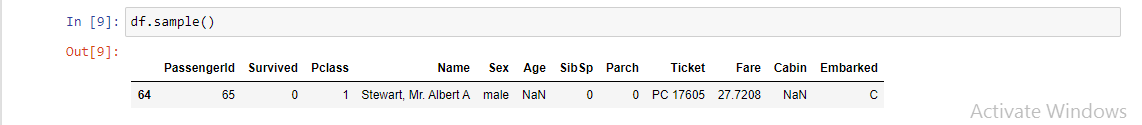
8. df.sample (): Usado para amostrar aleatoriamente em uma linha ou coluna. Permite que você selecione aleatoriamente valores de uma série ou DataFrame. É útil quando queremos selecionar uma amostra aleatória de uma distribuição.
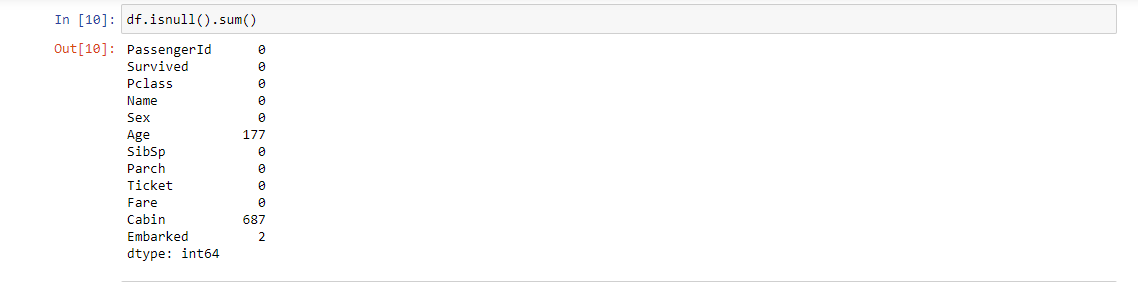
9. df.isnull () .soma (): Retorna o número de valores ausentes em cada coluna.
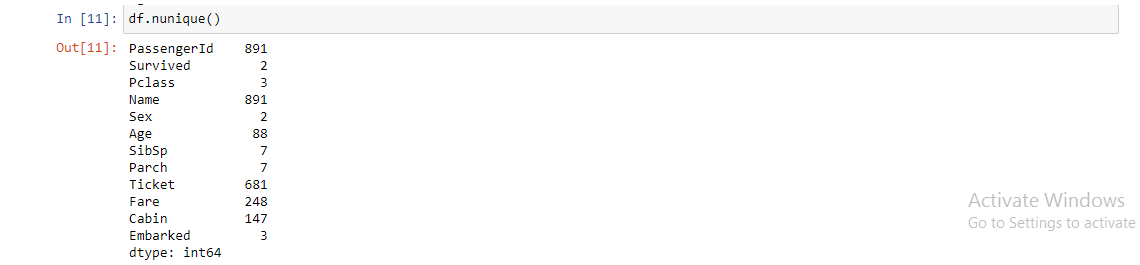
10. df.nunique (): Retorna o número de elementos únicos no objeto. Conta o número de entradas únicas em colunas ou linhas. É muito útil em características categóricas, especialmente nos casos em que não sabemos o número de categorias com antecedência.
11. df.index: Esta função procura um determinado elemento do início da lista e retorna o índice mais baixo onde o elemento aparece.

12. colunas df .: Retorna os rótulos das colunas do quadro de dados.

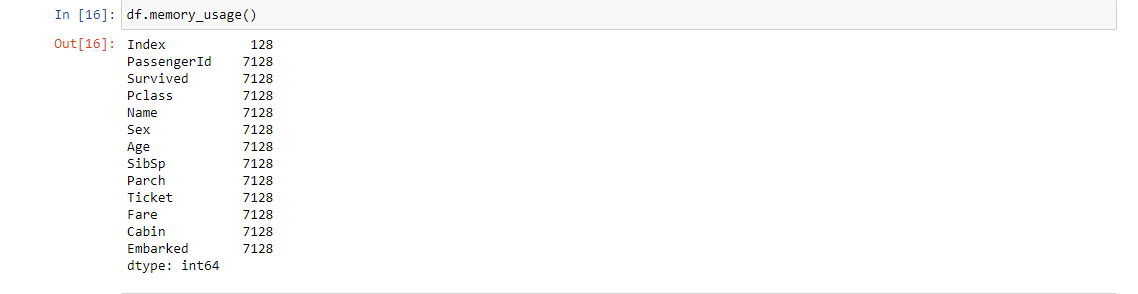
13. df.memory_usage (): Retorna quanta memória cada coluna usa em bytes. É útil especialmente ao trabalhar com grandes quadros de dados.
14. df.dropna (): Esta função é usada para remover uma linha ou coluna de um quadro de dados que tem um NaN ausente ou valores.

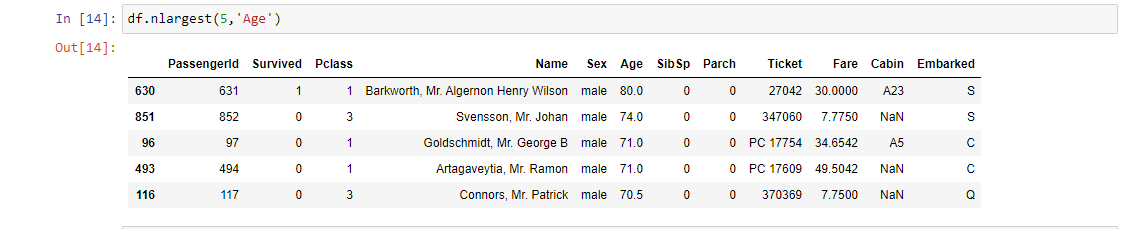
15. df.nlargest (): Retorna o primeiro Norte linhas ordenadas por colunas por ordem decrescente.
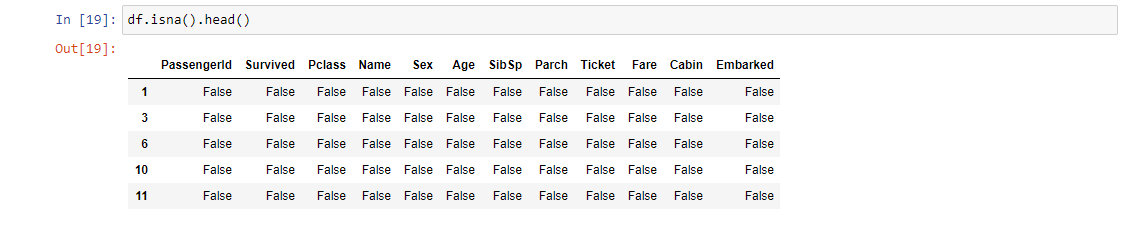
16. df.isna (): Esta função retorna um quadro de dados preenchido com valores booleanos com verdadeiro indicando valores ausentes.
17. df.duplicated (): Retorna uma string booleana denotando linhas duplicadas.

18. valor_contas (): Esta função é usada para obter uma série contendo contagens de valores únicos. O objeto resultante estará em ordem decrescente para que o primeiro elemento seja o elemento que ocorre com mais frequência. Exclua valores ausentes por padrão. Esta função é útil quando queremos verificar o problema do desequilíbrio de classes para uma variávelEm estatística e matemática, uma "variável" é um símbolo que representa um valor que pode mudar ou variar. Existem diferentes tipos de variáveis, e qualitativo, que descrevem características não numéricas, e quantitativo, representando quantidades numéricas. Variáveis são fundamentais em experimentos e estudos, uma vez que permitem a análise de relações e padrões entre diferentes elementos, facilitando a compreensão de fenômenos complexos.... Categórico.

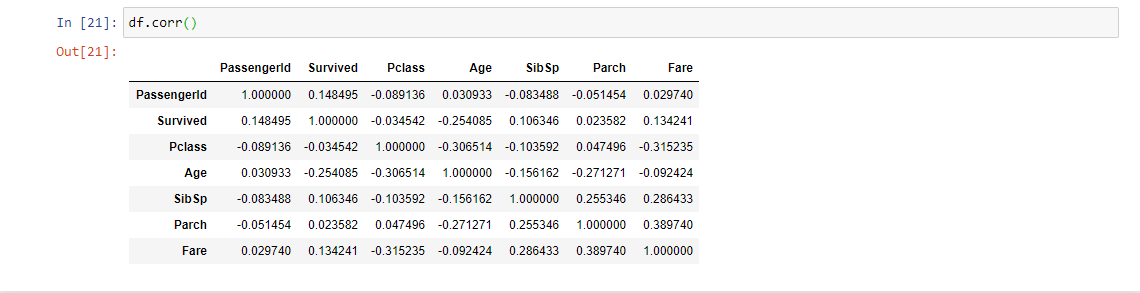
19. df.corr (): Esta função é usada para encontrar a correlação de pares de todas as colunas no quadro de dados. Valores ausentes são excluídos automaticamente. Para qualquer coluna de tipo de dados não numéricos no quadro de dados, é ignorado. Esta função é útil ao fazer a seleção de recursos, observando a correlação entre os recursos e a variável de destino ou entre as variáveis.
20. tipos de df.d: Esta função mostra o tipo de dados de cada coluna.
Notas finais
Obrigado pela leitura!
Se gostou e quer saber mais, visite meus outros artigos sobre ciência de dados e aprendizado de máquina clicando no link
Sinta-se à vontade para entrar em contato comigo em Linkedin, Correio eletrônico.
Qualquer coisa não mencionada ou você deseja compartilhar suas idéias? Sinta-se à vontade para comentar abaixo e eu entrarei em contato com você.
Até então, fique em casa, fique seguro para evitar a propagação de COVID-19, E continue aprendendo!
Sobre o autor
Chirag Goyal
Atualmente, Estou cursando bacharelado em tecnologia (B.Tech) em Ciência da Computação e Engenharia da Instituto Indiano de Tecnologia de Jodhpur (IITJ). Estou muito animado com o aprendizado de máquina, a aprendizado profundoAqui está o caminho de aprendizado para dominar o aprendizado profundo em, Uma subdisciplina da inteligência artificial, depende de redes neurais artificiais para analisar e processar grandes volumes de dados. Essa técnica permite que as máquinas aprendam padrões e executem tarefas complexas, como reconhecimento de fala e visão computacional. Sua capacidade de melhorar continuamente à medida que mais dados são fornecidos a ele o torna uma ferramenta fundamental em vários setores, da saúde... e inteligência artificial.
A mídia mostrada neste artigo não é propriedade da DataPeaker e é usada a critério do autor.





