
Fonte: https://www.serokell.io
Na foto acima, pode ver que os e-mails são classificados como spam ou não. Então, é um exemplo de classificação (classificação binária).
1. Regressão logística
2. Bayes ingenuo
3. Vizinhos mais próximos
5. Árvore de decisão
Veremos todos os algoritmos com um pequeno código aplicado ao conjunto de dados do iris que é utilizado para tarefas de classificação. O conjunto de dados tem 150 instâncias (filas), 4 caracteristicas (colunas) e não contém nenhum valor nulo. Existem 3 classes no conjunto de dados do iris:
– Silky Iris
– Iris Versicolor
– Iris Virginica
É um algoritmo de classificação muito básico mas importante em aprendizagem automática que utiliza uma ou mais variáveis independentes para determinar um resultado. A regressão logística tenta encontrar a relação que melhor se ajusta entre a variávelEm estatística e matemática, uma "variável" é um símbolo que representa um valor que pode mudar ou variar. Existem diferentes tipos de variáveis, e qualitativo, que descrevem características não numéricas, e quantitativo, representando quantidades numéricas. Variáveis são fundamentais em experimentos e estudos, uma vez que permitem a análise de relações e padrões entre diferentes elementos, facilitando a compreensão de fenômenos complexos.... dependente e um conjunto de variáveis independentes. A linha que melhor se ajusta neste algoritmo assemelha-se à forma de S, conforme mostrado no figura"Figura" é um termo usado em vários contextos, Da arte à anatomia. No campo artístico, refere-se à representação de formas humanas ou animais em esculturas e pinturas. Em anatomia, designa a forma e a estrutura do corpo. O que mais, em matemática, "figura" está relacionado a formas geométricas. Sua versatilidade o torna um conceito fundamental em várias disciplinas.....
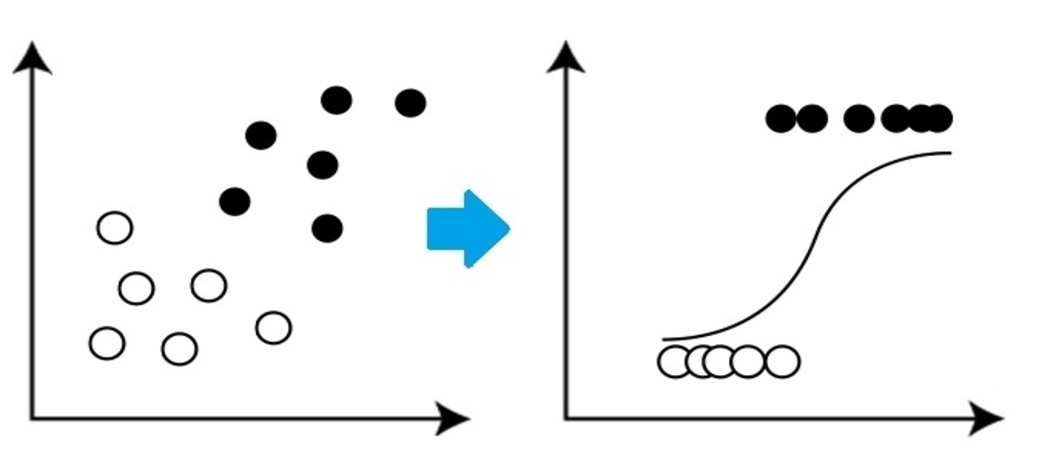
Fonte: https://www.equiskill.com
Prós:
- É um algoritmo muito simples e eficiente.
- Baixa variância.
- Fornece probabilidade pontuação das observações.
Contras:
- Má gestão um grande número de características categóricas.
- Assume que os dados estão livres de valores em falta e que os preditores são independentes entre si.
Exemplo:
from sklearn.datasets import load_iris
from sklearn.linear_model import LogisticRegression
X, y = load_iris()
LR_classifier = LogisticRegression(random_state = 0)
LR_classifier.fit(X, e)
LR_classifier.predict(X[:3, :])
Produção:
variedade([0, 0, 0])
Predisse 0 classe para todos 3 testes dados à função de previsão.
2. Bayes ingenuo
Naive Bayes baseia-se em Teorema de Bayes o que implica uma suposição de independência entre preditores. Este classificador assume que a presença de uma característica particular numa classe não está relacionada com a presença de qualquer outra
característica / variável.
Os classificadores Naive Bayes são de três tipos: Multinomial Naive Bayes, Bernoulli Naive Bayes, Gaussian Naive Bayes.
Prós:
- Este algoritmo funciona muito rapidamente.
- Além disso, pode ser usado para resolver problemas de previsão de várias classes, uma vez que é bastante útil com elas.
- Este classificador funciona melhor do que outros modelos com menos dados de TreinamentoO treinamento é um processo sistemático projetado para melhorar as habilidades, Conhecimento ou habilidades físicas. É aplicado em várias áreas, como esporte, Educação e desenvolvimento profissional. Um programa de treinamento eficaz inclui planejamento de metas, prática regular e avaliação do progresso. A adaptação às necessidades individuais e a motivação são fatores-chave para alcançar resultados bem-sucedidos e sustentáveis em qualquer disciplina.... se se mantiver a suposição de independência das características.
Contras:
- Assume
de que todas as funções são independentes. Embora pareça ótimo em teoria
teoria, mas na vida real, ninguém consegue encontrar um conjunto de características independentes.
Exemplo:
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.naive_bayes import GaussianNB
X, y = load_iris(return_X_y = True)
X_train, X_test, y_train, y_test = train_test_split(X, e, test_size=0.25, random_state=142)
Naive_Bayes = GaussianNB()
Naive_Bayes.fit(X_train, y_train)
prediction_results = Naive_Bayes.predict(X_test)
imprimir(prediction_results)
Produção:
variedade([0, 1, 1, 2, 1, 1, 0, 0, 2, 1, 1, 1, 2, 0, 1, 0, 2, 1, 1, 2, 2, 1,0, 1, 2, 1, 2, 2, 0, 1, 2,
     1, 2, 1, 2, 2, 1, 2])
Estas são as classes previstas para os dados X_test pelo nosso modelo de Naive Bayes.
3. Algoritmo do vizinho mais próximo K
Deves ter ouvido falar de um ditado popular:
“Deus cria-os e eles juntam-se.”
O KNN funciona segundo o mesmo princípio. Classifica os novos pontos de dados com base na classe da maioria dos pontos de dados entre os K vizinhos, onde K é o número de vizinhos a considerar. O KNN captura a ideia de similitude (às vezes chamada de distância,
proximidade ou vizinhança) com algumas fórmulas matemáticas básicas de distância como a distância euclidiana, distância de Manhattan, etc.
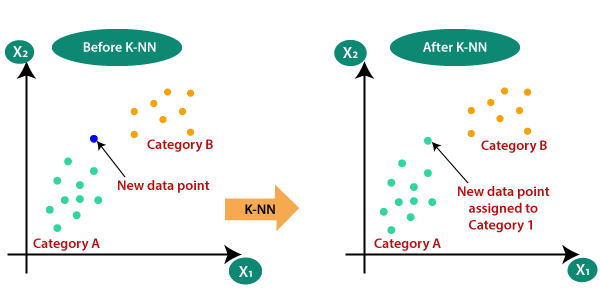
Fonte: https://www.javatpoint.com
Selecionar o valor correto para K
Para escolher o K adequado para os dados que deseja treinar, execute o algoritmo KNN várias vezes com diferentes valores de K e escolha aquele valor de K que reduz a quantidade de erros nos dados não vistos.
Prós:
- KNN é simples e fácil de implementar.
- Não é necessário criar um modelo, ajustar vários parametroso "parametros" são variáveis ou critérios usados para definir, medir ou avaliar um fenômeno ou sistema. Em vários domínios, como a estatística, Ciência da Computação e Pesquisa Científica, Os parâmetros são essenciais para estabelecer normas e padrões que orientam a análise e interpretação dos dados. Sua seleção e manuseio adequados são cruciais para obter resultados precisos e relevantes em qualquer estudo ou projeto.... ou fazer suposições adicionais como alguns dos outros algoritmos de classificação.
- Pode ser usado para classificação, regressão e pesquisa. Então, é flexível.
- O algoritmo torna-se significativamente mais lento à medida que aumenta o número de exemplos e / ou preditores / variáveis independentes.
from sklearn.neighbors import KNeighborsClassifier
X_train, X_test, y_train, y_test = train_test_split(X, e, test_size=0.25, random_state=142)
knn = KNeighborsClassifier(n_neighbors=3)
knn.fit(X_train, y_train)
prediction_results = knn.predict(X_test[:5,:)
imprimir(prediction_results)
Produção:
variedade([0, 1, 1, 2, 1])
Previmos os nossos resultados para 5 linhas de amostra. Portanto, temos 5 resultados em array.
4. SVM
SVM são as siglas de Support Vector Machine. Este es un algoritmo de aprendizado automático supervisionado que se utiliza con mucha frequência para desafíos de classificação y regresión. Apesar disto, usado principalmente em problemas de classificação. El concepto básico de Support Vector Machine y cómo funciona se puede comprender mejor con este sencillo ejemplo. Então, imagina que tienes dos etiquetas: verde y azul, y nuestros datos disposen dos características: X e e. Queremos un clasificador que, dado un par de (x, e) coordenadas, saídas si es verde o azul. Trace los datos de entrenamiento etiquetados en un plano y depois intente hallar un plano (el hiperplano de dimensiones aumenta) que segrega los puntos de datos de ambos colores con mucha claridade.
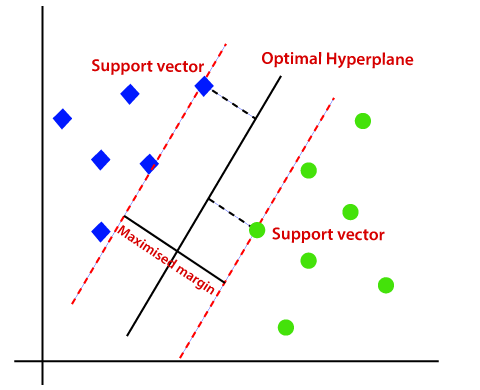
Fonte: https://www.javatpoint.com
Mas este é o caso de los datos lineales. Mas, ¿qué pasa si los datos no son lineales, então utiliza el truco del kernel? Então, para lidar com isto, aumentamos a dimensão"Dimensão" É um termo usado em várias disciplinas, como a física, Matemática e filosofia. Refere-se à extensão em que um objeto ou fenômeno pode ser analisado ou descrito. Em física, por exemplo, fala-se de dimensões espaciais e temporais, enquanto em matemática pode se referir ao número de coordenadas necessárias para representar um espaço. Compreendê-lo é fundamental para o estudo e..., isto gera dados no espaço e agora os dados tornam-se linearmente separáveis em dois grupos.
Prós:
- SVM funciona relativamente bem quando existe uma clara margemMargem é um termo usado em uma variedade de contextos, como contabilidade, Economia e impressão. Em contabilidade, refere-se à diferença entre receitas e custos, que permite avaliar a rentabilidade de um negócio. No domínio da publicação, A margem é o espaço em branco ao redor do texto em uma página, que facilita a leitura e proporciona uma apresentação estética. Seu correto manejo é essencial.. de separação entre classes.
- SVM é mais eficaz em espaços de alta dimensão.
Contras:
- SVM não é adequado para grandes conjuntos de dados.
- SVM não funciona muito bem quando o conjunto de dados tem mais ruído, Em outras palavras, quando as classes-alvo se sobrepõem. Então, precisa ser gerido.
Exemplo:
from sklearn import svm
svm_clf = svm.SVC()
X_train, X_test, y_train, y_test = train_test_split(X, e, test_size=0.25, random_state=142)
svm_clf.fit(X_train, y_train)
prediction_results = svm_clf.predict(X_test[:7,:])
imprimir(prediction_results)
Produção:
variedade([0, 1, 1, 2, 1, 1, 0])
5.Árvore de decisão
El árbol de decisiones es uno de los algoritmos de aprendizaje automático más utilizados. Se usan para problemas de clasificación y regresión. Los árboles de decisión imitan el pensamiento a nivel humano, por lo que es muy fácil compreender los datos y realizar buenas intuiciones e interpretaciones. Na realidade, te hacen ver la lógica de los datos para interpretarlos. Los árboles de decisión no son como algoritmos de caja negra como SVM, redes neurais, etc.
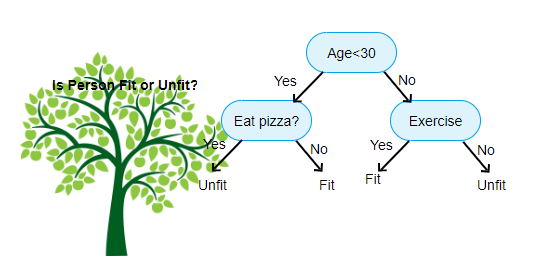
Fonte: https://www.aitimejournal.com
Como um exemplo, si classificamos a una persona como apta o no apta, A árvore de decisão se parece um pouco com isso na foto.
Então, em resumo, un árbol de decisão es un árbol donde cada nóO Nodo é uma plataforma digital que facilita a conexão entre profissionais e empresas em busca de talentos. Através de um sistema intuitivo, permite que os usuários criem perfis, Compartilhar experiências e acessar oportunidades de trabalho. Seu foco em colaboração e networking torna o Nodo uma ferramenta valiosa para quem deseja expandir sua rede profissional e encontrar projetos que se alinhem com suas habilidades e objetivos.... representa um
característica / atributo, cada rama representa una decisión, una regla y cada hoja representa un resultado. Este resultado puede ser de valor categórico o contínuo. Categórico en caso de clasificación y continuo en caso de aplicaciones de regresión.
Prós:
- En comparación con otros algoritmos, los árboles de decisão requieren menos esforço para a preparação de dados a lo largo del preprocesamiento.
- Tampoco requieren la padronizaçãoA padronização é um processo fundamental em várias disciplinas, que busca estabelecer padrões e critérios uniformes para melhorar a qualidade e a eficiência. Em contextos como engenharia, Educação e administração, A padronização facilita a comparação, Interoperabilidade e compreensão mútua. Ao implementar normas, a coesão é promovida e os recursos são otimizados, que contribui para o desenvolvimento sustentável e a melhoria contínua dos processos.... de datos ni el escalado.
- El modelo elaborado en el árbol de decisiones es muy intuitivo y fácil de explicar tanto a los equipos técnicos como a las partes interessadas.
Contras:
- Si se realiza inclusive un pequeño cambio en los datos, eso puede conducir a un gran cambio en la estructura del árbol de decisions que cause inestabilidad.
- As vezes, el cálculo pode ser muito mais complexo en comparação com outros algoritmos.
- Los árboles de decisão suelen tardar más en entrenar el modelo.
Exemplo:
from sklearn import tree
dtc = tree.DecisionTreeClassifier()
X_train, X_test, y_train, y_test = train_test_split(X, e, test_size=0.25, random_state=142)
dtc.fit(X_train, y_train)
prediction_results = dtc.predict(X_test[:7,:])
imprimir(prediction_results)
Produção:
variedade([0, 1, 1, 2, 1, 1, 0])
Notas finais
Estes são os 5 algoritmos de classificação mais populares, há muitos mais e além disso algoritmos avançados. Explore-os também. Vamos conectar LinkedIn
Obrigado por ler se você chegou aqui 🙂
A mídia mostrada nesta postagem não é propriedade da DataPeaker e é usada a critério do autor.





