
Visão geral
- Projetos de ciência de dados de código aberto agregam muito valor ao seu currículo e ajudam você a se destacar em uma entrevista
- Aqui tem 7 projetos de ciência de dados de código aberto nos quais você deve trabalhar este mês
Introdução
Vou lhe dar um conselho que gostaria que alguém tivesse me dado quando comecei minha carreira em ciência de dados.. Quando eu estava navegando na jornada cheia de obstáculos pelos remansos da ciência de dados, Tive uma grande luta antes de conseguir meu primeiro papel.. Tinha todas as qualificações (ou então eu pensei) mas algo parecia errado.
Essa lacuna entre o que eu trouxe para a mesa e o que o entrevistador esperava era experiência em projetos de ciência de dados..
Projetos de ciência de dados agregam muito valor ao seu currículo, especialmente se você é um iniciante. A maioria dos recém-chegados terá certificações, mas adicionar projetos de ciência de dados de código aberto lhe dará uma vantagem significativa sobre a concorrência. E acredite em mim, há um número impressionante de projetos de ciência de dados de código aberto para você.

Aqui, Eu fiz uma lista dos principais projetos de ciência de dados de código aberto que foram criados ou lançados em junho. Isso faz parte da minha série de projetos mensais, onde apresento os melhores projetos de ciência de dados de código aberto no GitHub.
Se você quiser ver os projetos anteriores, Eu os reuni na forma de curso grátis. Eles são estruturados por domínio (projetos de visão computacional, Projetos de PNL, etc.) para que você possa se concentrar no projeto que deseja. E se você é novo no GitHub, certifique-se de que está inscrito neste curso introdutório gratuito de Git e GitHub.
Projetos de ciência de dados de código aberto para aprimorar seu currículo

Eu dividi os projetos em três categorias de acordo com seu domínio:
- Aprendizado de máquina
- Visão computacional
- Outros projetos de ciência de dados de código aberto, incluindo um impressionante conjunto de dados
Vejamos cada categoria individualmente.
Projetos de aprendizado de máquina de código aberto
É aqui que você obterá o terreno do aprendizado de máquina.. Aqui, cobriremos três projetos de código aberto úteis relacionados ao aprendizado de máquina.. Você pode escolher um projeto com base em seus interesses ou experimentar todos eles. Tentei mantê-los o mais diversificados possível para que você possa ver um projeto sobre documentos de aprendizado de máquina e outro sobre a criação de pipelines de aprendizado de máquina.
Se você está procurando orientação ou é novo neste campo, Vou encaminhá-lo para alguns recursos de aprendizagem úteis:
Ler artigos de pesquisa sobre aprendizado de máquina é uma perspectiva bastante opressora para a maioria dos profissionais., muito menos para iniciantes. Cientistas de dados e pesquisadores de aprendizado de máquina tendem a escrever artigos extremamente técnicos que até mesmo especialistas têm dificuldade em decodificar.. Na realidade, este é um dos maiores pontos fracos em nosso campo.
Portanto, qualquer esforço para quebrar a complexidade é sempre bem-vindo. Este projeto útil é uma coleção de artigos sobre ciência de dados e aprendizado de máquina “com ilustrações, anotações e breves explicações de palavras-chave técnicas, termos e estudos anteriores que facilitam a leitura do artigo e da ideia principal”.
Este projeto era de código aberto no GitHub na semana passada, então é atualizado regularmente. Neste momento, já podemos ver alguns artigos lá para que você possa revisá-los e ter uma ideia de como as anotações foram feitas. Eu amo especialmente a anotação YOLOv1:

Muito genial! Vá em frente e explore este e outros documentos. Há muito o que aprender!
Este é um projeto bastante interessante para qualquer pessoa com um pouco de conhecimento em ciência de dados.

NeoML é uma estrutura abrangente de aprendizado de máquina que nos permite criar, treinar e implementar modelos de aprendizado de máquina. Em resumo, podemos criar um pipeline de aprendizado de máquina de ponta a ponta sem o incômodo de gastar muito dinheiro em soluções prontas para usar.
Cientistas e engenheiros de dados podem usá-lo para tarefas de visão computacional e processamento de linguagem natural (PNL), como pré-processamento de imagem, classificação, análise de design de documento, OCR e extração de dados de documentos estruturados e não estruturados.
Aqui está o principal recurso NeoML que tirei de seu repositório GitHub:
- Redes neurais compatíveis com mais de 100 tipos de camadas
- Aprendizado de máquina tradicional: mais de 20 algoritmos (classificação, regressão, agrupamento, etc.)
- Suporte para CPU e GPU, inferência rápida
- Suporte ONNX
- línguas: C ++, Java, Objective-C
- Multi plataforma: o mesmo código pode ser executado no Windows, Linux, Mac OS, iOS e Android
Aqui está um artigo para iniciantes sobre como criar pipelines de aprendizado de máquina:
Aqui está outro projeto que qualquer cientista de dados adoraria, especialmente se você estiver inclinado para a pesquisa. Freqüentemente, lutamos para passar de um ambiente de teste para uma implantação em grande escala; não é um passo fácil de dar (devemos realmente apreciar o papel que os engenheiros de dados desempenham).
Google, claro, tem uma solução potencial para nós na forma de Caliban. Esta é uma ferramenta para ajudá-lo a iniciar e rastrear seus experimentos numéricos em um ambiente de computação isolado e reproduzível.. Caliban foi desenvolvido por pesquisadores de aprendizado de máquina e engenheiros do Google.

Como eles dizem, Caliban "torna mais fácil ir de um protótipo simples rodando em uma estação de trabalho para milhares de trabalhos experimentais rodando na nuvem". Estes são os destaques a ter em conta:
- Desenvolva seu código experimental localmente e teste-o em um ambiente isolado (Docker)
- Desplácese fácilmente sobre los parametroso "parametros" são variáveis ou critérios usados para definir, medir ou avaliar um fenômeno ou sistema. Em vários domínios, como a estatística, Ciência da Computação e Pesquisa Científica, Os parâmetros são essenciais para estabelecer normas e padrões que orientam a análise e interpretação dos dados. Sua seleção e manuseio adequados são cruciais para obter resultados precisos e relevantes em qualquer estudo ou projeto.... experimentales
- Envie seus experimentos como trabalhos na nuvem, onde eles serão executados no mesmo ambiente de sandbox
- Controle e rastreie trabalhos
Projetos de visão de máquina de código aberto
Estou maravilhado com o progresso que estamos vendo na visão computacional (Sem trocadilhos!). Parece que todo mês, quando me sento para escrever este artigo, Encontro cada vez mais estruturas inovadoras e novas abordagens que melhoram o estado da arte neste campo.
As organizações estão vasculhando o mundo em busca de talentos em visão computacional agora, então é um bom momento para trabalhar nesses projetos e entrar em campo. Se você ainda não começou a ler sobre visão de máquina, aqui estão alguns recursos úteis:
E se eu lhe desse uma imagem de destino e pedisse para você escrever um programa de visão computacional que criasse a imagem do zero? sim, esse é o poder da visão computacional!
Este projeto de código aberto muito legal nos permite imitar um processo de desenho quando uma imagem de destino é fornecida para nós. Aqui está uma pequena demonstração de como é o processo:

Mal posso esperar para colocar minhas mãos nisso e começar a desenhar todos os tipos de coisas.. Você precisará das seguintes bibliotecas Python para executar este:
- OpenCV 3.4.1
- NumPy 1.16.2
- matplotlib 3.0.3
O desenvolvedor também nos deu um exemplo para que você possa executá-lo e ver a magia da visão computacional se desdobrar. Eu também sugiro que você verifique os seguintes artigos do OpenCV se você não trabalhou com eles antes:
Este projeto de código aberto é voltado para cientistas de dados um pouco mais avançados. Para entender do que se trata este projeto, devemos entender o conceito de super resolução de imagem única. Em termos simples, el objetivo aqui es construir una imagen de alta resoluçãoo "resolução" refere-se à capacidade de tomar decisões firmes e atingir metas estabelecidas. Em contextos pessoais e profissionais, Envolve a definição de metas claras e o desenvolvimento de um plano de ação para alcançá-las. A resolução é fundamental para o crescimento pessoal e o sucesso em várias áreas da vida, pois permite superar obstáculos e manter o foco no que realmente importa.... a partir de uma entrada correspondente de baja resolución.
Parece um projeto clássico de visão computacional!!
PULSE é uma nova solução para esta definição de problema. PULSO, abreviatura de Photo Upsampling via Latent Space Exploration, gera imagens ultra-realistas de alta resolução em resoluções incrivelmente altas. Y esto se logra de una manera totalmente auto-supervisionada y no se limita a un operador de degradación específico utilizado durante el TreinamentoO treinamento é um processo sistemático projetado para melhorar as habilidades, Conhecimento ou habilidades físicas. É aplicado em várias áreas, como esporte, Educação e desenvolvimento profissional. Um programa de treinamento eficaz inclui planejamento de metas, prática regular e avaliação do progresso. A adaptação às necessidades individuais e a motivação são fatores-chave para alcançar resultados bem-sucedidos e sustentáveis em qualquer disciplina.....
A seguir, um exemplo de como PULSE funciona é mostrado:
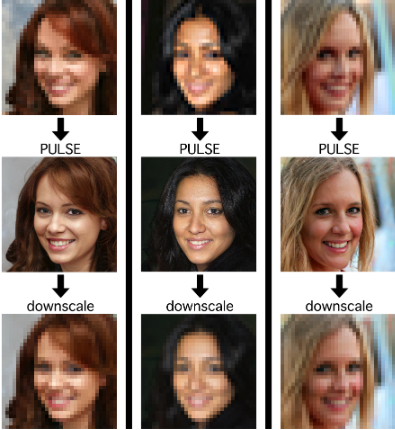
Eu encorajo você a ler primeiro o trabalho de investigação antes de olhar para o código. Isso lhe dará uma idéia melhor de como funciona o PULSE abaixo para que você possa abordar o código de forma muito mais clara.
Outros projetos de ciência de dados de código aberto
Aqui estão alguns projetos de ciência de dados de código aberto que não se enquadram nas duas categorias acima. Na realidade, estes são dois projetos contrastantes: um é voltado para iniciantes em ciência de dados, while que el otro se ocupa del mundo del Aprendizado por reforçoO aprendizado por reforço é uma técnica de inteligência artificial que permite que um agente aprenda a tomar decisões interagindo com um ambiente. Por meio de feedback na forma de recompensas ou punições, O agente otimiza seu comportamento para maximizar as recompensas acumuladas. Essa abordagem é usada em uma variedade de aplicações, De videogames a robótica e sistemas de recomendação, destacando-se por sua capacidade de aprender estratégias complexas.....
Escolha aquele que funciona melhor para você e comece a explorá-lo.
Tenho certeza de que a maioria de vocês já trabalhou com o conjunto de dados Iris. De fato, pode até ter sido o primeiro conjunto de dados que você usou para entender o conceito de classificação no aprendizado de máquina. Eu amo como é fácil entender e explorar o conjunto de dados.
Mas trabalhar com o mesmo conjunto de dados pode ser um pouco chato, especialmente quando você está aprendendo os prós e contras do aprendizado de máquina.
É aqui que entra o conjunto de dados PalmerPenguins.. Este conjunto de dados, código aberto no mês passado, está posicionado como uma alternativa ao Iris e visa fornecer um grande conjunto de dados para exploração e visualização de dados, especialmente para iniciantes. Aqui está um exemplo das visualizações que você pode criar:

O link que mencionei acima contém exemplos de como começar a explorar esses dados. Eles até forneceram detalhes sobre as diferentes variáveis, mas você não gostaria de explorar isso sozinho? 🙂
Você pode obter PalmerPenguins em sua máquina usando o seguinte código:
# install.packages("Remotos")
Remotos::install_github("allisonhorst / palmerpenguins")
Também recomendo verificar os artigos populares abaixo sobre exploração e visualização de dados:
Ah, aqui está um projeto de código aberto para todos vocês, reforço de aprendizagem de amigos. SlimeVolleyGym é um ambiente de academia simples para testar algoritmos de aprendizado de reforço de agente único e múltiplo. Isso foi criado e de código aberto por hardmaru, uma lenda no espaço de aprendizado de máquina.
É assim que o jogo funciona segundo ele (ele mesmo criou o jogo em JavaScript):
O jogo é muito simples: o objetivo do agente é fazer a bola cair no chão do lado do adversário, fazendo com que seu oponente perca uma vida. Cada agente começa com cinco vidas. O episódio termina quando um dos agentes perde todas as cinco vidas., ou depois de terem passado 3000 Passos. Um agente recebe uma recompensa de +1 quando seu oponente perde ou -1 quando você perde uma vida.

Você pode instalar limovólei direto do pip:
pip install slimevolleygym
Aqui estão alguns tutoriais excelentes de nosso especialista em aprendizado por reforço residente, Ankit Choudhary:
Notas finais
Uf, existem muitos projetos. Meu objetivo, como sempre, era manter os projetos o mais diversificados possível para que você possa escolher aqueles que se encaixam em sua jornada de ciência de dados. Se você é iniciante, Eu sugiro que você comece com o conjunto de dados PalmerPenguins, já que a maioria das pessoas nem sabe agora. Uma ótima oportunidade para começar com uma vantagem.
Eu adoraria ouvir sua opinião sobre qual projeto de código aberto foi mais útil para você.. Ou deixe-me saber se você gostaria que eu mostrasse outros projetos de ciência de dados aqui ou na edição do próximo mês..





