
Este artigo foi publicado como parte do Data Science Blogathon
Introdução:
Como todos sabemos, A inteligência artificial está sendo amplamente usada ao nosso redor: desde a leitura de notícias em seu dispositivo móvel ou análise de dados complexos em seu local de trabalho, IA melhorou a velocidade, precisão e eficácia do esforço humano. Os avanços na IA nos ajudaram a alcançar coisas que antes pensávamos que não eram possíveis. Até comer uma pizza do seu restaurante favorito em casa está a apenas um clique de distância, graças a AI.
Em poucas palavras, inteligência artificial significa um computador ou programa de computador que imita a inteligência humana. É conseguido aprendendo como você pensa, aprender, decide e trabalha o cérebro humano enquanto resolve um problema. Os resultados deste estudo são então usados como base para o desenvolvimento de sistemas inteligentes e software..
Existem 4 tipos de aprendizagem:
● Aprendizagem supervisionadaO aprendizado supervisionado é uma abordagem de aprendizado de máquina em que um modelo é treinado usando um conjunto de dados rotulados. Cada entrada no conjunto de dados está associada a uma saída conhecida, permitindo que o modelo aprenda a prever resultados para novas entradas. Este método é amplamente utilizado em aplicações como classificação de imagens, Reconhecimento de fala e previsão de tendências, destacando sua importância em....
● Aprendizagem não supervisionada.
● Aprendizagem semissupervisionada.
● Aprendizagem reforçada.
| Supervisionado | Sem supervisão | Semi-supervisionado | Reforçado |
| Aprendizagem supervisionada é quando o modelo é treinado em um conjunto de dados rotulado. | o Aprendizado não supervisionadoO aprendizado não supervisionado é uma técnica de aprendizado de máquina que permite que os modelos identifiquem padrões e estruturas em dados sem rótulos predefinidos. Por meio de algoritmos como k-means e análise de componentes principais, Essa abordagem é usada em uma variedade de aplicações, como segmentação de clientes, detecção de anomalias e compactação de dados. Sua capacidade de revelar informações ocultas o torna uma ferramenta valiosa no... é quando o modelo é treinado num conjunto de dados não rotulado, cabe ao algoritmo encontrar padrões subjacentes nos dados. | Situa-se entre a aprendizagem supervisionada e não supervisionada, nisto, alguns dados de aprendizagem são rotulados e outros não. | O algoritmo avalia seu desempenho com base nas respostas de feedback e reage de acordo. |
Este blog cobre o aprendizado de IA supervisionado e não supervisionado, usando conjunto de dados Python e Iris.
Tabela de conteúdo:
- Introdução
- Conjunto de dados Iris
- Aprendizagem supervisionada
- Árvore de decisão
- Regressão logística
- Aprendizagem não supervisionada
- Agrupamento de meias K
- Conclusão e referências
Conjunto de dados Iris:
O conjunto de dados contém 3 aulas com 50 cada instância e 150 instâncias totais, onde cada classe se refere a um tipo de planta de íris.
Classe: Silky Iris, Iris Versicolor, Iris Virginica
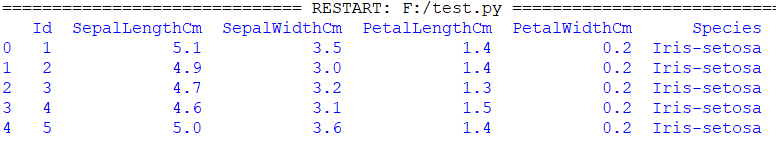
O formato de dados: (comprimento sépala, largura sépala, comprimento da pétala, largura da pétala)
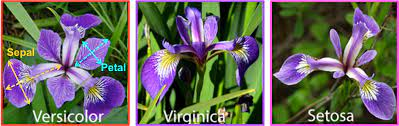
Treinaremos os nossos modelos com base nesses parametroso "parametros" são variáveis ou critérios usados para definir, medir ou avaliar um fenômeno ou sistema. Em vários domínios, como a estatística, Ciência da Computação e Pesquisa Científica, Os parâmetros são essenciais para estabelecer normas e padrões que orientam a análise e interpretação dos dados. Sua seleção e manuseio adequados são cruciais para obter resultados precisos e relevantes em qualquer estudo ou projeto.... e usá-los-emos para prever as classes de flores.
Compreender os dados:
Baixe o conjunto de dados Iris de https://www.kaggle.com/uciml/iris
importar numpy como np
importar pandas como pd
import matplotlib.pyplot as plt
iris = pd.read_csv("Iris.csv") #Iris.csv é agora um dataframe do pandas
imprimir(iris.head()) #imprime primeiro 5 valores
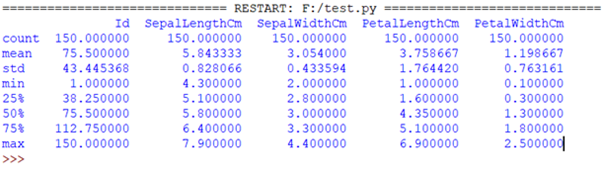
imprimir(iris.describe()) #imprime alguns detalhes estatísticos básicos como percentil,quer dizer, std etc. do quadro de dados |
Visualizando os dados usando matplotlib:
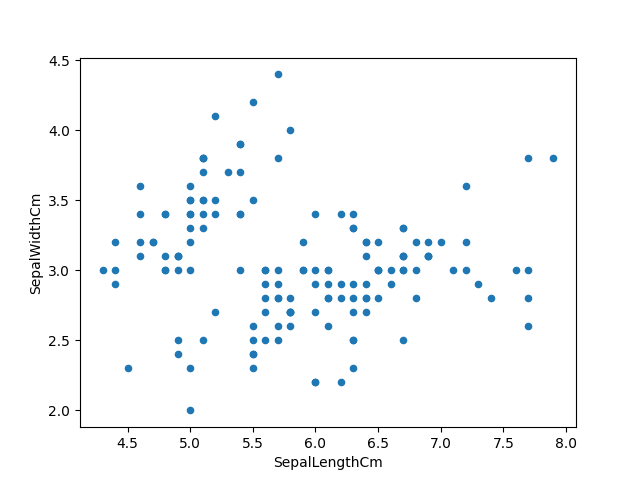
iris.plot(kind ="espalhar", x ="SepalLengthCm", y ="SepalWidthCm") plt.show() |
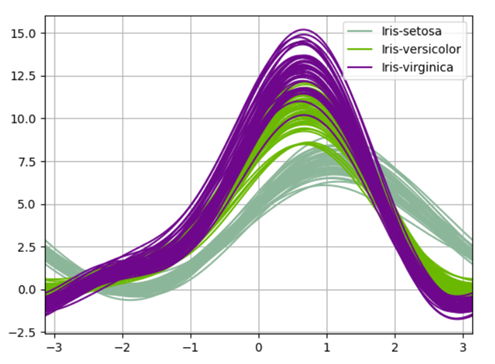
Visualização de dados usando curvas de Andrew de pandas:
As curvas de Andrews têm a forma funcional:
f
x_4 sem (2t) + x_5 cos (2t) +…
Onde os coeficientes x correspondem aos valores de cada dimensão"Dimensão" É um termo usado em várias disciplinas, como a física, Matemática e filosofia. Refere-se à extensão em que um objeto ou fenômeno pode ser analisado ou descrito. Em física, por exemplo, fala-se de dimensões espaciais e temporais, enquanto em matemática pode se referir ao número de coordenadas necessárias para representar um espaço. Compreendê-lo é fundamental para o estudo e... e t está espaçado linearmente entre -pi e + pi. Cada linha do quadro corresponde a uma única curva.
de pandas.plotting import andrews_curves
andrews_curves(iris.drop("Identificação", eixo = 1), "Espécies")
plt.show()
|
Pré-processamento do conjunto de dados:
Usando uma biblioteca integrada chamada 'train_test_split', que divide nosso conjunto de dados em uma proporção de 80:20. o 80% será utilizado para TreinamentoO treinamento é um processo sistemático projetado para melhorar as habilidades, Conhecimento ou habilidades físicas. É aplicado em várias áreas, como esporte, Educação e desenvolvimento profissional. Um programa de treinamento eficaz inclui planejamento de metas, prática regular e avaliação do progresso. A adaptação às necessidades individuais e a motivação são fatores-chave para alcançar resultados bem-sucedidos e sustentáveis em qualquer disciplina...., avaliação e seleção entre nossos modelos e os 20% será retido como um conjunto de dados de validação.
de sklearn.model_selection import train_test_split x = iris.iloc[:, :-1].valores #últimos valores de coluna excluídos y = iris.iloc[:, -1].valores #último valor da coluna de sklearn.model_selection import train_test_split x_train,x_test,y_train,y_test = train_test_split(x,e,test_size = 0.2, random_state = 0) #Dividir o conjunto de dados em conjunto de treinamento e conjunto de teste |
Aprendizagem supervisionada :
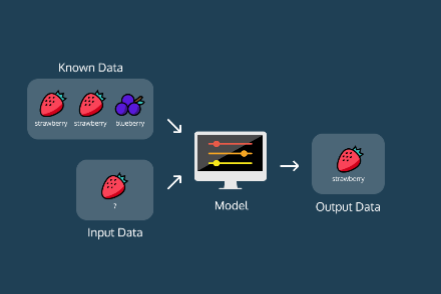
Algoritmos de aprendizado de máquina supervisionados são treinados para encontrar padrões usando um conjunto de dados. O processo é simples, pega o que foi aprendido no passado e, em seguida, aplica a novos dados. A aprendizagem supervisionada usa exemplos marcados para prever padrões e eventos futuros.
Por exemplo, quando ensinamos a uma criança que 2 + 2 = 4 ou apontamos a imagem de qualquer animal para que você saiba o seu nome.
A aprendizagem supervisionada, por sua vez, é dividida em:
● Classificação: A classificação prevê rótulos de classe categóricos, que são discretos e bagunçados. É um processo de duas etapas, consistindo em uma etapa de aprendizagem e uma etapa de classificação. Existem vários algoritmos de classificação como: “Classificador de árvore de decisão”, “Floresta aleatória”, “Classificador Naive Bayes”, etc.
● Regressão: A regressão é geralmente descrita como a determinação de uma relação entre duas ou mais variáveis, como prever o trabalho de uma pessoa com base nos dados de entrada X. Alguns dos algoritmos de regressão são: “Regressão logística”, “Regressão de loop”, “Regressão de cume”, etc. .
Classificador de árvore de decisão:
O motivo geral para usar uma árvore de decisão é criar um modelo de treinamento que pode ser usado para prever a classe ou o valor das variáveis de destino, aprendendo regras de decisão inferidas de dados anteriores. (dados de treinamento).
Tente resolver o problema usando a representação em árvore. Cada nóO Nodo é uma plataforma digital que facilita a conexão entre profissionais e empresas em busca de talentos. Através de um sistema intuitivo, permite que os usuários criem perfis, Compartilhar experiências e acessar oportunidades de trabalho. Seu foco em colaboração e networking torna o Nodo uma ferramenta valiosa para quem deseja expandir sua rede profissional e encontrar projetos que se alinhem com suas habilidades e objetivos.... interno da árvore corresponde a um atributo e cada nó folha corresponde a uma etiqueta de classe.
Usando a árvore de decisão no conjunto de dados Iris:
de sklearn.tree import DecisionTreeClassifier
de sklearn.metrics import precision_score
classifier = DecisionTreeClassifier() classifier.fit(x_train, y_train) #treinando o classificador y_pred = classifier.predict(x_test) #fazendo previsões imprimir(classificação_report(y_test, y_pred)) #Resumo das previsões feitas pelo classificador imprimir(confusão_matriz(y_test, y_pred)) #para avaliar a qualidade do resultado imprimir('acurácia é',precisão_pontuação(y_pred,y_test)) #Pontuação de precisão
|
Precisão: precisão das previsões positivas.
Recuperação: fração de positivos que foram identificados corretamente.
Pontuação F1: Qual porcentagem de previsões positivas estavam corretas?
macro avg – média não ponderada por rótulo
média ponderada: calculando a média da média ponderada de suporte por etiqueta
Mapa de caloruma "mapa de calor" é uma representação gráfica que usa cores para mostrar a densidade de dados em uma área específica. Comumente usado em análise de dados, Estudos de marketing e comportamentais, Esse tipo de visualização permite identificar padrões e tendências rapidamente. Através de variações cromáticas, Os mapas de calor facilitam a interpretação de grandes volumes de informações, ajudando a tomar decisões informadas.... para a matriz de confusão:
importado do mar como sns cm = confusão_matriz(y_test, y_pred) #Transformar para df cm_df = pd.DataFrame(cm,índice = ['setosa','versicolor','virginica'], colunas = ['setosa','versicolor','virginica']) plt.figure(figsize =(5.5,4)) sns.heatmap(cm_df, annot = True) plt.ylabel('Etiqueta verdadeira')
plt.xlabel('Etiqueta prevista')
plt.show() |
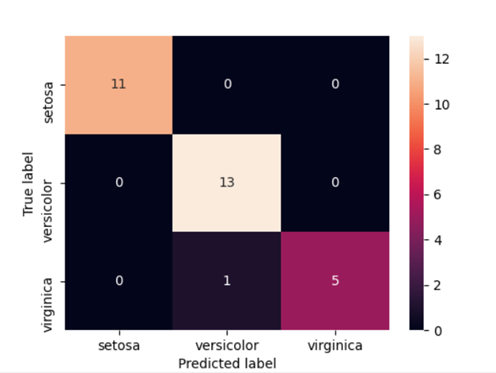
Uma ideia que podemos tirar da matriz é que o modelo foi muito preciso ao classificar Setosa e Virginica (Verdadeiro positivo / All = 1.0). Porém, A precisão do Versicolor foi menor (13/14 = 0,928).
Aprendizagem não supervisionada:
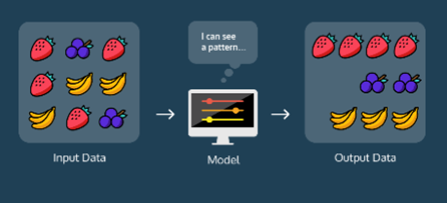
A aprendizagem não supervisionada é usada contra dados sem rótulos históricos. O sistema não está sujeito a um conjunto predeterminado de resultados, correlações entre entradas e saídas ou um “resposta correta”. O algoritmo deve descobrir o que está vendo por si mesmo, uma vez que não tem nenhum armazenamento de waypoint. O objetivo é explorar os dados e encontrar algum tipo de padrões ou estruturas.
A aprendizagem não supervisionada pode ser classificada em:
● Agrupamento: Clustering é a tarefa de dividir a população ou pontos de dados em vários grupos, de modo que os pontos de dados de um grupo sejam homogêneos uns com os outros do que aqueles de grupos diferentes. Existem vários algoritmos de agrupamento, alguns deles são: “Algoritmos de agrupamento K-means”, “mudança média”, “agrupamento hierárquico”, etc.
● Associação: Uma regra de associação é um método de aprendizagem não supervisionada que é utilizado para encontrar relações entre variáveis num grande base de dadosUm banco de dados é um conjunto organizado de informações que permite armazenar, Gerencie e recupere dados com eficiência. Usado em várias aplicações, De sistemas corporativos a plataformas online, Os bancos de dados podem ser relacionais ou não relacionais. O design adequado é fundamental para otimizar o desempenho e garantir a integridade das informações, facilitando assim a tomada de decisão informada em diferentes contextos..... Determine o conjunto de elementos que ocorrem juntos no conjunto de dados.
Agrupamento de meias K:
O objetivo do algoritmo de agrupamento K-means é encontrar clusters nos dados, com o número de grupos representado pelo variávelEm estatística e matemática, uma "variável" é um símbolo que representa um valor que pode mudar ou variar. Existem diferentes tipos de variáveis, e qualitativo, que descrevem características não numéricas, e quantitativo, representando quantidades numéricas. Variáveis são fundamentais em experimentos e estudos, uma vez que permitem a análise de relações e padrões entre diferentes elementos, facilitando a compreensão de fenômenos complexos.... K. O algoritmo funciona iterativamente para atribuir cada ponto de dados a um dos K grupos com base nas características fornecidas.. .
Os resultados da execução de um K-means em um conjunto de dados são:
● Centroides K: centróides para cada um dos grupos K identificados no conjunto de dados.
● Rótulos para dados de treinamento: conjunto de dados completo rotulado para garantir que cada ponto de dados seja mapeado para um dos clusters.
Usando clustering K-means no conjunto de dados Iris:
de sklearn.datasets import load_iris
de sklearn.cluster import KMeans
iris_data = load_iris() #carregando conjunto de dados da íris de sklearn.datasets iris_df = pd.DataFrame(iris_data.data, colunas = iris_data.feature_names) #criando dataframe kmeans = KMeans(n_clusters = 3, init ="k-means ++", max_iter = 100, n_init = 10, random_state = 0) #Aplicando classificador Kmeans y_kmeans = kmeans.fit_predict(x) imprimir(kmeans.cluster_centers_) #exibir centros de cluster plt.scatter(x[y_kmeans == 0, 0], x[y_kmeans == 0, 1],s = 100, c ="vermelho", rótulo ="Iris-sedoso") plt.scatter(x[y_kmeans == 1, 0], x[y_kmeans == 1, 1],s = 100, c ="azul", rótulo ="Iris versicolor") plt.scatter(x[y_kmeans == 2, 0], x[y_kmeans == 2, 1],s = 100, c ="verde", rótulo ="Iris-virginica") #Visualizando os clusters - Nas primeiras duas colunas plt.scatter(kmeans.cluster_centers_[:, 0], kmeans.cluster_centers_[:,1],s = 100, c ="Preto", rótulo ="Centroids") #traçando os centróides dos clusters plt.legend() plt.show() |
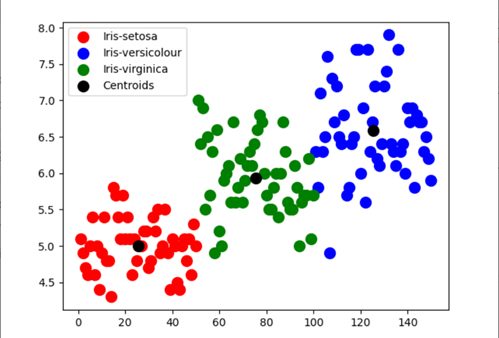
Uma ideia que podemos obter do Diagrama de dispersãoO gráfico de dispersão é uma ferramenta gráfica usada em estatística para visualizar a relação entre duas variáveis. Consiste em um conjunto de pontos em um plano cartesiano, onde cada ponto representa um par de valores correspondentes às variáveis analisadas. Este tipo de gráfico permite identificar padrões, Tendências e possíveis correlações, facilitando a interpretação dos dados e a tomada de decisão com base nas informações visuais apresentadas.... es que la precisión del modelo para determinar Setosa y Virginica es comparativamente más a Versicolour.
conclusão:
Exploramos e pré-processamos o conjunto de dados Iris usando sklearn. conjunto de dados, bem como usar o arquivo Iris.csv. O que mais, aprendí sobre el aprendizaje supervisado y no supervisado e implementé el algoritmo de árbol de decisión y el algoritmo de agrupamentoo "agrupamento" É um conceito que se refere à organização de elementos ou indivíduos em grupos com características ou objetivos comuns. Este processo é usado em várias disciplinas, incluindo psicologia, Educação e biologia, para facilitar a análise e compreensão de comportamentos ou fenômenos. No campo educacional, por exemplo, O agrupamento pode melhorar a interação e o aprendizado entre os alunos, incentivando o trabalho.. de K-means.
Referências:
https://www.kaggle.com/sixteenpython/machine-learning-with-iris-dataset
https://scikit-learn.org/stable/
https://certes.co.uk/types-of-artificial-intelligence-a-detailed-guide/
Sobre o autor:
Ola leitor, eu sou yashi saxena, e atualmente trabalho na TCS como engenheiro de sistemas. AO, ML e PNL sempre foram meu interesse, então aqui estou eu fazendo um esforço para aprender mais sobre este campo. Você pode se conectar comigo no Linkedin: https://www.linkedin.com/in/yashi-saxena-7a9522194/
A mídia mostrada neste artigo não é propriedade da DataPeaker e é usada a critério do autor.





