
Introdução
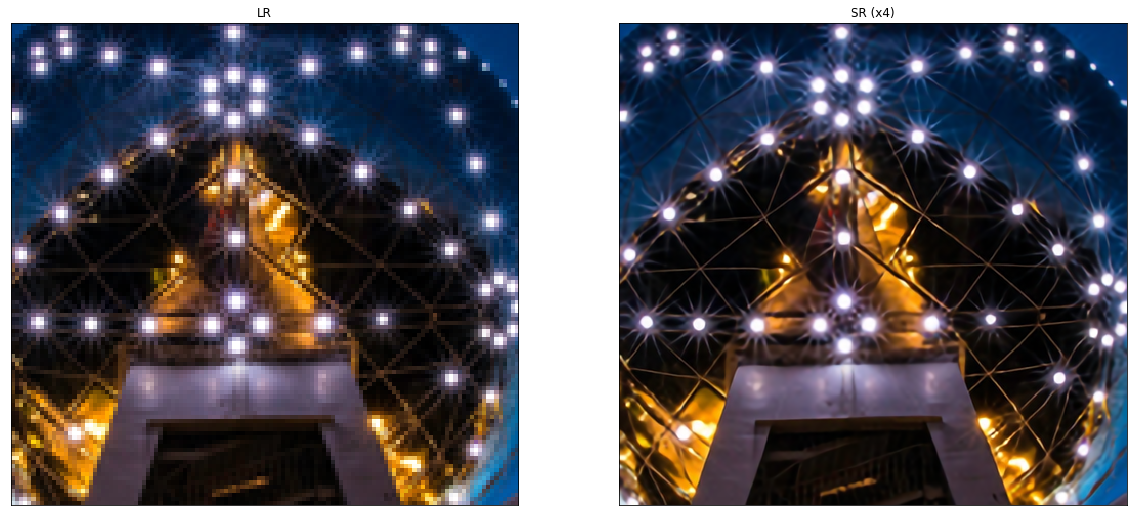
(SR) é o processo de recuperação alta resoluçãoo "resolução" refere-se à capacidade de tomar decisões firmes e atingir metas estabelecidas. Em contextos pessoais e profissionais, Envolve a definição de metas claras e o desenvolvimento de um plano de ação para alcançá-las. A resolução é fundamental para o crescimento pessoal e o sucesso em várias áreas da vida, pois permite superar obstáculos e manter o foco no que realmente importa.... (HORA) Imagens de baixa resolução (LR) imagens. É uma classe importante de técnicas de processamento de imagem em visão computacional e processamento de imagem e possui uma ampla gama de aplicações do mundo real., como imagens médicas, imagens de satélite, vigilância e segurança, imagens astronômicas, entre outras.
Com o avanço nas técnicas de aprendizado profundoAqui está o caminho de aprendizado para dominar o aprendizado profundo em, Uma subdisciplina da inteligência artificial, depende de redes neurais artificiais para analisar e processar grandes volumes de dados. Essa técnica permite que as máquinas aprendam padrões e executem tarefas complexas, como reconhecimento de fala e visão computacional. Sua capacidade de melhorar continuamente à medida que mais dados são fornecidos a ele o torna uma ferramenta fundamental em vários setores, da saúde... nos últimos anos, Modelos de RH baseados em aprendizagem profunda foram explorados ativamente e, frequentemente, alcançar desempenho de ponta em vários benchmarks SR. Uma variedade de métodos de aprendizado profundo foram aplicados para resolver as tarefas de RH, variando do método baseado em redes neurais convolucionais (CNN) às abordagens recentes e promissoras de RH com base em redes geradoras adversas.
Problema
O problema da exclusão da imagem (SR), em particular a super-resolução de uma única imagem (SISR), ganhou muita atenção na comunidade de pesquisa. SISR visa reconstruir uma imagem de alta resolução ISR imagem única de baixa resolução ILR. Geralmente, a relação entre mimLR e a imagem original de alta resolução IHORA pode variar dependendo da situação. Muitos estudos assumem que euLR é uma versão bicúbica reduzida de IHORA, mas outros fatores degradantes, como desfoque, destruição ou ruído também podem ser considerados para aplicações práticas.
Neste artigo, vamos nos concentrar em aprendizagem supervisionadaO aprendizado supervisionado é uma abordagem de aprendizado de máquina em que um modelo é treinado usando um conjunto de dados rotulados. Cada entrada no conjunto de dados está associada a uma saída conhecida, permitindo que o modelo aprenda a prever resultados para novas entradas. Este método é amplamente utilizado em aplicações como classificação de imagens, Reconhecimento de fala e previsão de tendências, destacando sua importância em... métodos para tarefas de super-resolução. Ao usar imagens HR como alvo e LR como entrada, podemos tratar este problema como um problema de aprendizado supervisionado.
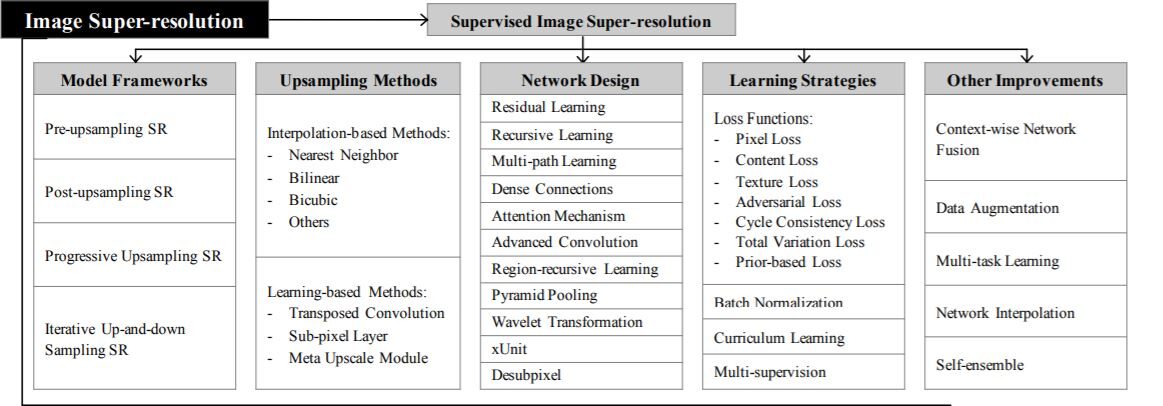
Métodos de amostragem superiores
Antes de entender o resto da teoria por trás da super resolução, devemos entender amostragem (Aumente a resolução espacial das imagens ou simplesmente aumente o número de linhas / colunas de pixels ou ambos na imagem) e seus vários métodos.
1. Métodos baseados em interpolação – Interpolação de imagem (escala de imagem) refere-se ao redimensionamento de imagens digitais e é amplamente utilizado por aplicativos relacionados a imagens. Os métodos tradicionais incluem interpolação do vizinho mais próximo, interpolação linear, binaural, bicúbica, etc.
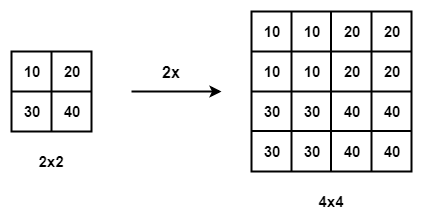
Interpolação do vizinho mais próximo com a escala de 2
- Interpolação do vizinho mais próximo – A interpolação do vizinho mais próximo é um algoritmo simples e intuitivo. Seleciona o valor de pixel mais próximo para cada posição para interpolar independentemente de qualquer outro pixel.
- Interpolação bilinear – Interpolação bilinear (TORNAR-SE) primeiro executa a interpolação linear em um eixo da imagem e, em seguida, no outro eixo. Uma vez que resulta em uma interpolação quadrática com um campo receptivo de 2 × 2, mostra um desempenho muito melhor do que a interpolação do vizinho mais próximo, mantendo uma velocidade relativamente rápida.
- Interpolação bicúbica – de forma similar, interpolação bicúbica (BCI) realiza interpolação cúbica em cada um dos dois eixos. Comparado com BLI, o BCI leva em consideração 4 × 4 pixels e resulta em resultados mais suaves com menos artefatos, mas velocidade muito menor. Referir a isto para uma discussão detalhada.
Deficiências – Métodos baseados em interpolação muitas vezes introduzem alguns efeitos colaterais, como complexidade computacional, amplificação de ruído, resultados difusos, etc.
2. Amostragem ascendente baseada na aprendizagem – Para superar as deficiências dos métodos baseados em interpolação e aprender a sobreamostragem ponta a ponta, a camada de convolução transposta e a camada de subpixel são inseridas no campo SR.
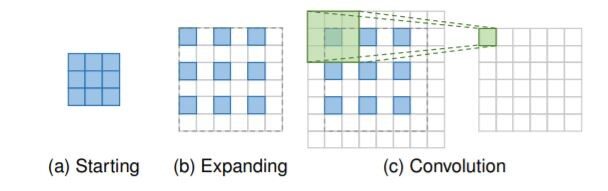
Camada de convolução transposta: quadrados azuis indicam entrada,
e as caixas verdes indicam o kernel e a saída de convolução.
- Convolução transposta: camada, também conhecido como camada de deconvolução, tente realizar uma transformação oposta a uma convolução normal, quer dizer, prever a entrada possível com base em mapas de recursos do tamanho da saída de convolução. Especificamente, aumenta a resolução da imagem expandindo a imagem inserindo zeros e realizando uma convolução.
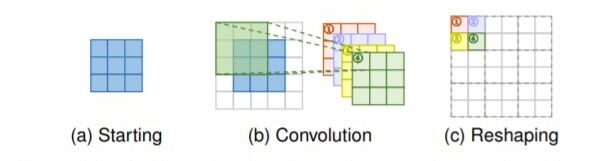
Camada de subpixel: caixas azuis indicam entrada e caixas com outras cores indicam diferentes operações de convolução e diferentes mapas de recursos de saída.
- Camada de subpixel: A camada de subpixel, outra camada de upsampling que pode ser aprendida de ponta a ponta, realiza upsampling gerando uma pluralidade de canais por convolução e, em seguida, remodelando os programas. Dentro desta camada, Uma convolução é primeiro aplicada para produzir saídas com
s2 canais de tempo, onde s é o fator de escala. Supondo que o tamanho da entrada seja h × w × c, o tamanho da saída será h × w × s2C. Depois disso, a operação de remodelagem é realizada para produzir saídas com tamanho sh × sw × c
Quadros de sobre-resolução
Uma vez que a super-resolução da imagem é um problema mal colocado, como sobreamostrar (quer dizer, gerar uma saída de frequência cardíaca a partir da entrada LR) é o problema chave. Existem principalmente quatro quadros de modelo com base nas principais operações de amostragem empregadas e suas localizações no modelo (veja a tabela acima).
1. Super resolução de pré-amostragem –
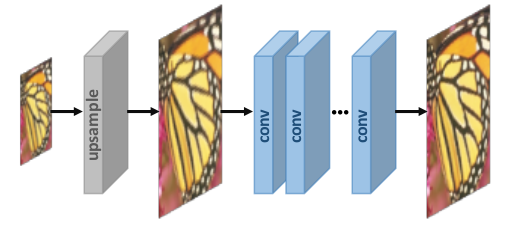
Não fazemos mapeamento direto de imagens LR para imagens HR, pois é considerada uma tarefa difícil. Usar algoritmos de upsampling tradicionais para obter imagens de resolução mais alta e, em seguida, refiná-las usando redes neurais profundas é uma solução simples. Por exemplo, As imagens LR são amostradas para imagens HR espessas com o tamanho desejado por interpolação bicúbica. Mais tarde, CNNs profundos são aplicados a essas imagens para reconstruir imagens de alta qualidade.
2. Super resolução pós-amostra:
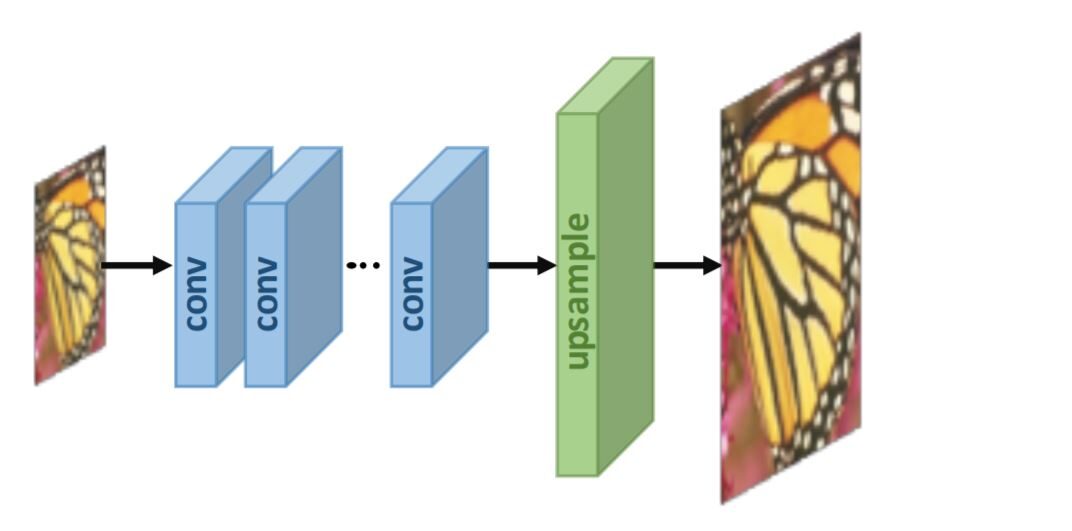
Para melhorar a eficiência computacional e fazer uso total da tecnologia de aprendizado profundo para aumentar automaticamente a resolução, os investigadores propõem realizar a maioria dos cálculos num espaço de baixa dimensão"Dimensão" É um termo usado em várias disciplinas, como a física, Matemática e filosofia. Refere-se à extensão em que um objeto ou fenômeno pode ser analisado ou descrito. Em física, por exemplo, fala-se de dimensões espaciais e temporais, enquanto em matemática pode se referir ao número de coordenadas necessárias para representar um espaço. Compreendê-lo é fundamental para o estudo e... substituindo a amostragem pré-definida por camadas de aprendizagem de extremo a extremo integradas no final dos modelos. No trabalho pioneiro desta estrutura, a saber, SR pós-amostragem, As imagens de entrada LR alimentam profundamente a CNN sem aumentar a resolução, e as camadas de amostragem superiores que podem ser aprendidas de ponta a ponta são aplicadas no final da rede.
Estratégias de aprendizado
No campo da super resolução, funções de perda são usadas para
medir o erro de reconstrução e orientar a otimização do modelo. Nos primeiros dias, pesquisadores costumam usar Perda L2 por pixel (erro quadrático médio), mas então ele descobre que não pode medir o
qualidade de reconstrução com muita precisão. Portanto, uma variedade
funções de perda (p. não., perda de conteúdo, os adversárioss) são adotados para melhor medir a reconstrução
erro e produzir resultados de maior qualidade e mais realistas.
- Perda de Pixelwise L1 – Diferença absoluta entre os pixels da imagem HR de verdade e da gerada.
- Perda de Pixelwise L2 – Diferença quadrada média entre os pixels da imagem HR de verdade e a gerada.
- Perda de conteúdo – a perda de conteúdo é relatada como a distância euclidiana entre as renderizações de alto nível da imagem de saída e a imagem de destino. Funções de alto nível são obtidas passando por CNNs previamente treinados, como VGG e ResNet.
- Perda adversária – Baseado em GAN, onde tratamos o modelo SR como um gerador e definimos um discriminador adicional para julgar se a imagem de entrada é gerada ou não.
- PSNR – A relação sinal-ruído de pico (PSNR) é uma métrica objetiva comumente usada para medir a qualidade da reconstrução de uma transformação com perdas. PSNR é inversamente proporcional ao logaritmo do erro quadrático médio (MSE) entre a imagem real do terreno e a imagem gerada.
Em MSE, Eu sou um sem barulho metro×Norte imagem monocromática (verdade fundamental) e K é a imagem gerada (abordagem barulhenta). A PSNR, MAXeu representa o máximo valor de pixel possível da imagem.
Layout de rede
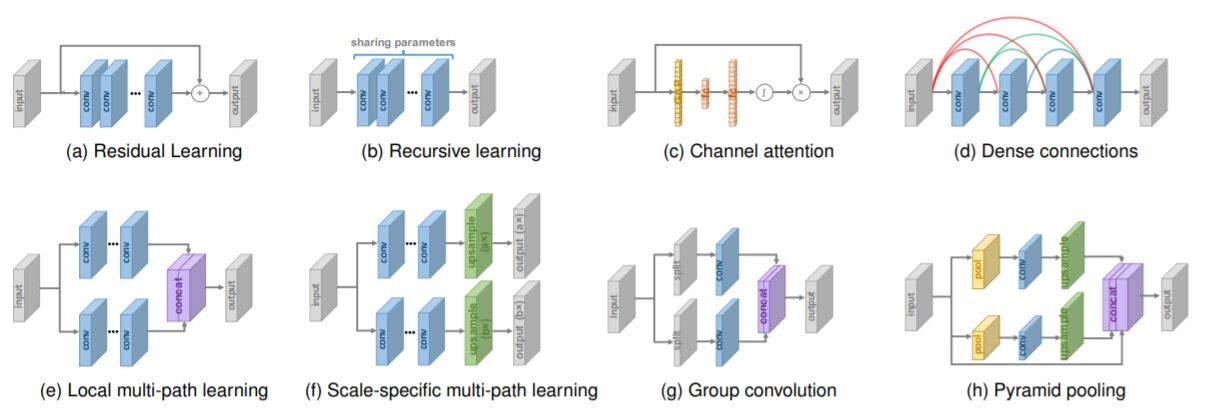
Vários projetos de rede em arquitetura de super-resolução
Chega do básico! Vamos analisar alguns dos Estado da arte métodos de superresolução –
Métodos de superresolução
Rede de adversários geradores de super-resolução (SRGAN) – Use a ideia de GAN para tarefa de super resolução, quer dizer, o gerador tentará produzir uma imagem do ruído que será julgado pelo discriminador. Ambos continuarão a treinar para que o gerador possa gerar imagens que possam coincidir com os dados de TreinamentoO treinamento é um processo sistemático projetado para melhorar as habilidades, Conhecimento ou habilidades físicas. É aplicado em várias áreas, como esporte, Educação e desenvolvimento profissional. Um programa de treinamento eficaz inclui planejamento de metas, prática regular e avaliação do progresso. A adaptação às necessidades individuais e a motivação são fatores-chave para alcançar resultados bem-sucedidos e sustentáveis em qualquer disciplina.... reais.
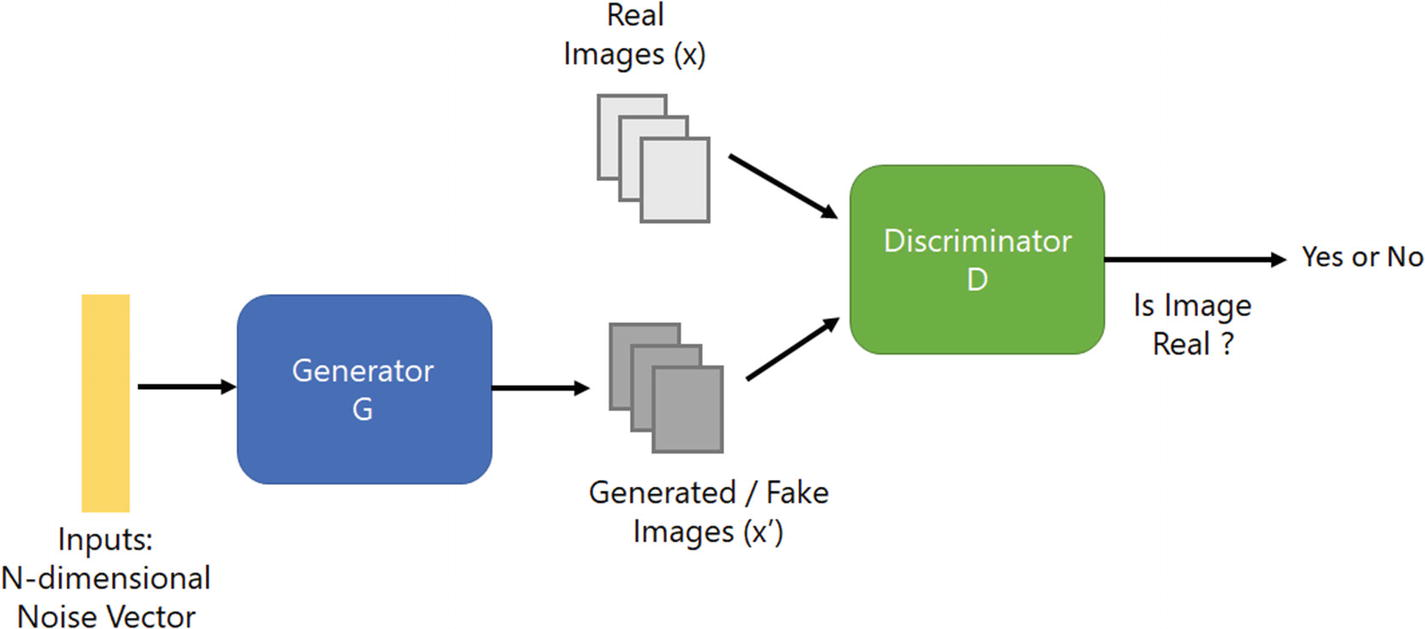
Arquitetura da Rede Adversária Geradora
Existem várias formas de super resolução, mas há um problema: Como podemos recuperar detalhes de textura mais finos de uma imagem de baixa resolução para que a imagem não seja distorcida?
Os resultados têm um alto PSNR; a mídia tem resultados de alta qualidade, mas muitas vezes faltam detalhes de alta frequência.
Para conseguir isso no SRGAN, Funções Lambda em Python Função de perdaA função de perda é uma ferramenta fundamental no aprendizado de máquina que quantifica a discrepância entre as previsões do modelo e os valores reais. Seu objetivo é orientar o processo de treinamento, minimizando essa diferença, permitindo assim que o modelo aprenda de forma mais eficaz. Existem diferentes tipos de funções de perda, como erro quadrático médio e entropia cruzada, cada um adequado para diferentes tarefas e... perceptiva que inclui a perda de conteúdo e adversária.
Verifica a papéis originais para informações detalhadas.
Passos –
1. Nós processamos RH (imagens de alta resolução) para imagens LR de amostragem reduzida. Agora temos imagens de RH e LR para o conjunto de dados de treinamento.
2. Passamos imagens LR por meio de um gerador que faz a amostragem e fornece imagens SR.
3. Usamos o discriminador para distinguir a imagem HR e propagar a perda de GAN para treinar o discriminador e gerador.
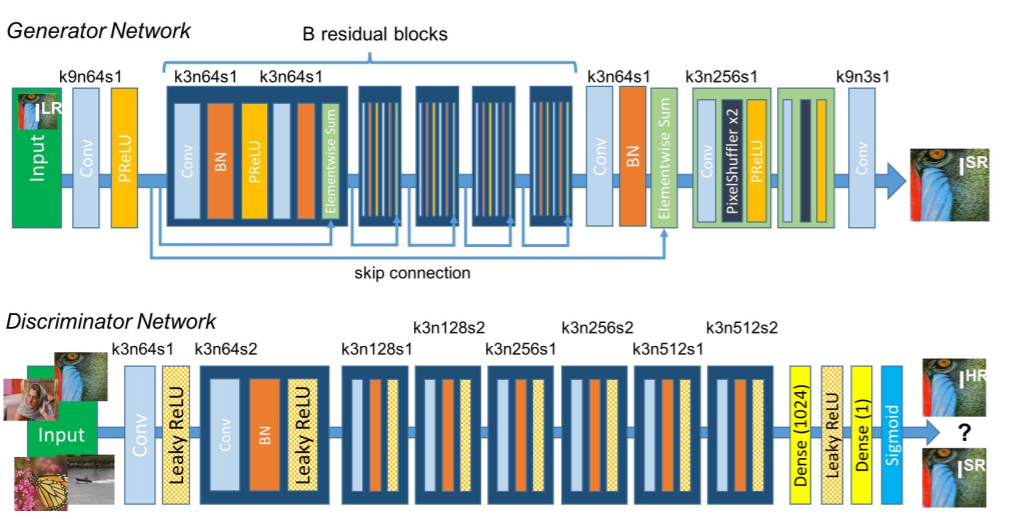
Arquitetura de rede SRGAN
Principais características do método:
- Tipo de quadro de pós-amostragem
- Camada de subpixel para maior amostragem
- Contém blocos residuais
- Perda de percepção de uso
EDSR, MDSR – Exposição de técnicas de aprendizagem residual
desempenho de super-resolução aprimorado por meio de redes neurais convolucionais profundas (DCNN). Arquitetura de escala única Rede aprimorada de super-resolução profunda (EDSR) lida com uma escala de super-resolução específica e Sistema de super resolução profunda em várias escalas (MDSR) reconstrói várias escalas de imagens de alta resolução em um único modelo. Melhoria significativa de desempenho do modelo.
é devido à otimização, removendo módulos desnecessários em
redes residuais convencionais.
Verifica a papéis originais para informações detalhadas.
Algumas das principais características dos métodos:
- Blocos residuais – SRGAN aplicou com sucesso a arquitetura ResNet ao problema de super resolução com SRResNet, melhorou ainda mais o desempenho, empregando uma estrutura ResNet melhor. Na arquitetura proposta –
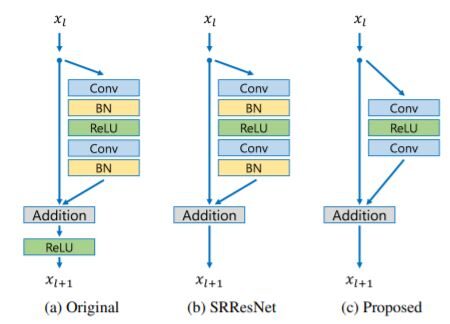
Comparação de blocos residuais
- Removeram as camadas de padronizaçãoA padronização é um processo fundamental em várias disciplinas, que busca estabelecer padrões e critérios uniformes para melhorar a qualidade e a eficiência. Em contextos como engenharia, Educação e administração, A padronização facilita a comparação, Interoperabilidade e compreensão mútua. Ao implementar normas, a coesão é promovida e os recursos são otimizados, que contribui para o desenvolvimento sustentável e a melhoria contínua dos processos.... por lotes da rede como em SRResNets. Uma vez que as camadas de normalização em lote normalizam as características, elimine a flexibilidade do alcance da rede padronizando as características, é melhor eliminá-los.
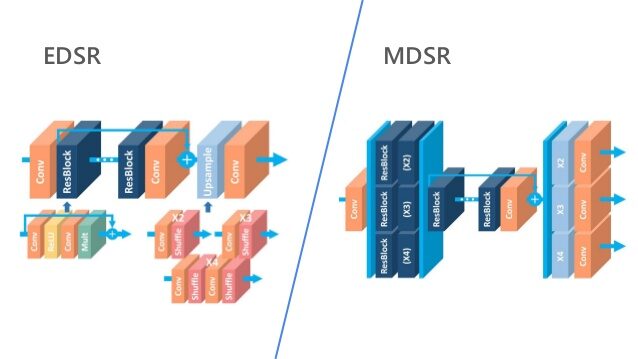
- Um MDSR, propuseram uma arquitetura multiescala que partilha a maioria dos parametroso "parametros" são variáveis ou critérios usados para definir, medir ou avaliar um fenômeno ou sistema. Em vários domínios, como a estatística, Ciência da Computação e Pesquisa Científica, Os parâmetros são essenciais para estabelecer normas e padrões que orientam a análise e interpretação dos dados. Sua seleção e manuseio adequados são cruciais para obter resultados precisos e relevantes em qualquer estudo ou projeto.... em diferentes escalas. O modelo multiescala proposto usa significativamente menos parâmetros do que vários modelos de escala única, mas mostra desempenho comparável.
Chegamos ao fim do blog!! Para mais informações sobre super resolução, verifique estes trabalhos de pesquisa.
Por favor, compartilhe seus comentários sobre o blog na seção de comentários. Boa aprendizagem 🙂
A mídia mostrada neste artigo não é propriedade da DataPeaker e é usada a critério do autor.





