
Introdução
Se está volviendo muy difícil mantenerse atualizado con los avances recientes que se están produciendo en el aprendizado profundoAqui está o caminho de aprendizado para dominar o aprendizado profundo em, Uma subdisciplina da inteligência artificial, depende de redes neurais artificiais para analisar e processar grandes volumes de dados. Essa técnica permite que as máquinas aprendam padrões e executem tarefas complexas, como reconhecimento de fala e visão computacional. Sua capacidade de melhorar continuamente à medida que mais dados são fornecidos a ele o torna uma ferramenta fundamental em vários setores, da saúde.... Dificilmente um dia passa sem que uma nova inovação ou um novo aplicativo de aprendizado profundo chegue. Porém, A maioria desses avanços está oculta em um grande número de artigos de pesquisa publicados em mídias como a ArXiv / Springer.
Para nos manter atualizados, criamos um pequeno grupo de leitura para compartilhar nossos aprendizados internamente no DataPeaker. Um desses aprendizados que eu gostaria de compartilhar com a comunidade é um estudo de arquiteturas avançadas que foram desenvolvidas pela comunidade de pesquisa.
Este artigo contém alguns dos avanços recentes em aprendizagem profunda, juntamente com códigos para implementação na biblioteca keras. Também forneci links para os artigos originais, caso você esteja interessado em lê-los ou queira consultá-los.
Para manter o artigo conciso, Eu só considerei arquiteturas que tiveram sucesso no domínio da Visão Computacional.
Se você está interessado, continue lendo!
PD: Este artigo pressupõe conhecimento de redes neurais e familiaridade com keras. Se você precisa se atualizar sobre esses tópicos, Eu recomendo fortemente que você leia os seguintes artigos primeiro:
Tabela de conteúdo
- O que entendemos por arquitetura avançada?
- Tipos de tarefas de visão de máquina
- Lista de arquiteturas de aprendizagem profunda
O que entendemos por arquitetura avançada?
Os algoritmos de aprendizado profundo consistem em um conjunto diversificado de modelos em comparação com um único algoritmo de aprendizado de máquina tradicional. Esto se debe a la flexibilidad que proporciona la neuronal vermelhoAs redes neurais são modelos computacionais inspirados no funcionamento do cérebro humano. Eles usam estruturas conhecidas como neurônios artificiais para processar e aprender com os dados. Essas redes são fundamentais no campo da inteligência artificial, permitindo avanços significativos em tarefas como reconhecimento de imagem, Processamento de linguagem natural e previsão de séries temporais, entre outros. Sua capacidade de aprender padrões complexos os torna ferramentas poderosas.. al crear un modelo completo de extremo a extremo.
A rede neural às vezes pode ser comparada a blocos de lego, onde você pode construir quase qualquer estrutura simples ou complexa que sua imaginação o ajude a construir.
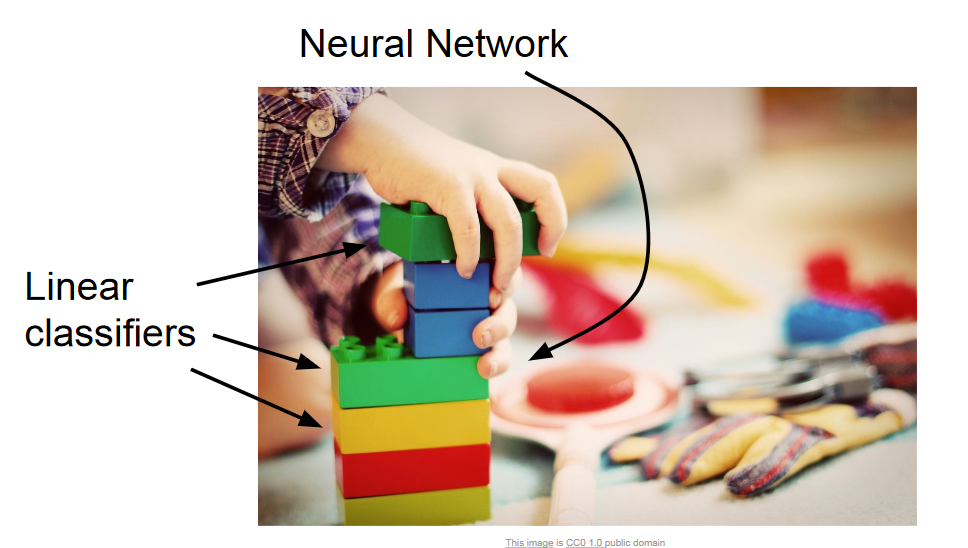
Podemos definir uma arquitetura avançada como aquela que possui um histórico comprovado de ser um modelo de sucesso.. Isso é visto principalmente em desafios como ImageNet, onde sua tarefa é resolver um problema, digamos reconhecimento de imagem, usando os dados fornecidos. Quem não sabe o que é ImageNet, é o conjunto de dados que é fornecido no desafio ILSVR (Reconhecimento Visual de Grande Escala ImageNet).
Também conforme descrito nas arquiteturas mencionadas abaixo, cada um deles tem uma nuance que os diferencia dos modelos usuais; dando-lhes uma vantagem quando usados para resolver um problema. Essas arquiteturas também se enquadram na categoria de modelos “profundo”, portanto, é provável que tenham um desempenho melhor do que suas contrapartes superficiais.
Tipos de tarefas de visão de máquina
Este artigo enfoca principalmente a visão computacional, então é natural descrever o horizonte das tarefas de visão computacional. Visão computacional; como o nome sugere, é simplesmente criar modelos artificiais que podem replicar as tarefas visuais realizadas por um ser humano. Isso significa essencialmente que o que podemos ver e o que percebemos é um processo que pode ser compreendido e implementado em um sistema artificial..
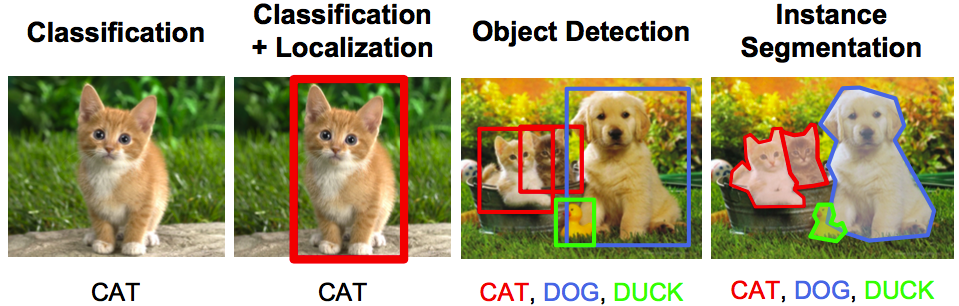
Os principais tipos de tarefas em que a visão computacional pode ser classificada são os seguintes:
- Reconhecimento / classificação de objeto – Em reconhecimento de objeto, você recebe uma imagem bruta e sua tarefa é identificar a qual classe a imagem pertence.
- Classificação + Localização – Se houver apenas um objeto na imagem e sua tarefa é encontrar a localização desse objeto, um termo mais específico para este problema é problema de localização.
- Detecção de objetos – Na detecção de objetos, sua tarefa é identificar onde os objetos estão na imagem. Esses objetos podem ser da mesma classe ou de uma classe completamente diferente.
- SegmentaçãoA segmentação é uma técnica de marketing chave que envolve a divisão de um mercado amplo em grupos menores e mais homogêneos. Essa prática permite que as empresas adaptem suas estratégias e mensagens às características específicas de cada segmento, melhorando assim a eficácia de suas campanhas. A segmentação pode ser baseada em critérios demográficos, psicográfico, geográfico ou comportamental, facilitando uma comunicação mais relevante e personalizada com o público-alvo.... de imagen – A segmentação de imagens é uma tarefa um pouco sofisticada, onde o objetivo é mapear cada pixel para sua classe legítima.
Lista de arquiteturas de aprendizagem profunda
Agora que entendemos o que é arquitetura avançada e exploramos as tarefas de visão computacional, vamos listar as arquiteturas mais importantes e suas descrições:
1. AlexNet
AlexNet é a primeira arquitetura profunda introduzida por um dos pioneiros no aprendizado profundo: Geoffrey Hinton e seus colegas. É uma arquitetura de rede simples, mas poderosa, que ajudou a pavimentar o caminho para pesquisas inovadoras de aprendizagem profunda como é agora. Aqui está uma representação da arquitetura proposta pelos autores.
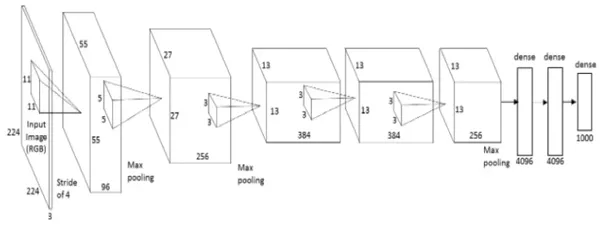
Quando ele quebra, AlexNet parece uma arquitetura simples com camadas convolucionais e agrupadas umas sobre as outras, seguido por camadas totalmente conectadas no topo. Esta é uma arquitetura muito simples, que foi conceituado na década de 1980. Lo que distingue a este modelo es la escala en la que realiza la tarea y el uso de la GPU para el TreinamentoO treinamento é um processo sistemático projetado para melhorar as habilidades, Conhecimento ou habilidades físicas. É aplicado em várias áreas, como esporte, Educação e desenvolvimento profissional. Um programa de treinamento eficaz inclui planejamento de metas, prática regular e avaliação do progresso. A adaptação às necessidades individuais e a motivação são fatores-chave para alcançar resultados bem-sucedidos e sustentáveis em qualquer disciplina..... Na década de 1980, a CPU foi usada para treinar uma rede neural. Enquanto AlexNet acelera o treinamento 10 vezes apenas com o uso de GPU.
Embora um pouco desatualizado no momento, AlexNet ainda é usado como um ponto de partida para aplicar redes neurais profundas para todas as tarefas, visão computacional ou reconhecimento de voz.
2. Rede VGG
A rede VGG foi apresentada por pesquisadores do Visual Graphics Group em Oxford (daí o nome VGG). Esta rede é especialmente caracterizada por sua forma piramidal, onde as camadas inferiores mais próximas da imagem são largas, enquanto as camadas superiores são profundas.
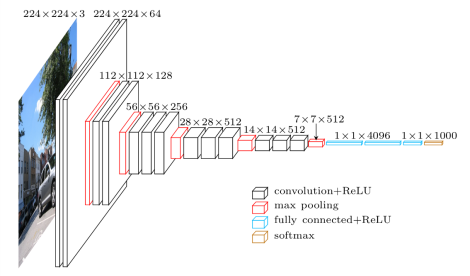
Como mostra a imagem, VGG contém camadas convolucionais posteriores seguidas por camadas agrupadas. As camadas de agrupamento são responsáveis por tornar as camadas mais estreitas. Em seu artigo, propôs vários tipos de redes deste tipo, com mudanças na profundidade da arquitetura.
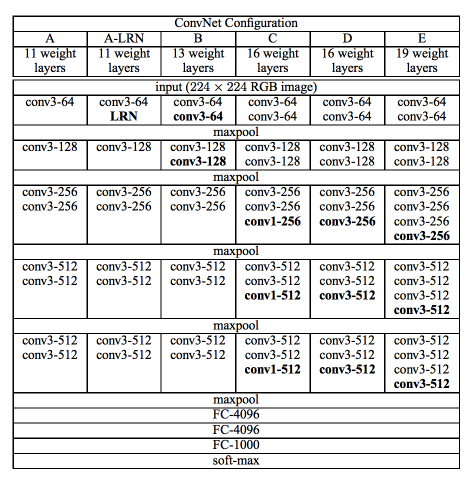
As vantagens do VGG são:
- É uma arquitetura muito boa para benchmarking em uma tarefa particular.
- O que mais, redes pré-habilitadas para VGG estão disponíveis gratuitamente na Internet, por isso é comumente usado para várias aplicações.
Por outro lado, sua principal desvantagem é que é muito lento para treinar se você treinar do zero. Incluído com uma GPU decente, levaria mais de uma semana para funcionar.
3. GoogleNet
GoogleNet (o Rede de Iniciação) é uma aula de arquitetura desenvolvida por pesquisadores do Google. GoogleNet foi o vencedor do ImageNet 2014, onde ele provou ser um modelo poderoso.
Nesta arquitetura, além de aprofundar (contém 22 camadas em comparação com VGG que tinha 19 capas), os pesquisadores também fizeram uma nova abordagem chamada módulo de Iniciação.
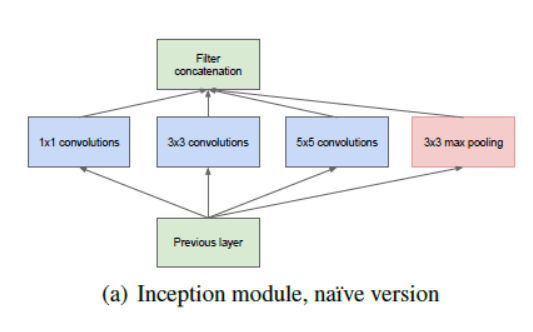
Como visto acima, é uma mudança drástica em relação às arquiteturas sequenciais que vimos anteriormente. Em uma única camada, vários tipos de “extratores de recursos”. Isso indiretamente ajuda a rede a funcionar melhor, uma vez que a rede em treinamento tem muitas opções para escolher ao resolver a tarefa. Você pode optar por envolver a entrada ou agrupá-la diretamente.
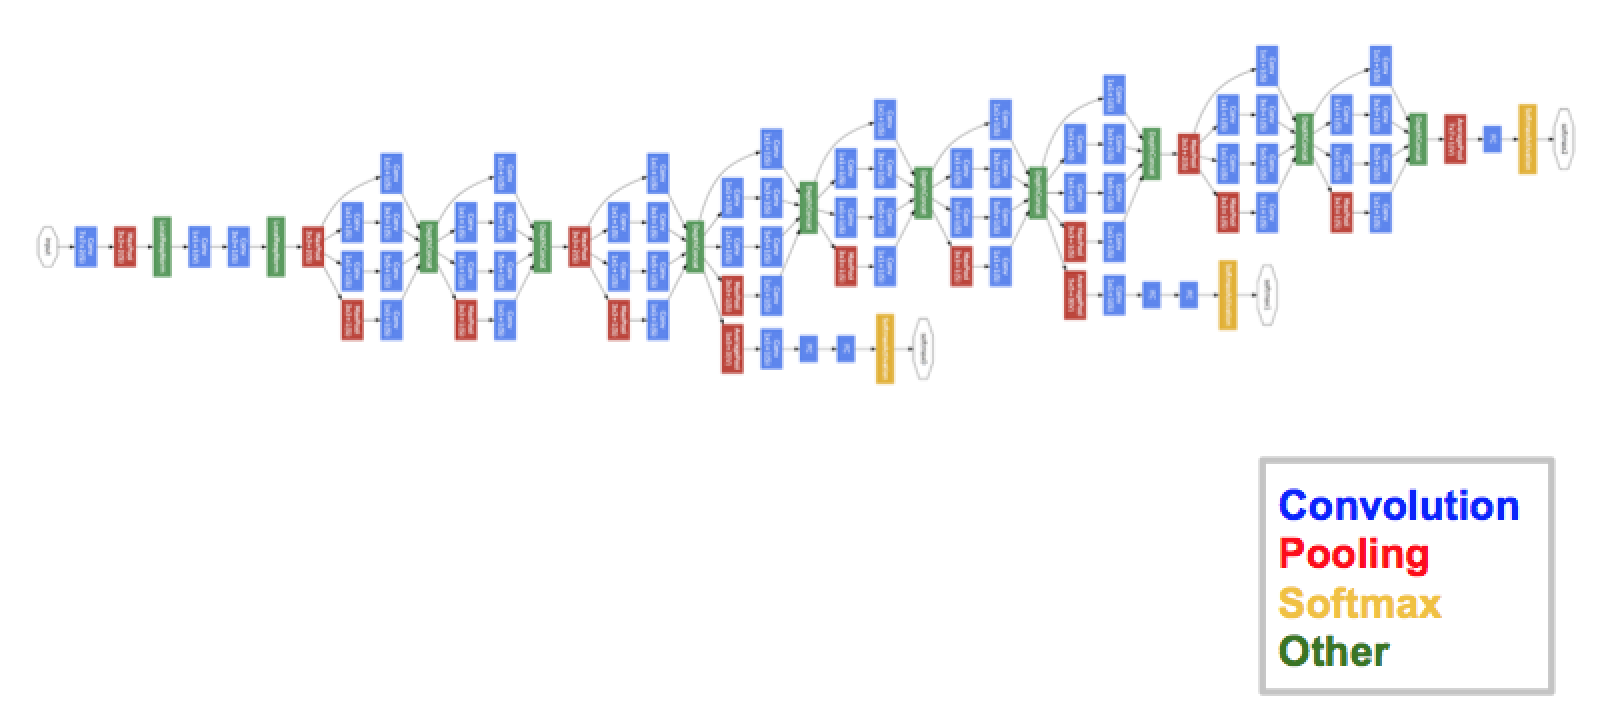
A arquitetura final contém vários desses módulos iniciais empilhados uns sobre os outros.. Até o treinamento é um pouco diferente no GoogleNet, ya que la mayoría de las capas superiores tienen su propia Camada de saídao "Camada de saída" é um conceito utilizado no campo da tecnologia da informação e design de sistemas. Refere-se à última camada de um modelo ou arquitetura de software que é responsável por apresentar os resultados ao usuário final. Essa camada é crucial para a experiência do usuário, uma vez que permite a interação direta com o sistema e a visualização dos dados processados..... Essa nuance ajuda o modelo a convergir mais rápido, uma vez que há treinamento conjunto e treinamento paralelo para as próprias camadas.
As vantagens do GoogleNet são:
- GoogleNet treina mais rápido que VGG.
- O tamanho de uma rede do Google previamente treinada é comparativamente menor do que o do VGG. Um modelo VGG pode ter> 500 MB, enquanto o GoogleNet tem um tamanho de apenas 96 MB
O GoogleNet não tem uma desvantagem imediata em si, mas mudanças adicionais para a arquitetura são propostas, que fazem o modelo funcionar melhor. Uma dessas mudanças é chamada Red Xception, em que o limite de divergência do módulo inicial é aumentado (4 no GoogleNet como vimos na imagem acima). Agora, teoricamente, pode ser infinito (Por isso é chamado de início extremo!)
4. ResNet
ResNet é uma das arquiteturas monstruosas que realmente define o quão profunda pode ser uma arquitetura de aprendizado profundo.. Redes residuais (ResNet para breve) consiste em vários módulos residuais subsequentes, que são o bloco de construção básico da arquitetura ResNet. Uma representação do módulo residual é a seguinte
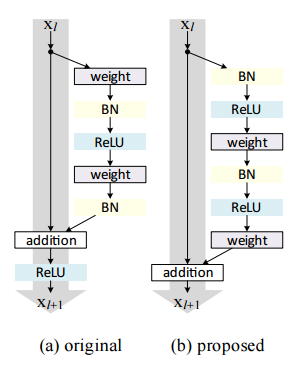
Em palavras simples, um módulo residual tem duas opções, você pode realizar um conjunto de funções na entrada ou você pode pular esta etapa completamente.
Agora semelhante ao GoogleNet, esses módulos residuais são empilhados uns sobre os outros para formar uma rede ponta a ponta completa.
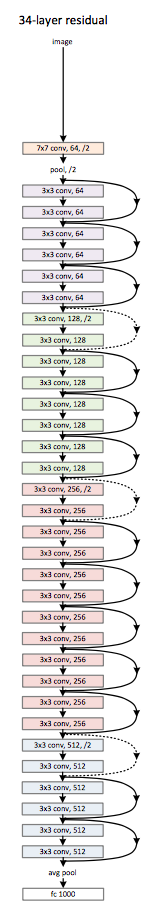
Algumas técnicas mais recentes que o ResNet introduziu incluem:
- Uso de SGD padrão em vez de técnica de aprendizagem adaptativa extravagante. Isso é feito em conjunto com uma função de inicialização razoável que mantém o treinamento intacto..
- Mudanças no pré-processamento de entrada, onde a entrada é primeiro corrigida e, em seguida, fornecida à rede.
A principal vantagem do ResNet é que centenas, mesmo milhares dessas camadas residuais podem ser usadas para criar uma rede e, em seguida, treinar. Isso é um pouco diferente das redes sequenciais usuais, onde você vê que há melhorias de desempenho reduzidas conforme o número de camadas aumenta.
5. ResNeXt
ResNeXt é considerado a técnica atual mais avançada para reconhecimento de objetos. É baseado nos conceitos de inicialização e resnet para gerar uma arquitetura nova e aprimorada. A imagem a seguir é um resumo da aparência de um módulo residual do módulo ResNeXt.
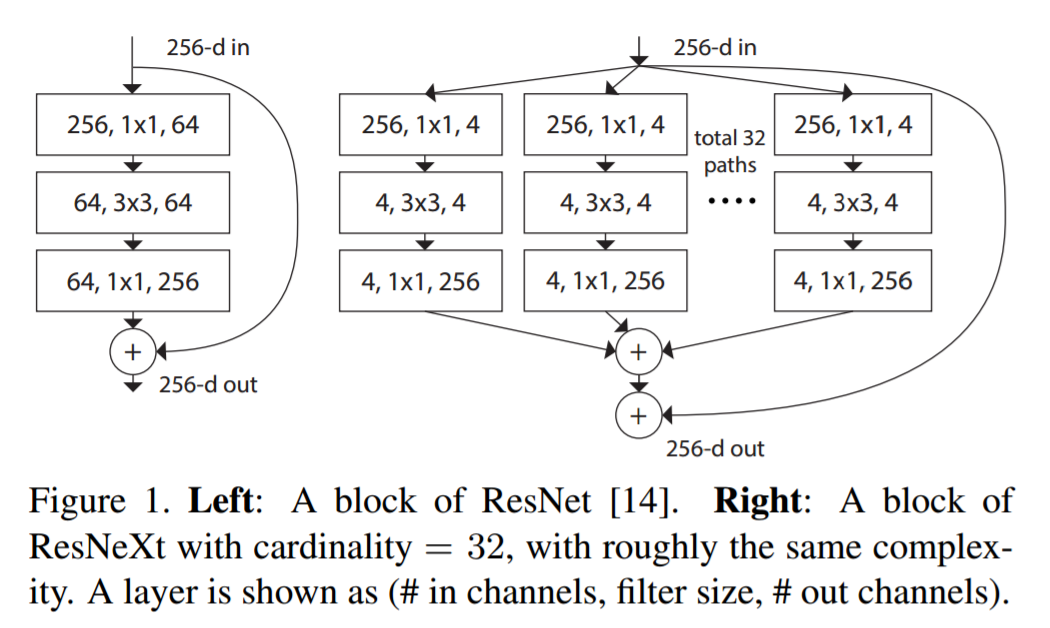
6. RCNN (CNN regional)
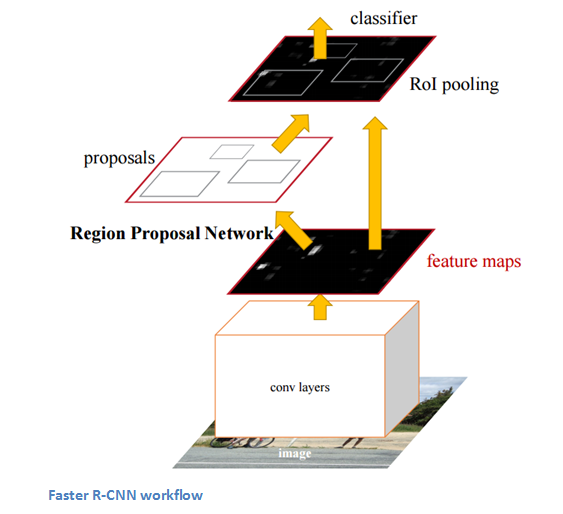
A arquitetura CNN baseada em região é considerada a mais influente de todas as arquiteturas de aprendizado profundo que foram aplicadas ao problema de detecção de objetos.. Para resolver o problema de detecção, o que o RCNN faz é tentar desenhar uma caixa delimitadora sobre todos os objetos presentes na imagem e, em seguida, reconhecer qual objeto está na imagem. Funciona da seguinte maneira:
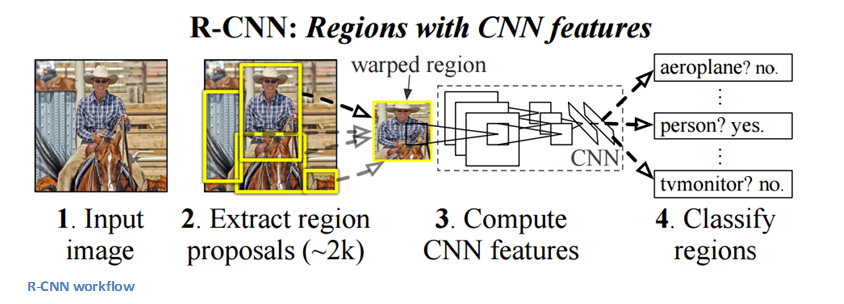
A estrutura do RCNN é a seguinte:
7. YOLO (você só olha uma vez)
YOLO é o sistema atual de última geração baseado em aprendizado profundo em tempo real para resolver problemas de detecção de imagem. Como pode ser visto na imagem abaixo, ele primeiro divide a imagem em caixas delimitadoras definidas e, em seguida, executa um algoritmo de reconhecimento em paralelo para todas essas caixas para identificar a qual classe de objeto elas pertencem. Depois de identificar essas classes, continua a mesclar habilmente essas caixas para formar uma caixa delimitadora ideal em torno dos objetos.
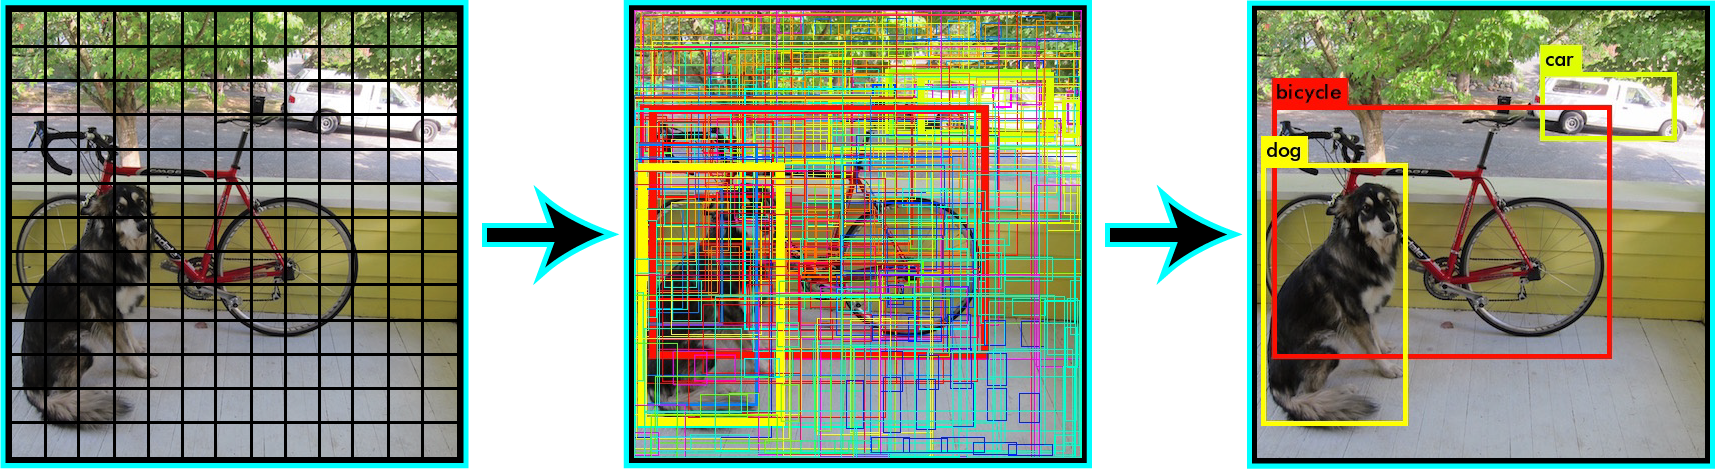
Tudo isso é feito em paralelo, para que possa ser executado em tempo real; processando 40 imagens em um segundo.
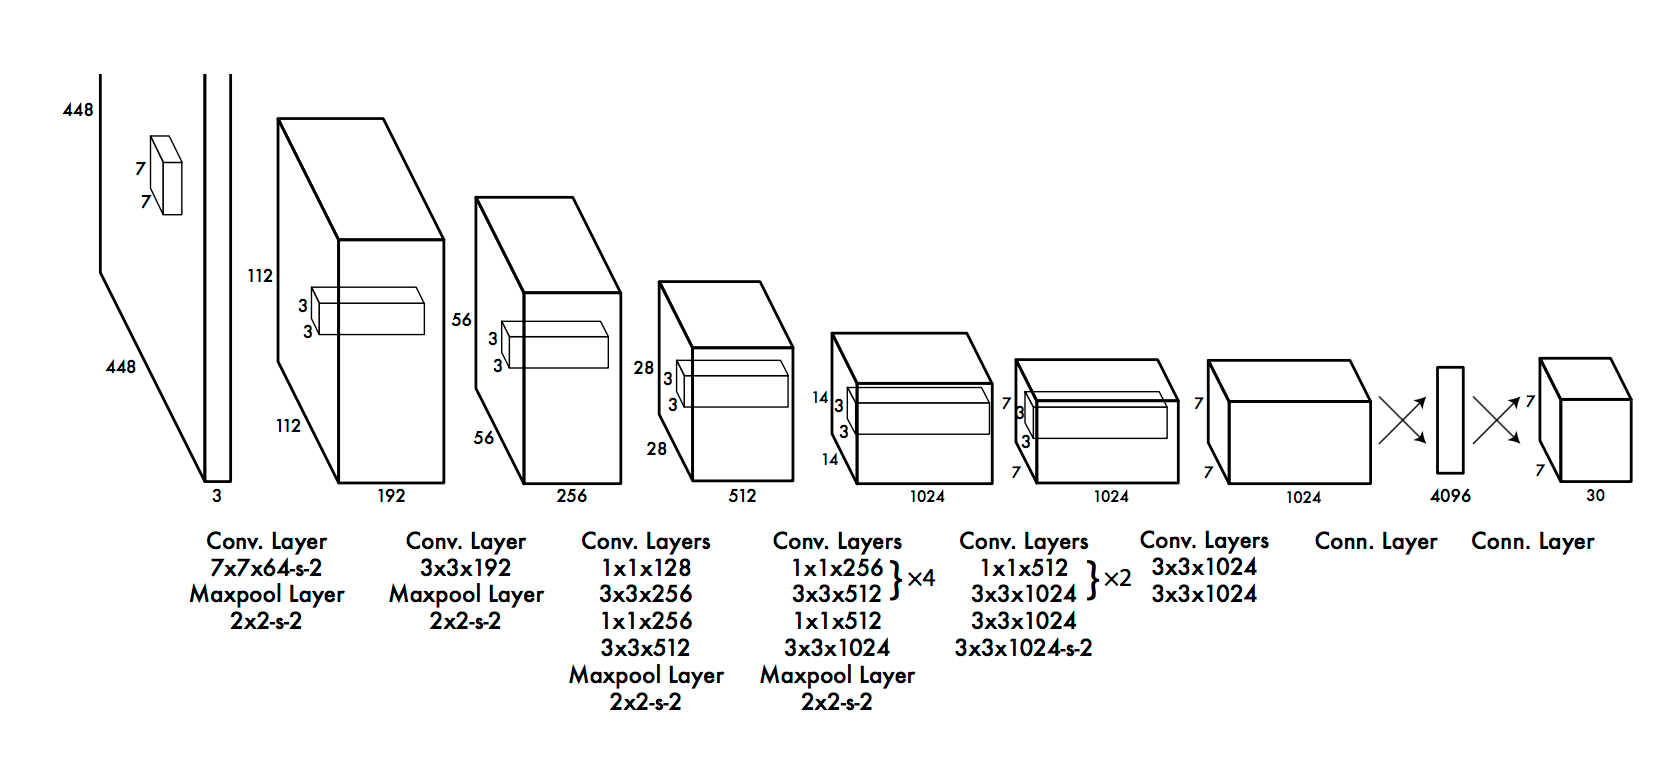
Embora ofereça um desempenho reduzido do que sua contraparte RCNN, ainda tem a vantagem de estar em tempo real para ser viável para uso nos problemas do dia-a-dia. Aqui está uma representação da arquitetura YOLO.
8. SqueezeNet
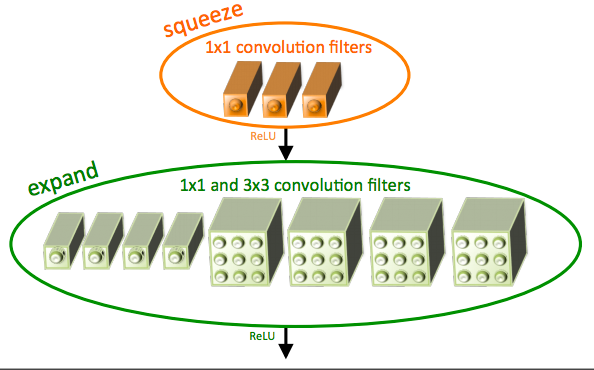
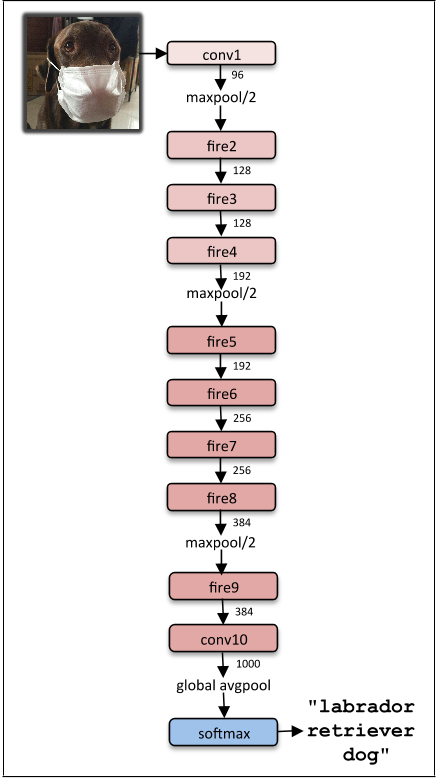
A arquitetura squeezeNet é uma arquitetura mais poderosa que é extremamente útil em cenários de baixa largura de banda, como plataformas móveis.. Esta arquitetura ocupa apenas 4,9 MB de espaço, por outro lado, O começo ocupa ~ 100 MB! Essa mudança drástica é provocada por uma estrutura especializada chamada módulo de incêndio.. A imagem abaixo é uma representação do módulo de incêndio.
A arquitetura final do squeezeNet é a seguinte:
9. SegNet
SegNet é uma arquitetura de aprendizado profundo aplicada para resolver problemas de segmentação de imagens. Consiste em uma sequência de camadas de processamento (codificadores) seguido por um conjunto correspondente de decodificadores para uma classificação de pixel. A imagem a seguir resume a operação do SegNet.
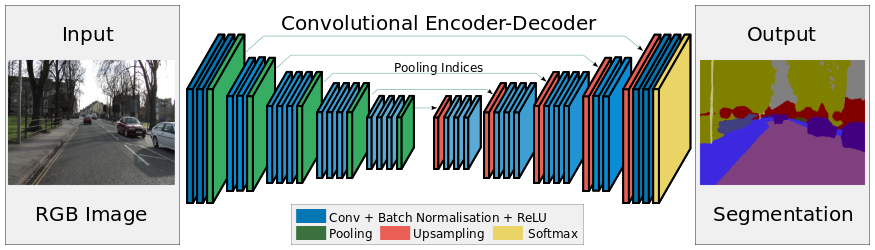
Uma característica fundamental do SegNet é que ele preserva os detalhes de alta frequência na imagem segmentada, como os índices de agrupamento da rede do codificador são conectados aos índices de agrupamento das redes do decodificador. Em resumo, a transferência de informações é direta, em vez de complicada. SegNet é um dos melhores modelos para usar quando se trata de problemas de segmentação de imagens.
10. GAN (Rede Adversarial Generativa)
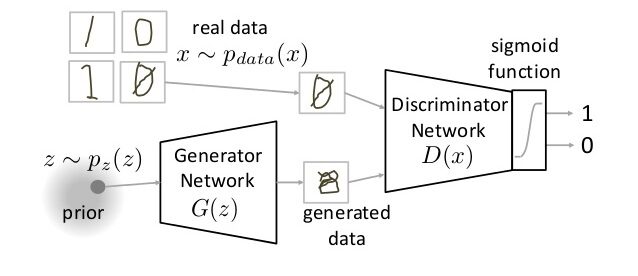
GAN é uma classe completamente diferente de arquiteturas de rede neural, em que uma rede neural é usada para gerar uma imagem completamente nova que não está presente no conjunto de dados de treinamento, mas é realista o suficiente para estar no conjunto de dados. Por exemplo, a imagem abaixo é uma análise do GAN. Abordei como funcionam os GANs neste artigo.. Verifique se você está curioso.
Notas finais
Neste artigo, Cobri uma visão geral das principais arquiteturas de aprendizado profundo com as quais você deve estar familiarizado. Se você tiver alguma dúvida sobre arquiteturas de aprendizado profundo, sinta-se à vontade para compartilhar comigo através dos comentários.





