
Tema a abordar
- O que é análise exploratória de dados?
- Qual é a necessidade de automatizar a análise exploratória de dados?
- Bibliotecas Python para automatizar a análise exploratória de dados
Análise exploratória de dados
é uma técnica de exploração de dados para compreender os diversos aspetos dos dados. É uma espécie de resumo de dados. É um dos passos mais importantes antes de realizar qualquer tarefa de aprendizagem automática ou aprendizado profundoAqui está o caminho de aprendizado para dominar o aprendizado profundo em, Uma subdisciplina da inteligência artificial, depende de redes neurais artificiais para analisar e processar grandes volumes de dados. Essa técnica permite que as máquinas aprendam padrões e executem tarefas complexas, como reconhecimento de fala e visão computacional. Sua capacidade de melhorar continuamente à medida que mais dados são fornecidos a ele o torna uma ferramenta fundamental em vários setores, da saúde....
Os cientistas de dados realizam procedimentos de análise exploratória de dados para explorar, dissecar e resumir as qualidades fundamentais dos conjuntos de dados, utilizando regularmente abordagens de representação da informação. Os procedimentos de EDA têm em consideração um controlo rigoroso das fontes de informação, o que permite aos cientistas de dados descobrir as respostas adequadas de que precisam ao encontrar padrões de informação, detetar inconsistências, verificar suposições ou testar hipóteses.
Os cientistas de dados utilizam análise exploratória de dados para observar o que os conjuntos de dados podem revelar para além da apresentação convencional da informação ou das atribuições de teste de hipóteses. Isto permite-lhes adquirir uma perceção abrangente sobre os fatores nos conjuntos de dados e as suas ligações. A análise exploratória de dados pode ajudar a identificar erros evidentes, distinguir exceções nos conjuntos de dados, obter conexões, descobrir elementos significativos, descubra padrões com informações privilegiadas e forneça novos conhecimentos.
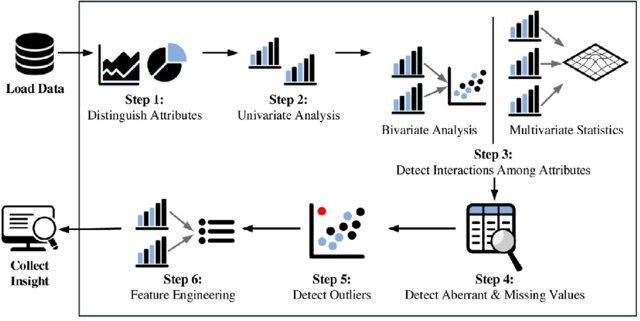
Etapas na análise exploratória de dados
Necessidade de automatizar a análise exploratória de dados
O movimento expandido dos clientes na web, os instrumentos aperfeiçoados para controlar o tráfego web, a multiplicação de telemóveis, os dispositivos habilitados para a web e os sensores de IoT são os elementos essenciais que aceleram o ritmo da era da informação atualmente. Nesta era informatizada, as organizações de todos os tamanhos compreendem que a informação pode assumir um papel crucial na melhoria da sua competitividade, rentabilidade e capacidades dinâmicas, o que gera maiores acordos, receitas e lucros.
Hoje em dia, la mayoría de las organizaciones se acercan a inmensos conjuntos de datos, porém, solo tener grandes medidas de información no mejora el negocio, excepto si las empresas investigan los datos accesibles e impulsan el desenvolvimento autorizado.
En el ciclo de vida de un proyecto de ciencia de datos o cualquier proyecto de aprendizaje automático, mais do que 60% de tu tiempo entra en cosas como análise de datos, selección de características, engenharia de recursos, etc. Debido a que es la parte más importante o la columna vertebral de un proyecto de ciencia de datos, es esa parte en particular en la que tiene que realizar muchas actividades como limpiar los datos, manejar los valores faltantes , manejar valores atípicos, manejar conjuntos de datos desequilibrados, como lidar com características categóricas e muito mais. Então, se queres poupa o teu tempo na análise exploratória de dados, podemos usar bibliotecas Python como dtale, pandas profiling, sweetviz e autoviz para automatizar as nossas tarefas.
As bibliotecas automatizam a análise exploratória de dados
Neste blog, Discutimos quatro bibliotecas Python importantes. Estas são listadas abaixo:
- pandas profiling
- pandas profiling
- sweetviz
- autoviz
D-pandas profiling
É uma biblioteca lançada em fevereiro de 2020 que nos permite visualizar facilmente o DataFrame do pandas. Tem muitas funcionalidades que são muito úteis para a análise exploratória de dados. É feita usando o backend do Flask e o frontend React. Suporta gráficos interativos, Gráficos 3D, mapas de calor, a correlação entre características, crea columnas personalizadas y muchos más. Es el más famoso y el favorito de todos.
Instalação
dtale se pode instalar usando el siguiente código:
pip install dtale
Análise de datos exploratorios con D-tale
Profundicemos en el análisis de datos exploratorios utilizando esta biblioteca. Primeiro, tenemos que escribir un código para lanzar la aplicación interactiva d-tale localmente:
import dtale
import pandas as pd
df = pd.read_csv('data.csv')
d = dtale.show(df)
d.open_browser()
Aquí estamos importando pandas y dtale. Estamos a ler o conjunto de dados usando a função read_csv () y finalmente mostramos los datos en el navegador localmente usando la función mostrar y abrir el navegador.
Muestra los datos de la misma manera que lo hacen los pandas, pero tiene una característica adicional, tiene un menu en la esquina superior izquierda que nos permite fazer muchas cosas y muestra un recuento de colunas y filas no nosso conjunto de dados.
A saída do código acima é mostrada abaixo:
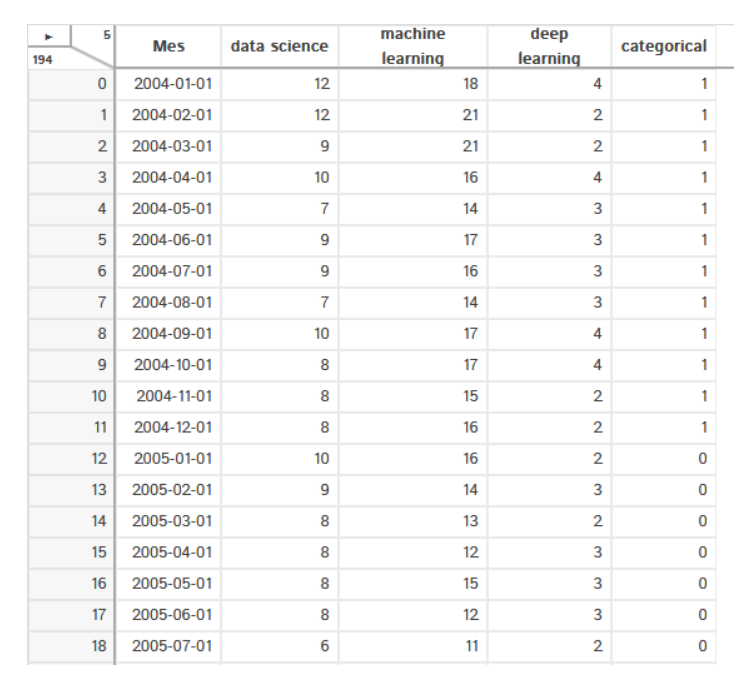
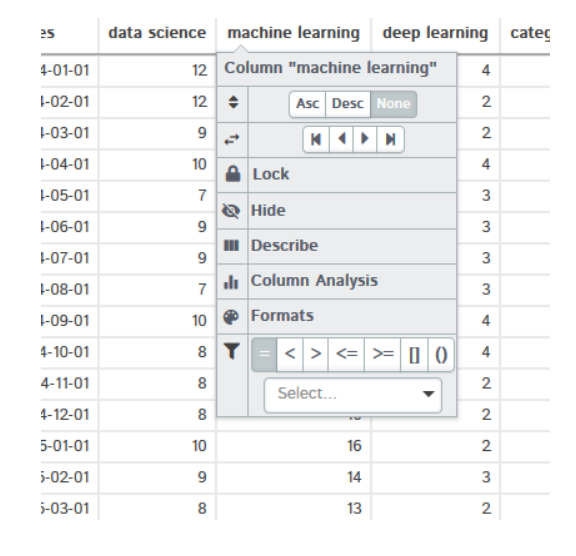
Si hace clic en cualquier encabezado de coluna, aparecerá el menú desplegable. Le brindará muchas opciones, como ordenar los datos, describir el conjunto de datos, análisis de columnas y muchas más. También puede comprobar esta función por su cuenta
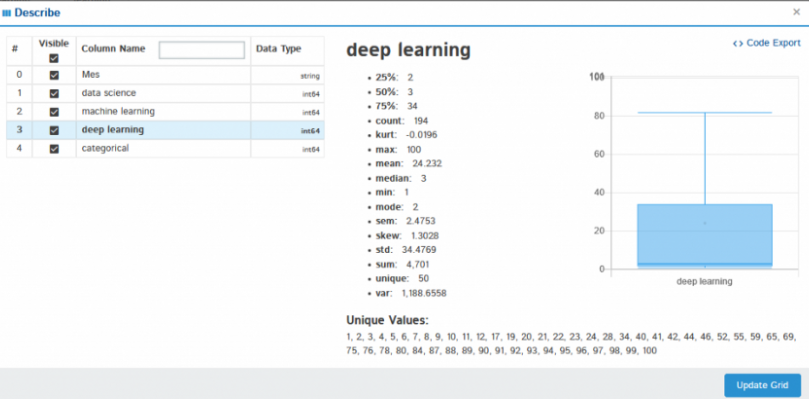
Si hace clic en Describir, muestra el análisis estadístico de la columna seleccionada como media, medianaA mediana é uma medida estatística que representa o valor central de um conjunto de dados ordenados. Para calculá-lo, Os dados são organizados do menor para o maior e o número no meio é identificado. Se houver um número par de observações, Os dois valores principais são calculados em média. Este indicador é especialmente útil em distribuições assimétricas, uma vez que não é afetado por valores extremos...., máximo, mínima varianza, Desvio padrão, cuartiles y muchos más.
Do mesmo modo, puede probar otras funciones por su cuenta, como análisis de columnas, formatos, filtros.
Magic of dtale: clique no botão de menu e encontrará todas as opções disponíveis
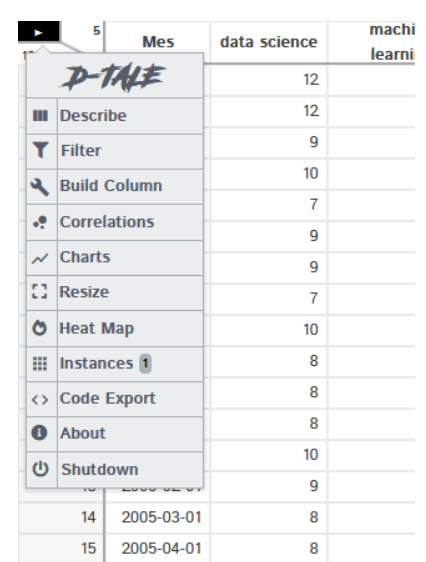
Não é possível cobrir todas as funcionalidades, mas estou a cobrir a mais interessante.
Correlações – Mostra-nos como as colunas se correlacionam entre si.
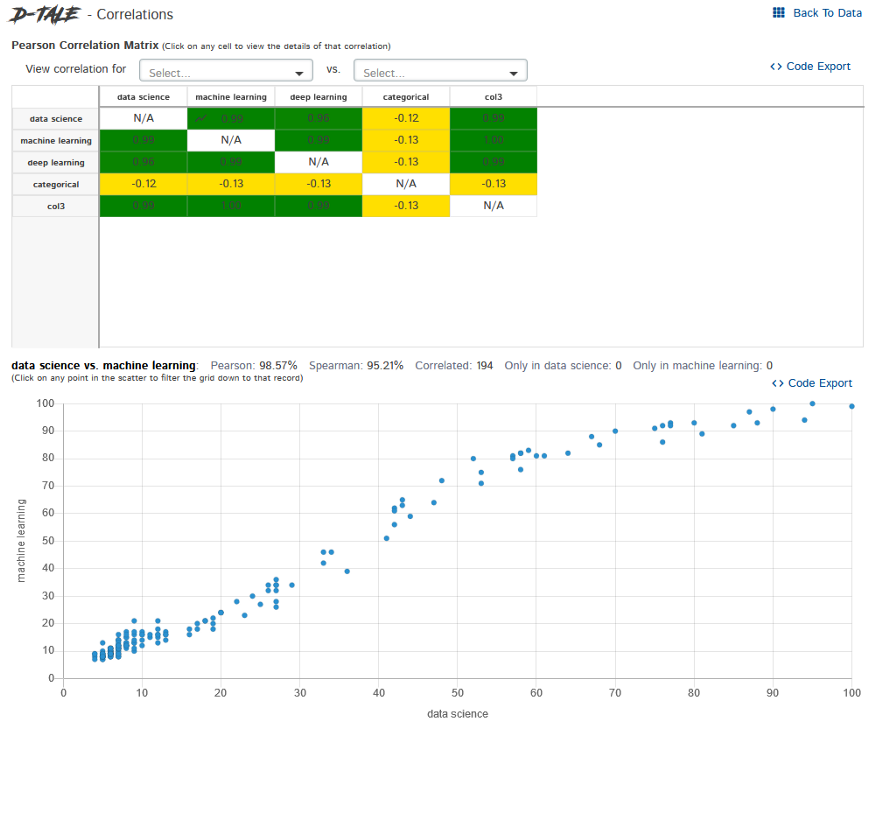
Gráficos– Crie gráficos personalizados como gráficos de linhas, gráficos de barras, gráfico de setores, gráficos empilhados, diagramas de dispersão, mapas geológicos, etc.
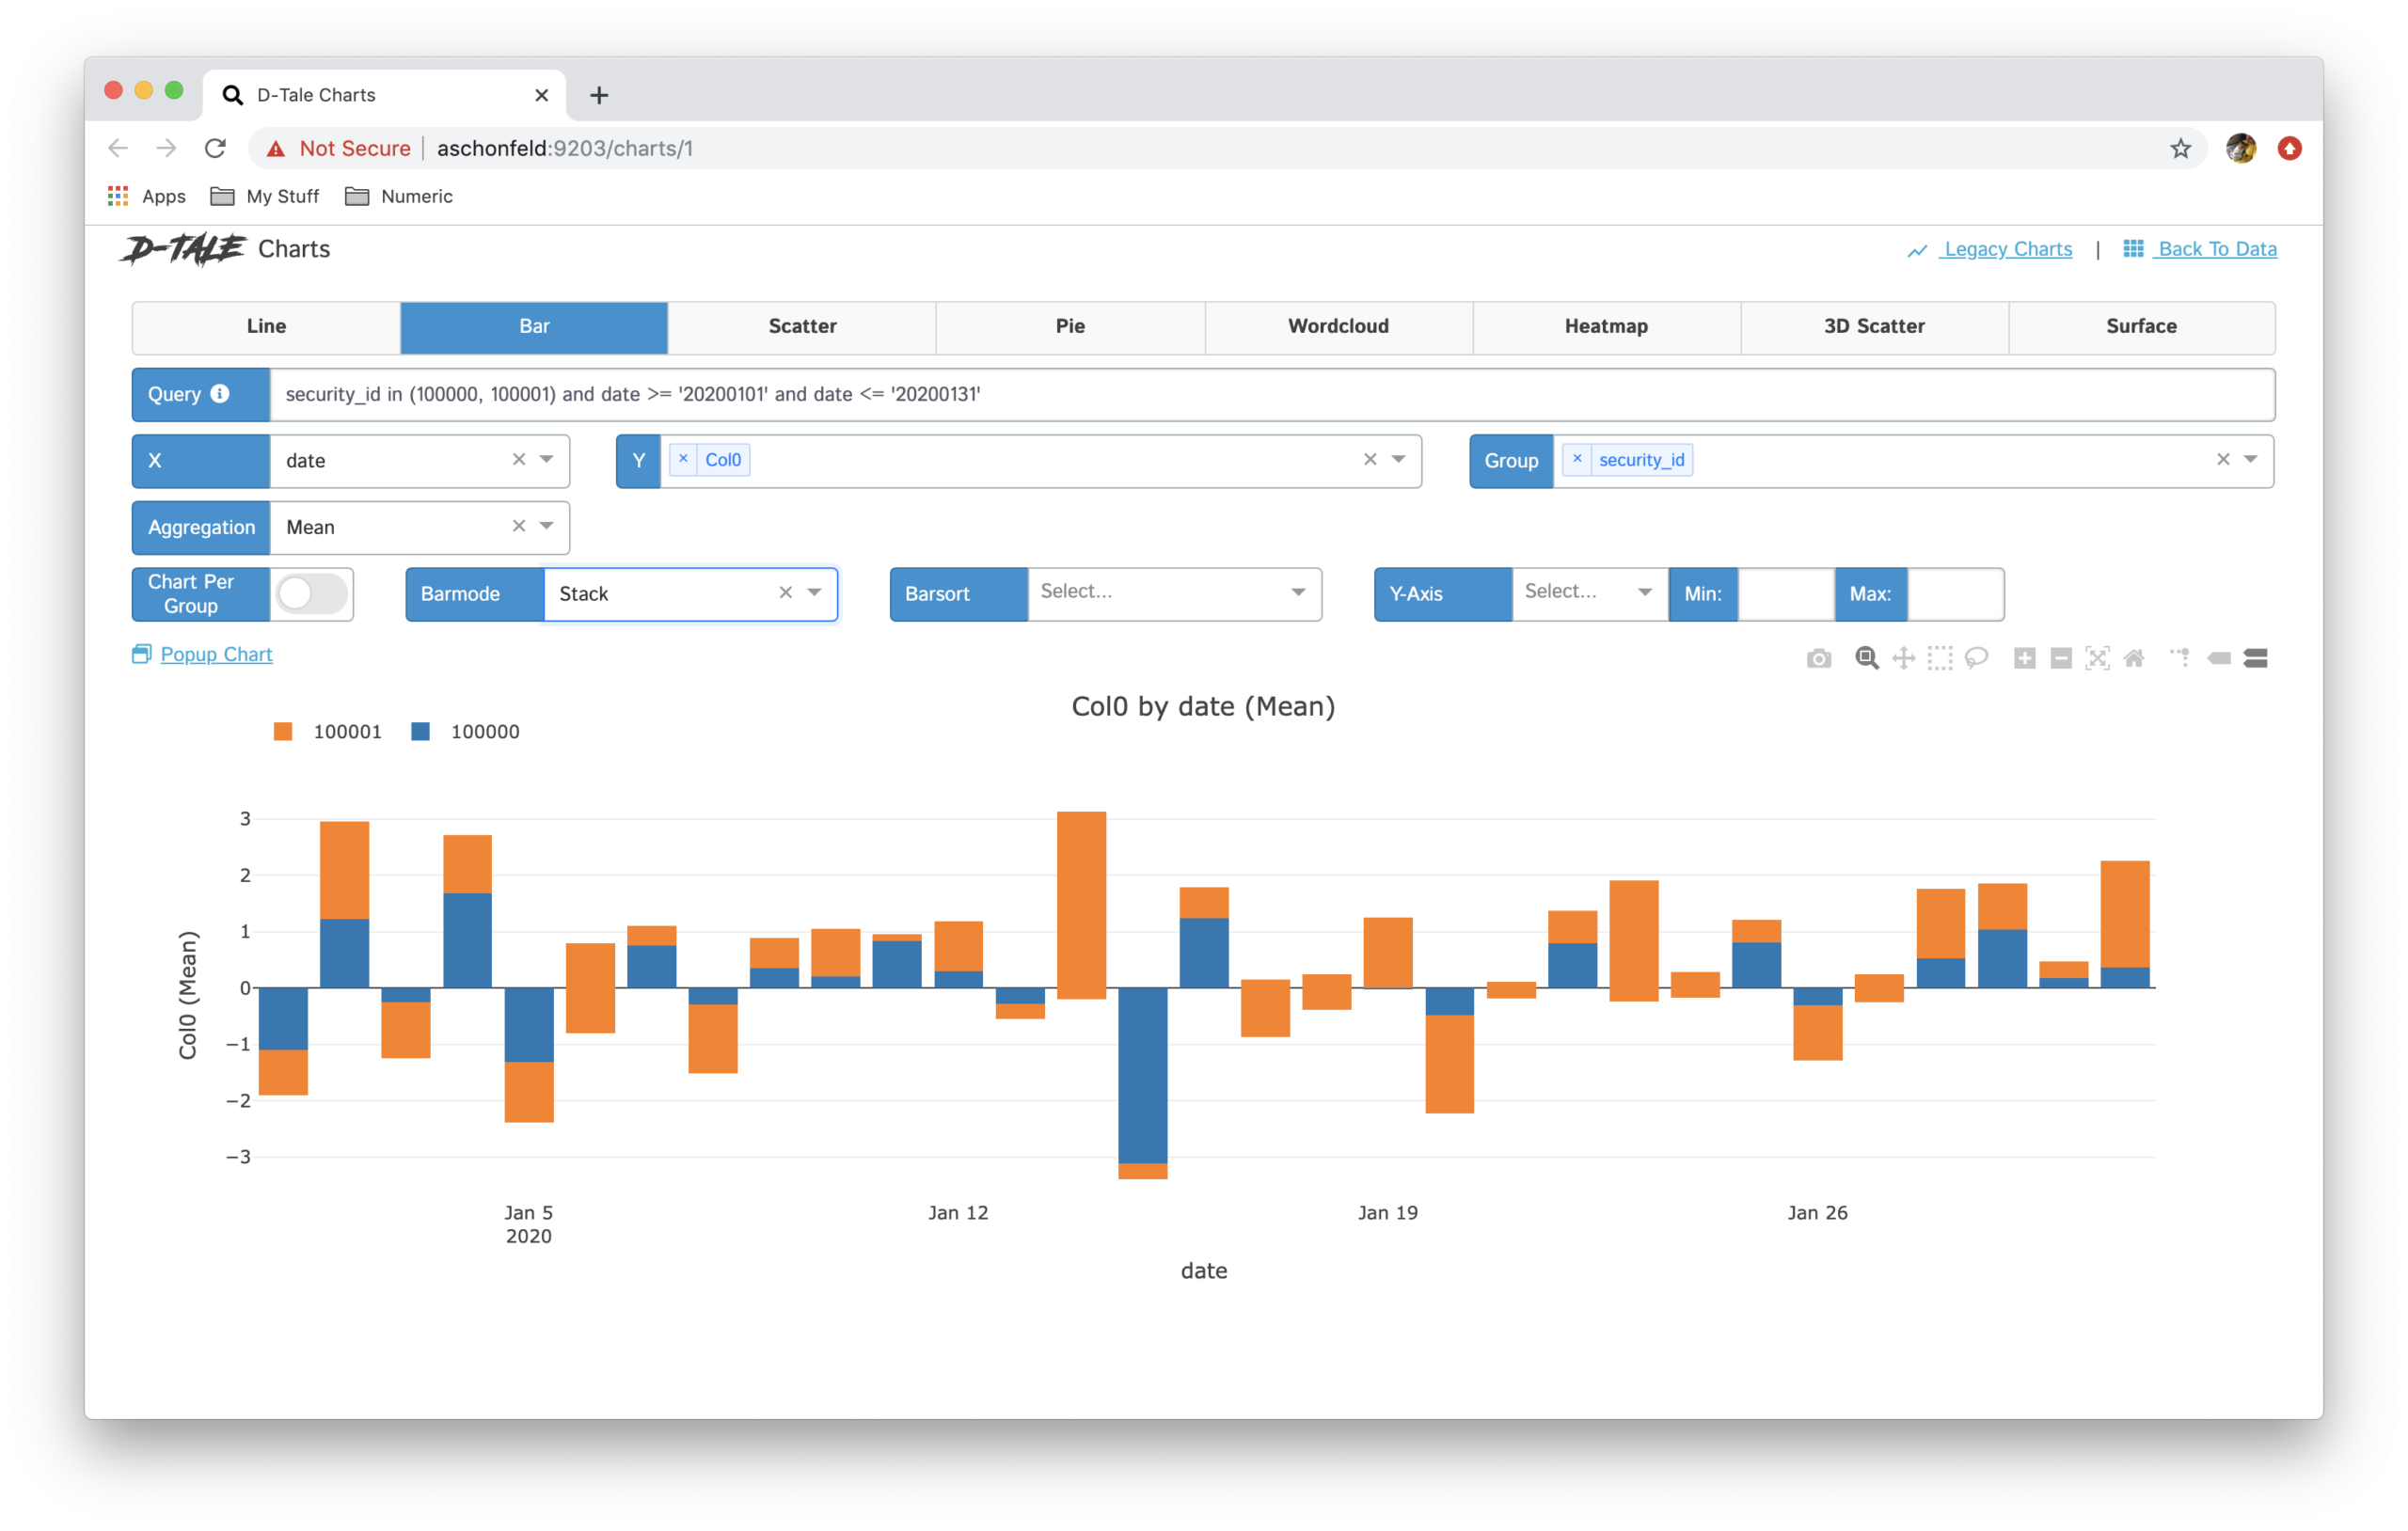
Existem muitas opções disponíveis nesta biblioteca para a análise de dados. Esta ferramenta é muito útil e torna a análise exploratória de dados muito mais rápida em comparação com a utilização de bibliotecas tradicionais de machine learning como pandas, matplotlib, etc.
Para obter documentação oficial, verifique este link:
Perfilamento de pandas
Es una biblioteca de código abierto escrita en Python y generó informes HTML interativos y describe varios aspetos del conjunto de datos. Las funcionalidades clave incluyen el manejo de valores perdidos, estadísticas de conjuntos de datos como media, moda, mediana, asimetría, Desvio padrão, etc., gráficos como histogramasHistogramas são representações gráficas que mostram a distribuição de um conjunto de dados. Eles são construídos dividindo o intervalo de valores em intervalos, o "Caixas", e contando quantos dados caem em cada intervalo. Essa visualização permite identificar padrões, tendências e variabilidade de dados de forma eficaz, facilitando a análise estatística e a tomada de decisões informadas em várias disciplinas.... y correlaciones también.
Instalação
La creación de perfiles de pandas se puede instalar usando el siguiente código:
pip install pandas-profiling
Análisis de datos exploratorios mediante la creación de perfiles de Pandas
Profundicemos en el análisis de datos exploratorios utilizando esta biblioteca. Estoy usando un conjunto de datos de muestra para comenzar con la creación de perfiles de pandas, verifique el siguiente código:
#importing required packages
import pandas as pd
import pandas_profiling
import numpy as np

#importing the data
df = pd.read_csv('sample.csv')

#descriptive statistics
pandas_profiling.ProfileReport(df)
A continuación se muestra la salida mágica del código anterior
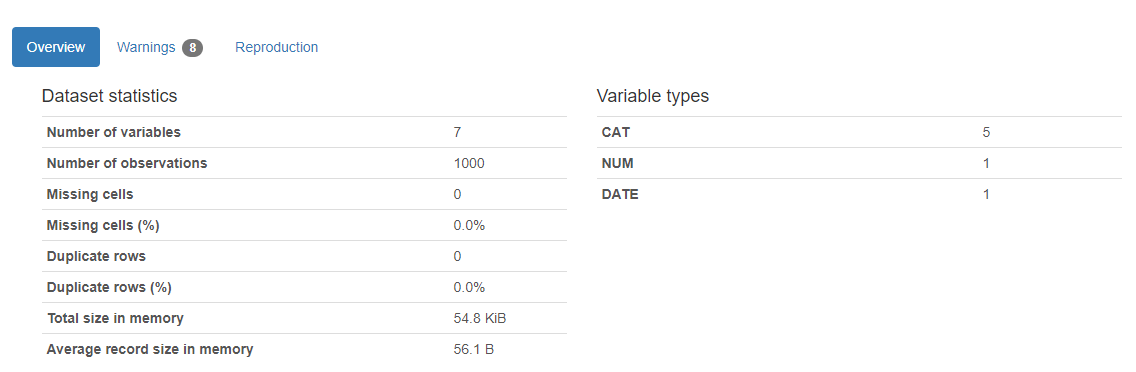
Aquí está el resultado. Aparecerá un informe y devolverá cuántas variables hay en nuestro conjunto de datos, el número de filas, las celdas que faltan en el conjunto de datos, el porcentaje de celdas que faltan, el número y el porcentaje de filas duplicadas. Los datos de celdas faltantes y duplicadas son muy importantes para nuestro análisis, ya que describen la imagen más amplia del conjunto de datos. El informe también muestra el tamaño total de la memoria. También muestra los tipos de variables en el lado derecho de la salida.
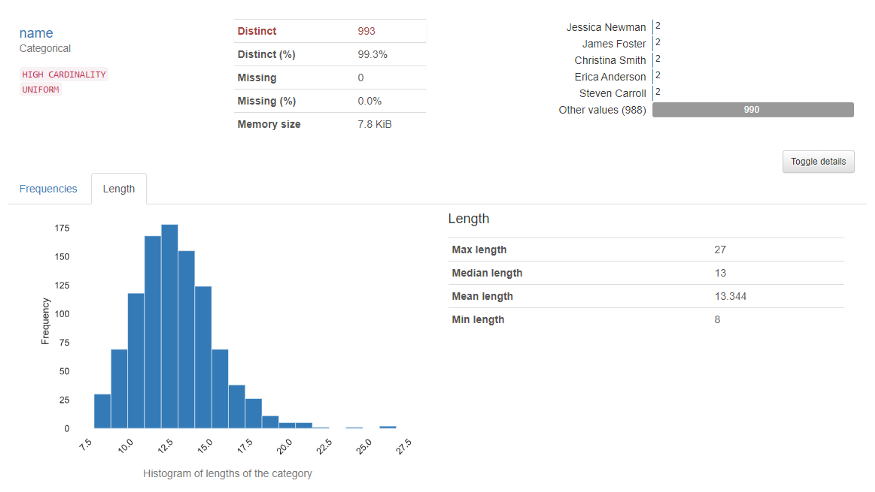
La sección de variables muestra el análisis de una columna en particular. Por exemplo, para o variávelEm estatística e matemática, uma "variável" é um símbolo que representa um valor que pode mudar ou variar. Existem diferentes tipos de variáveis, e qualitativo, que descrevem características não numéricas, e quantitativo, representando quantidades numéricas. Variáveis são fundamentais em experimentos e estudos, uma vez que permitem a análise de relações e padrões entre diferentes elementos, facilitando a compreensão de fenômenos complexos.... Categórico, aparecerá a seguinte saída.
Para o variável numérica, aparecerá a seguinte saída
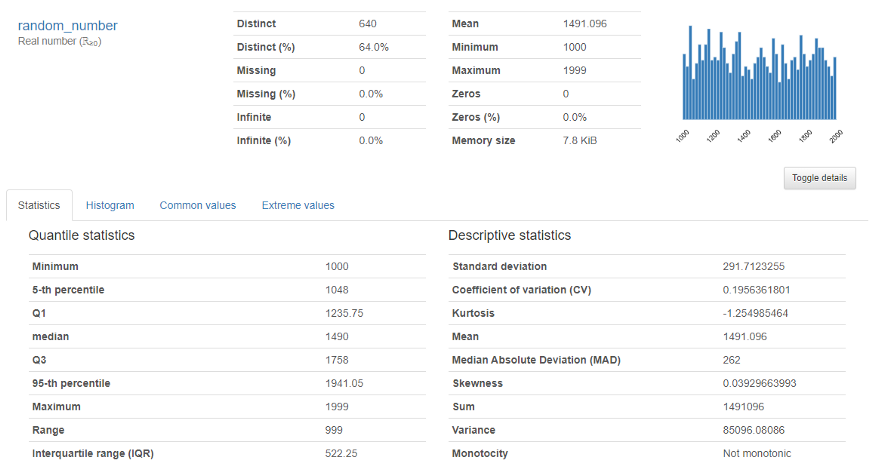
Fornece uma análise aprofundada de variáveis numéricas como quantis, meios de comunicação, soma, mediana, variância, monotonicidade, classificação, curtose, intervalo interquartílico e muito mais.
Correlações e interação: Descreve como as variáveis se correlacionam entre si através de. Estes dados são muito necessários para os cientistas de dados.
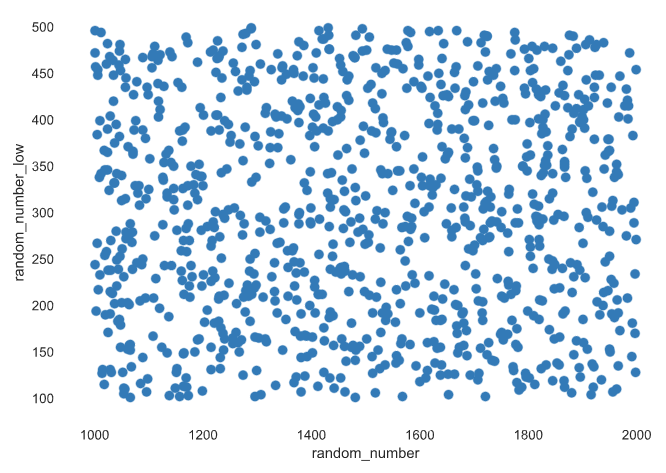
Para mais informacao, consulte a documentação oficial:
Sweetviz
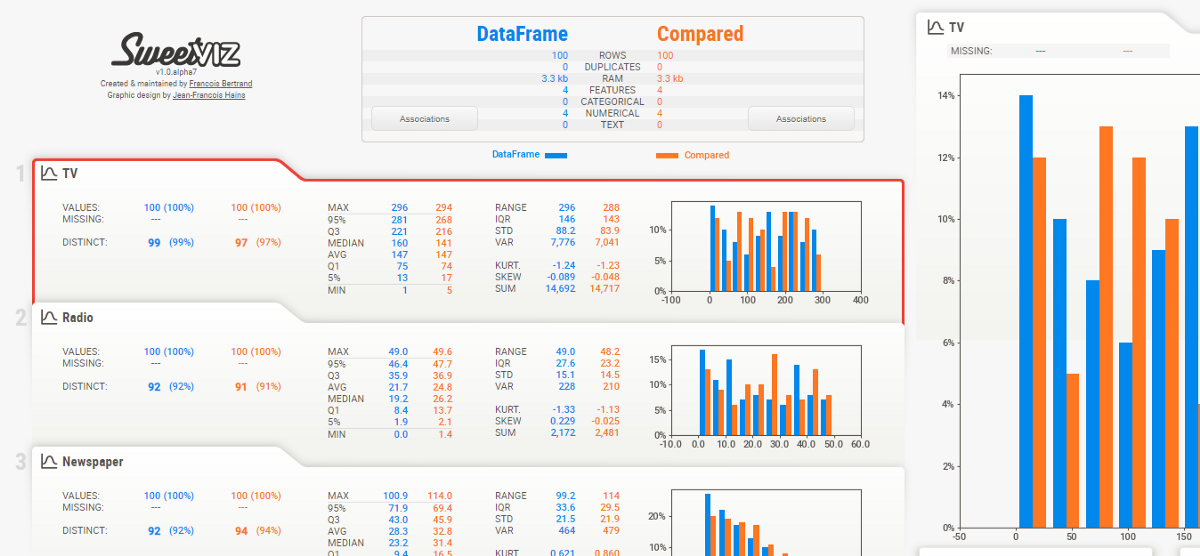
É uma biblioteca de Python de código aberto que se usava para obter visualizações, o que é útil na análise exploratória de dados com apenas algumas linhas de código. A biblioteca pode ser usada para visualizar as variáveis e comparar conjuntos de dados.
Instalação
Esta biblioteca pode ser instalada usando o seguinte código:
pip install sweetviz
Análisis de datos exploratorios con SweetViz
Profundicemos en el análisis de datos exploratorios utilizando esta biblioteca. Estoy usando un conjunto de datos de muestra para comenzar, verifique el siguiente código
import sweetviz
import pandas as pd
df = pd.read_csv('sample.csv')
my_report = sweetviz.analyze([df,'Train'], target_feat="SalePrice")
my_report.show_html('FinalReport.html')
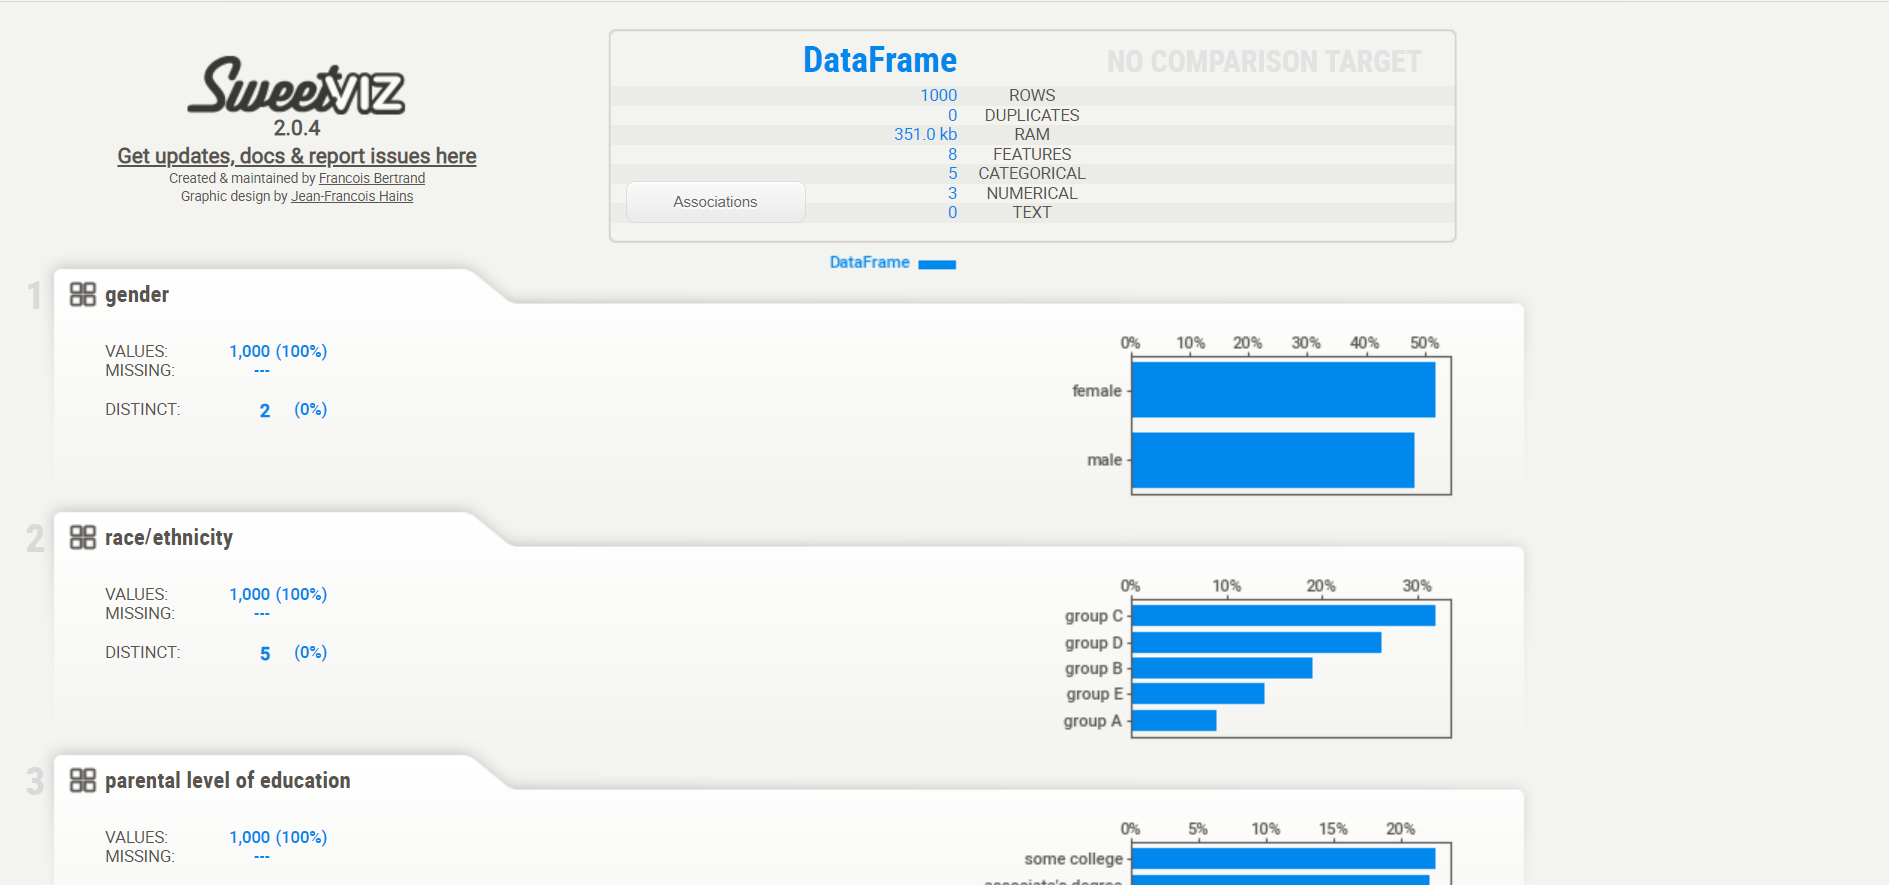
Reporte final:
Para mais informacao, consulte a documentação oficial:
Autoviz
Significa Visualizar automáticamente. La visualización es posible con cualquier tamaño del conjunto de datos con unas pocas líneas de código.
Instalação
pip instalar autoviz
Exibição
Código de muestra:
from autoviz.AutoViz_Class import AutoViz_Class
AV = AutoViz_Class()
df = AV. AutoViz('sample.csv')
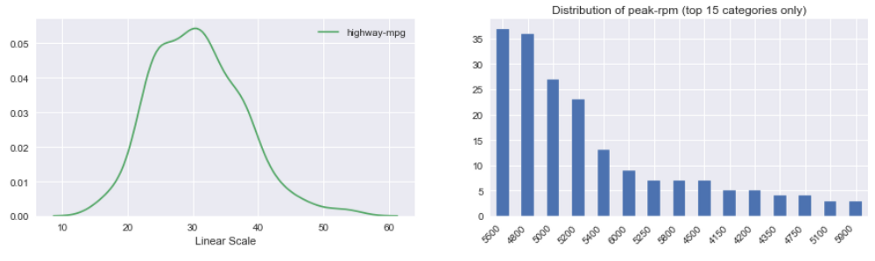
Histograma de variável contínua:
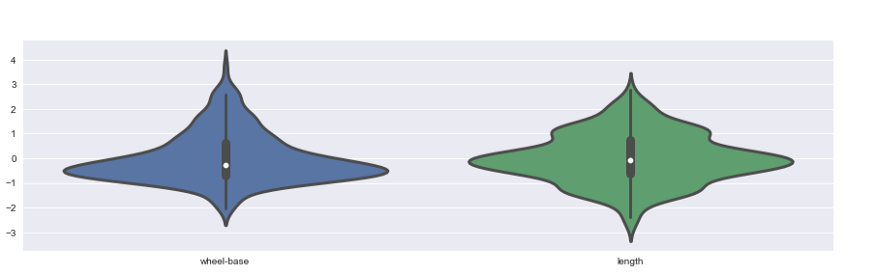
Armações de violino:
Mapa de caloruma "mapa de calor" é uma representação gráfica que usa cores para mostrar a densidade de dados em uma área específica. Comumente usado em análise de dados, Estudos de marketing e comportamentais, Esse tipo de visualização permite identificar padrões e tendências rapidamente. Através de variações cromáticas, Os mapas de calor facilitam a interpretação de grandes volumes de informações, ajudando a tomar decisões informadas....:
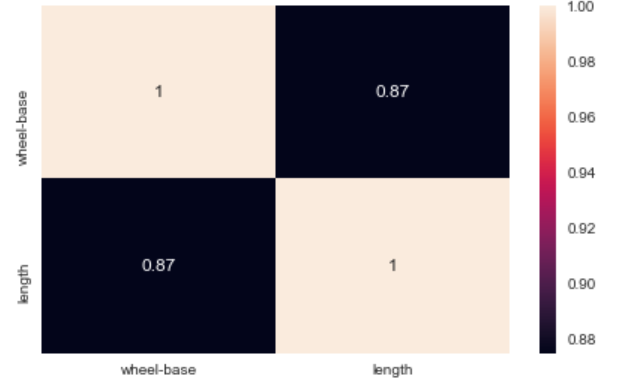
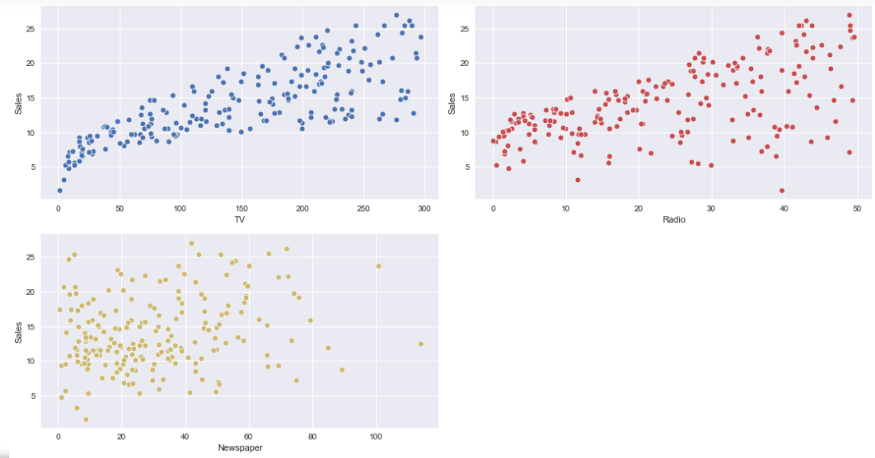
Gráfico de dispersãoUm gráfico de dispersão é uma representação visual que mostra a relação entre duas variáveis numéricas usando pontos em um plano cartesiano. Cada eixo representa uma variável, e a localização de cada ponto indica seu valor em relação a ambos. Esse tipo de gráfico é útil para identificar padrões, Correlações e tendências nos dados, facilitando a análise e interpretação de relações quantitativas....:
Para mais informacao, consulte a documentação oficial:
Obrigado por ler isso. se você gosta deste item, Compartilhe com seus amigos. Em caso de alguma sugestão / dúvida, Comente abaixo.
Identificação de e-mail: [e-mail protegido]
Me siga no LinkedIn: LinkedIn
A mídia mostrada neste artigo não é propriedade da DataPeaker e é usada a critério do autor.





