
Introdução
Por alguma razão, problemas de regressão e classificação acabam chamando a maior parte da atenção no mundo do aprendizado de máquina. As pessoas não percebem a grande variedade de problemas de aprendizado de máquina que podem existir.
A mim, por outro lado, Adoro explorar diferentes tipos de problemas e compartilhar meu aprendizado com a comunidade aqui.
Anteriormente, compartilhei minhas aprendizagens sobre algoritmos genéticos com a comunidade. Continuando com minha pesquisa, Pretendo cobrir um tópico que tem um problema muito menos difundido, mas é um problema persistente na comunidade de ciência de dados, qual é a classificação de várias tags.
Neste artigo, Vou lhe dar uma explicação intuitiva sobre o que a classificação multi-tag envolve, junto com uma ilustração de como resolver o problema. Espero que mostre o horizonte do que a ciência de dados abrange. Então vamos seguir em frente!
Tabela de conteúdo
- O que é classificação multi-tag?
- Multi-Class v / s Multi-rótulo
- Carregando e gerando vários conjuntos de dados de etiqueta
- Técnicas para resolver um problema de classificação de rótulo múltiplo
- Método de transformação do problema
- Método de algoritmo adaptado
- Abordagens de conjunto
- Estudos de caso
1. O que é classificação multi-tag?
Vamos dar uma olhada na imagem abaixo.
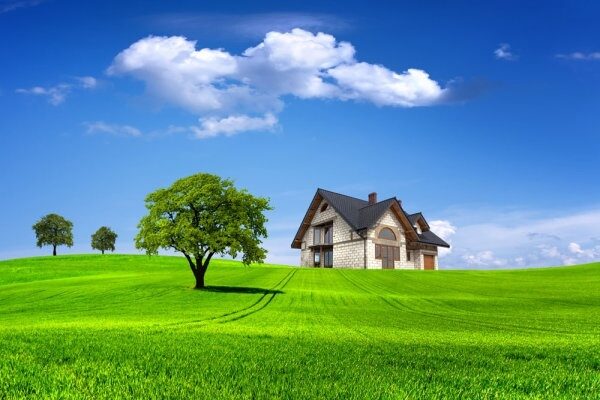
E se eu te perguntar se esta imagem contém uma casa? A opção será SIM o NÃO.
Considere outro caso, como todas as coisas (ou rótulos) são relevantes para esta imagem.
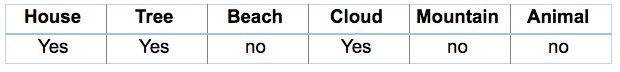
Esses tipos de problemas, onde temos um conjunto de variáveis de destino, são conhecidos como classificação de múltiplas tags problemas. Então, Há alguma diferença entre esses dois casos? Claramente, sim, porque no segundo caso, qualquer imagem pode conter um conjunto diferente dessas várias tags para imagens diferentes.
Mas antes de mergulhar nas várias tags, Eu só queria esclarecer uma coisa, muitos de vocês podem ficar confusos sobre como isso difere do problema de várias classes.
Então, vamos tentar entender a diferença entre esses dois conjuntos de problemas.
2. Multi-rótulo v / s multi-classe
Considere um exemplo para entender a diferença entre esses dois. Para isso, Espero que a imagem abaixo deixe as coisas bem claras. Vamos tentar entender isso.
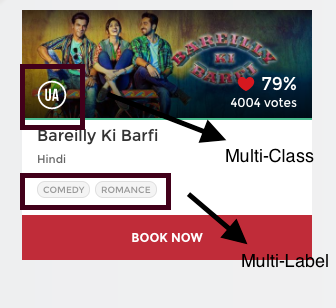
Para qualquer filme, o Conselho Central de Certificação de Filmes, emite um certificado com base no conteúdo do filme.
Por exemplo, se você olhar para cima, este filme foi classificado como 'VOCÊ / UMA’ (que significa 'supervisão parental para crianças menores de 12 anos’) certificado. Existem outros tipos de classes de certificado, como 'UMA’ (Restrito a adultos) o 'VOCÊ’ (Exibição pública irrestrita), mas é certo que cada filme só pode ser categorizado com apenas um desses três tipos de certificados.
Em resumo, existem várias categorias, mas a cada instância é atribuída apenas uma, portanto, esses problemas são conhecidos como classificação de múltiplas classes problema.
Novamente, se você olhar de volta para a foto, este filme foi categorizado no gênero de comédia e romance. Mas há uma diferença porque, desta vez, cada filme pode se enquadrar em um ou mais conjuntos de categorias diferentes.
Portanto, cada instância pode ser atribuída a várias categorias, é por isso que esses tipos de problemas são conhecidos como classificação de múltiplas tags problema, onde temos um conjunto de rótulos de destino.
Excelente! Agora você pode distinguir entre um problema com vários rótulos e várias classes. Então, vamos começar a lidar com esses tipos de problemas.
3. Carregando e gerando vários conjuntos de dados de etiqueta
Scikit-learn forneceu uma biblioteca separada scikit-multilearn para classificação de várias tags.
Para um melhor entendimento, vamos começar a praticar com um conjunto de dados multi-rótulo. Você pode encontrar um conjunto de dados do mundo real no repositório fornecido pelo pacote MULAN. Esses conjuntos de dados estão presentes no formato ARFF.
Então, para começar com qualquer um desses conjuntos de dados, olhe o código python abaixo para carregá-lo em seu notebook jupyter. Aqui eu baixei o conjunto de dados de levedura do repositório.
importar scipy
de scipy.io import arff
dados, meta = scipy.io.arff.loadarff('/Users/shubhamjain/Documents/yeast/yeast-train.arff')
df = pd.DataFrame(dados)
É assim que o conjunto de dados se parece.
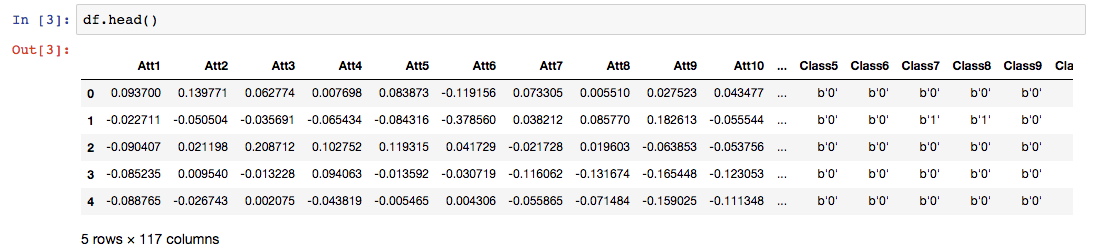
Aqui, Para representa os atributos ou variáveis independentes e Classe representa as variáveis alvo.
Para fins práticos, temos outra opção para gerar um conjunto de dados de múltiplas tags artificiais.
de sklearn.datasets import make_multilabel_classification

# isso irá gerar um conjunto de dados multi-rótulo aleatório
X, y = make_multilabel_classification(esparso = verdadeiro, n_labels = 20,
return_indicator ="escasso", allow_unlabeled = False)
Vamos entender os parâmetros usados acima.
escasso: É verdade, retorna uma matriz esparsa, onde matriz esparsa significa uma matriz que possui um grande número de elementos zero.
n_labels: O número médio de rótulos em cada instância.
return_indicator: E 'escasso’ Retornar E em formato de indicador binário esparso.
allow_unlaoted: E Certo, algumas instâncias podem não pertencer a nenhuma classe.
Você deve ter notado que usamos uma matriz esparsa em todos os lugares, e scikit-multilearn também recomenda o uso de dados esparsos porque é muito raro um conjunto de dados do mundo real ser denso. Geralmente, o número de rótulos atribuídos a cada instância é muito menor.
Nós vamos, agora temos nossos conjuntos de dados prontos, então, vamos aprender rapidamente técnicas para resolver o problema de várias tags.
4. Técnicas para resolver um problema de classificação de rótulo múltiplo
Basicamente, existem três métodos para resolver um problema de classificação de múltiplos rótulos, a saber:
- Transformação de problema
- Algoritmo adaptado
- Abordagens de conjunto
4.1 Transformação de problema
Neste método, vamos tentar transformar nosso problema de rótulo múltiplo em problema de rótulo único.
Este método pode ser feito de três maneiras diferentes, como:
- Relevância binária
- Correntes de classificação
- Rótulo Powerset
4.1.1 Relevância binária
Esta é a técnica mais simples, que basicamente trata cada tag como um problema de classificação de classe única separada.
Por exemplo, vamos considerar um caso como mostrado abaixo. Temos o conjunto de dados como este, onde X é a característica independente e Y é a variável alvo.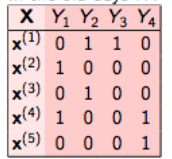
Em relevância binária, este problema é dividido em 4 diferentes problemas de classificação de classe única, como mostrado na figura abaixo.
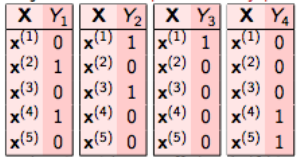
Não temos que fazer isso manualmente, a biblioteca multi-aprendizagem fornece sua implementação em Python. Então, vamos ver rapidamente sua implementação nos dados gerados aleatoriamente.
# usando relevância binária
de skmultilearn.problem_transform import BinaryRelevance
de sklearn.naive_bayes import GaussianNB

# inicializar classificador multi-rótulo de relevância binária
# com um classificador de base gaussian ingênuo bayes
classificador = BinaryRelevance(GaussianNB())

# Comboio
classifier.fit(X_train, y_train)

# prever
predictions = classifier.predict(X_test)
NOTA: Aqui, usamos o algoritmo Naive Bayes, mas você pode usar qualquer outro algoritmo de classificação.
Agora, em um problema de classificação de múltiplas tags, não podemos apenas usar nossas métricas normais para calcular a precisão de nossas previsões. Para aquele propósito, usaremos pontuação de precisão métrico. Esta função calcula a precisão do subconjunto, o que significa que o conjunto previsto de rótulos deve corresponder exatamente ao verdadeiro conjunto de rótulos.
Então, vamos calcular a precisão das previsões.
de sklearn.metrics import precision_score
precisão_pontuação(y_test,previsões)
Por tanto, obtivemos uma pontuação de precisão de 45%, isso não é tão ruim. Vamos ver rapidamente seus prós e contras.
É o método mais simples e eficiente, pero el único inconveniente de este método es que no considera la correlación de etiquetas porque trata cada variávelEm estatística e matemática, uma "variável" é um símbolo que representa um valor que pode mudar ou variar. Existem diferentes tipos de variáveis, e qualitativo, que descrevem características não numéricas, e quantitativo, representando quantidades numéricas. Variáveis são fundamentais em experimentos e estudos, uma vez que permitem a análise de relações e padrões entre diferentes elementos, facilitando a compreensão de fenômenos complexos.... de destino de forma independiente.
4.1.2 Correntes de classificação
Nisto, o primeiro classificador é treinado apenas nos dados de entrada e, em seguida, cada classificador subsequente é treinado no espaço de entrada e todos os classificadores anteriores na cadeia.
Vamos tentar entender isso com um exemplo. No conjunto de dados mostrado abaixo, temos X como espaço de entrada e Y como rótulos.
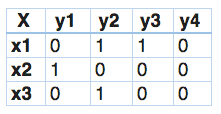
Em cadeias classificadoras, este problema se tornaria 4 diferentes problemas de tag única, como é mostrado a seguir. Aqui, a cor amarela é o espaço de entrada e a parte branca representa a variável alvo.
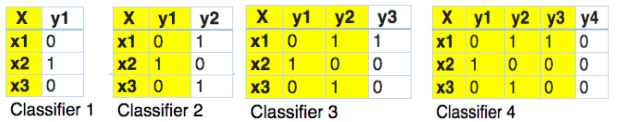
Isso é bastante semelhante à relevância binária, a única diferença é que ele forma strings para preservar o mapeamento do rótulo. Então, vamos tentar implementar isso usando a biblioteca multi-aprendizagem.
# usando cadeias classificadoras
de skmultilearn.problem_transform import ClassifierChain
de sklearn.naive_bayes import GaussianNB

# inicializar cadeias de classificador classificador multi-rótulo
# com um classificador de base gaussian ingênuo bayes
classifier = ClassifierChain(GaussianNB())

# Comboio
classifier.fit(X_train, y_train)

# prever
predictions = classifier.predict(X_test)

precisão_pontuação(y_test,previsões)
0.21212121212121213
Podemos ver que usando isso, obtivemos uma precisão de aproximadamente 21%, que é muito menos do que binário Relevância. Isso pode ser devido à ausência de correlação de tag, uma vez que geramos os dados aleatoriamente.
4.1.3 Rótulo Powerset
Nisto, transformamos o problema em um problema de várias classes com um classificador de várias classes treinado em todas as combinações de rótulos exclusivas encontradas nos dados de treinamento.
Vamos entender com um exemplo.
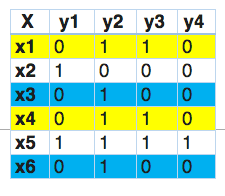
Nisto, descobrimos que x1 e x4 têm os mesmos rótulos, de forma similar, x3 e x6 têm o mesmo conjunto de rótulos. Portanto, o conjunto de alimentação de etiquetas transforma este problema em um único problema de várias classes, como é mostrado a seguir.
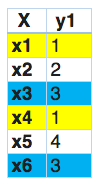
Portanto, rótulo powerset deu uma classe única para cada combinação de rótulo possível que está presente no conjunto de treinamento.
Vamos ver sua implementação em Python.
# usando Label Powerset
de skmultilearn.problem_transform import LabelPowerset
de sklearn.naive_bayes import GaussianNB

# inicializar o classificador multi-rótulo do Label Powerset
# com um classificador de base gaussian ingênuo bayes
classifier = LabelPowerset(GaussianNB())

# Comboio
classifier.fit(X_train, y_train)

# prever
predictions = classifier.predict(X_test)

precisão_pontuação(y_test,previsões)
0.5757575757575758
Isso nos dá a maior precisão entre os três que discutimos até agora.. A única desvantagem disso é que à medida que os dados de treinamento aumentam, aumentar o número de aulas. Portanto, aumenta a complexidade do modelo e levaria a menos precisão.
Agora, Vejamos o segundo método para resolver o problema de classificação de vários rótulos.
4.2 Algoritmo adaptado
Algoritmo adaptado, como o nome sugere, adaptar o algoritmo para realizar diretamente a classificação de vários rótulos, em vez de transformar o problema em diferentes subconjuntos de problemas.
Por exemplo, a versão multi-tag de kNN é representada por MLkNN. Então, vamos implementar isso rapidamente em nosso conjunto de dados gerado aleatoriamente.
de skmultilearn.adapt import MLkNN

classificador = MLkNN(k = 20)

# Comboio
classifier.fit(X_train, y_train)

# prever
predictions = classifier.predict(X_test)

precisão_pontuação(y_test,previsões)
0.69
Excelente! Alcançou uma pontuação de precisão de 69% em seus dados de teste.
Sci-kit learn fornece suporte integrado de classificação de várias tags em alguns dos algoritmos como Random Forest e Ridge regression. Portanto, pode chamá-los diretamente e prever a saída.
Você pode verificar o biblioteca de aprendizagem múltipla para obter mais informações sobre outros tipos de algoritmos personalizados.
4.3 Abordagens de conjunto
Ensemble sempre produz melhores resultados. A biblioteca Scikit-Multilearn oferece diferentes funções de classificação de conjuntos, que você pode usar para obter melhores resultados.
Para implementação direta, você pode consultar aqui.
5. Estudos de caso
Vários problemas de classificação de tag são muito comuns no mundo real. Então, vamos dar uma olhada em algumas das áreas onde podemos encontrar uso deles.
1. Categorização de áudio
Já vimos músicas classificadas em diferentes gêneros. Eles também são classificados com base em emoções ou humores como “calma relaxante”, “tristeza-solidão”, etc.
Fonte: Ligação
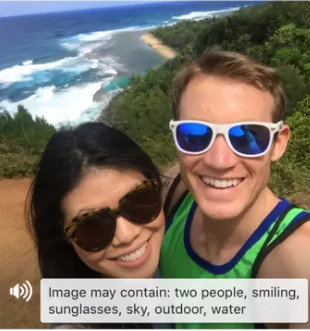
2. Categorização de imagem
A classificação de vários rótulos usando imagens também possui uma ampla gama de aplicações. As imagens podem ser rotuladas para indicar diferentes objetos, pessoas ou conceitos.
3. Bioinformática
A classificação de múltiplos rótulos é amplamente utilizada no campo da bioinformática, por exemplo, a classificação de genes no conjunto de dados de levedura.
Ele também é usado para prever várias funções de proteínas usando várias proteínas não marcadas.. Você pode verificar isso papel para mais informacao.
4. Categorização do texto
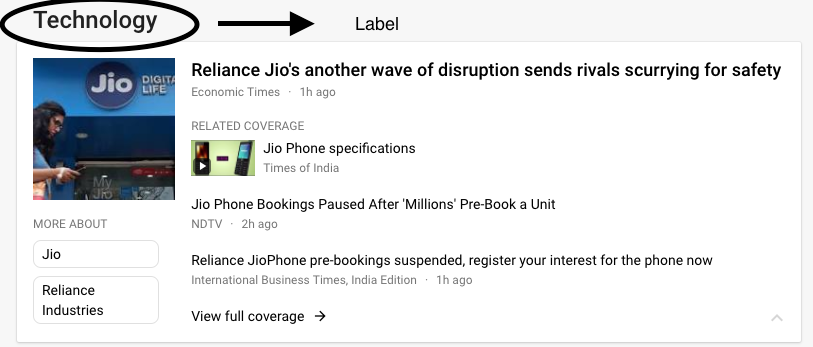
Todos deveriam verificar as notícias do Google uma vez. Então, o que o Google Notícias faz é marcar todas as notícias em uma ou mais categorias para que sejam exibidas em diferentes categorias. Por exemplo, Olhe para a foto abaixo.
Fonte da imagem: notícias do Google
Essa mesma notícia está presente nas categorias da Índia, Tecnologia, Últimas, etc. porque foi classificado nesses rótulos diferentes. Portanto, é um problema de classificação de múltiplas tags.
Existem muitas outras áreas, então explore e comente abaixo se quiser compartilhar com a comunidade.
6. Notas finais
Neste artigo, apresentou a você o conceito de vários problemas de classificação de tag. Também cobri abordagens para resolver este problema e casos de uso práticos em que você pode precisar lidar com isso usando a biblioteca de multi-aprendizagem em Python.
Espero que este artigo dê a você uma vantagem quando você se depara com esses tipos de problemas. Se você tiver alguma dúvida / sugestão, Sinta-se à vontade para entrar em contato comigo abaixo!





