
Este artigo foi publicado como parte do Data Science Blogathon
C
- Este artigo dará-lhe uma compreensão básica de como funciona a análise de texto.
- Conheça os diferentes passos do processo de PLN
- Derivação do sentimento geral do texto.
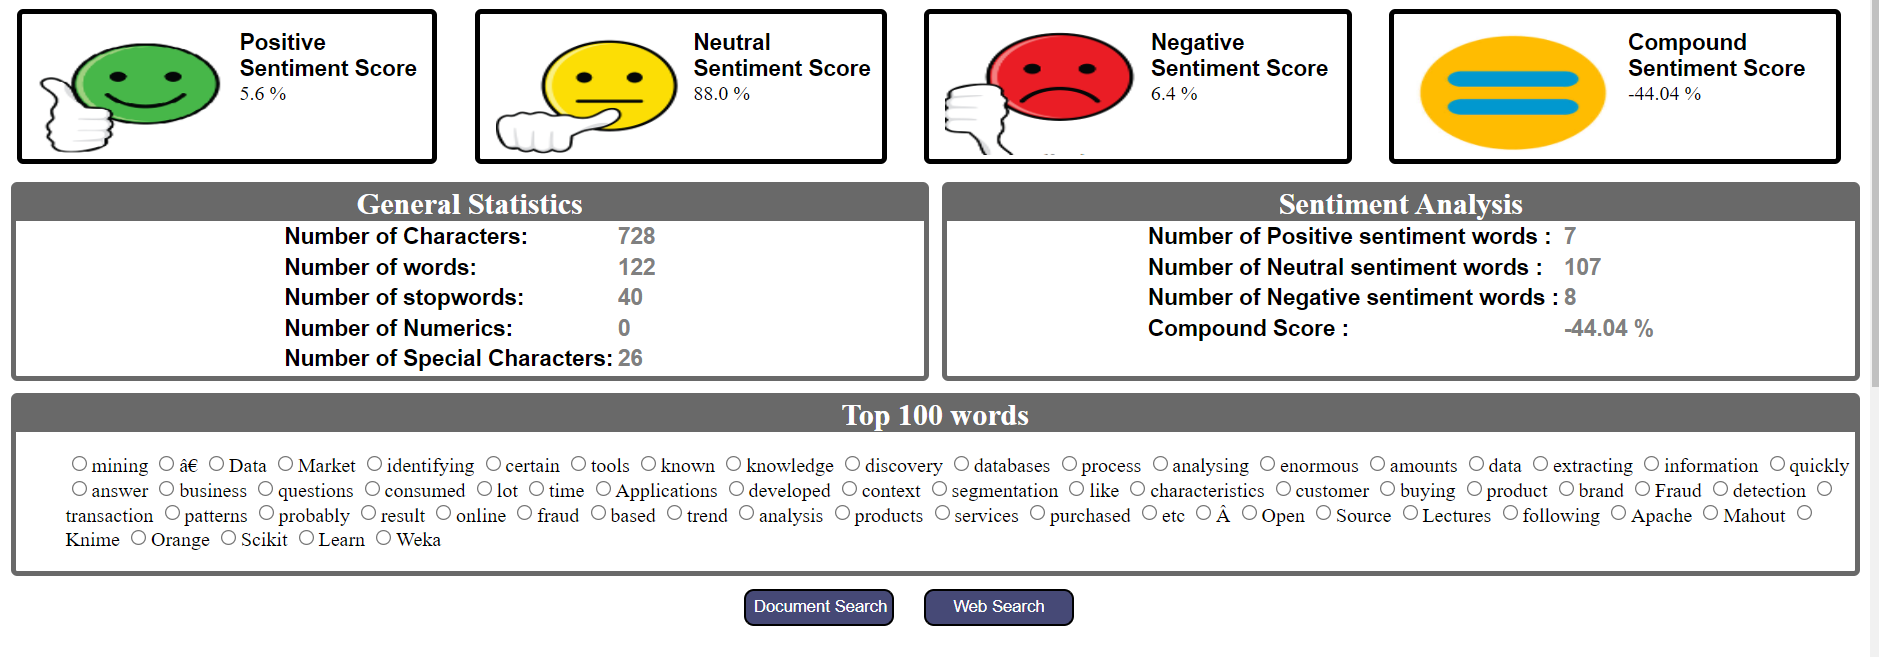
- Painel que mostra as estatísticas gerais e a análise de sentimentos do texto.
Resumo
Nesta era digital moderna, gera-se uma grande quantidade de informação por segundo. A maioria dos dados que os humanos geram através de mensagens, tweets, blogs, novos artigos, recomendações de produtos e críticas no WhatsApp não estão estruturados. Então, Para obter informações úteis destes dados altamente desestruturados, primeiro devemos convertê-los em forma estruturada e normalizada.
Processamento de linguagem natural (PNL) es una clase de inteligencia artificial que realiza una serie de procesos sobre estos datos no estructurados para obtener información significativa. El procesamiento del lenguaje es de naturaleza completamente no determinista porque el mismo lenguaje puede tener diferentes interpretaciones. Se vuelve tedioso porque algo adecuado para una persona no es adecuado para otra. O que mais, el uso de lenguaje coloquial, acrónimos, hashtags con palabras adjuntas, emoticonos posee una sobrecarga para su preprocesamiento.
Si le interesa el poder de la analíticaAnalytics refere-se ao processo de coleta, Meça e analise dados para obter insights valiosos que facilitam a tomada de decisões. Em vários campos, como negócio, Saúde e esporte, A análise pode identificar padrões e tendências, Otimize processos e melhore resultados. O uso de ferramentas avançadas e técnicas estatísticas é essencial para transformar dados em conhecimento aplicável e estratégico.... de redes sociais, este artículo es el punto de partida para usted. Este artigo cobre os conceitos básicos de análise de texto e fornece um tutorial passo a passo para realizar o processamento de linguagem natural sem necessidade de qualquer conjunto de dados TreinamentoO treinamento é um processo sistemático projetado para melhorar as habilidades, Conhecimento ou habilidades físicas. É aplicado em várias áreas, como esporte, Educação e desenvolvimento profissional. Um programa de treinamento eficaz inclui planejamento de metas, prática regular e avaliação do progresso. A adaptação às necessidades individuais e a motivação são fatores-chave para alcançar resultados bem-sucedidos e sustentáveis em qualquer disciplina.....
Introdução à PLN
O processamento de linguagem natural é o subcampo da inteligência artificial que compreende processos sistemáticos para converter dados não estruturados em informação significativa e extrair conhecimentos úteis a partir deles. A PLN é ainda classificada em duas categorias principais: PLN baseada em regras e PLN estatística. A PLN baseada em regras utiliza um raciocínio básico para processar tarefas, portanto é necessário um esforço manual sem muito treino com o conjunto de dados. A PLN estatística, por outro lado, entrena una gran cantidad de datos y obtiene información a partir de ellos. Utiliza algoritmos de aprendizaje automático para entrenar el mismo. Neste artigo, aprenderemos la PNL basada en reglas.
Aplicativos de PNL:
- Resumo do texto
- Máquina tradutora
- Sistemas de preguntas y respuestas
- Revisiones ortográficas
- autocompletar
- Análise de sentimentos
- Reconhecimento de voz
- SegmentaçãoA segmentação é uma técnica de marketing chave que envolve a divisão de um mercado amplo em grupos menores e mais homogêneos. Essa prática permite que as empresas adaptem suas estratégias e mensagens às características específicas de cada segmento, melhorando assim a eficácia de suas campanhas. A segmentação pode ser baseada em critérios demográficos, psicográfico, geográfico ou comportamental, facilitando uma comunicação mais relevante e personalizada com o público-alvo.... de temas
Canalización de PNL:
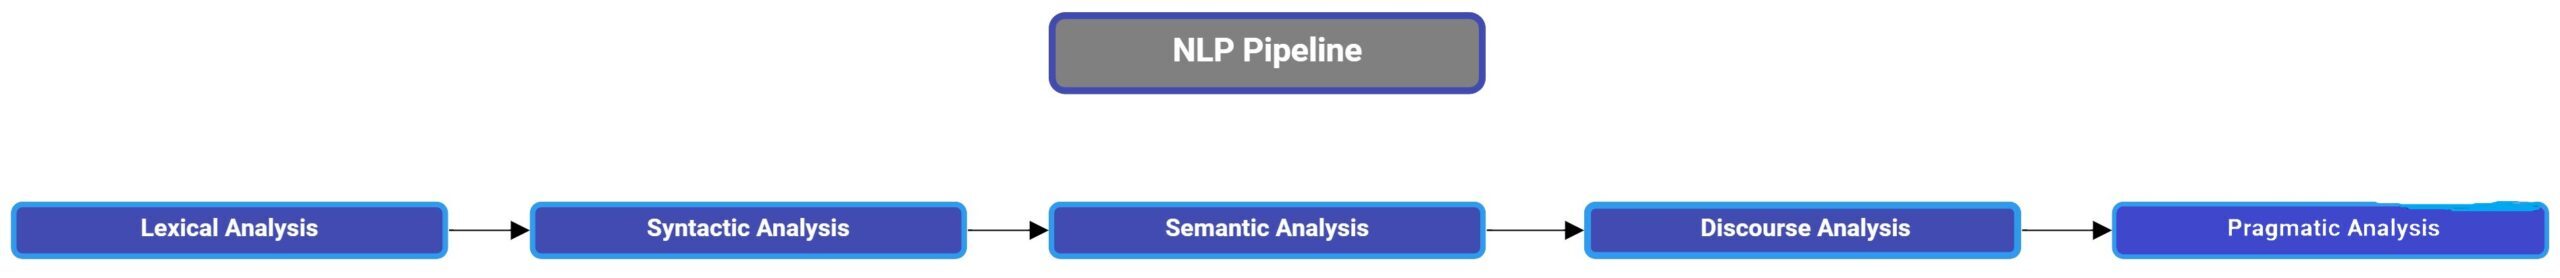
La canalización de PNL se divide en cinco subtareas:
1. Análisis léxico: El análisis léxico es el proceso de analizar la estructura de palabras y frases presentes en el texto. El léxico se define como el fragmento identificável más pequeño del texto. Podría ser una palabra, frase, etc. Implica identificar y dividir todo el texto en oraciones, párrafos y palabras.
2. Análise sintática: A análise sintática é o processo de organizar as palavras de uma forma que mostre a relação entre elas. Implica analisá-las em busca de padrões gramaticais. Por exemplo, a frase “A universidade vai para a menina”. é rejeitada pelo analisador sintático.
3. Análise semântica: A análise semântica é o processo de analisar o texto para determinar o seu significado. Considera estruturas sintáticas para mapear os objetos no domínio da tarefa. Por exemplo, a frase “Quer comer gelado quente” é rejeitada pelo analisador semântico.
4. Integração da divulgação: A integração da divulgação é o processo de estudar o contexto do texto. As frases estão organizadas numa ordem significativa para formar um parágrafo, o que significa que a frase anterior a uma frase em particular é necessária para compreender o significado geral. O que mais, a frase que segue a frase depende da anterior.
5. Análise pragmática: A análise pragmática é definida como o processo de reconfirmar que o que o texto realmente significava é o mesmo que o derivado.
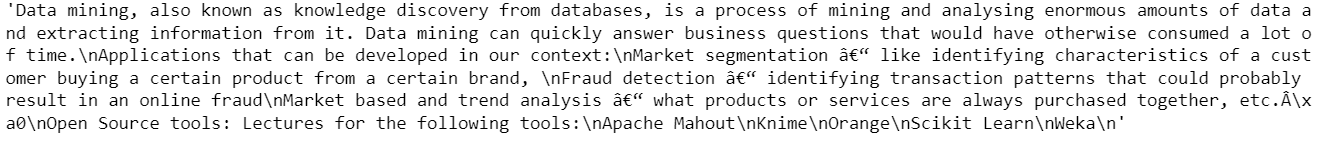
Lendo o ficheiro de texto:
filename = "C:UsersDellDesktopexample.txt"
text = open(nome do arquivo, "r").leitura()
Imprimir o texto:
imprimir(texto)
Instalação da biblioteca para PLN:
Usaremos a biblioteca spaCy para este tutorial. espaço é uma biblioteca de software de código aberto para PLN avançada escrita nas linguagens de programação Python e Cython. A biblioteca é publicada sob uma licença MIT. Ao contrário do NLTK, que se usa ampliamente para la enseñanza y la investigación, spaCy se enfoca en proporcionar software para uso en producción. spaCy también admite flujos de trabajo de aprendizado profundoAqui está o caminho de aprendizado para dominar o aprendizado profundo em, Uma subdisciplina da inteligência artificial, depende de redes neurais artificiais para analisar e processar grandes volumes de dados. Essa técnica permite que as máquinas aprendam padrões e executem tarefas complexas, como reconhecimento de fala e visão computacional. Sua capacidade de melhorar continuamente à medida que mais dados são fornecidos a ele o torna uma ferramenta fundamental em vários setores, da saúde... que permiten conectar modelos estadísticos entrenados por bibliotecas de aprendizaje automático populares como TensorFlow, Pytorch a través de su propia biblioteca de aprendizaje automático Thinc.[Wikipedia]
pip install -U pip setuptools wheel
pip install -U spacy
Ya que estamos tratando con el idioma inglés. Entonces necesitamos instalar el en_core_web_sm paquete para ello.
python -m spacy download en_core_web_sm
Verificando que la descarga fue exitosa e importando el paquete spacy:
import spacy
nlp = spacy.load('en_core_web_sm')
Después de la creación exitosa del objeto NLP, podemos pasar al preprocesamiento.
Tokenización:
A tokenização é o processo de converter todo o texto numa série de palavras conhecidas como tokens. Este é o primeiro passo em qualquer processo de PLN. Divide todo o texto em unidades significativas.
text_doc = nlp(texto)
imprimir ([token.text para token em text_doc])
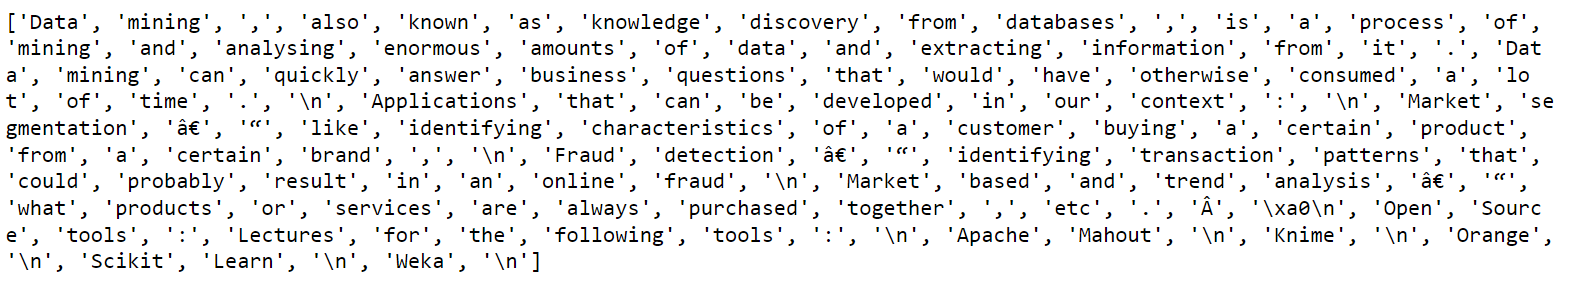
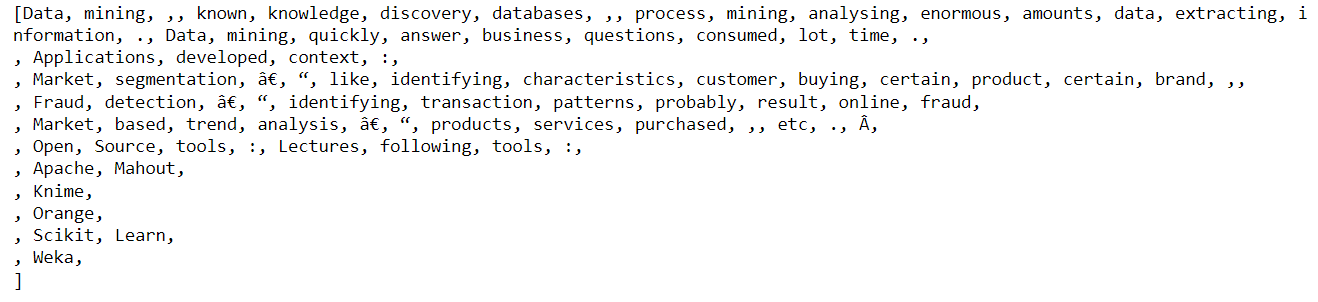
Como podemos observar nos tokens, há muitos espaços em branco, vírgulas, palavras irrelevantes que não servem para nada do ponto de vista da análise.
Identificação da frase
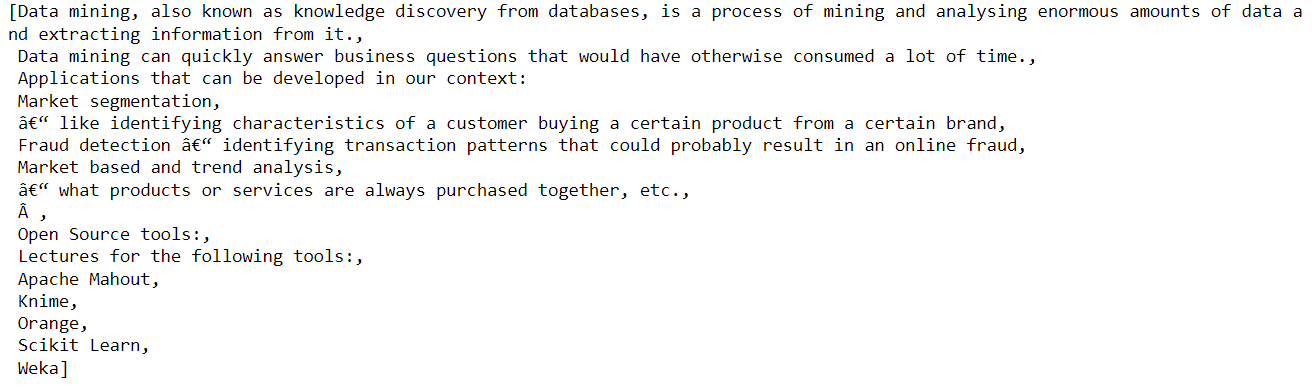
Identificar as frases do texto é útil quando queremos estruturar partes significativas do texto que ocorrem juntas. Por isso é útil encontrar frases.
about_doc = nlp(about_text)
sentences = list(about_doc.sents)
Removendo palavras irrelevantes
As palavras irrelevantes são definidas como palavras que aparecem frequentemente na linguagem. Eles não têm um papel significativo na análise de texto e dificultam a análise de Distribuição de frequênciaA distribuição de frequência é uma ferramenta estatística que organiza e resume os dados em intervalos ou categorias, facilitando sua análise. Permite visualizar com que frequência diferentes valores ocorrem em um conjunto de dados, por meio de tabelas ou gráficos. Essa técnica é fundamental na estatística descritiva, pois ajuda a identificar padrões, Tendências e dispersão de dados, apoiando a tomada de decisão informada..... Por exemplo, a, uma, uma, o, etc. Portanto, devem ser removidos do texto para obter uma imagem mais clara do texto.
texto_normalizado = [token por token em text_doc se não token.is_stop]
imprimir (texto_normalizado)
Eliminação de pontuação:
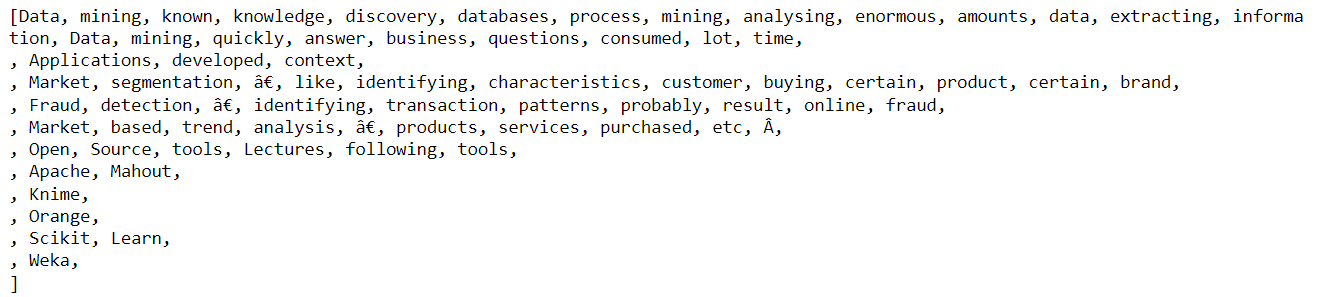
Como podemos ver no resultado anterior, existem sinais de pontuação que não nos servem. Então vamos eliminá-los.
texto_limpo = [token por token em texto_normalizado se não token.is_punct]
imprimir (clean_text)
Lematización:
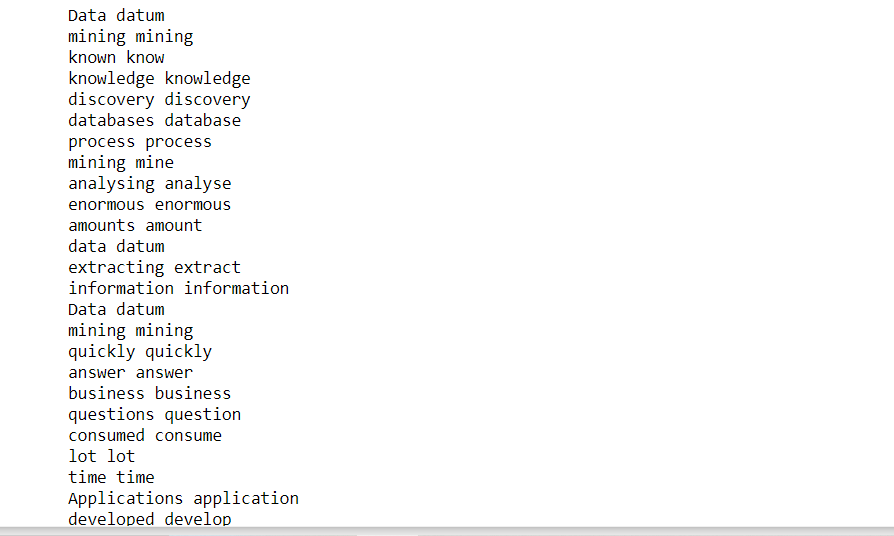
A lematização é o processo de reduzir uma palavra à sua forma original. Lema é uma palavra que representa um grupo de palavras chamadas lexemas. Por exemplo: participar, participar, participar. Todos se reduzem a um lema comum, quer dizer, participar.
para token em texto_limpo:
imprimir (símbolo, token.lemma_)
Contagem de frequência de palavras:
Realicemos ahora un análisis estadístico del texto. Encontraremos las diez primeras palabras según su frecuencia en el texto.
from collections import Counter
words = [token.text for token in clean_text if not token.is_stop and not token.is_punct]
word_freq = Counter(palavras)
# 10 commonly occurring words with their frequencies
common_words = word_freq.most_common(10)
imprimir (common_words)

Análise de sentimentos
El análisis de sentimiento es el proceso de analizar el sentimiento del texto. Una forma de hacerlo es a través de la polaridad de las palabras, ya sean positivas o negativas.
VADER (Valence Aware Dictionary and Sentiment Reasoner) es una biblioteca de análisis de sentimientos basada en reglas y léxico en Python. Utiliza una serie de léxicos de sentimientos. Um léxico de sentimento é uma série de palavras que são atribuídas às suas respetivas polaridades, quer dizer, Positivo, negativa e neutra de acordo com o seu significado semântico.
Por exemplo:
1. Palavras como bom, excelente, incrível, fantástico são de polaridade positiva.
2. Palavras como mau, pior, patético são de polaridade negativa.
O analisador de sentimentos VADER encontra as percentagens de palavras de diferentes polaridades e dá pontuações de polaridade de cada uma delas respetivamente. A saída do analisador é pontuada de 0 uma 1, que se pode converter em percentagens. Não fala apenas das pontuações de positividade ou negatividade, mas também do quão positivo ou negativo é um sentimento.
Primeiro, vamos descarregar o pacote usando pip.
pip install vaderSentiment
Mais tarde, analise as pontuações de sentimento.
from vaderSentiment.vaderSentiment import SentimentIntensityAnalyzer
analyzer = SentimentIntensityAnalyzer()
vs = Analyzer.polarity_scores(texto)
vs

PainelUm painel é um grupo de especialistas que se reúne para discutir e analisar um tópico específico. Esses fóruns são comuns em conferências, Seminários e debates públicos, onde os participantes compartilham seus conhecimentos e perspectivas. Os painéis podem abordar uma variedade de áreas, Da ciência à política, e seu objetivo é incentivar a troca de ideias e a reflexão crítica entre os participantes.... de control del analizador de texto
Los pasos anteriores se pueden resumir para crear un tablero para el analizador de texto. Incluye la cantidad de palabras, la cantidad de caracteres, la cantidad de números, las N palabras principales, la intención del texto, la opinión general, la puntuación de la opinión positiva, la pontuação de la opinión negativa, la puntuación de la opinión neutral y el recuento de palabras de la opinión.
conclusão
La PNL ha tenido un gran impacto en campos como el análisis de reseñas de productos, recomendações, Análise de Redes Sociais, traducción de texto y, portanto, ha obtenido enormes benefícios para las grandes empresas.
Espero que este artículo le ayude a comenzar su viaje en el campo de la PNL.
E finalmente, … Não precisa dizer,
Obrigado pela leitura!
A mídia mostrada neste artigo não é propriedade da DataPeaker e é usada a critério do autor.





