
Introdução
O GraphLab representou um avanço inesperado no meu plano de aprendizagem. Depois de tudo, ‘Coisas boas acontecem quando se espera menos que aconteçam’. Tudo começou com o final de Hack de dados da Black Friday. De 1200 participantes, tivemos os nossos vencedores e as suas soluções interessantes.
Li-as e analisei-as. Percebi que tinha perdido uma ferramenta incrível de aprendizado de máquina. Uma exploração rápida disse-me que esta ferramenta tem um imenso potencial para reduzir as nossas dificuldades no modelamento de aprendizado de máquina. Então, decidi explorá-la mais a fundo. Agora dediquei alguns dias a compreender a sua ciência e os seus métodos lógicos de utilização. Para minha surpresa, não foi difícil de entender.
Estavas a tentar melhorar o teu modelo de aprendizagem automática? Mas falhou na maioria das vezes? Experimenta esta ferramenta avançada de aprendizagem automática. Um mês de teste é gratuito e a assinatura de 1 ano está disponível GRATUITAMENTE para uso académico. Mais tarde, podes comprar uma assinatura para os anos seguintes.
Para começar rapidamente, aqui está um guia para principiantes sobre GraphLab em Python. Para facilitar a compreensão, tentei explicar estes conceitos da forma mais simples possível.
tópicos abordados
- Como começou tudo ?
- O que é o GraphLab?
- Benefícios e limitações do GraphLab
- Como instalar o GraphLab?
- Começando com o GraphLab
Como começou tudo ?
O GraphLab tem uma história interessante desde os seus primórdios. Deixa-me contar-te brevemente.
GraphLab, conhecido como Dato, foi fundado por Carlos Guestrin. Carlos tem um doutoramento em Ciências da Computação pela Universidade de Stanford. Aconteceu há alguns 7 anos. O Carlos era professor na Universidade Carnegie Mellon. Dois dos seus estudantes estavam a trabalhar em algoritmos de aprendizagem automática distribuída em larga escala. Executaram o seu modelo sobre Hadoop e descobriram que demorava bastante tempo a calcular. As situações nem melhoraram depois de utilizar MPI (biblioteca informática de alto desempenho).
Então, decidiram construir um sistema para escrever artigos mais rapidamente. Com isto, Nasceu o GraphLab.
PD – GraphLab Create é um software comercial da GraphLab. Aceda-se ao GraphLab Create em Python usando a biblioteca “graphlab”. Portanto, neste artigo, ‘GraphLab’ conota o GraphLab Create. Não se confunda.
O que é o GraphLab?
GraphLab es un nuevo marco paralelo para el aprendizaje automático escrito en C ++. Es un proyecto de código abierto y ha been diseñado considerando la escala, variedad y complejidad de los datos del mundo real. Incorpora vários algoritmos de alto nível como Stochastic Gradient Descent (SGD), Gradient Descent & Locking para ofrecer una experiencia de alto rendimiento. Ayuda a los científicos y desarrolladores de datos a crear e instalar facilmentemente aplicaciones a gran escala.
Mas, ¿qué lo hace asombroso? Es la presencia de bibliotecas ordenadas para la transformación, manipulación y visualización de modelos de datos. O que mais, se compone de kits de herramientas de aprendizaje automático escalables que tienen todo (quase) necesario para mejorar los modelos de aprendizaje automático. O kit de ferramentas inclui implementação para aprendizado profundoAqui está o caminho de aprendizado para dominar o aprendizado profundo em, Uma subdisciplina da inteligência artificial, depende de redes neurais artificiais para analisar e processar grandes volumes de dados. Essa técnica permite que as máquinas aprendam padrões e executem tarefas complexas, como reconhecimento de fala e visão computacional. Sua capacidade de melhorar continuamente à medida que mais dados são fornecidos a ele o torna uma ferramenta fundamental em vários setores, da saúde..., máquinas de fatores, modelagem de tema, agrupamento, vizinhos mais próximos e mais.
Aqui está a arquitetura completa do GraphLab Create.
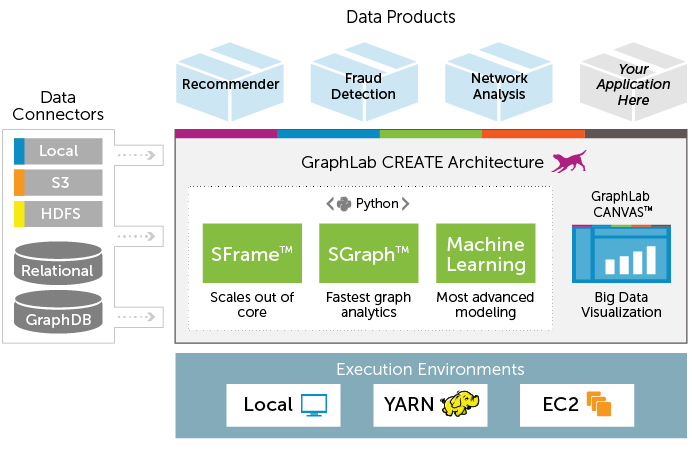
Quais são os benefícios de usar o GraphLab?
Existem múltiplos benefícios em usar o GraphLab, conforme descrito abaixo:
- Gerencia grandes volumes de dados: A estrutura de dados do GraphLab pode lidar com grandes conjuntos de dados, resultando em aprendizagem automática escalável. Vamos ver a estrutura de dados do GraphLab:
-
- SFrame: É uma estrutura de dados tabular baseada em disco eficiente que não é limitada pela RAM. Ajuda a escalar a análise e o processamento de dados para lidar com grandes conjuntos de dados (Terabyte), mesmo no seu computador portátil. Tem uma sintaxe semelhante à do pandas ou dos data frames R. Cada coluna é uma SArray, que é uma série de elementos armazenados no disco. Isto faz com que os SFrames se baseiem no disco. Discuta os métodos para trabalhar com 'SFrames' nas secções seguintes.
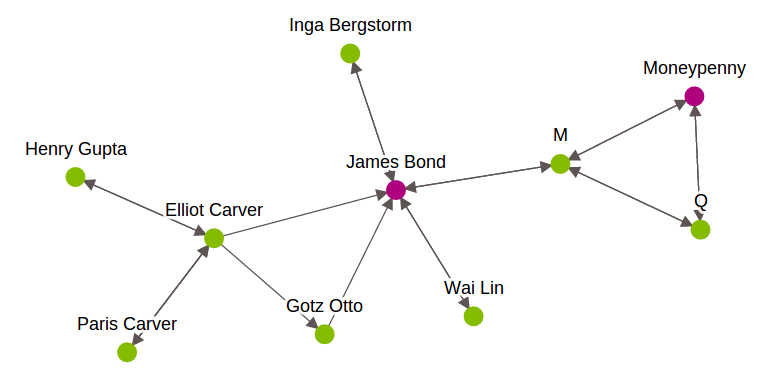
- SGraph: Graph ajuda-nos a compreender redes ao analisar as relações entre pares de elementos. Cada artigo está representado por um vértice no gráfico. A relação entre elementos está representada por arestas. No GraphLab, para realizar uma análise de dados orientada a grafos, usa SGraph objeto. É uma estrutura de dados de grafo escalável que armazena vértices e arestas em SFrames. Para saber mais sobre isso, consulte este Ligação. A seguir está uma representação gráfica das personagens de James Bond.
-
- Integração com várias fontes de dados: O GraphLab suporta várias fontes de dados como S3, ODBC, JSONJSON, o Notação de objeto JavaScript, É um formato leve de troca de dados que é fácil para os humanos lerem e escreverem, e fácil para as máquinas analisarem e gerarem. É comumente usado em aplicativos da web para enviar e receber informações entre um servidor e um cliente. Sua estrutura é baseada em pares de valores-chave, tornando-o versátil e amplamente adotado no desenvolvimento de software.., CSV, HDFSHDFS, o Sistema de Arquivos Distribuído Hadoop, É uma infraestrutura essencial para armazenar grandes volumes de dados. Projetado para ser executado em hardware comum, O HDFS permite a distribuição de dados em vários nós, garantindo alta disponibilidade e tolerância a falhas. Sua arquitetura é baseada em um modelo mestre-escravo, onde um nó mestre gerencia o sistema e os nós escravos armazenam os dados, facilitando o processamento eficiente de informações.. e muito mais.
- Exploração e visualização de dados com o GraphLab Canvas. O GraphLab Canvas é uma interface gráfica interativa baseada em navegador que permite explorar dados tabulares, estatísticas resumidas e gráficos bivariados. Com esta funcionalidade, dedica menos tempo a codificar a exploração de dados. Isto ajudará a concentrar-se mais em compreender a relação e distribuição das variáveis. Falei sobre esta parte nas secções seguintes.
- Engenharia de funções: O GraphLab tem uma opção integrada para criar novas funcionalidades úteis para melhorar o desempenho do modelo. É composto por várias opções como transformação, agrupamentoo "agrupamento" É um conceito que se refere à organização de elementos ou indivíduos em grupos com características ou objetivos comuns. Este processo é usado em várias disciplinas, incluindo psicologia, Educação e biologia, para facilitar a análise e compreensão de comportamentos ou fenômenos. No campo educacional, por exemplo, O agrupamento pode melhorar a interação e o aprendizado entre os alunos, incentivando o trabalho.., imputação, uma codificação one-hot, tf-idf, etc.
- Modelagem: O GraphLab possui várias ferramentas para oferecer uma solução fácil e rápida para problemas de ML. Permite-lhe realizar vários exercícios de modelagem (regressão, classificação, agrupamento) em menos linhas de código. Pode trabalhar em problemas como o sistema de recomendação, a previsão de churn, a análise de sentimentos, a análise de imagens e muitos mais.
- Automatização da produção: Os pipelines de dados permitem-lhe montar tarefas de código reutilizável em trabalhos. Mais tarde, executá-los automaticamente em ambientes de execução comuns (por exemplo, Amazon Web Services, Hadoop).
- GraphLab Create SDK: Os utilizadores avançados podem expandir as capacidades do GraphLab Create utilizando o GraphLab Create SDK. Pode definir novos modelos / programas de aprendizagem automática e integrá-los com o resto do pacote. Ver o repositório no GitHub aqui.
- Licença: Tem limitação de uso. Pode optar por um período de teste gratuito de 30 dias ou uma licença de um ano para a edição académica. Para prolongar a sua assinatura, Você será acusado (ver estrutura de assinatura aqui).
Como instalar o GraphLab?
Também pode utilizar o GraphLab assim que tiver utilizado a sua licença. Porém, também pode começar com o teste gratuito ou a edição académica com subscrição de 1 ano. Portanto, antes da instalação, a sua máquina deve cumprir os requisitos do sistema para executar o GraphLab.
Requisitos do sistema para o GraphLab:
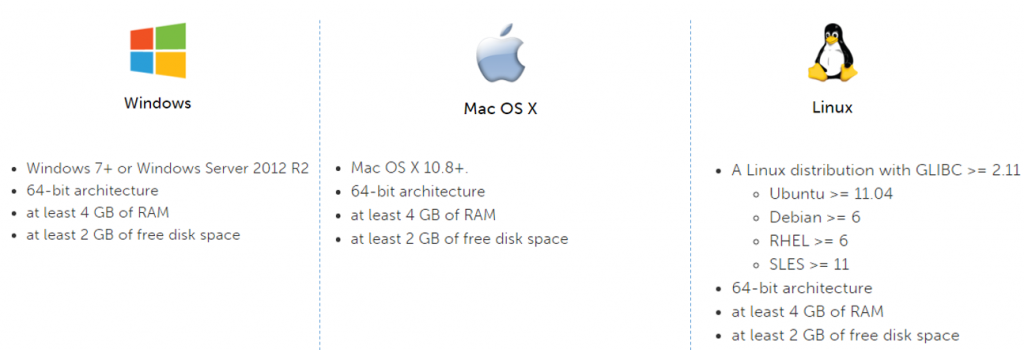
Se o seu sistema não cumprir os requisitos acima, Você pode usar GraphLab Create na camada gratuita da AWS O que mais.
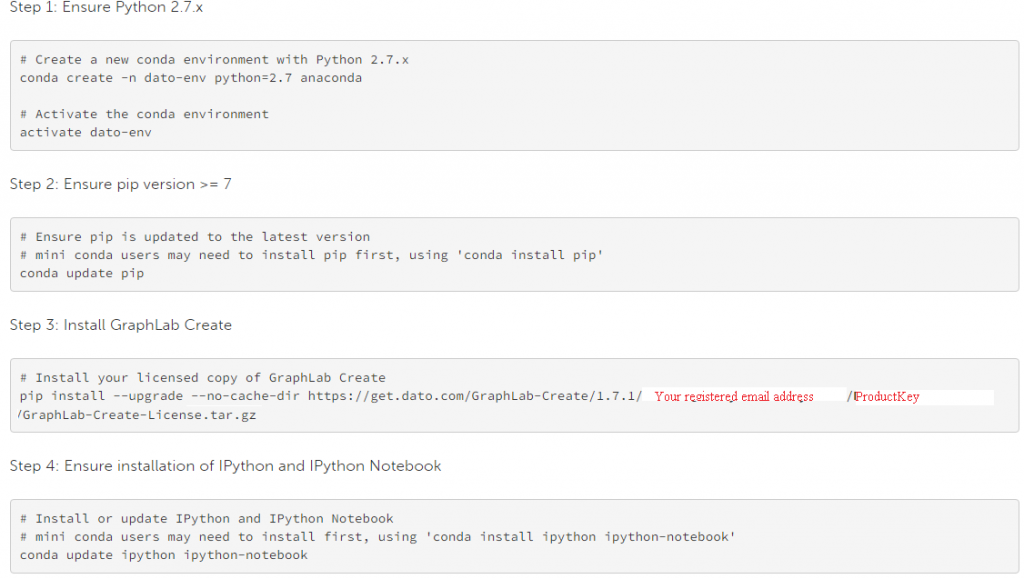
Passos para a instalação:
- Registar-se para caminho livre. Após o registo, receberá uma chave de produto.
- Selecione o seu sistema operativo (a seleção automática está ativada) e siga as instruções fornecidas
- A seguir, apresentam-se as instruções de instalação da linha de comandos (para “Ambiente Anaconda Python”).
Começando com Graphlab
Uma vez que tenha instalado o GraphLab corretamente, pode aceder a ele usando “importar ”.
import graphlab
or
import graphlab as gl
Aqui, demonstrar-me-ei o uso do GraphLab resolvendo um desafio de ciência de dados. Tenho o conjunto de dados retirado de Hack de dados da Black Friday.
-
-
- Manipulação de dados: Também pode realizar uma operação de manipulação de dados com SFrame, como adicionar um valor constante a todos os valores, concatenar duas ou mais variáveis, criar uma nova variávelEm estatística e matemática, uma "variável" é um símbolo que representa um valor que pode mudar ou variar. Existem diferentes tipos de variáveis, e qualitativo, que descrevem características não numéricas, e quantitativo, representando quantidades numéricas. Variáveis são fundamentais em experimentos e estudos, uma vez que permitem a análise de relações e padrões entre diferentes elementos, facilitando a compreensão de fenômenos complexos.... de saída com base numa variável, conforme mostrado abaixo:
- Adicione um valor constante à variável:
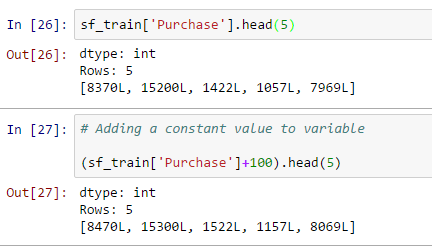
- Concatenar duas cadeias e armazená-las numa nova variável:
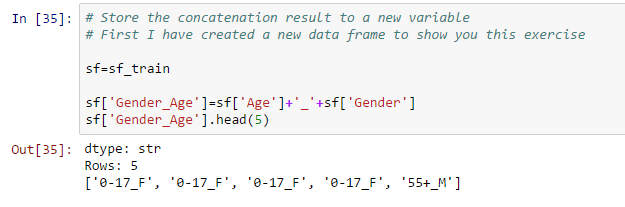
- Atualizar valores de variáveis existentes: isto pode ser feito usando a função apply. Neste conjunto de dados, combinei grupos etários superiores a 50 usando o seguinte código:
# Fazer uma alteração numa variável existente
# Combinar todos os intervalos etários superiores a 50
def combine_age(era):
 se idade=='51-55':
 return '50+'
 elif age=='55+':
 return '50+'
 else:
 return idade
sf['Age']=sf['Age'].Aplique(combine_age)
Agora, observe a visualização antes e depois da variável “Era”.
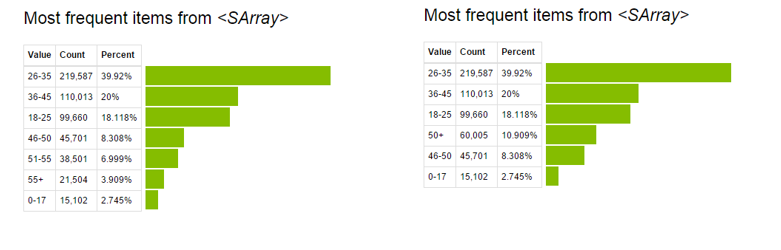 Para mais detalhes sobre manipulação de dados com GraphLab, consulte este Ligação.
- Adicione um valor constante à variável:
- Engenharia de funções: A engenharia de características é um método eficaz para melhorar o desempenho do modelo. Com esta técnica, podemos criar novas variáveis após a transformação ou manipulação das variáveis existentes. De fato, O GraphLab automatizou este processo. Eles têm várias opções de transformação para características numéricas, categóricas, de texto e imagem. O que mais, encontrará opções diretas para agrupamento de funções, imputação, uma codificação one-hot, limite de contagem, TF-IDF, Hasher, Tokenizing e outros. Vamos ver a imputação de característica categórica “Product_Category_2” baseado em “Idade” e “Gênerodo conjunto de dados 'Black Friday'.
# Criar os dados
# Variáveis com base nas quais queremos realizar a imputação e variável a imputar
# Pode consultar os algoritmos por detrás da imputação aqui.

sf_impute = sf_train['Age','Sexo','Product_Category_2']
imputador = graphlab.feature_engineering. CategoricalImputer(feature="Product_Category_2") # Fit and transform on the same data transformed_sf = imputer.fit_transform(sf_impute)#Retrieve the imputed values transformed_sf
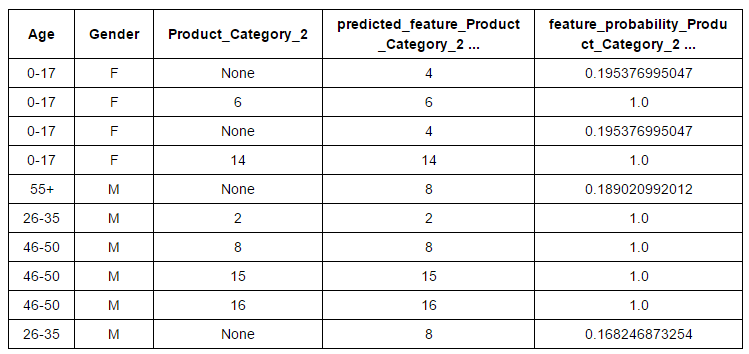
Finalmente, puede llevar esta variável de entrada al conjunto de datos original.
sf_train['Predicted_Product_Category_2']=transformed_sf['predicted_feature_Product_Category_2']
de forma similar, puede aplicar otras operaciones de ingeniería de características al conjunto de datos según sus requisitos. Puedes referir esto Ligação para mais detalhes.
- Modelagem: Nesta fase, hacemos predicciones a partir de datos pasados. GraphLab cria facilmentemente modelos para tareas comunes, O que:
UMA) Predicción de cantidades numéricas
B) Sistemas de recomendación de edificios
C) Agrupar datos y documentos
D) Análisis de gráficos
- Manipulação de dados: Também pode realizar uma operação de manipulação de dados com SFrame, como adicionar um valor constante a todos os valores, concatenar duas ou mais variáveis, criar uma nova variávelEm estatística e matemática, uma "variável" é um símbolo que representa um valor que pode mudar ou variar. Existem diferentes tipos de variáveis, e qualitativo, que descrevem características não numéricas, e quantitativo, representando quantidades numéricas. Variáveis são fundamentais em experimentos e estudos, uma vez que permitem a análise de relações e padrões entre diferentes elementos, facilitando a compreensão de fenômenos complexos.... de saída com base numa variável, conforme mostrado abaixo:
-
En el desafío del Viernes Negro, estamos obligados a predecir las cantidades numéricas “Compra”, quer dizer, necesitamos un modelo de regresión para predecir la “Compra”.
No GraphLab, tenemos três tipos de modelos de regresión:
UMA) Regressão linear
B) Regressão de floresta aleatória
C) Regresión impulsada por gradientes
Si tiene alguna confusión en la selección del algoritmo, GraphLab se encarga de eso. Não te preocupes. Seleciona el modelo de regresión correto automáticamente.
# Make a train-test split
train_data, validate_data = sf_train.random_split(0.8)
# Escolhe automaticamente o modelo certo com base nos seus dados.
model = graphlab.regression.create(train_data, alvo ="Purchase", features = ['Sexo','Age','Occupation','City_Category','Stay_In_Current_City_Years',
 'Marital_Status','Product_Category_1'])
# Save predictions to an SArray
predictions = model.predict(validate_data)
# Evaluate the model and save the results into a dictionary
results = model.evaluate(validate_data)
resultados
Produção:
{'max_error': 13377.561969523947, 'rmse': 3007.1225949345117}
#Do prediction on test data set
final_predictions = model.predict(sf_test)
Para saber más sobre otras técnicas de modelado como agrupamiento, classificação, sistema de recomendación, análise de texto, análisis de gráficos, sistemas de recomendação, você pode verificar isso Ligação. alternativamente, aquí está el completo guía del usuario por Dato.
Notas finais
Neste artigo, aprendimos sobre “GraphLab Create”, que ajuda a manejar un gran conjunto de dados enquanto se crean modelos de aprendizaje automático. Também analisamos a estrutura de dados do Graphlab que lhe permite gerir grandes conjuntos de dados como 'SFrame' e 'SGraph'. Recomendo que use o GraphLab. Vai adorar as suas funções automatizadas como a exploração de dados (Canvas, ferramenta de exploração de dados web interativa), a engenharia de funções, a seleção dos modelos adequados e a implementação.
Para um melhor entendimento, também demonstrei um exercício de modelação usando o GraphLab. En mi próximo artículo sobre GraphLab, me centraré en el análisis de gráficos y el sistema de recomendación.
Você acha útil este artigo ? Comparta con nosotros su experiencia con GraphLab.





