
objetivo
- O impulso é uma técnica de aprendizagem conjunta em que cada modelo tenta corrigir os erros do modelo anterior.
- Aprenda sobre o algoritmo de aumento de gradienteGradiente é um termo usado em vários campos, como matemática e ciência da computação, descrever uma variação contínua de valores. Na matemática, refere-se à taxa de variação de uma função, enquanto em design gráfico, Aplica-se à transição de cores. Esse conceito é essencial para entender fenômenos como otimização em algoritmos e representação visual de dados, permitindo uma melhor interpretação e análise em... e a matemática por trás dele.
Introdução
Neste artigo, vamos discutir um algoritmo que funciona com a técnica de impulso, o algoritmo de aumento de gradiente. É mais conhecido como Gradient Boosting Machine ou GBM.
Observação: Se você está mais interessado em aprender conceitos em formato audiovisual, temos esse artigo completo explicado no vídeo abaixo. Sim, não é assim, você pode continuar lendo.
Os modelos no Gradient Boosting Machine são construídos sequencialmente e cada um destes modelos subsequentes tenta reduzir o erro do modelo anterior. Mas a questão é: como cada modelo reduz o erro do modelo anterior? Isso é feito construindo o novo modelo sobre os erros ou residuais das previsões anteriores.
Isto se hace para determinar se há algum patrão no erro que o modelo anterior passa por alto. Vamos entender isso com um exemplo.
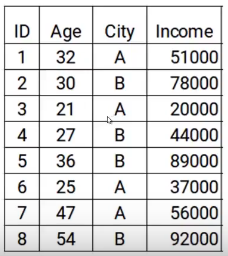
Aquí tenemos los dados con dos características: edad y ciudad, e o variávelEm estatística e matemática, uma "variável" é um símbolo que representa um valor que pode mudar ou variar. Existem diferentes tipos de variáveis, e qualitativo, que descrevem características não numéricas, e quantitativo, representando quantidades numéricas. Variáveis são fundamentais em experimentos e estudos, uma vez que permitem a análise de relações e padrões entre diferentes elementos, facilitando a compreensão de fenômenos complexos.... objetivo es el ingreso. Então, según la ciudad y la edad de la persona, temos que predecir los ingresos. Tenga en cuenta que a largo del proceso de aumento de gradiente, actualizaremos lo siguiente: el objetivo del modelo, el residuo del modelo y la predicción.
Pasos para construir el modelo de máquina de aumento de gradiente
Para simplificar la compreensão de la máquina de aumento de gradiente, hemos dividido el proceso en cinco pasos simples.
Paso 1
El primer paso es construir un modelo y hacer predicciones sobre los datos dados. Volvamos a nossos datos, para el primer modelo, o objetivo será o valor de Rendimento dado nos dados. Então, estableci o objetivo como valores originais de Rendimento.
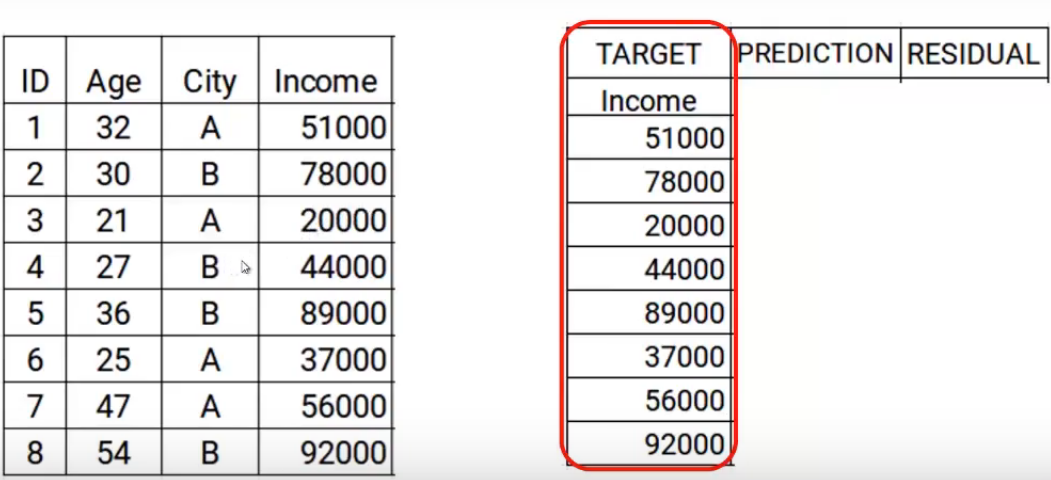
Agora construiremos o modelo usando as características idade e cidade com o rendimento objetivo. Este modelo treinado poderá gerar um conjunto de previsões. As quais se supõem como segue.
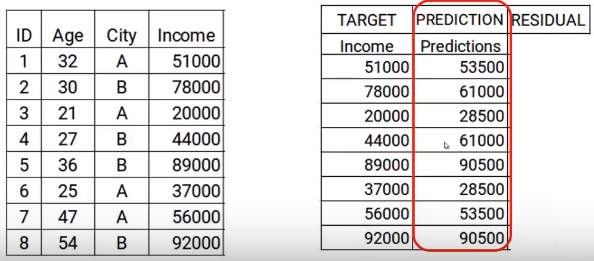
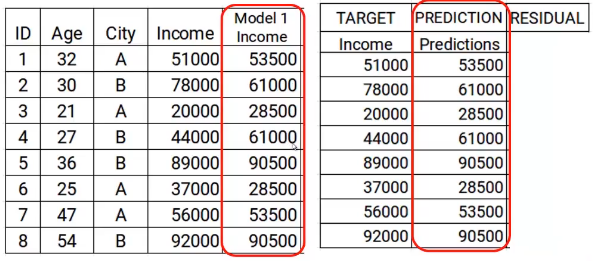
Agora vou armazenar estas previsões com os meus dados. Aqui é onde completo o primeiro passo.
Paso 2
O passo seguinte é utilizar estas previsões para obter o erro, que será usado mais tarde como objetivo. Por agora temos os valores reais de Rendimento e as previsões do modelo1. Usando estas colunas, calcularemos el error simplesmente restando los ingresos reales y las predicciones de ingresos. A se muestra a continuación.
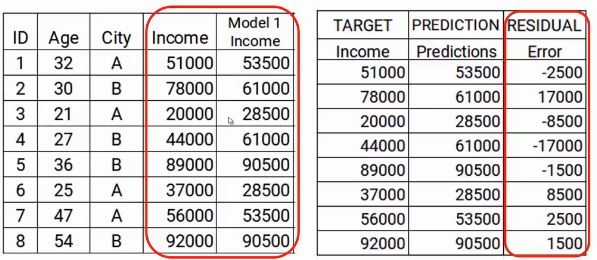
Como mencionámos anteriormente, los modelos sucesivos se centran en el error. Então, los erros aqui serão nosso novo objetivo. Eso cubre el paso dos.
Paso 3
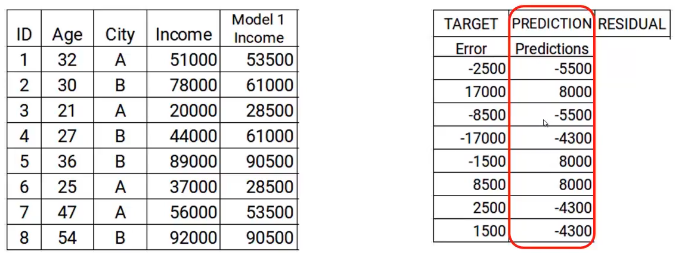
Na próxima etapa, criaremos um modelo sobre estes erros e realizaremos las predicciones. Aqui a ideia é determinar se há algum patrón oculto no error.
Então, usando el error como objetivo y las características originales Edad y Ciudad, generaremos nuevas predicciones. Tenga en cuenta que las predicciones, neste caso, serán los valores de error, no los valores de ingresos previstos, ya que nuestro objetivo es el error. Digamos que el modelo da las siguientes predicciones
Paso 4
Agora temos de atualizar as previsões do model1. Vamos adicionar a previsão do passo anterior e somá-la à previsão do model1, e chamá-la de Model2 Income.
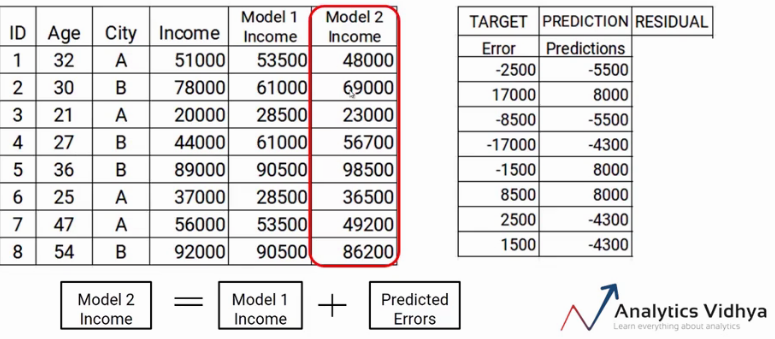
Como você pode ver, As minhas novas previsões estão mais próximas dos valores reais dos meus rendimentos.
Finalmente, Vamos repetir os passos 2 uma 4, o que significa que estaremos a calcular novos erros e a definir este novo erro como alvo. Vamos repetir este processo até que o erro seja zero ou até atingirmos o critério de paragem, que indica o número de modelos que queremos construir. Esse é o processo passo a passo para construir um modelo de aumento de gradiente.
Em poucas palavras, construímos o nosso primeiro modelo que tem as características x e y como objetivo e, vamos chamar a este modelo H0, que é uma função de x e y. Luego construimos el siguiente modelo sobre los errores del último modelo y un tercer modelo sobre los errores del modelo anterior y así sucesivamente. Hasta que construyamos n modelos.
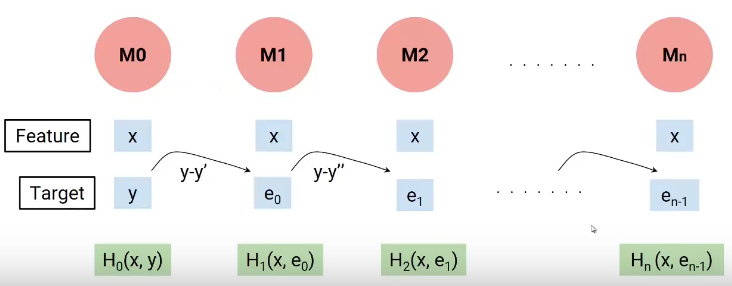
Cada modelo sucesivo trabalha sobre os erros de todos los modelos anteriores para tentar identificar qualquer patrón no error. Efectivamente, posso dizer que cada um destes modelos são funções individuais que têm a variável independente x como característica y o objetivo é o erro do modelo combinado anterior.
Então, para determinar la ecuación final de nuestro modelo, construimos nuestro primer modelo H0, que me dio algunas predicciones y geró algunos errores. Llamemos a este resultado combinado F0 (X).
Agora criamos nosso segundo modelo y agregamos novos erros a F0 (X), esta nueva función será F1 (X). de forma similar, construiremos o próximo modelo e assim sucesivamente, até que tengamos modelos como se mostra a continuación.
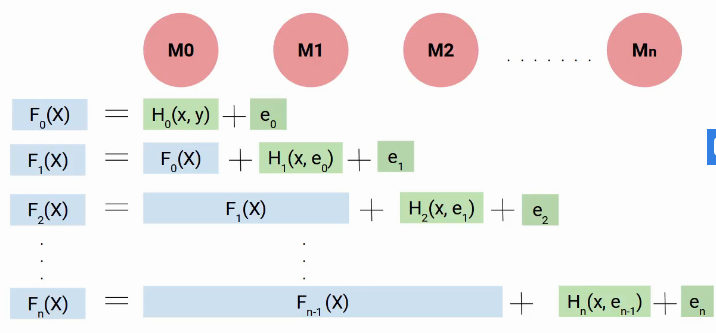
Então, em cada passo, intentamos modelar los errores, lo que nos ayuda a reducir el error general. Idealmente, queremos que este 'en’ sea cero. Como você pode ver, cada modelo aqui está a tratar de aumentar el rendimiento del modelo, portanto, usamos el término impulso.
Pero por qué usamos el término gradiente, aquí está el truco. En lugar de agregar directamente estos modelos, los agregamos con peso o coeficiente, y el valor correcto de este coeficiente se decide utilizando la técnica de aumento de gradiente.
Por tanto, una forma más generalizada de nuestra ecuación será la siguiente.
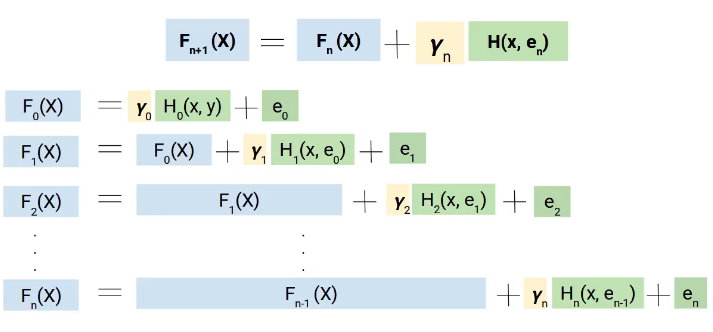
Las matemáticas behind de Gradient Boosting Machine
Espero que agora tengas uma ideia ampla de como funciona el aumento de gradiente. De aqui em frente, nos centraremos em como se calcula el valor de Yn.
Usaremos a técnica de desescenso de gradiente para obter os valores de estes coeficientes gama (E), de manera que minimicemos la Função de perdaA função de perda é uma ferramenta fundamental no aprendizado de máquina que quantifica a discrepância entre as previsões do modelo e os valores reais. Seu objetivo é orientar o processo de treinamento, minimizando essa diferença, permitindo assim que o modelo aprenda de forma mais eficaz. Existem diferentes tipos de funções de perda, como erro quadrático médio e entropia cruzada, cada um adequado para diferentes tarefas e.... Ahora profundicemos en esta ecuación y comprendamos el papel de la función de pérdida y gamma.
Aqui, la función de pérdida que estamos usando es (y-y ') 2. y es el valor real e 'es el valor final predito por el último modelo. Então, podemos substituir y 'con Fn (X) que representa o objetivo real menos las predicciones actualizadas de todos los modelos que hemos construido hasta ahora.
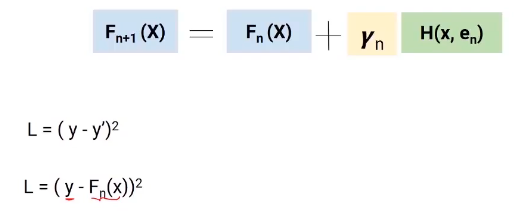
Diferenciación parcial
Creo que estará familiarizado con el proceso de descenso de gradientes, ya que vamos a utilizar el mismo concepto. Diferenciaremos la ecuación de L con respecto a Fn (X), obtendrás la siguiente ecuación, que também se conhece como pseudo residual. Cuál es el gradiente negativo de la función de pérdida.
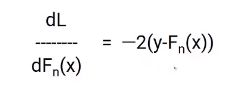
Para simplificar esto, multiplicaremos ambos lados por -1. El resultado será algo como esto.
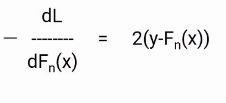
Agora, sabemos que el error en nuestra ecuación de Fn + 1 (X) es el valor real menos las predicciones actualizadas de todos los modelos. Portanto, podemos substituir el en nuestra ecuación final con estos pseudo resíduos como se muestra en la imagen a continuación.
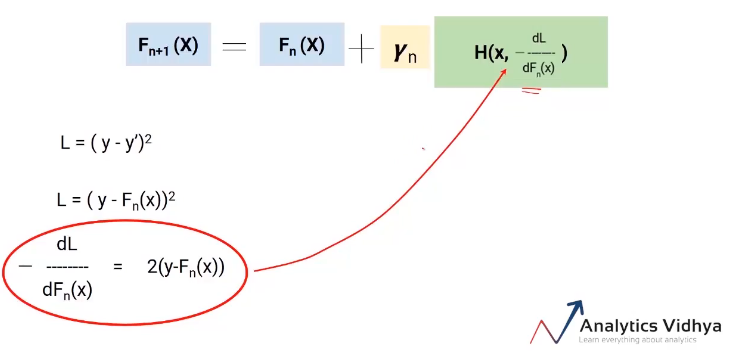
Entonces esta es nuestra ecuación final. La mejor parte de este algoritmo es que le da la libertad de decidir la función de pérdida. La única condición es que la función de pérdida sea diferenciable. Para facilitar a compreensão, usamos una função de pérdida muy simple (y-y ') 2 pero puede cambiarla a una perda de bisagra o uma perda logit o qualquer cosa.
El objetivo es minimizar la pérdida total. Veamos cuál sería la pérdida total aquí, será la pérdida hasta el modelo n más la pérdida del modelo actual que estamos construyendo. Aquí está la ecuación.
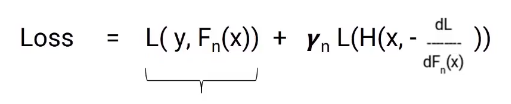
Nesta equação, a primeira parte é fixa, mas a segunda parte é a perda do modelo em que estamos a trabalhar atualmente. A perda deste modelo ainda não pode ser alterada, mas podemos alterar o valor de gamma. Agora temos de selecionar o valor de gamma de forma a minimizar a perda total e este valor é selecionado através do processo de descida do gradiente.
Então, A ideia é reduzir a perda geral ao decidir o valor ótimo de gamma para cada modelo que construímos.
Árvore de decisão de aumento de gradiente
Falo de um caso especial de aumento de gradiente, quer dizer, árvore de decisão de aumento de gradiente (GBDT). Aqui, cada modelo seria uma árvore e o valor de gamma será decidido em cada nível da folha, não no nível geral do modelo. Então, como mostrado na imagem a seguir, cada folha teria um valor gamma.
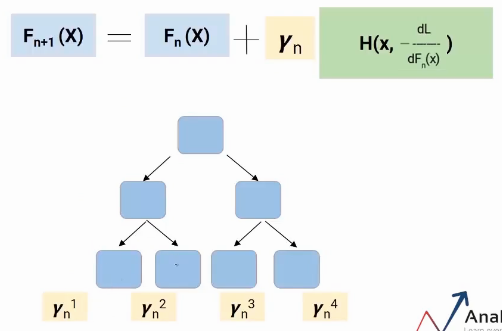
É assim que funciona a Gradient Boosting Decision Tree.
Notas finais
Boosting é um tipo de aprendizagem em conjunto. É um processo sequencial onde cada modelo tenta corrigir os erros do modelo anterior. Isto significa que cada modelo subsequente depende dos seus predecessores. Neste artigo, vimos o algoritmo de gradient boosting e a matemática por trás dele.
Como temos uma ideia clara do algoritmo, tente construir os modelos e obtenha alguma experiência prática com ele.
Se você está procurando iniciar sua jornada de ciência de dados e deseja todos os tópicos sob o mesmo teto, sua busca para aqui. Dê uma olhada no AI e ML BlackBelt certificados da DataPeaker Mais Programa
Se você tiver alguma dúvida, deixe-me saber na seção de comentários!
Se você tem alguma dúvida, Deixe-me saber nos comentários abaixo.





