
Impulsione o algoritmo no aprendizado de máquina
Impulso pode ser chamado de um conjunto de algoritmos cuja função principal é transformar alunos fracos em alunos fortes. Eles se tornaram mainstream Indústria de Ciência de Dados porque eles estiveram no comunidade de aprendizado de máquina durante anos. O impulso foi introduzido pela primeira vez por Freund e Schapire no ano 1997 com seu Algoritmo AdaBoost, e desde então, impulso tem sido uma técnica predominante para resolver problemas de classificação binária.
Por que os algoritmos de impulso são tão populares?
Para saber isso, em palavras mais simples. algoritmos de impulso pode superar algoritmos mais simples como Floresta aleatória, árvores de decisão ou regressão logística. É uma das principais razões para o aumento na promoção de algoritmos por muitos concorrentes de aprendizado de máquina, devido ao fato de que algoritmos de impulso são poderosos.. Ainda assim, pode melhorar precisão de previsão de seu modelo por um número considerável de fatores. Muitos concorrentes de aprendizado de máquina usam um único algoritmo de impulso ou vários algoritmos de impulso para resolver os respectivos problemas..
Algoritmo de impulso explicado
Impulso combinar alunos fracos para formar um aluno forte, onde um aluno fraco define um classificador ligeiramente correlacionado com a classificação real. Ao contrário de um aluno fraco, um bom aluno é um classificador associado às categorias corretas.
Para saber isso, vamos assumir um cenário:
Suponha que você construa um Modelo de floresta aleatório o que lhe dá uma precisão de 75% no conjunto de dados de validação e, a seguir, decidir testar algum outro modelo no mesmo conjunto de dados. Suponha que você tente linear modelo de regressão e kNN no mesmo conjunto de dados de validação, e agora seu modelo oferece uma precisão de 69% e 92%, respectivamente. É claro que os três modelos funcionam de maneiras absolutamente diferentes e fornecem resultados absolutamente diferentes no mesmo conjunto de dados..
Você já pensou, em vez de apenas usar um desses modelos, e se usarmos uma combinação de todos esses modelos para fazer as previsões finais?
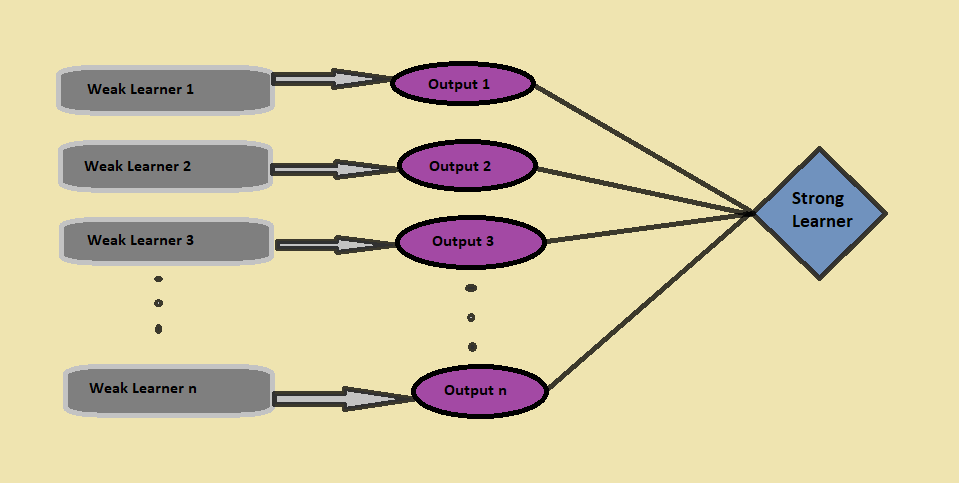
Capturaremos mais informações dos dados tirando a média das previsões desses modelos.; Equivalentemente, o algoritmo de aumento combina vários modelos mais simples (também chamados de alunos fracos) para gerar o resultado final (também chamado de aluno forte).
Agora você pensaria em como identificar alunos fracos?
Para identificar alunos fracos, nós usamos algoritmos de aprendizado de máquina com uma distribuição diferente para cada iteração e para cada algoritmo, gera uma nova regra de previsão fraca. Depois de muitas iterações, o algoritmo de impulso combina todos os alunos vulneráveis para formar uma regra de predição de cadeia única.
Outra coisa essencial para prestar atenção aqui é, ‘Como determinamos uma distribuição diferente para cada rodada??’
Existem três etapas que devemos considerar para selecionar a distribuição correta:
- O aluno fraco considera todas as distribuições e, em seguida, atribui peso igual a cada observação, depois de
- Se o erro for gerado pela previsão do primeiro algoritmo de aprendizado fraco, mais atenção é dada ao erro de previsão das observações. O seguinte algoritmo de aprendizado fraco se aplica.
- Por último, repita a segunda etapa até que o algoritmo básico de aprendizagem atinja seu limite ou a precisão desejada seja alcançada.
Finalmente, como consequência, o algoritmo de impulso combina todos os resultados fracos do aluno. Apresenta-se com um aluno mais forte e poderoso, o que eventualmente melhora a precisão da previsão do modelo (como se ve en la figura"Figura" é um termo usado em vários contextos, Da arte à anatomia. No campo artístico, refere-se à representação de formas humanas ou animais em esculturas e pinturas. Em anatomia, designa a forma e a estrutura do corpo. O que mais, em matemática, "figura" está relacionado a formas geométricas. Sua versatilidade o torna um conceito fundamental em várias disciplinas.... anterior).
Ao aumentar, em vez de apenas combinar os classificadores isolados, usa o mecanismo de aumentar os pesos dos pontos de dados classificados incorretamente nos classificadores acima.
Tipos de algoritmo de impulsos
É hora de discutir alguns dos tipos essenciais de algoritmos de momentum agora.
1. Aumento de gradienteGradiente é um termo usado em vários campos, como matemática e ciência da computação, descrever uma variação contínua de valores. Na matemática, refere-se à taxa de variação de uma função, enquanto em design gráfico, Aplica-se à transição de cores. Esse conceito é essencial para entender fenômenos como otimização em algoritmos e representação visual de dados, permitindo uma melhor interpretação e análise em...
No aumento de gradiente algoritmo, treinamos vários modelos sequencialmente, e para cada novo modelo, el modelo minimiza gradualmente la Função de perdaA função de perda é uma ferramenta fundamental no aprendizado de máquina que quantifica a discrepância entre as previsões do modelo e os valores reais. Seu objetivo é orientar o processo de treinamento, minimizando essa diferença, permitindo assim que o modelo aprenda de forma mais eficaz. Existem diferentes tipos de funções de perda, como erro quadrático médio e entropia cruzada, cada um adequado para diferentes tarefas e... usando el método Gradient Descent. a Algoritmo de aumento da árvore de gradiente você aceita Árvores de decisão como o fraco magro porque os nós em uma árvore de decisão consideram um ramo diferente de características para escolher a melhor divisão, o que significa que todas as árvores não são iguais. Por isso, pode capturar diferentes saídas de dados o tempo todo.
O algoritmo de aumento da árvore de gradiente é construído sequencialmente porque, para cada nova árvore, o modelo considera os erros da última árvore, e a decisão de cada árvore sucessiva é baseada nos erros cometidos pela árvore anterior.
Os algoritmos de Gradient Boosting são usados principalmente para problemas de classificação e regressão.
Código Python:
from sklearn.ensemble importar GradientBoostingClassifier #Para classificação
from sklearn.ensemble import GradientBoostingRegressor #Para regressão
cl = GradientBoostingClassifier (n_estimators = 100, learning_rate = 1.0, max_depth = 1)
cl.fit (Xtrain, Ytrain)
Onde:
n_estimators O parâmetro é usado para controlar o número de alunos fracos,
taxa de Aprendizagem O parâmetro controla a contribuição de todos os alunos vulneráveis para o resultado final,
Profundidade máxima O parâmetro é para a profundidade máxima dos estimadores de regressão individuais para limitar o número de nós na árvore.
2. AdaBoost (reforço adaptativo)
O algoritmo AdaBoost, abreviatura de Drive adaptativo, é uma técnica de impulso em aprendizado de máquina que é usada como Método de definição. Sobre Drive adaptativo, todos os pesos são reatribuídos a cada instância onde pesos mais altos são atribuídos a modelos classificados incorretamente, e se encaixa na sequência de alunos fracos em pesos diferentes.
Adaboost começa com fazer previsões sobre o conjunto de dados original em linguagem simples, e então dar o mesmo peso a cada observação. Se a previsão feita com o primeiro aluno estiver incorreta, atribui o maior relevância para declaração incorretamente prevista e procedimento iterativo. Continue adicionando novos alunos até que o limite do modelo seja atingido.
Podemos utilizar cualquier algoritmo de aprendizaje automático con Adaboost como estudiantes débiles si acepta pesos en el conjunto de datos de TreinamentoO treinamento é um processo sistemático projetado para melhorar as habilidades, Conhecimento ou habilidades físicas. É aplicado em várias áreas, como esporte, Educação e desenvolvimento profissional. Um programa de treinamento eficaz inclui planejamento de metas, prática regular e avaliação do progresso. A adaptação às necessidades individuais e a motivação são fatores-chave para alcançar resultados bem-sucedidos e sustentáveis em qualquer disciplina.... y se utiliza tanto para problemas de regresión como de clasificación.
Código Python:
from sklearn.ensemble import AdaBoostClassifier #Para classificação
from sklearn.ensemble import AdaBoostRegressor #For Regression
de sklearn.tree import DecisionTreeClassifier
dtree = DecisionTreeClassifier ()
cl = AdaBoostClassifier (n_estimators = 100, base_estimator = dtree, learning_rate = 1)
cl.fit (xtrain, Ytrain)
Onde:
n_estimators e o parâmetro learning_rate tem o mesmo propósito que no caso do algoritmo Gradient Boosting,
base_estimator O parâmetro ajuda a especificar diferentes algoritmos de aprendizado de máquina.
3. XGBoost
O algoritmo XGBoost, abreviatura de Extreme Gradient Boosting, É simplesmente uma versão improvisada do algoritmo de aumento de gradiente, e o procedimento de trabalho de ambos é quase o mesmo. Um ponto crucial em XGBoost é isso Implementa procesamiento paralelo a nivel de nóO Nodo é uma plataforma digital que facilita a conexão entre profissionais e empresas em busca de talentos. Através de um sistema intuitivo, permite que os usuários criem perfis, Compartilhar experiências e acessar oportunidades de trabalho. Seu foco em colaboração e networking torna o Nodo uma ferramenta valiosa para quem deseja expandir sua rede profissional e encontrar projetos que se alinhem com suas habilidades e objetivos...., tornando-o mais poderoso e rápido do que o algoritmo de aumento de gradiente.. XGBoost reduz overfitting e melhora o desempenho geral a través de la inclusión de varias técnicas de regularizaçãoA regularização é um processo administrativo que busca formalizar a situação de pessoas ou entidades que atuam fora do marco legal. Esse procedimento é essencial para garantir direitos e deveres, bem como promover a inclusão social e econômica. Em muitos países, A regularização é aplicada em contextos migratórios, Trabalhista e Tributário, permitindo que aqueles que estão em situação irregular tenham acesso a benefícios e se protejam de possíveis sanções.... a través de el establecimiento de los hiperparámetros del algoritmo XGBoost.
Um ponto importante a se prestar atenção XGBoost é isso você não precisa se preocupar com valores ausentes no conjunto de dados porque, durante todo o procedimento de treinamento, o próprio modelo aprende onde ajustar os valores ausentes, Em outras palavras, o nó esquerdo ou o nó direito.
O XGBoost é usado principalmente para classificar problemas, mas pode ser usado para problemas de regressão.
Código Python:
importar xgboost como xgb
xgb_model = xgb.XGBClassifier (learning_rate = 0,001, max_depth = 1, n_estimators_100)
xbg_model.fit (x_train, y_train)
NOTAS FINAIS
Esta postagem analisou algoritmos de impulso em aprendizado de máquina, explicou o que são algoritmos de impulso e tipos de algoritmos de impulso: Adaboost, Gradient Boosting y XGBoost. Además miramos sus respectivos códigos y parametroso "parametros" são variáveis ou critérios usados para definir, medir ou avaliar um fenômeno ou sistema. Em vários domínios, como a estatística, Ciência da Computação e Pesquisa Científica, Os parâmetros são essenciais para estabelecer normas e padrões que orientam a análise e interpretação dos dados. Sua seleção e manuseio adequados são cruciais para obter resultados precisos e relevantes em qualquer estudo ou projeto.... de Python involucrados.
Se você tiver alguma dúvida, você pode me encontrar no meu LinkedIn @Mrinalwalia.
A mídia mostrada nesta postagem não é propriedade da DataPeaker e é usada a critério do autor.





