
Este artigo foi publicado como parte do Data Science Blogathon.
O que é um modelo estatístico?
“A modelação é uma arte, bem como uma ciência, e é dirigida a encontrar um bom modelo aproximado … como base para a inferência estatística” – Burnham & Anderson
Um modelo estatístico é um tipo de modelo matemático que faz parte das suposições realizadas para descrever o processo de geração de dados.
Vamos focar-nos nos dois termos destacados acima:
- Tipo de modelo matemático? O modelo estatístico não é determinista, ao contrário de outros modelos matemáticos, onde as variáveis têm valores específicos. As variáveis nos modelos estatísticos são estocásticas, quer dizer, têm distribuições de probabilidade.
- Suposições? Mas, Como é que esses pressupostos nos ajudam a compreender as propriedades ou características dos dados reais? Em poucas palavras, estes pressupostos facilitam o cálculo da probabilidade de um evento.
Citação um exemplo para compreender melhor o papel dos pressupostos estatísticos na modelação de dados:
Suposição 1: Supondo que temos 2 dados justos e que cada face tem a mesma probabilidade de aparecer, quer dizer, 1/6. Agora, podemos calcular a probabilidade de que dois dados mostrem 5 O que 1/6 * 1/6. Como podemos calcular a probabilidade de cada evento, constitui um modelo estatístico.
Suposição 2: Os dados estão viciados e tudo o que sabemos é que a probabilidade da face 5 isto é 1/8, o que facilita o cálculo da probabilidade de que ambos os dados mostrem 5 O que 1/8 * 1/8. Mas não conhecemos a probabilidade das outras faces, portanto, não podemos calcular a probabilidade de cada evento. Por tanto, esta suposição não constitui um modelo estatístico.
Por que precisamos da modelação estatística?
O modelo estatístico desempenha um papel fundamental na realização de inferências estatísticas que ajudam a fazer proposições sobre as propriedades e características desconhecidas da população, como mostrado abaixo:
1) Estimativa:
É a ideia central por trás do aprendizado automático, quer dizer, descobrir o número que pode estimar os parametroso "parametros" são variáveis ou critérios usados para definir, medir ou avaliar um fenômeno ou sistema. Em vários domínios, como a estatística, Ciência da Computação e Pesquisa Científica, Os parâmetros são essenciais para estabelecer normas e padrões que orientam a análise e interpretação dos dados. Sua seleção e manuseio adequados são cruciais para obter resultados precisos e relevantes em qualquer estudo ou projeto.... de distribuição.
Observe que o Estimadoro "Estimador" é uma ferramenta estatística usada para inferir características de uma população a partir de uma amostra. Ele se baseia em métodos matemáticos para fornecer estimativas precisas e confiáveis. Existem diferentes tipos de estimadores, como o imparcial e o consistente, escolhidos de acordo com o contexto e objetivo do estudo. Seu uso correto é essencial na pesquisa científica, levantamentos e análise de dados.... é uma variávelEm estatística e matemática, uma "variável" é um símbolo que representa um valor que pode mudar ou variar. Existem diferentes tipos de variáveis, e qualitativo, que descrevem características não numéricas, e quantitativo, representando quantidades numéricas. Variáveis são fundamentais em experimentos e estudos, uma vez que permitem a análise de relações e padrões entre diferentes elementos, facilitando a compreensão de fenômenos complexos.... aleatória em si mesma, enquanto uma estimativa é um número único que nos dá uma ideia da distribuição do processo de geração de dados. Por exemplo, a média e sigma da distribuição gaussiana
2) Intervalo de confiança:
Dar uma barra de erro em torno do número da estimativa única, quer dizer, um intervalo de valores para indicar a confiança na estimativa obtida com base em várias amostras. Por exemplo, a estimativa A é calculada a partir de 100 amostras e tem um intervalo de confiança mais amplo, enquanto a estimativa B é calculada a partir de 10000 amostras e, portanto, tem um intervalo de confiança mais estreito.
3) Testando hipóteses
É uma declaração de procura por evidência estatística. Vamos compreender melhor a necessidade de realizar modelos estatísticos com a ajuda do exemplo abaixo.
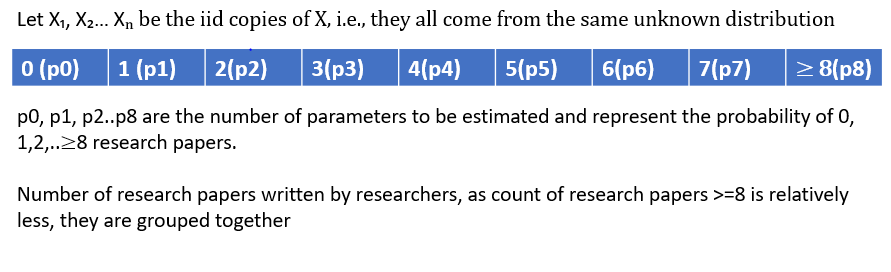
O objetivo é compreender a distribuição subjacente para calcular a probabilidade de que um investigador selecionado aleatoriamente tivesse escrito, Digamos, 3 artigos de pesquisa.
Temos uma variável aleatória discreta com 8 (9-1) parámetros para aprender, quer dizer, probabilidad de 0,1,2 .. trabajos de investigación. A medida que aumenta el número de parámetros a estimar, también lo es la necesidad de tener tantas observaciones, pero este no es el propósito del modelado de datos.
Então, podemos reducir el número de incógnitas de 8 parámetros a solo 1 parámetro lambda, simplemente asumiendo que los datos siguen la distribución de Poisson.
Nuestra suposición de que los datos siguen la distribución de Poisson podría ser una simplificación en comparación con el proceso de generación de datos reales, pero es una buena aproximación.
Tipos de supuestos de modelado:
Ahora que entendemos la importancia del modelado estadístico, entendamos el tipos de supuestos de modelado:
1) Paramétrico: Assume um conjunto finito de parâmetros que capturam tudo o que está relacionado com os dados. Se conhecermos o parâmetro θ que representa muito bem o processo de geração de dados, então as previsões (x) são independentes dos dados observados (D)
2) Não paramétrico: Assume que nenhum conjunto finito de parâmetros pode definir a distribuição dos dados. A complexidade do modelo é ilimitada e cresce com a quantidade de dados
3) Semiparamétrico: É um modelo híbrido cujas suposições se situam entre abordagens paramétricas e não paramétricas. Consta de dos componentes: estrutural (paramétrico) e variação aleatória (não paramétrico). O modelo de risco proporcional de Cox é um exemplo popular de suposições semiparamétricas.
Definição de um modelo estatístico: (S, P)
S: Suponhamos que temos uma coleção de cópias N iid como X1, X2, X3… Xn através de um experimento estatístico (é o processo de gerar ou recolher dados). Todos estes As variáveis aleatórias podem ser medidas num espaço amostral que se denota por S.
PAG: É o conjunto de distribuições de probabilidade em S que contém a distribuição que é uma representação aproximada da nossa distribuição real.
Internalizemos o conceito de espaço amostral antes de compreender como se poderia representar um modelo estatístico para estas distribuições.
1) Bernoulli: {0,1}
2) Gaussiano: (-∞, + ∞)
Então, agora vimos alguns exemplos de espaço amostral de algumas das famílias de distribuição, agora vejamos como se define um modelo estatístico:
1) Bernoulli: ({0,1}, (Ber (p)) p∈ (0,1))
2) Gaussiano: ((-∞, + ∞), (N (𝜇, 0.3)) 𝜇∈R)
Nós vamos, modelos especificados e mal especificados:
¿Qué es la especificación del modelo? De acordo com Wikipedia definição:
Especificación del modelo consiste en selecionar una forma funcional adecuada para el modelo. Por exemplo, dados “ingreso personal” (e) junto com “años de escolaridad” (s) e “experiencia en el trabajo” (x), podríamos especificar una relación funcional y = f (s, x)} Como segue:
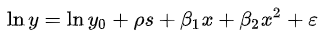
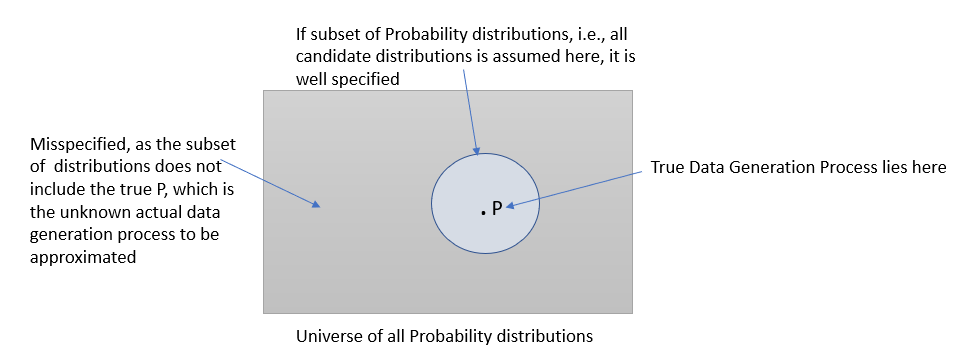
Modelo de especificación incorreta: ¿Alguna vez le ha sucedido que el modelo converge corretamente en datos simulados, pero en el momento en que llegan los datos reales, su robustez se degrada y ya no converge? Nós vamos, esto podría suceder normalmente si el modelo que desarrolló no coincide con los datos, lo que generalmente se conoce como Modelo de especificación incorreta. Pode dever-se ao facto de a classe de distribuição assumida para a modelagem não conter a distribuição de probabilidade desconhecida p de onde é extraída a amostra, quer dizer, o verdadeiro processo de geração de dados.
Fonte: Autor
Espero que este artigo lhe tenha proporcionado uma compreensão do que é um modelo estatístico, porque precisamos de tais modelos, que papel os pressupostos desempenham e como esses pressupostos podem determinar a qualidade do nosso modelo.
*O processo de distribuição / a geração de dados real ou verdadeira a que se faz referência ao longo deste artigo implica que existe uma distribuição de probabilidade que é induzida pelo processo que gera os dados observados.
Referências:
https://mc-stan.org/docs/2_22/stan-users-guide/well-specified-models.html
http://mlss.tuebingen.mpg.de/2015/slides/ghahramani/gp-neural-nets15.pdf
https://courses.edx.org/courses/course-v1:MITx+18.6501x+3T2019/course/





