
Introdução
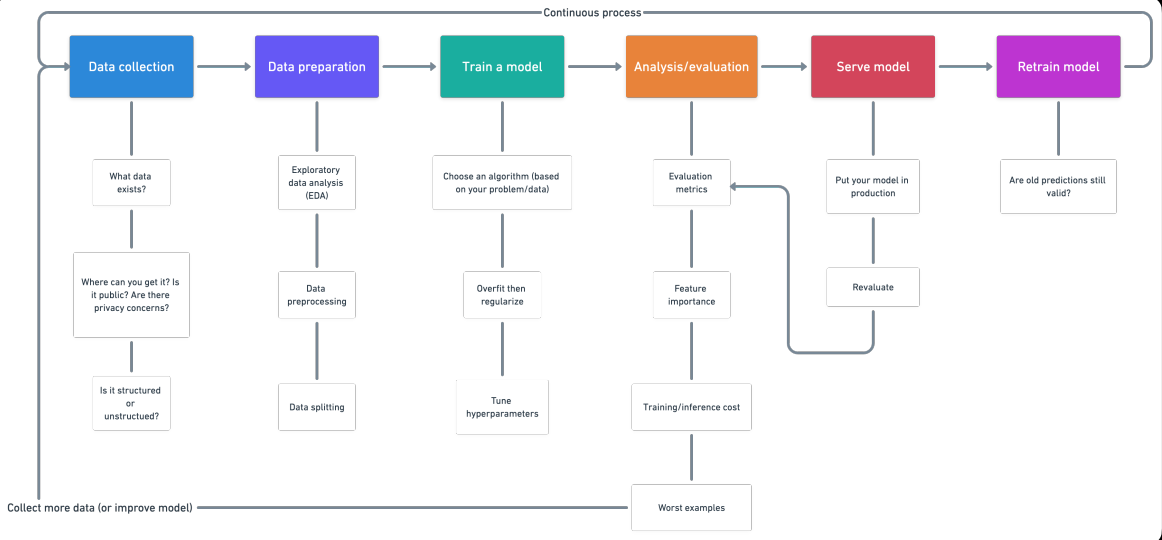
1. Coleta de dados
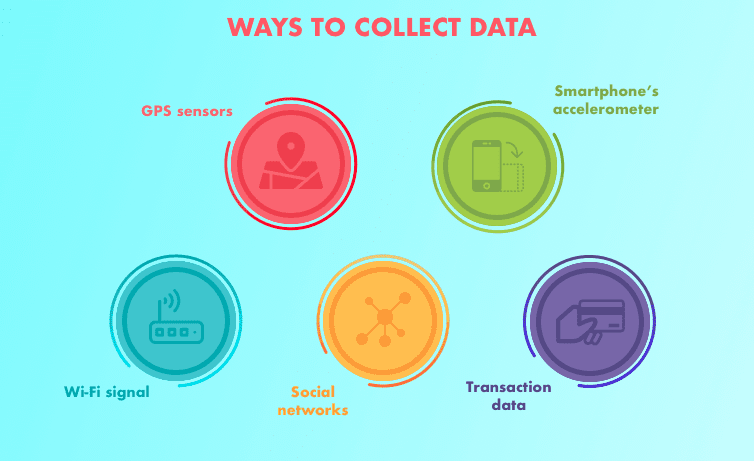
- Que tipo de problema estamos a tentar resolver?
- Que fontes de dados já existem?
- Que problemas de privacidade existem?
- Os dados são públicos?
- Onde devemos armazenar os ficheiros?
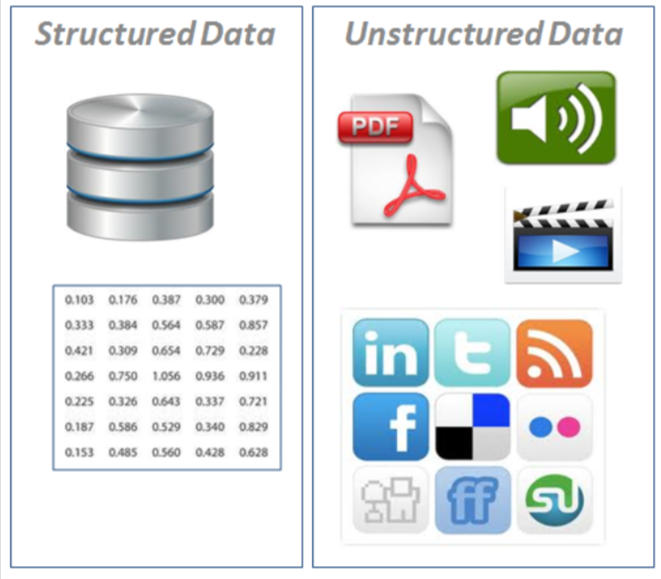
- Dados estruturados: aparecem em formato tabular (estilo de linhas e colunas, como o que encontraria numa folha de cálculo do Excel). Contém diferentes tipos de dados, por exemplo, séries temporais numéricas, categóricas.
- · Nominal / categórico – Uma coisa ou outra (mutuamente exclusivos). Por exemplo, para as balanças de automóveis, a cor é uma categoria. Um carro pode ser azul mas não branco. A ordem não importa.
- Numérico: Qualquer valor contínuo onde a diferença entre eles importa. Por exemplo, ao vender casas, $ 107,850 é mais que $ 56,400.
- Ordinal: Datos que tienen orden pero se desconoce la distancia entre valores. Por exemplo, una pregunta como, ¿cómo calificaría su salud del 1 al 5? 1 siendo pobre, 5 saludable. Puede responder 1, 2, 3, 4, 5, pero la distancia entre cada valor no significa necesariamente que una respuesta de 5 sea cinco veces más buena que una respuesta de 1. Séries TemporaisUma série temporal é um conjunto de dados coletados ou medidos em momentos sucessivos, geralmente em intervalos de tempo regulares. Esse tipo de análise permite identificar padrões, Tendências e ciclos nos dados ao longo do tempo. Sua aplicação é ampla, abrangendo áreas como economia, Meteorologia e saúde pública, facilitando a previsão e a tomada de decisões com base em informações históricas....: datos a lo largo del tiempo. Por exemplo, los valores históricos de venta de las topadoras de 2012 uma 2018.
- Séries Temporais: Datos a lo largo del tiempo. Por exemplo, los valores históricos de venta de las topadoras de 2012 uma 2018.
- Dados não estruturados: Datos sin estructura rígida (imagens, vídeo, voz, Talvez uma analogia melhor seria
texto de idioma)
2. Preparação de dados
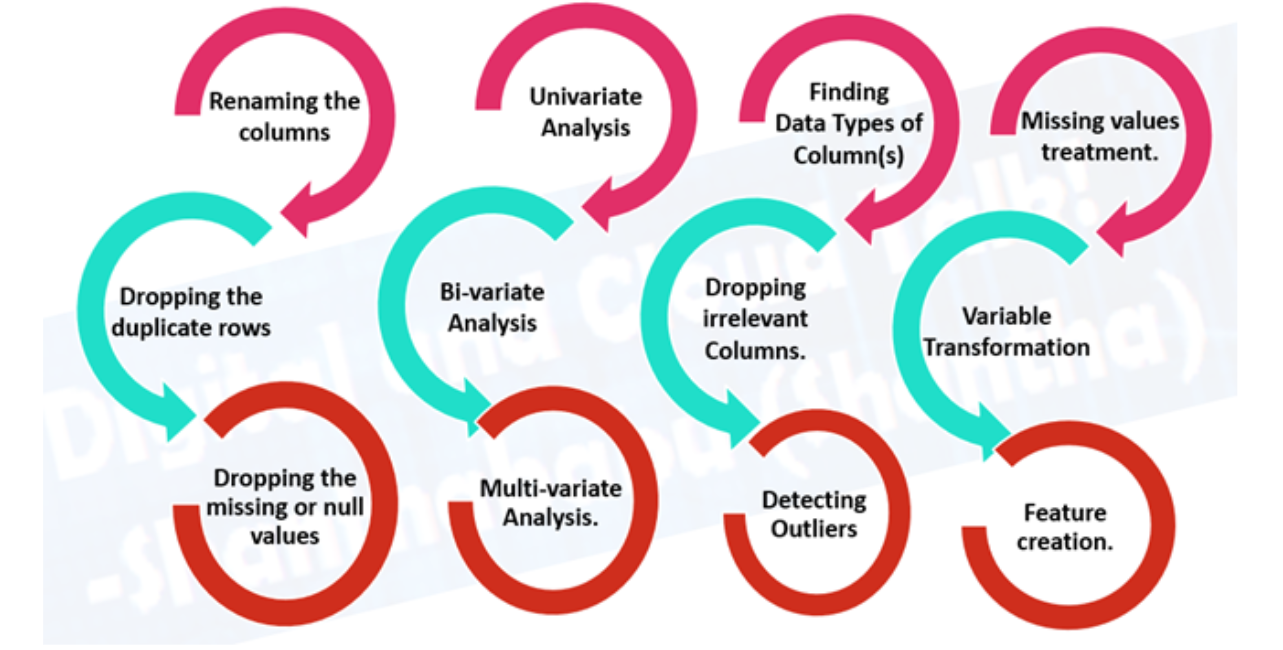
- Análise exploratória de dados (EDA), aprender sobre los datos con los que está trabajando
- ¿Cuáles son las variables de características (entrada) e o variávelEm estatística e matemática, uma "variável" é um símbolo que representa um valor que pode mudar ou variar. Existem diferentes tipos de variáveis, e qualitativo, que descrevem características não numéricas, e quantitativo, representando quantidades numéricas. Variáveis são fundamentais em experimentos e estudos, uma vez que permitem a análise de relações e padrões entre diferentes elementos, facilitando a compreensão de fenômenos complexos.... de destino (Saída)? Por exemplo, para predecir una enfermedad cardíaca, las variables características pueden ser la edad, el peso, la frecuencia cardíaca promedio y el nivel de actividad física de una persona. E a variável alvo será se têm ou não uma doença.
- Que tipo de tens? Séries temporais estruturadas, não estruturadas, numéricas. Faltam valores? Caso os elimine ou os complete, a função de imputação.
- Onde estão os valores atípicos? Quantos deles existem? Por que estão lá? Há alguma pergunta que possa fazer a um especialista na área sobre os dados? Por exemplo, Um médico especialista em doenças cardíacas poderia lançar alguma luz sobre o seu conjunto de dados de doenças cardíacas?
- Pré-processamento de dados, preparação dos seus dados para modelação.
- Função de imputação: preencher os valores em falta (um modelo de aprendizagem automática não pode aprender
em dados que não estão lá)
- Imputação única: Preencher com a média, uma mediana da coluna.
- Múltiplas imputações: Modele outros valores em falta com o que o seu modelo encontrar.
- KNN (k vizinhos mais próximos): Complete os dados com um valor de outro exemplo semelhante.
- Muito mais, como a imputação aleatória, a última observação levada em frente (para séries temporais), a média móvel e os mais frequentes.
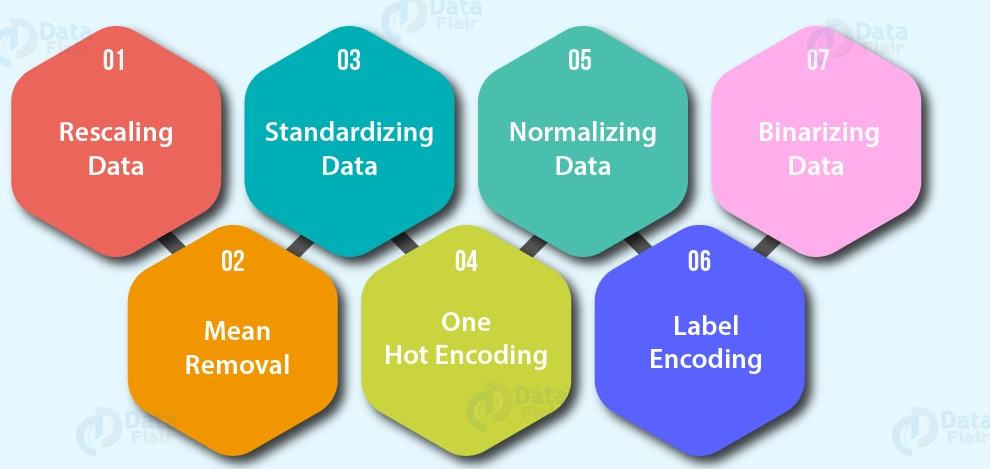
- Codificação de variáveis (converter valores em números). Um modelo de aprendizagem automática
exige que todos os valores sejam numéricos)
- Uma codificação quente: Converta todos os valores únicos em listas de zeros e uns onde o valor-alvo é 1 e o resto são zeros. Por exemplo, quando um carro é pintado de verde, vermelho, azul, verde, o futuro da cor do carro seria representado como [1, 0, e 0] e um vermelho seria [0, 1, e 0].
- Codificador de rótulos: Converta os rótulos em valores numéricos distintos. Por exemplo, se os seus objetivos forem animais diferentes, como cão, gato, pássaro, estes poderiam ser convertidos em 0, 1 e 2, respectivamente.
- Codificação de embedding: Aprenda uma representação entre todos os diferentes pontos de dados. Por exemplo, um modelo de linguagem é uma representação de como diferentes palavras se relacionam entre si. O embedding também está cada vez mais disponível para dados estruturados (tabulares).
- NormalizaçãoA padronização é um processo fundamental em várias disciplinas, que busca estabelecer padrões e critérios uniformes para melhorar a qualidade e a eficiência. Em contextos como engenharia, Educação e administração, A padronização facilita a comparação, Interoperabilidade e compreensão mútua. Ao implementar normas, a coesão é promovida e os recursos são otimizados, que contribui para o desenvolvimento sustentável e a melhoria contínua dos processos.... de funcionalidades (escalado) ou padronização: Quando as variáveis numéricas estão em escalas diferentes (por exemplo, o número_de_casas_de_banho está entre 1 e 5 e o tamanho_do_terreno entre 500 e 20000 pés quadrados), alguns algoritmos de aprendizagem automática não funcionam muito bem. A normalização e padronização ajudam a resolver este problema.
- Engenharia de funções: transformar os dados numa representação (potencialmente) mais significativa ao adicionar conhecimento do domínio
- Decompor
- Discretização: converter grupos grandes em grupos mais pequenos
- Funções de cruzamento e interação: combinação de duas ou mais funções
- As características do indicador: usar outras partes dos dados para indicar algo potencialmente significativo
- Seleção de recursos: selecionando
as características mais valiosas do seu conjunto de dados para modelar. Potencialmente reduzindo o tempo de TreinamentoO treinamento é um processo sistemático projetado para melhorar as habilidades, Conhecimento ou habilidades físicas. É aplicado em várias áreas, como esporte, Educação e desenvolvimento profissional. Um programa de treinamento eficaz inclui planejamento de metas, prática regular e avaliação do progresso. A adaptação às necessidades individuais e a motivação são fatores-chave para alcançar resultados bem-sucedidos e sustentáveis em qualquer disciplina.... e sobreajuste (menos dados gerais e menos dados redundantes para treinar) e melhorando a precisão.
- Redução de dimensionalidade: Um método comum de redução de dimensionalidade, PCA ou análise de componentes principais pega uma grande quantidade de dimensões (caracteristicas) e usa álgebra linear para reduzi-las a menos dimensões. Por exemplo, suponha que você tenha 10 funções numéricas, poderia executar PCA para reduzi-las a 3.
- Importância da função (modelagem posterior): Ajuste um modelo a um conjunto de dados, de seguida, inspecione quais características foram mais importantes para os resultados, remova as menos importantes.
- Métodos de envoltura como os algoritmos genéticos e a eliminação recursiva de características implicam criar grandes subconjuntos de opções de características e depois eliminar as que não são importantes.
- Lidar com os desequilíbrios: Os seus dados têm 10,000 exemplos de uma classe mas apenas 100 exemplos de outra?
- Recolha mais dados (se puder)
- Utilize o pacote scikit-learn-contrib imbalanced- aprender
- Utilize SMOTE: técnica sintética de sobremostragem de minorias. Cria amostras sintéticas da sua classe minoritária para tentar nivelar o campo de jogo.
- Um artigo útil para consultar é “Aprendendo com dados desequilibrados”.
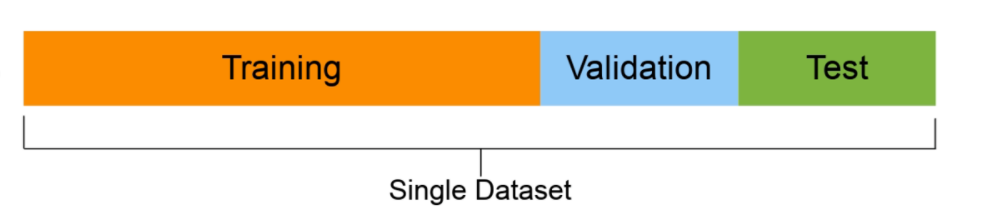
- Conjunto de treino (geralmente 70-80% dos dados): o modelo aprende sobre isto.
- Conjunto de validação (normalmente deste 10 al 15% dos dados): os hiperparâmetros do modelo são ajustados a este
- Conjunto de teste (normalmente entre o 10% e ele 15% dos dados): o desempenho final dos modelos é avaliado com base neste. Se tiver feito bem, espera-se que os resultados do conjunto de teste forneçam uma boa indicação de como o modelo deverá funcionar no mundo real. Não utilize este conjunto de dados para ajustar o modelo.
3. Treine o modelo com os dados (3 Passos: escolha um algoritmo, ajustar o modelo, reduza o ajuste com regularizaçãoA regularização é um processo administrativo que busca formalizar a situação de pessoas ou entidades que atuam fora do marco legal. Esse procedimento é essencial para garantir direitos e deveres, bem como promover a inclusão social e econômica. Em muitos países, A regularização é aplicada em contextos migratórios, Trabalhista e Tributário, permitindo que aqueles que estão em situação irregular tenham acesso a benefícios e se protejam de possíveis sanções....)
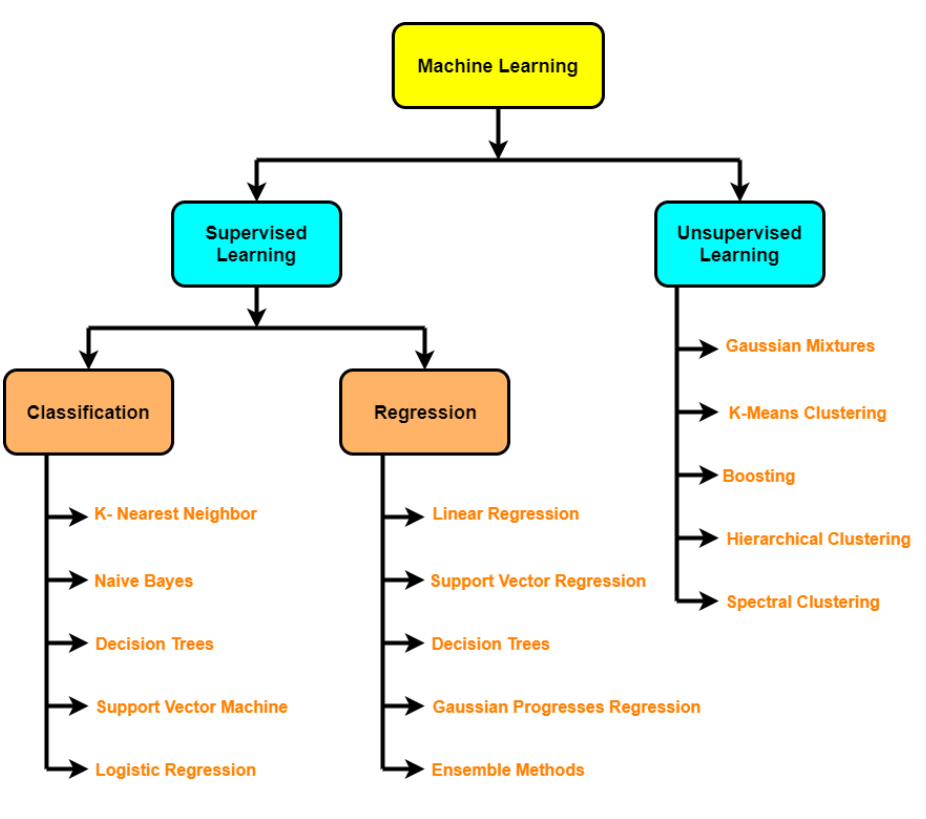
- Algoritmos supervisionados: regressão linear, Regressão logística, KNN, SVM, árvore de decisão e florestas aleatórias, AdaBoost / Gradient Boosting Machine (impulso)
- Algoritmos não supervisionados: agrupamentoo "agrupamento" É um conceito que se refere à organização de elementos ou indivíduos em grupos com características ou objetivos comuns. Este processo é usado em várias disciplinas, incluindo psicologia, Educação e biologia, para facilitar a análise e compreensão de comportamentos ou fenômenos. No campo educacional, por exemplo, O agrupamento pode melhorar a interação e o aprendizado entre os alunos, incentivando o trabalho.., redução de dimensionalidade (PCA, O desempenho é exibido como gráficos de dispersão e caixa, t-SNE), detecção de anomalia
- Aprendizagem por lotes
- Aprendizagem online
- Aprendizagem de transferência
- Aprendizagem ativa
- conjunto
- Desajuste – ocurre cuando su modelo no funciona tan bien como le gustaría en sus datos. Intente entrenar para un modelo más largo o más avanzado.
- Sobreajuste– ocurre cuando la pérdida de validación comienza a aumentar o cuando el modelo funciona mejor en el conjunto de entrenamiento que en el de prueba.
- Regularização: una colección de tecnologías para prevenir / reducir el sobreajuste (por exemplo, L1, L2, Abandono, Parada antecipada, Aumento de dados, Normalización de lotes)
- Ajuste de hiperparâmetros – Ejecute un montón de experimentos con diferentes configuraciones y vea cuál funciona mejor
4. Análise / Avaliação
- Classificação: precisão, precisão, Recuperação, F1, matriz de confusão, precisión media media (detecção de objeto)
- Regressão – MSE, MUITO DE, R ^ 2
- Métrica basada en tareas: por exemplo, para el automóvil autónomo, es posible que desee saber el número de desconexiones
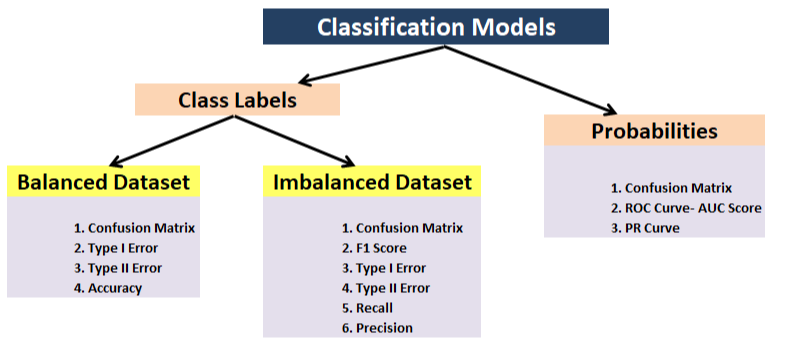
- Importância do recurso
- Treinamento / tiempo de inferencia / custo
- ¿Qué pasa si la herramienta: cómo se compara mi modelo con otros modelos?
- Exemplos menos seguros: Em que é que o modelo se engana?
- Compensação de viés / variância
5. Modelo de serviço (Implementação de um modelo)
- Coloca o modelo em Produção e vê como corre.
- Instrumentos que pode utilizar: TensorFlow Serving, PyTorch Serving, Google AI Platform, Sagemaker
- MLOps: onde a engenharia de software encontra o aprendizado automático, essencialmente toda a tecnologia necessária em torno de um modelo de aprendizado automático para que funcione em produção
6. Retrain do modelo
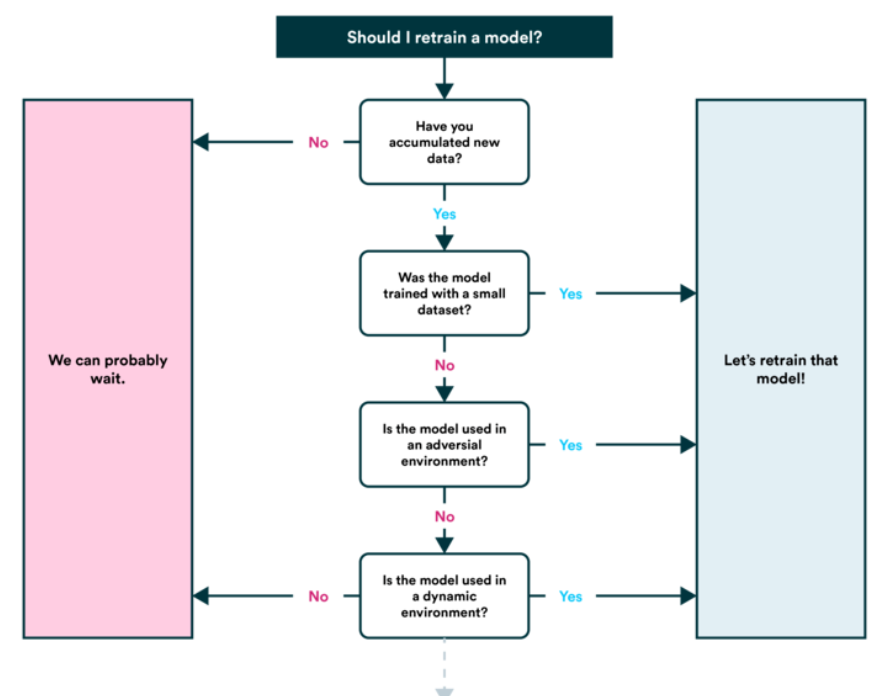
- Vê como o modelo funciona após a publicação (ou antes da publicação) com base em várias métricas de avaliação e volta a consultar os passos anteriores conforme necessário (lembrar, o aprendizado automático é muito experimental, por lo que aquí es donde querrá realizar un seguimiento de sus datos y experimentos.
- También encontrará que las predicciones de su modelo comienzan a 'envejecer’ (generalmente no en un estilo elegante) o 'derivar', como cuando las fuentes de datos cambian o se actualizan (nuevo hardware, etc.). Aquí es cuando querrás volver a entrenarlo.
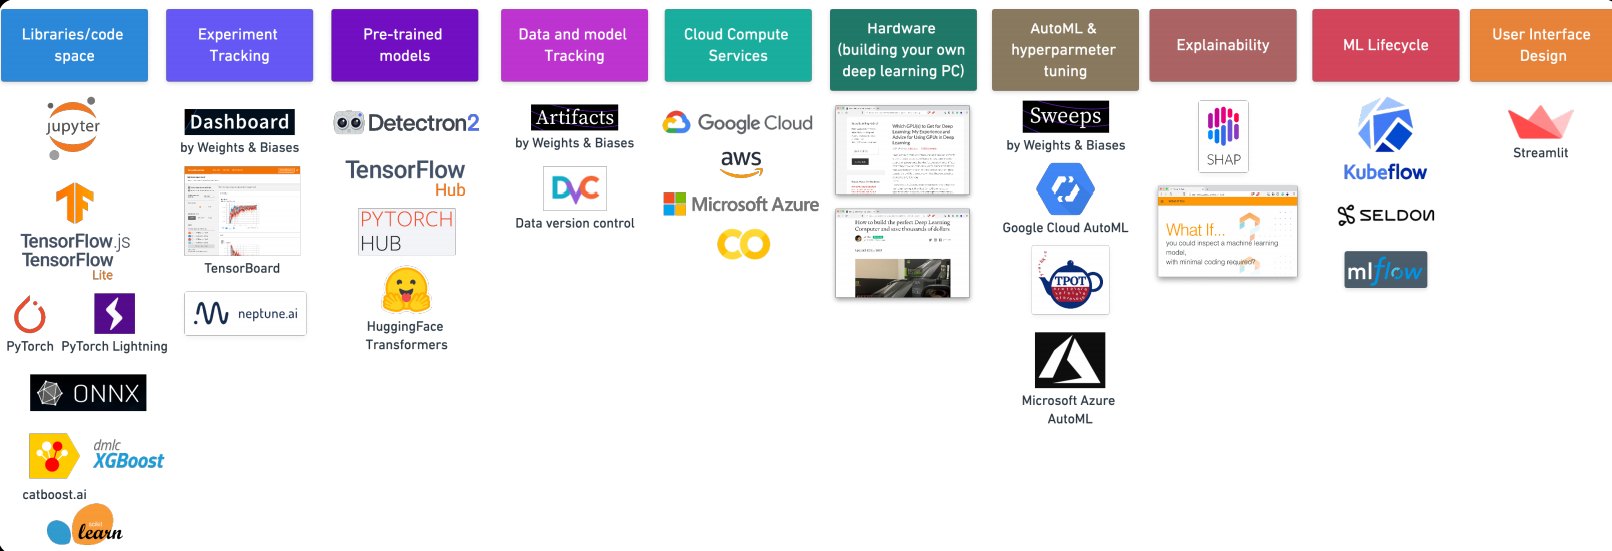
7. Herramientas de aprendizaje automático
Obrigado por ler isso. se você gosta deste item, Compartilhe com seus amigos. Em caso de alguma sugestão / dúvida, Comente abaixo.
Identificação de e-mail: [e-mail protegido]
Me siga no LinkedIn: LinkedIn
A mídia mostrada neste artigo não é propriedade da DataPeaker e é usada a critério do autor.





