
Desde a última década, temos visto a GPU surgir com mais frequência em áreas como HPC (Computação de alto desempenho) e no campo mais popular, quer dizer, os jogos. As GPUs têm melhorado ano após ano e agora são capazes de fazer coisas incrivelmente impressionantes, mas nos últimos anos têm captado ainda mais atenção devido ao aprendizado profundoAqui está o caminho de aprendizado para dominar o aprendizado profundo em, Uma subdisciplina da inteligência artificial, depende de redes neurais artificiais para analisar e processar grandes volumes de dados. Essa técnica permite que as máquinas aprendam padrões e executem tarefas complexas, como reconhecimento de fala e visão computacional. Sua capacidade de melhorar continuamente à medida que mais dados são fornecidos a ele o torna uma ferramenta fundamental em vários setores, da saúde....
Como os modelos de aprendizagem profunda passam muito tempo no TreinamentoO treinamento é um processo sistemático projetado para melhorar as habilidades, Conhecimento ou habilidades físicas. É aplicado em várias áreas, como esporte, Educação e desenvolvimento profissional. Um programa de treinamento eficaz inclui planejamento de metas, prática regular e avaliação do progresso. A adaptação às necessidades individuais e a motivação são fatores-chave para alcançar resultados bem-sucedidos e sustentáveis em qualquer disciplina...., mesmo CPUs potentes não eram suficientemente eficientes para lidar com tantos cálculos de uma só vez e esta é a área onde as GPUs simplesmente superaram as CPUs devido ao seu paralelismo. Mas antes de nos aprofundarmos, vamos primeiro entender algumas coisas sobre a GPU.
O que é a GPU?
Una GPU o ‘Unidad de procesamiento de gráficos’ es una versión mini de una computadora completa, pero solo dedicada a una tarea específica. Es diferente a una CPU que realiza múltiples tareas al mismo tiempo. La GPU viene con su propio procesador que está integrado en su propia placa base junto con v-ram o video ram, y también un diseño térmico adecuado para ventilación y enfriamiento.
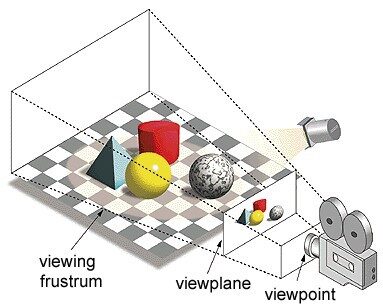
En el término ‘Unidad de procesamiento de gráficos’, ‘Gráficos’ se refiere a renderizar una imagen en coordenadas específicas en un espacio 2d o 3D. Una ventana o punto de vista es la perspectiva de un espectador de mirar un objeto según el tipo de proyección utilizada. La rasterización y el trazado de rayos son algunas de las formas de renderizar escenas en 3D, ambos conceptos se basan en un tipo de proyección llamada proyección en perspetiva. ¿Qué es la proyección en perspetiva?
Em resumo, es la forma en que se forma una imagen en un plano de vista o lienzo donde las líneas paralelas convergen a un punto convergente llamado 'centro de proyección’ también a medida que el objeto se aleja del punto de vista parece ser más pequeño , exatamente cómo se retratan nuestros ojos en el mundo real y esto también ayuda a comprender la profundidad de una imagen, esa es la razón por la que produce imágenes realistas.
O que mais, las GPU también procesan geometría compleja, vetor, fuentes de luz o iluminaciones, texturas, formas, etc. Como agora temos uma ideia básica sobre a GPU, entendamos por que ela é muito utilizada para o aprendizado profundo.
Por que as GPUs são melhores para o aprendizado profundo?
Uma das características mais admiradas de uma GPU é a capacidade de calcular processos em paralelo. Este é o ponto onde o conceito de computação paralela entra em ação. Uma CPU, em geral, completa sua tarefa de forma sequencial. Uma CPU pode ser dividida em núcleos e cada núcleo realiza uma tarefa de cada vez. Suponhamos que uma CPU tenha 2 núcleos. Mais tarde, dois processos de tarefas diferentes podem ser executados nesses dois núcleos, realizando assim multitarefa.
Mas mesmo assim, esses processos são executados em série.
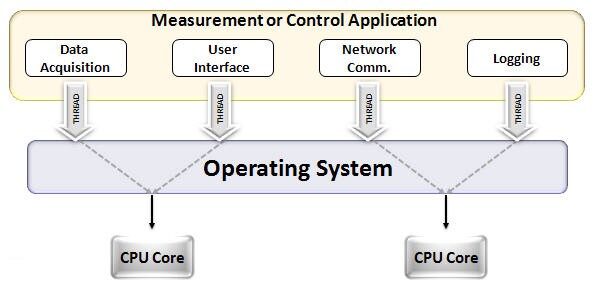
Isso não significa que as CPUs não sejam suficientemente boas. De fato, las CPU son realmente buenas para manejar diferentes tareas relacionadas con diferentes operaciones como manejar sistemas operativos, entregar hojas de cálculo, reproducir videos HD, extraer archivos zip grandes, Tudo ao mesmo tempo. Estas son algunas de las cosas que una GPU simplemente no puede hacer.
¿Dónde está la diferencia?
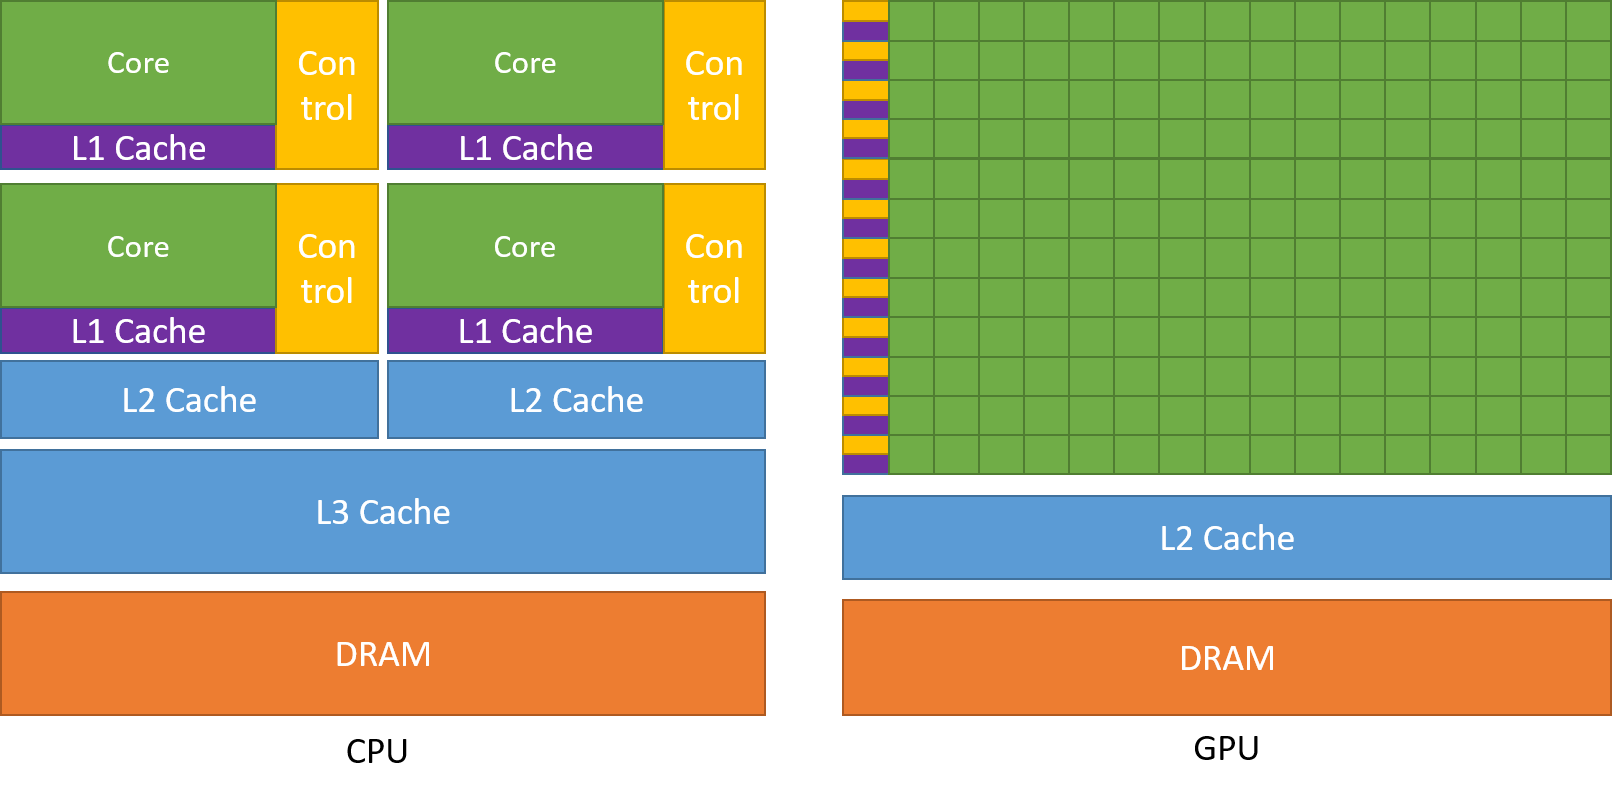
Como mencionado anteriormente, una CPU se divide en múltiples núcleos para que puedan realizar múltiples tareas al mismo tiempo, mientras que la GPU tendrá cientos y miles de núcleos, todos los cuales están dedicados a una sola tarea. Estos son cálculos simples que se realizan con más frecuencia y son independientes entre sí. Y ambos almacenan los datos requeridos con frecuencia en su respetiva memoria caché, siguiendo así el principio de ‘referencia de localidad‘.
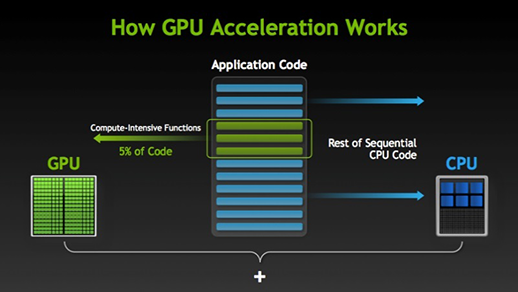
Hay muchos programas y juegos que pueden aprovechar las GPU para su ejecución. La idea detrás de esto es hacer que algunas partes de la tarea o el código de la aplicación sean paralelas, pero no todos los procesos. Esto se debe a que la mayoría de los procesos de la tarea solo deben ejecutarse de manera secuencial. Por exemplo, Começar sessãoo "Sessão" É um conceito-chave no campo da psicologia e da terapia. Refere-se a uma reunião agendada entre um terapeuta e um cliente, onde os pensamentos são explorados, Emoções e comportamentos. Essas sessões podem variar em duração e frequência, e seu principal objetivo é facilitar o crescimento pessoal e a resolução de problemas. A eficácia das sessões depende da relação entre o terapeuta e o terapeuta.. en un sistema o aplicación no necesita ser paralelo.
Cuando hay parte de la ejecución que se puede hacer en paralelo, simplemente se cambia a GPU para su procesamiento, donde al mismo tiempo se ejecuta la tarea secuencial en la CPU, luego ambas partes de la tarea se combinan nuevamente.
En el mercado de GPU, hay dos jugadores principales, quer dizer, AMD y Nvidia. Las GPU de Nvidia se utilizan ampliamente para el aprendizaje profundo porque tienen un amplio soporte en el software del foro, los controladores, CUDA y cuDNN. Então, en términos de inteligencia artificial y aprendizaje profundo, Nvidia es pionera durante mucho tiempo.
Se dice que las redes neuronales son vergonzosamente paralelo, lo que significa que los cálculos en redes neuronales se pueden ejecutar en paralelo fácilmente y son independientes entre sí.
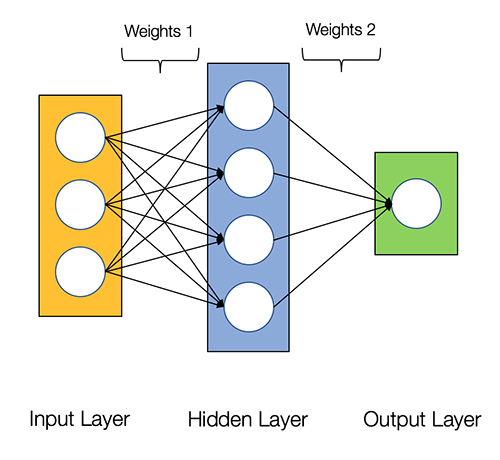
Algunos cálculos como el cálculo de pesos y funciones de activación de cada capa, la retropropagación se pueden realizar en paralelo. También hay muchos artículos de investigación disponibles al respecto.
Las GPU de Nvidia vienen con núcleos especializados conocidos como MILAGRES núcleos que ajudam a acelerar o aprendizado profundo.
O que é CUDA?
CUDA significa 'Compute Unified Device Architecture'’ que foi lançado no ano 2007, é uma forma de conseguir computação em paralelo e obter o máximo desempenho da potência da sua GPU de maneira otimizada, o que resulta num desempenho muito melhor ao executar tarefas.
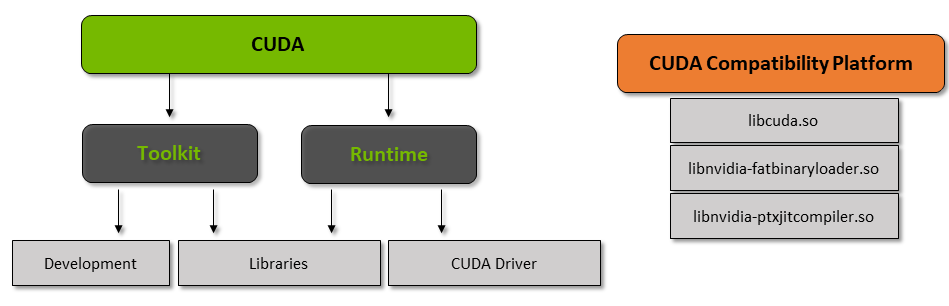
O kit de ferramentas CUDA é um pacote completo que consiste num ambiente de desenvolvimento usado para criar aplicações que utilizam GPU. Este kit de ferramentas contém principalmente o compilador, o depurador e as bibliotecas de C / c ++. O que mais, o tempo de execução do CUDA tem os seus drivers para que possa comunicar-se com a GPU. CUDA também é uma linguagem de programação que foi projetada especificamente para instruir a GPU a realizar uma tarefa. Também é conhecida como programação de GPU.
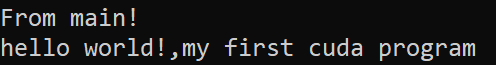
A seguir é apresentado um programa simples de olá mundo apenas para ter uma ideia de como o código CUDA se parece.
/* programa ola mundo em cuda *
#incluir<stdio.h>
#incluir<stdlib.h>
#incluir<cuda.h>__global__ void demo() {
    printf("Olá, mundo!,meu primeiro programa cuda");
}int main() {
    printf("Do main!n");
    demo<<<1,1>>>();
    Retorna 0;
}
O que é cuDNN?
cuDNN é uma biblioteca de neuronal vermelhoAs redes neurais são modelos computacionais inspirados no funcionamento do cérebro humano. Eles usam estruturas conhecidas como neurônios artificiais para processar e aprender com os dados. Essas redes são fundamentais no campo da inteligência artificial, permitindo avanços significativos em tarefas como reconhecimento de imagem, Processamento de linguagem natural e previsão de séries temporais, entre outros. Sua capacidade de aprender padrões complexos os torna ferramentas poderosas.. que é otimizada para GPU e pode aproveitar ao máximo a GPU da Nvidia. Esta biblioteca consiste na implementação de convolução, propagação para frente e para trás, funções de ativação e pooling. É uma biblioteca imprescindível sem a qual não se pode usar GPU para treinar redes neuronais.
Um grande salto com os núcleos Tensor!
No ano 2018, A Nvidia lançou uma nova linha das suas GPUs, quer dizer, a série 2000. Também chamadas RTX, Estas placas vêm com núcleos tensor dedicados ao aprendizado profundo e baseados na arquitetura Volta.
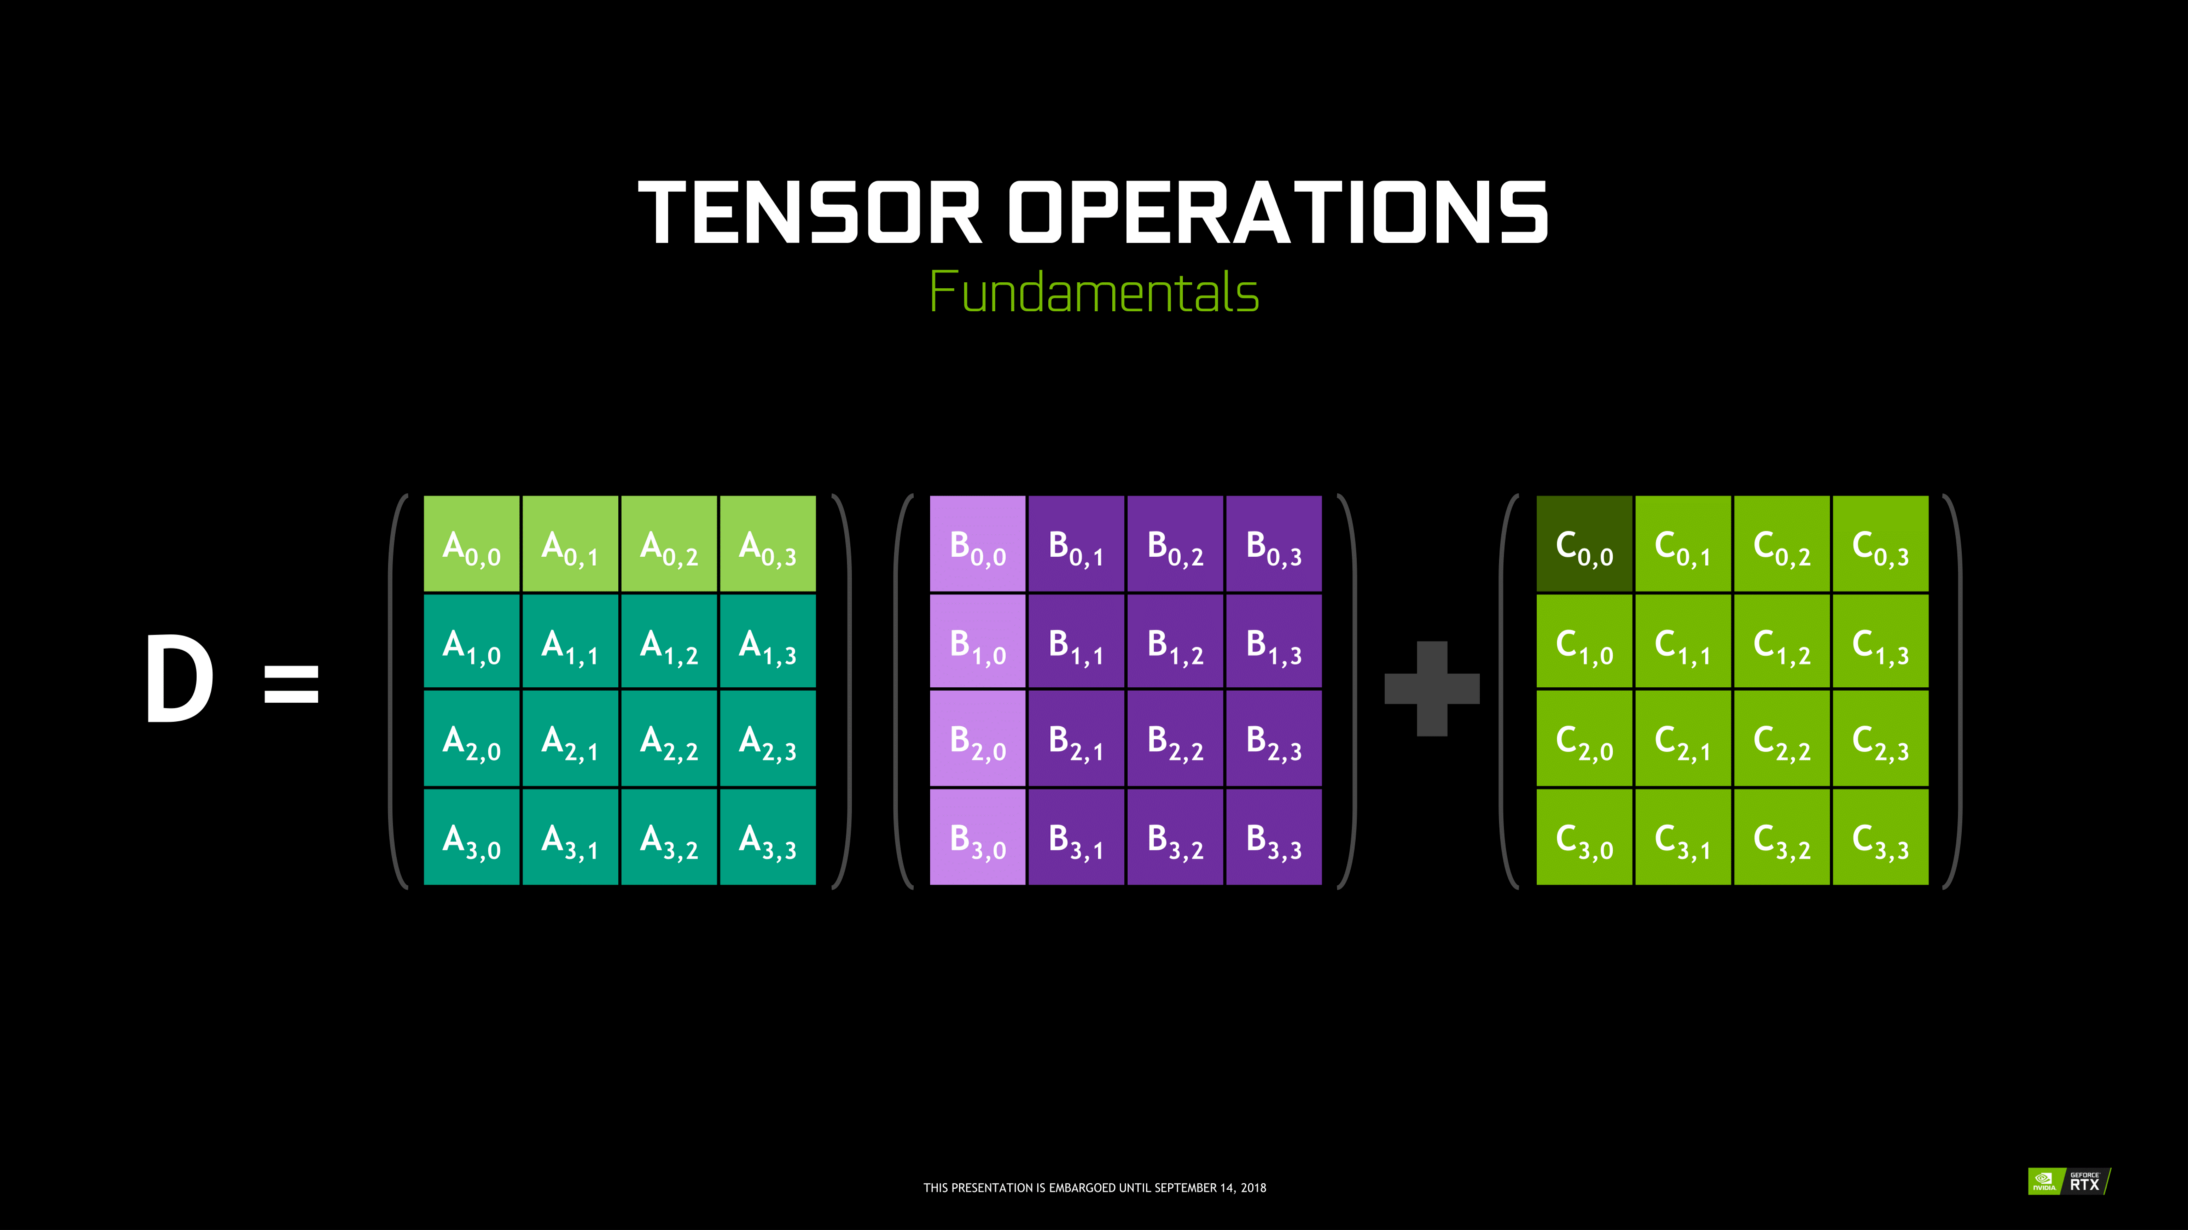
Os núcleos tensor são núcleos particulares que realizam a multiplicação de matrizes 4 x 4 FP16 e a soma com 4 x 4 matriz FP16 ou FP32 em precisão média, a saída resultará numa matriz 4 x 4 FP16 ou FP32 com total precisão.
Observação: ‘FP’ significa ponto flutuante para compreender melhor o ponto flutuante e a precisão, verifique isto Blog.
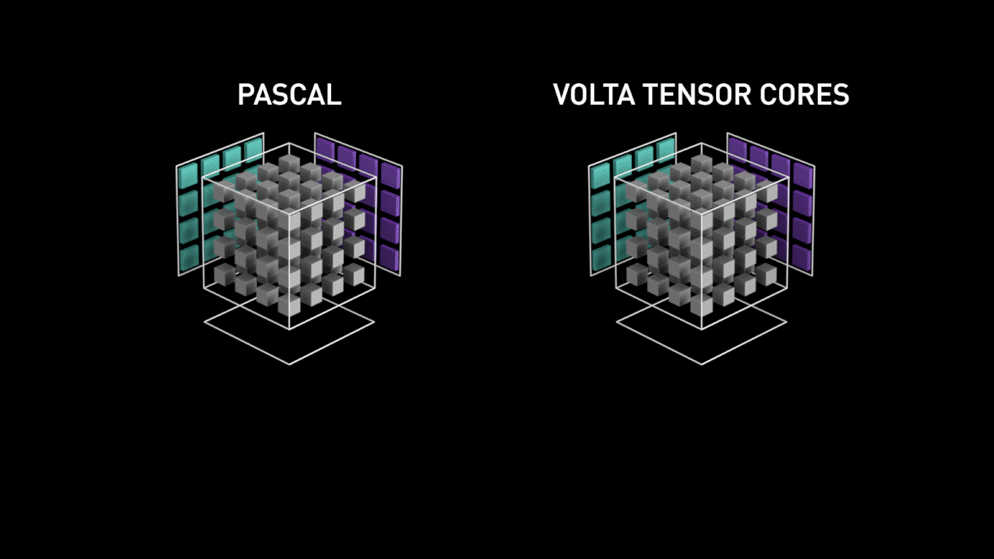
Como afirma a Nvidia, los núcleos tensoriales de nueva generación basados en la arquitetura volta son mucho más rápidos que los núcleos CUDA basados en la arquitetura Pascal. Esto dio un gran impulso al aprendizaje profundo.
Al momento de escribir este blog, Nvidia anunció la última série 3000 de su línea de GPU que viene con arquitetura Ampere. Nisto, mejoraron el rendimiento de los núcleos tensoriales en 2x. También trae nuevos valores de precisión como TF32 (tensorOs tensores são estruturas matemáticas que generalizam conceitos como escalares e vetores. São utilizados em diversas disciplinas, incluindo física, engenharia e aprendizagem automática, para representar dados multidimensionais. Um tensor pode ser visualizado como uma matriz de múltiplas dimensões, o que permite modelar relações complexas entre diferentes variáveis. A sua versatilidade e capacidade para lidar com grandes volumes de informação tornam-no uma ferramenta fundamental na análise e processamento de dados.... flutuador 32), FP64 (punto flotante 64). El TF32 funciona igual que el FP32 pero con una aceleración de hasta 20x, como resultado de todo esto, Nvidia afirma que el tiempo de inferencia o entrenamiento de los modelos se reducirá de semanas a horas.
AMD frente a Nvidia
AMD As GPUs são decentes para jogos, mas assim que o deep learning entra em cena, crie uma nova consulta e carregue a tabela InvOverRides do arquivo excel Nvidia estão muito à frente. Não significa que as GPUs da AMD sejam más. É devido à otimização do software e aos drivers que não são atualizados ativamente, No lado da Nvidia têm melhores drivers com atualizações frequentes e em cima disso o CUDA, cuDNN ajuda a acelerar os cálculos.
Algumas bibliotecas conhecidas como Tensorflow, compatibilidade com PyTorch para CUDA. Significa que se podem usar GPUs de entrada da série GTX 1000. Do lado da AMD, tem muito pouco suporte de software para as suas GPUs. No lado do hardware, A Nvidia introduziu núcleos tensores dedicados. A AMD tem ROCm para aceleração, mas não é tão bom como núcleos tensoriais, e muitas bibliotecas de aprendizagem profunda não são compatíveis com ROCm. Nos últimos anos, não foi notado nenhum grande salto em termos de desempenho.
Devido a todos estes pontos, A Nvidia simplesmente sobressai na aprendizagem profunda.
Resumo
Para concluir tudo o que aprendemos, fica claro que a partir de agora a Nvidia é o líder do mercado em termos de GPU, mas realmente espero que até a AMD consiga acompanhar no futuro ou pelo menos faça algumas melhorias notáveis na próxima linha das suas GPUs. já que estão a fazer um trabalho excelente em relação aos seus CPUs, quer dizer, a série Ryzen.
O alcance das GPUs nos próximos anos é enorme à medida que realizamos novas inovações e avanços em aprendizagem profunda, aprendizagem automática e HPC. A aceleração por GPU será sempre útil para que muitos desenvolvedores e estudantes entrem neste campo, já que os seus preços também estão a tornar-se mais acessíveis. Também graças à ampla comunidade que também contribui para o desenvolvimento de IA e HPC.
Prathmesh Patil
Entusiasta da aprendizagem automática, ciência de dados, desenvolvedor de Python.
LinkedIn: https://www.linkedin.com/in/prathmesh





