
Introdução
Neste artigo, examinaremos o popular conjunto de dados do Titanic e tentaremos prever se uma pessoa sobreviveu ao naufrágio. Você pode obter este conjunto de dados do Kaggle, ligado aqui. Este artigo se concentrará em como pensar sobre esses projetos, mais do que na implementação. Muitos dos iniciantes estão confusos sobre como começar, quando terminar e tudo mais, Espero que este artigo sirva como um manual do iniciante para você.. Eu sugiro que você pratique o projeto no Kaggle.
O objetivo: prever se um passageiro sobreviveu ou não. 0 por não sobreviver, 1 Para sobreviver.
Descrever os dados
Neste artigo, faremos uma análise básica de dados, em seguida, um pouco de engenharia de recursos e, ao final, usaremos alguns dos modelos populares para previsão. Comecemos.
Análise de dados
Paso 1: Importação de bibliotecas básicas
import numpy as np
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt
%matplotlib inline
Paso 2: ler os dados
treinamento = pd.read_csv('/kaggle/input/titanic/train.csv')
test = pd.read_csv('/kaggle/input/titanic/test.csv')
Treinamento['train_test'] = 1
teste['train_test'] = 0
teste['Survived'] = np.NaN
all_data = pd.concat([Treinamento,teste])
all_data.colunas
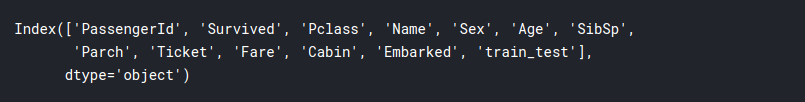
Paso 3: exploração de dados
Nesta secção, tentaremos extrair insights dos dados e nos familiarizarmos com eles, a fim de criar modelos mais eficientes.
training.info()
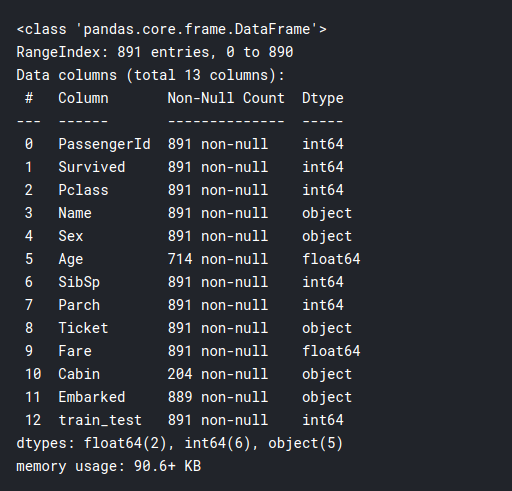
treinamento.descrever()
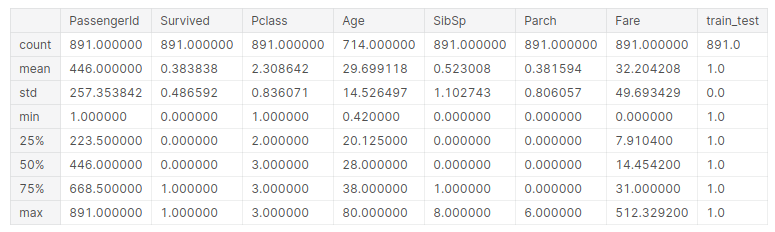
# seperate the data into numeric and categorical
df_num = training[['Age','SibSp','Parch','Tarifa']]
df_cat = treinamento[['Survived','Pclass','Sex','Ticket','Cabin','Embarked']]
Agora vamos fazer gráficos dos dados numéricos:
para i em df_num.colunas:
    plt.hist(df_num[eu])
    plt.title(eu)
    plt.show()
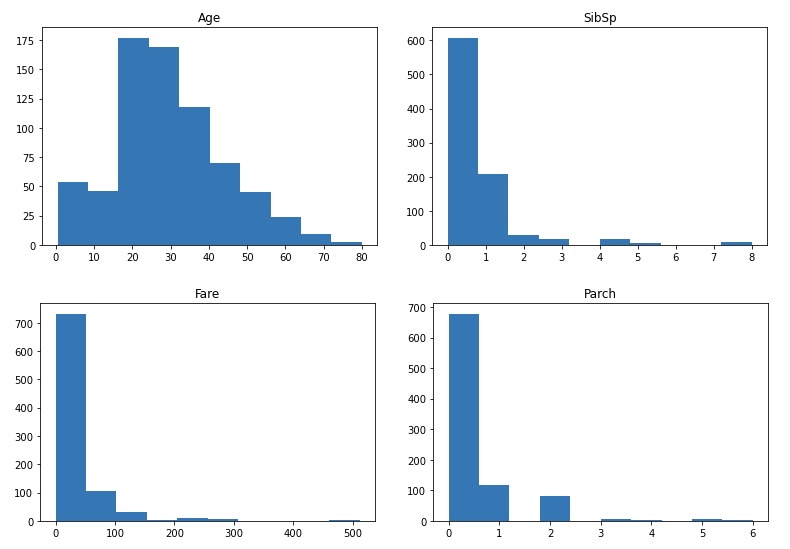
Então, como você pode ver, a maioria das distribuições estão espalhadas, exceto idade, é bastante normalizado. Podemos considerar normalizá-los mais tarde. A seguir, desenhamos um mapa de caloruma "mapa de calor" é uma representação gráfica que usa cores para mostrar a densidade de dados em uma área específica. Comumente usado em análise de dados, Estudos de marketing e comportamentais, Esse tipo de visualização permite identificar padrões e tendências rapidamente. Através de variações cromáticas, Os mapas de calor facilitam a interpretação de grandes volumes de informações, ajudando a tomar decisões informadas.... Correlação entre colunas numéricas:
sns.heatmap(df_num.corr())
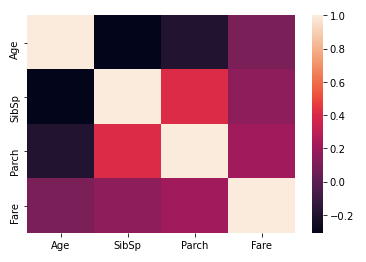
Aqui podemos ver que Parch e SibSp têm uma correlação mais alta, o que geralmente faz sentido, pois os pais são mais propensos a viajar com seus vários filhos e os cônjuges tendem a viajar juntos. A seguir, vamos comparar as taxas de sobrevivência entre as variáveis numéricas. Isso pode revelar algumas ideias interessantes:
pd.pivot_table(Treinamento, index = 'Survived', valores = ['Age','SibSp','Parch','Tarifa'])
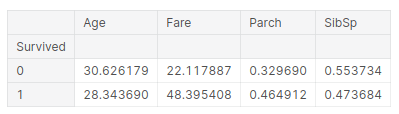
A inferência que podemos tirar desta tabela é:
- A idade média dos sobreviventes é 28 anos, então os jovens tendem a sobreviver mais.
- Pessoas que pagavam taxas mais altas tinham mais probabilidade de sobreviver, mais que o dobro. Estas podem ser as pessoas que viajam de primeira classe. É assim que os ricos sobreviviam, que é uma história triste neste palco.
- Na terceira coluna, se você tem pais, tem uma chance maior de sobreviver. Então, os pais poderiam ter salvado os filhos antes de si mesmos, explicando assim as taxas
- E se você é criança e tem irmãos, você tem menos chance de sobreviver.
Agora fazemos algo semelhante com nossas variáveis categóricas:
para i em df_cat.columns:
    sns.barplot(df_cat[eu].valor_contas().índice,df_cat[eu].valor_contas()).set_title(eu)
    plt.show()
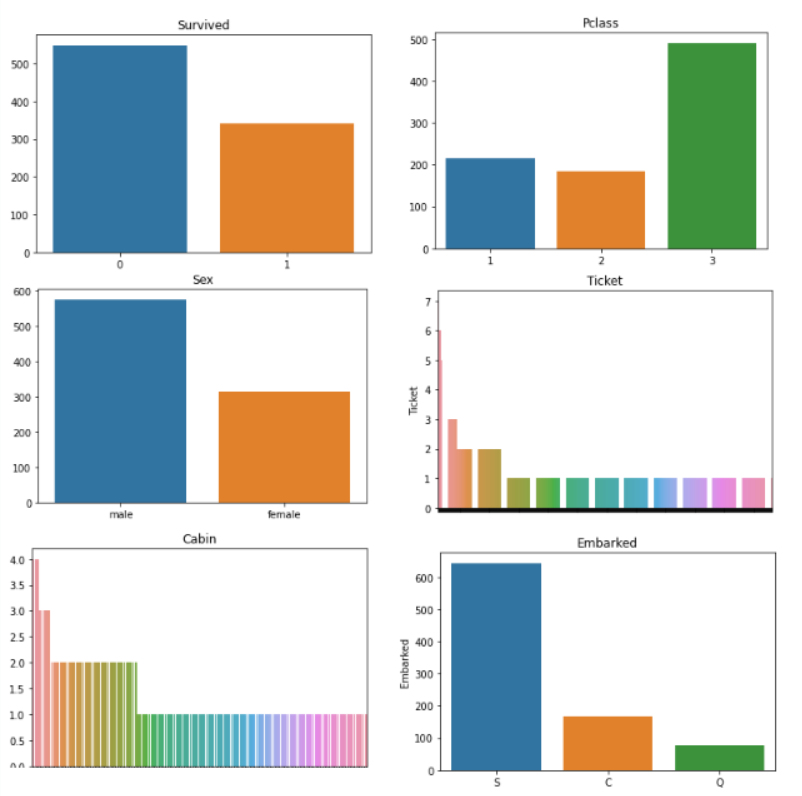
Os gráficos dos ingressos e da cabine parecem muito bagunçados, Podemos ter que projetá-los! Além disso, o resto dos gráficos nos dizem:
- Sobreviveu: a maioria das pessoas morreu no naufrágio, apenas alguns 300 pessoas sobreviveram.
- Pclass: A maioria das pessoas que estavam viajando tinha passagens para a 3ª classe.
- Sexo: havia mais homens do que mulheres a bordo do navio, cerca do dobro da quantidade.
- Embarcou: A maioria dos passageiros embarcou no navio de Southampton.
Agora faremos algo semelhante ao tabela dinâmicaA Tabela Dinâmica é uma ferramenta poderosa em programas de planilhas, como o Microsoft Excel e o Google Sheets. Permite resumir, Analise e visualize grandes volumes de dados com eficiência. Através de sua interface intuitiva, Os usuários podem reorganizar as informações, Aplique filtros e crie relatórios personalizados, facilitar a tomada de decisões informadas em vários contextos, do campo empresarial à pesquisa acadêmica.... anterior, mas com nossas variáveis categóricas, e compará-los com o nosso variávelEm estatística e matemática, uma "variável" é um símbolo que representa um valor que pode mudar ou variar. Existem diferentes tipos de variáveis, e qualitativo, que descrevem características não numéricas, e quantitativo, representando quantidades numéricas. Variáveis são fundamentais em experimentos e estudos, uma vez que permitem a análise de relações e padrões entre diferentes elementos, facilitando a compreensão de fenômenos complexos.... dependente, e se as pessoas sobrevivessem:
imprimir(pd.pivot_table(Treinamento, index = 'Survived', colunas ="Pclass",
                     valores ="Bilhete" ,aggfunc ="contar"))
imprimir()
imprimir(pd.pivot_table(Treinamento, index = 'Survived', colunas ="Sexo",
                     valores ="Bilhete" ,aggfunc ="contar"))
imprimir()
imprimir(pd.pivot_table(Treinamento, index = 'Survived', colunas ="Embarcou",
                     valores ="Bilhete" ,aggfunc ="contar"))
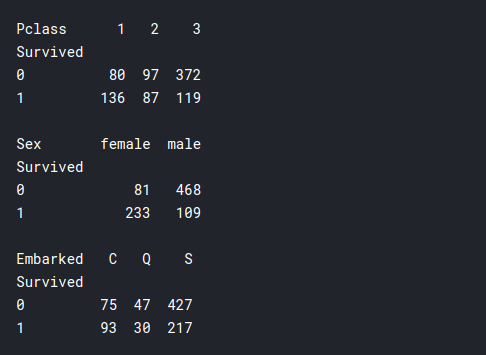
- Pclass: Aqui podemos ver que muito mais pessoas sobreviveram da primeira classe do que da segunda ou terceira classe., embora o número total de passageiros na primeira classe fosse muito menor do que na terceira classe. Portanto, aqui, nossa suposição anterior de que os ricos sobreviveram é confirmada, o que pode ser relevante para a construção do modelo.
- Sexo: a maioria das mulheres sobreviveu e a maioria dos homens morreu no naufrágio. Portanto, parece que o ditado “Mulher e filhos primeiro” realmente se aplica neste cenário.
- Embarcou: Isso não parece muito relevante, talvez se alguém fosse de “Cherburgo"Eu tive uma chance maior de sobreviver.
Paso 4: Engenharia de funções
Nós vimos que nosso bilhete e cabine os dados realmente não fazem sentido para nós, e isso pode prejudicar o desempenho do nosso modelo, então temos que simplificar alguns desses dados com a engenharia de funções.
Se olharmos para os dados reais da cabine, vemos que basicamente há uma letra e um número. Letras podem significar que tipo de cabine é, onde você está no navio, em qual andar, para que classe é isso, etc. E os números podem significar o número da cabine. Vamos primeiro dividi-los em cabines individuais e ver se alguém tinha mais de um táxi.
df_cat.Cabin
training['cabin_multiple'] = treinamento. Cabine.apply(lambda x: 0 se pd.isna(x)
                                                    mais len(x.split(' ')))
Treinamento['cabin_multiple'].valor_contas()
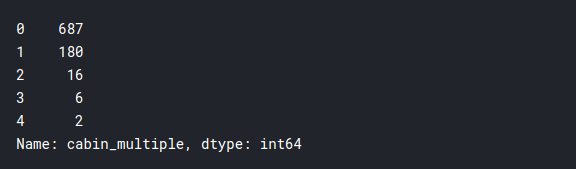
Parece que a grande maioria não tinha cabines individuais, e apenas algumas pessoas tinham mais de uma cabine. Agora vamos ver se as taxas de sobrevivência dependem disso.:
pd.pivot_table(Treinamento, index = 'Survived', colunas ="cabin_multiple",
               valores ="Bilhete" ,aggfunc ="contar")
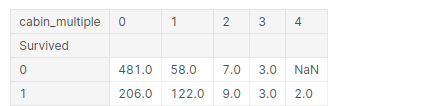
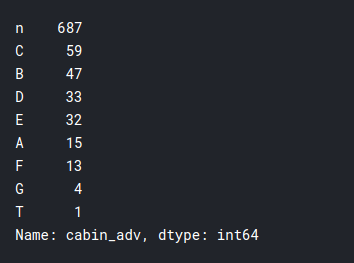
A seguir, vamos ver a caligrafia real da cabine em que eles estavam. Portanto, você pode esperar cabines com a mesma letra para estar em aproximadamente os mesmos locais ou nos mesmos andares e, logicamente, se uma cabine estava perto de botes salva-vidas, tinha uma chance melhor de sobreviver. Vamos dar uma olhada nisso.:
# n significa nulo
# in this case we will treat null values like it's own category
training['cabin_adv'] = treinamento. Cabine.apply(lambda x: str(x)[0])
#comparing survival rates by cabin
print(training.cabin_adv.value_counts())
pd.pivot_table(Treinamento,index='Survived',colunas ="cabin_adv",
                        valores ="Nome", aggfunc ="contar")
Eu fiz alguma engenharia futura no bilhete coluna e não produziu muitos insights importantes, que ainda não sabemos, então vou pular essa parte para manter o artigo conciso. Vamos simplesmente dividir os tíquetes em numéricos e não numéricos para uso eficiente:
Treinamento['numeric_ticket'] = training.Ticket.apply(lambda x: 1 se x.isnumeric() outro 0)
Treinamento['ticket_letters'] = training.Ticket.apply(lambda x: ''.join(x.split(' ')[:-1])
                                            .substituir('.','').substituir('/','')
                                            .diminuir() se len(x.split(' ')[:-1]) >0 outro 0)
Outra coisa interessante que podemos observar é o título de passageiros individuais. E se ele desempenhou algum papel em conseguir um assento para eles nos botes salva-vidas.
training.Name.head(50)
Treinamento['name_title'] = treinamento.Nome.aplicar(lambda x: x.split(',')[1]
                                                        .dividir('.')[0].faixa())
Treinamento['name_title'].valor_contas()
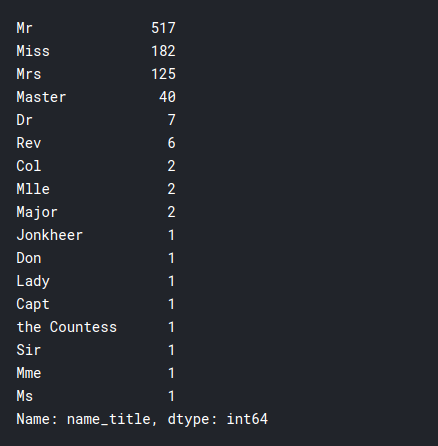
Como você pode ver, o navio foi abordado por pessoas de muitas classes diferentes, isso pode ser útil em nosso modelo.
Paso 5: pré-processamento de dados para o modelo
Neste segmento, preparamos nossos dados para modelos. Os objetivos que devemos cumprir estão listados abaixo:
- Remova os valores nulos da coluna Enviado
- Incluir apenas dados relevantes
- Transforme categoricamente todos os dados, usando algo chamado transformador.
- Imputando dados com tendências centrais por idade e taxa.
- Normalize o avaliar coluna para ter uma distribuição mais normal.
- usando dados de escala padrão 0-1
Paso 6: Implementação de modelo
Aqui vamos simplesmente implementar os vários modelos com parametroso "parametros" são variáveis ou critérios usados para definir, medir ou avaliar um fenômeno ou sistema. Em vários domínios, como a estatística, Ciência da Computação e Pesquisa Científica, Os parâmetros são essenciais para estabelecer normas e padrões que orientam a análise e interpretação dos dados. Sua seleção e manuseio adequados são cruciais para obter resultados precisos e relevantes em qualquer estudo ou projeto.... padrões e veja qual deles produz o melhor resultado. Os modelos podem ser ajustados para melhor desempenho, mas eles não estão no escopo deste artigo. Os modelos que vamos rodar são:
- Regressão logística
- Vizinho mais próximo
- Classificador de vetor de suporte
Primeiro, nós importamos os modelos necessários
from sklearn.model_selection import cross_val_score
from sklearn.linear_model import LogisticRegression
from sklearn.neighbors import KNeighborsClassifier
from sklearn.svm import SVC
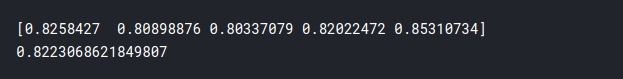
1) Regressão logística
lr = LogisticRegression(max_iter = 2000)
cv = cross_val_score(lr,X_train_scaled,y_train,cv = 5)
imprimir(cv)
imprimir(cv.média())
2) Vizinho mais próximo
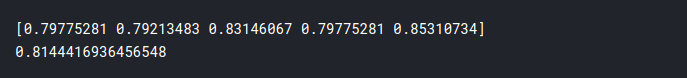
knn = KNeighborsClassifier()
cv = cross_val_score(em,X_train_scaled,y_train,cv = 5)
imprimir(cv)
imprimir(cv.média())
3) Classificador de vetor de suporte
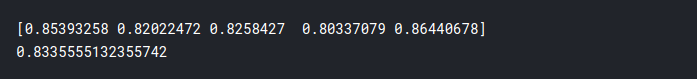
svc = SVC(probabilidade = Verdadeiro)
cv = cross_val_score(Svc,X_train_scaled,y_train,cv = 5)
imprimir(cv)
imprimir(cv.média())
Por tanto, la precisión de los modelos es:
- Regressão logística: 82,2%
- Vizinho mais próximo: 81,4%
- SVC: 83,3%
Como você pode ver, obtemos precisão decente com todos os nossos modelos, mas o melhor é SVC. E pronto, é assim que você concluiu seu primeiro projeto de ciência de dados! Embora muito mais possa ser feito para obter melhores resultados, isso é mais do que suficiente para você começar e ver como pensa como um cientista de dados. Espero que este tutorial tenha ajudado você, Eu me diverti muito fazendo o projeto sozinha e espero que você goste também. Saúde!!





