
Este artigo foi publicado como parte do Data Science Blogathon
Introdução
Neste artigo, aprenderemos como uma das técnicas de aprendizado profundoAqui está o caminho de aprendizado para dominar o aprendizado profundo em, Uma subdisciplina da inteligência artificial, depende de redes neurais artificiais para analisar e processar grandes volumes de dados. Essa técnica permite que as máquinas aprendam padrões e executem tarefas complexas, como reconhecimento de fala e visão computacional. Sua capacidade de melhorar continuamente à medida que mais dados são fornecidos a ele o torna uma ferramenta fundamental em vários setores, da saúde... utilizadas para encontrar a precisão de Conjunto de dados de câncer de mama, mas eu sei que a maioria dos técnicos não sabe do que estamos falando, começaremos do básico e, em seguida, passaremos ao nosso tópico. Em primeiro lugar, faremos uma breve introdução ao aprendizado profundo e, em seguida,, o que é o neuronal vermelhoAs redes neurais são modelos computacionais inspirados no funcionamento do cérebro humano. Eles usam estruturas conhecidas como neurônios artificiais para processar e aprender com os dados. Essas redes são fundamentais no campo da inteligência artificial, permitindo avanços significativos em tarefas como reconhecimento de imagem, Processamento de linguagem natural e previsão de séries temporais, entre outros. Sua capacidade de aprender padrões complexos os torna ferramentas poderosas.. artificial?
O que é aprendizado profundo?
Se falarmos sobre aprendizagem profunda, apenas entenda que é um subconjunto ou subparte do aprendizado de máquina. Podemos dizer que a aprendizagem profunda é uma função de IA que imita o cérebro humano e processa esses dados e cria padrões para usar na tomada de decisões.
Aprendizado profundo é o tipo de aprendizado de máquina semelhante ao cérebro humano. Usa uma estrutura de várias camadas de algoritmos chamados redes neurais. Seus algoritmos tentam copiar os dados que os humanos estariam analisando com uma certa estrutura lógica. Também conhecido como rede neural profunda ou aprendizado neural profundo.
No aprendizado profundo, existe um conceito chamado Rede Neural Artificial, que discutiremos brevemente a seguir.:
Neuronal vermelho artificial
Como o nome sugere, rede neural artificial, é a rede de neurônios artificiais. Refere-se a um modelo inspirado biologicamente no cérebro. Podemos dizer que geralmente é uma rede computacional baseada em redes neurais biológicas que constroem a estrutura do cérebro humano.
Todos vocês sabem que os neurônios estão interconectados entre si em nosso cérebro e o processo de transmissão de dados. É semelhante aos neurônios do cérebro humano que estão interconectados uns com os outros, a rede neural consiste em um grande número de neurônios artificiais, chamadas unidades organizadas em uma sequência de camadas. tendo as várias camadas de neurônios e formando uma rede completa. esses neurônios são chamados de nós.
Consiste em três camadas que são:
- Camada de entradao "camada de entrada" refere-se ao nível inicial em um processo de análise de dados ou em arquiteturas de redes neurais. Sua principal função é receber e processar informações brutas antes de serem transformadas por camadas subsequentes. No contexto do aprendizado de máquina, A configuração adequada da camada de entrada é crucial para garantir a eficácia do modelo e otimizar seu desempenho em tarefas específicas....
- Manto oculto
- Camada de saídao "Camada de saída" é um conceito utilizado no campo da tecnologia da informação e design de sistemas. Refere-se à última camada de um modelo ou arquitetura de software que é responsável por apresentar os resultados ao usuário final. Essa camada é crucial para a experiência do usuário, uma vez que permite a interação direta com o sistema e a visualização dos dados processados....
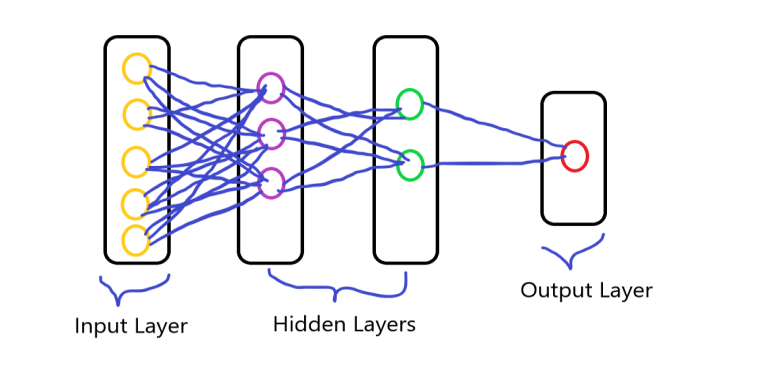
Criar RNA usando um conjunto de dados de câncer de mama
Agora passamos ao nosso tópico, aqui vamos pegar o conjunto de dados e, em seguida, criar a rede neural artificial e classificar o diagnóstico, primeiro, pegamos um conjunto de dados de câncer de mama e seguimos em frente.
Conjunto de dados: Conjunto de dados de câncer de mama
Depois de baixar o conjunto de dados, nós importaremos as bibliotecas importantes que são necessárias para processamento posterior.
Bibliotecas de importação
#importar pandas
importar pandas como pd
#import numpy
importar numpy como np
import matplotlib.pyplot as plt
importado do mar como sb
Aqui nós importamos pandas, NumPy e algumas bibliotecas de exibição.
Agora vamos carregar nosso conjunto de dados usando o pandas:
df = pd.read_csv('Breast_cancer.csv')
df
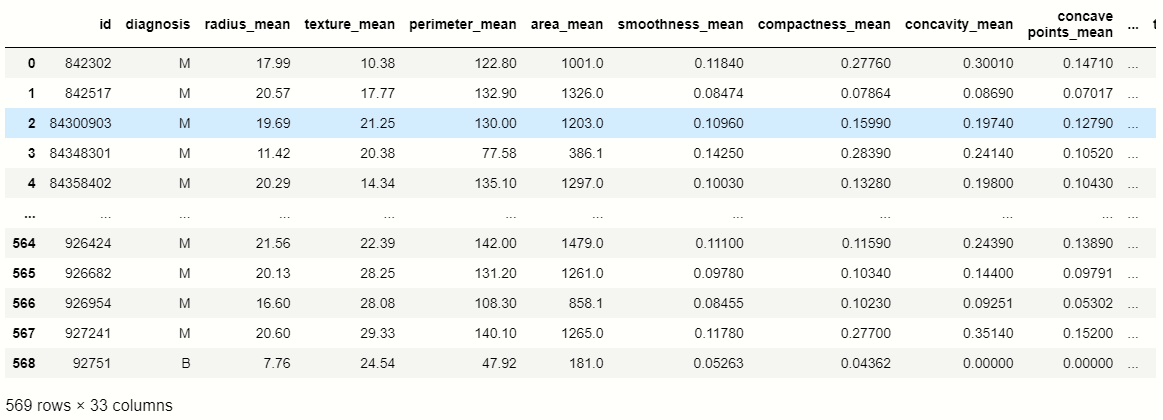
Neste conjunto de dados, nós visamos o 'diagnóstico’ coluna de características, então verificamos a contagem de valores dessa coluna usando pandas:
# counting values of variables in 'diagnosis'
df['diagnosis'].valor_contas()
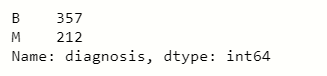
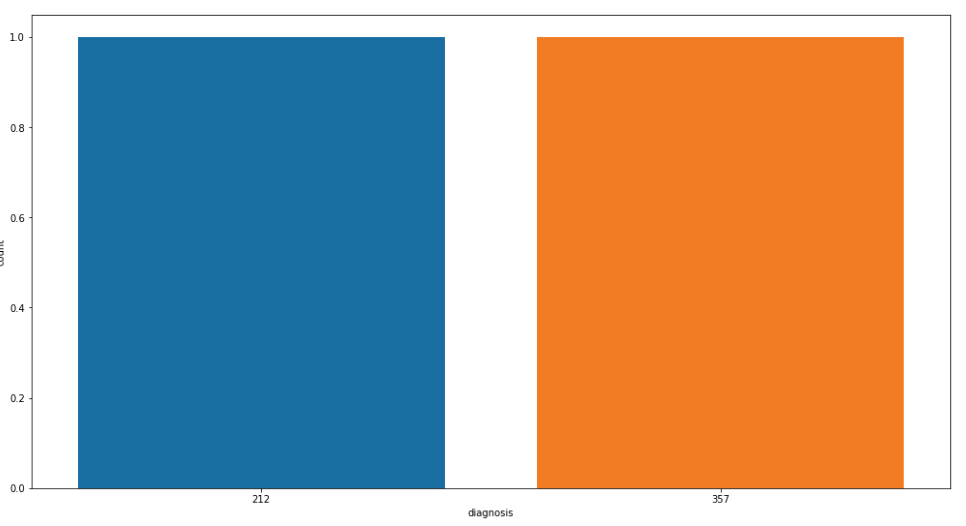
Agora visualizamos as contagens de valores das 'colunas de diagnóstico: para melhor compreensão
Ver contas de valor
plt.figure(figsize =[17,9])
sb.countplot(df['diagnosis'].valor_contas())
plt.show()
Valores nulos
No conjunto de dados, temos que verificar os valores nulos que estão presentes dentro das variáveis para as quais usamos o pandas:
df.isnull().soma()
Depois de executar o programa, concluímos que o nome da função ‘Sem nome: 32’ contém todos os valores nulos, então excluímos ou descartamos essa coluna.
#recurso de queda
df.drop(['Sem nome: 32','id'],eixo = 1, local = Verdadeiro)
Variáveis independentes e dependentes
Agora é a hora de dividir o conjunto de dados em variáveis independentes e dependentes, para isso, criamos duas variáveis, um representa independente e o outro representa dependente.
# variáveis independentes
x = df.drop('diagnosis',eixo = 1)
#variáveis dependentes
y = df.diagnosis
Gestão de valor categórico
Quando imprimimos o variávelEm estatística e matemática, uma "variável" é um símbolo que representa um valor que pode mudar ou variar. Existem diferentes tipos de variáveis, e qualitativo, que descrevem características não numéricas, e quantitativo, representando quantidades numéricas. Variáveis são fundamentais em experimentos e estudos, uma vez que permitem a análise de relações e padrões entre diferentes elementos, facilitando a compreensão de fenômenos complexos.... dependente e então vemos que eles contêm dados categóricos e temos que converter os dados categóricos em formato binário para processamento posterior. Portanto, usamos Scikit learn Label Encoder para codificar os dados categóricos.
de sklearn.preprocessing import LabelEncoder
#criando o objeto
lb = LabelEncoder()
y = lb.fit_transform(e)
Divisão de dados
Agora é o momento de dividir os dados em partes de TreinamentoO treinamento é um processo sistemático projetado para melhorar as habilidades, Conhecimento ou habilidades físicas. É aplicado em várias áreas, como esporte, Educação e desenvolvimento profissional. Um programa de treinamento eficaz inclui planejamento de metas, prática regular e avaliação do progresso. A adaptação às necessidades individuais e a motivação são fatores-chave para alcançar resultados bem-sucedidos e sustentáveis em qualquer disciplina.... e teste:
de sklearn.model_selection import train_test_split
xtrain,xtest,Ytrain,ytest = train_test_split(x,e,test_size = 0.3, random_state = 40)
Dimensione os dados
Quando criamos a rede neural artificial, temos que dimensionar os dados para números menores porque o algoritmo de aprendizado profundo multiplica os pesos e os dados de entrada dos nós e leva muito tempo, então, para reduzir esse tempo, escalamos os dados.
Para escalar, nós usamos o scikit learn Escalador padrão módulo, escalamos o conjunto de dados de treinamento e teste:
#importando StandardScaler
de sklearn.preprocessing import StandardScaler
#creating object
sc = StandardScaler()
xtrain = sc.fit_transform(xtrain)
xtest = sc.transform(xtest)
A partir daqui, começamos a criar a rede neural artificial, para isso importamos as bibliotecas importantes que são usadas para criar ANN:
#importando keras
importar keras
#importing módulo sequencial
de keras.models import Sequential
# importar módulo denso para camadas ocultas
de keras.layers import Dense
#importing funções de ativação
de keras.layers import LeakyReLU,PReLU,ELU
de keras.layers import Dropout
Criação de camadas
Depois de importar essas bibliotecas, nós criamos os três tipos de camadas:
- Camada de entrada
- Manto oculto
- Camada de saída
Primeiro, nós criamos o modelo:
#criando modelo
classificador = Sequencial()
UMA sequencial O modelo é apropriado para uma pilha simples de camadas onde cada camada tem exatamente um tensorOs tensores são estruturas matemáticas que generalizam conceitos como escalares e vetores. São utilizados em diversas disciplinas, incluindo física, engenharia e aprendizagem automática, para representar dados multidimensionais. Um tensor pode ser visualizado como uma matriz de múltiplas dimensões, o que permite modelar relações complexas entre diferentes variáveis. A sua versatilidade e capacidade para lidar com grandes volumes de informação tornam-no uma ferramenta fundamental na análise e processamento de dados.... de entrada e um tensor de saída.
Agora criamos as camadas da rede neural:
#primeira camada escondida
classifier.add(Denso(unidades = 9, kernel_initializer ="he_uniforme",activation='relu',input_dim = 30))
#segunda camada escondida
classifier.add(Denso(unidades = 9, kernel_initializer ="he_uniforme",activation='relu'))
# última camada ou camada de saída
classifier.add(Denso(unidades = 1, kernel_initializer ="glorot_uniform",activation='sigmoid'))
No seguinte código, o método Denso é usado para criar as camadas, em que usamos parametroso "parametros" são variáveis ou critérios usados para definir, medir ou avaliar um fenômeno ou sistema. Em vários domínios, como a estatística, Ciência da Computação e Pesquisa Científica, Os parâmetros são essenciais para estabelecer normas e padrões que orientam a análise e interpretação dos dados. Sua seleção e manuseio adequados são cruciais para obter resultados precisos e relevantes em qualquer estudo ou projeto.... fundamentais. O primeiro parâmetro é Nós de saída, a O segundo é o inicializador para a matriz de pesos do kernel, o terceiro é o função de despertarA função de ativação é um componente chave em redes neurais, uma vez que determina a saída de um neurônio com base em sua entrada. Seu principal objetivo é introduzir não linearidades no modelo, permitindo que você aprenda padrões complexos em dados. Existem várias funções de ativação, como o sigmóide, ReLU e tanh, cada um com características particulares que afetam o desempenho do modelo em diferentes aplicações.... e o último parâmetro são os nós de entrada ou o número de características independentes.
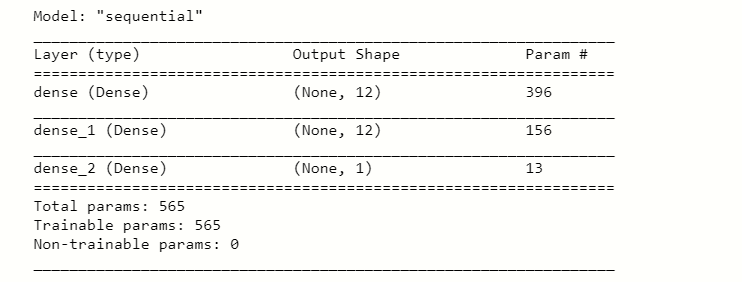
Depois de executar este código, pegamos o resumo dele usando:
#fazendo resumo das camadas
classifier.summary()
Preenchendo ANN
Agora compilamos nosso modelo com o otimizador:
#compilando a RNA
classifier.compile(otimizador ="Adão",perda ="binário_crossentropia",metrics =['accuracy'])
Adaptação da RNA aos dados de treinamento
Depois de compilar o modelo, temos que ajustar a RNA nos dados de treinamento para a previsão:
 #fitting the ANN to the training set
model = classifier.fit(xtrain,Ytrain,batch_size = 100, epochs = 100)
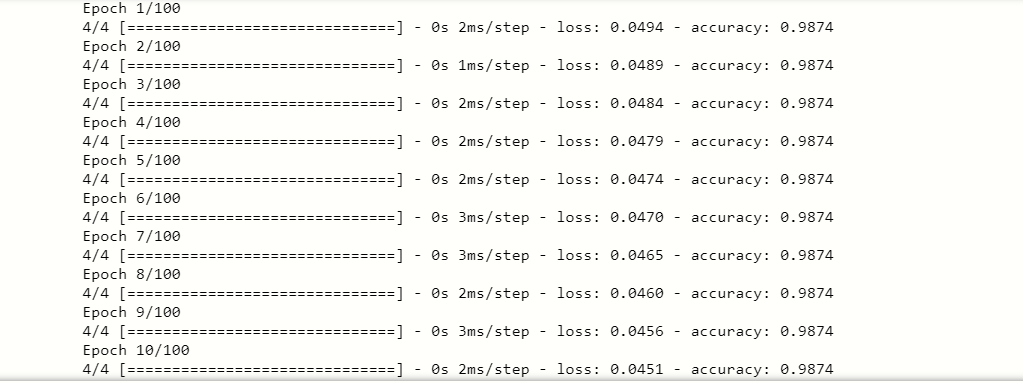
a encaixar() O método ajusta a ANN aos dados de treinamento, nos parâmetros, definimos os valores específicos de cada variável como tamanho do lote, épocas, etc. Finalmente, encontramos uma pontuação de precisão excelente, então nosso modelo é perfeitamente adequado para os dados de treinamento.
Depois de treinar os dados, também precisamos testar a pontuação de precisão dos dados de teste, vamos ver a seguir:
#agora testando para dados de teste
y_pred = classifier.predict(teste)
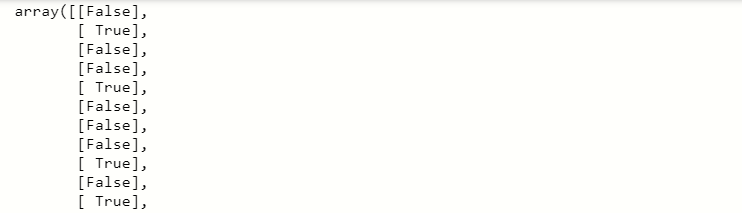
Ao executar este código, descobrimos que y_pred continha os diferentes valores, então, convertemos os valores de predição em valores limite como True, Falso.
#convertendo valores
y_pred = (y_pred>0.5)
imprimir(y_pred)
Matriz de pontuação e confusão
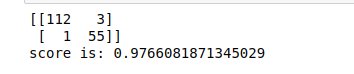
Agora verificamos a matriz de confusão e a pontuação dos valores previstos.
de sklearn.metrics import confused_matrix
de sklearn.metrics import precision_score
cm = confusão_matriz(ytest,y_pred)
pontuação = precisão_score(ytest,y_pred)
imprimir(cm)
imprimir('pontuação é:',pontuação)
Produção:-
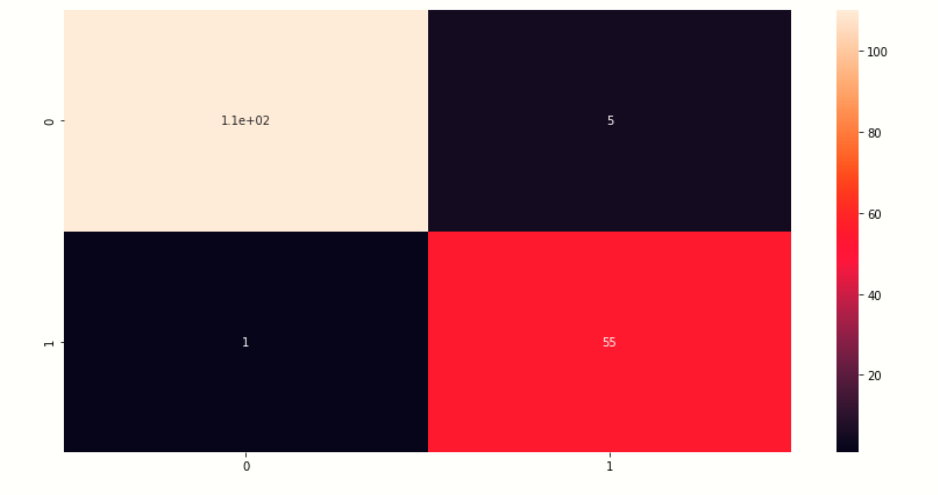
Visualize a matriz de confusão
Aqui, visualizamos a matriz de confusão dos valores de previsão.
# criando mapa de calor da matriz de compressão
plt.figure(figsize =[14,7])
sb.heatmap(cm,annot = True)
plt.show()
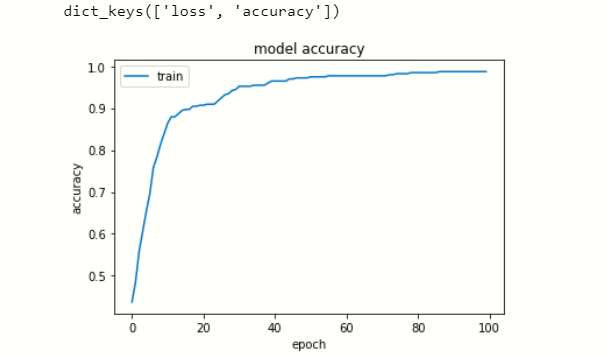
Ver histórico de dados
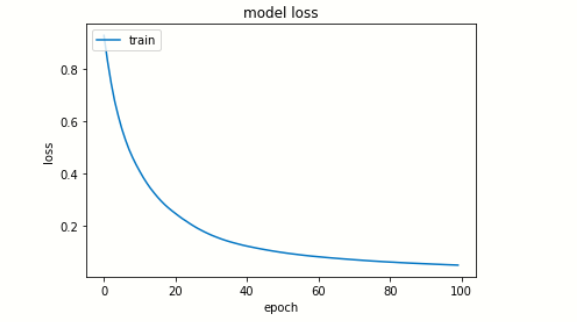
Agora visualizamos a perda e a precisão em cada época.
# liste todos os dados do histórico
imprimir(model.history.keys())
# resumir a história para precisão
plt.plot(model.history['accuracy'])
plt.title('precisão do modelo')
plt.ylabel('accuracy')
plt.xlabel('época')
plt.legend(['train', 'test'], loc ="superior esquerdo")
plt.show()
# resumir a história para perdas
plt.plot(model.history['loss'])
plt.title('perda do modelo')
plt.ylabel('loss')
plt.xlabel('época')
plt.legend(['train', 'test'], loc ="superior esquerdo")
plt.show()
Modelo de poupança
Finalmente, nós salvamos nosso modelo.
#salvando o modelo
classifier.save('Nome_do_arquivo.h5')
EndNote
Esta é a minha primeira RNA criada em aprendizado profundo, Eu sou um iniciante em aprendizado profundo. Eu faço o meu melhor para explicar este artigo, espero que gostem. Obrigado por ler este artigo.
Conecte-se comigo no LinkedIn: Perfil
Obrigado.
A mídia mostrada neste artigo não é propriedade da DataPeaker e é usada a critério do autor.





