
Este artigo foi publicado como parte do Data Science Blogathon.
Introdução
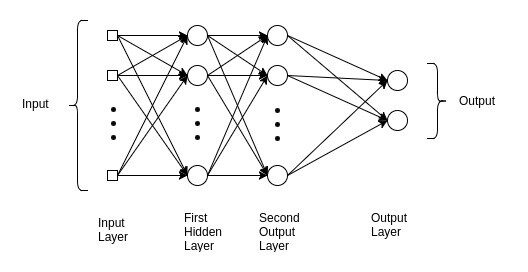
Compreender esta rede ajuda-nos a obter informações sobre as razões subjacentes nos modelos avançados de Deep Learning. O perceptrão multicamada é usado frequentemente em problemas de regressão simples. Porém, os MLP não são ideais para processar padrões com dados sequenciais e multidimensionais.
🙄 Um perceptrão multicamada esforça-se por memorizar padrões em dados sequenciais, devido a isto, requere uma “grande” quantidade de parametroso "parametros" são variáveis ou critérios usados para definir, medir ou avaliar um fenômeno ou sistema. Em vários domínios, como a estatística, Ciência da Computação e Pesquisa Científica, Os parâmetros são essenciais para estabelecer normas e padrões que orientam a análise e interpretação dos dados. Sua seleção e manuseio adequados são cruciais para obter resultados precisos e relevantes em qualquer estudo ou projeto.... para processar dados multidimensionais.
MLP, CNN e RNN não fazem tudo …
Grande parte do seu sucesso provém de identificar o seu objetivo e da boa escolha de alguns parâmetros, O que Função de perda, Otimizador, e Regularizador.
Também dispomos de dados externos ao ambiente de treino. O papel do regularizador é garantir que o modelo treinado se generalize para novos dados.
Conjunto de dados MNIST
Suponhamos que o nosso objetivo é criar uma rede para identificar números com base em dígitos manuscritos. Por exemplo, quando a entrada da rede é uma imagem de um número 8, a previsão correspondente também deve ser 8.
🤷🏻♂️ Este es un trabajo básico de clasificación con redes neuronales.
Antes de analizar el modelo MLP, es esencial comprender el conjunto de datos del MNIST. Se utiliza para explicar y validar muchas teorías de aprendizado profundoAqui está o caminho de aprendizado para dominar o aprendizado profundo em, Uma subdisciplina da inteligência artificial, depende de redes neurais artificiais para analisar e processar grandes volumes de dados. Essa técnica permite que as máquinas aprendam padrões e executem tarefas complexas, como reconhecimento de fala e visão computacional. Sua capacidade de melhorar continuamente à medida que mais dados são fornecidos a ele o torna uma ferramenta fundamental em vários setores, da saúde... porque las 70.000 imágenes que contiene son pequeñas pero suficientemente ricas en información;
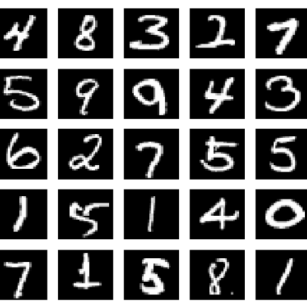
MNIST es una colección de dígitos que van del 0 al 9. Tiene un conjunto de TreinamentoO treinamento é um processo sistemático projetado para melhorar as habilidades, Conhecimento ou habilidades físicas. É aplicado em várias áreas, como esporte, Educação e desenvolvimento profissional. Um programa de treinamento eficaz inclui planejamento de metas, prática regular e avaliação do progresso. A adaptação às necessidades individuais e a motivação são fatores-chave para alcançar resultados bem-sucedidos e sustentáveis em qualquer disciplina.... a partir de 60.000 imágenes y 10.000 pruebas clasificadas en categorías.
Usar el conjunto de datos MNIST en TensorFlow es simple.
importar entorpecido Como por exemplo
a partir de tensorflow.keras.datasets importar mnist
(x_train, y_train), (x_test, y_test) = mnist.load_data()
a mnist.load_data () El método es conveniente, ya que no es necesario cargar las 70.000 imágenes y sus etiquetas.
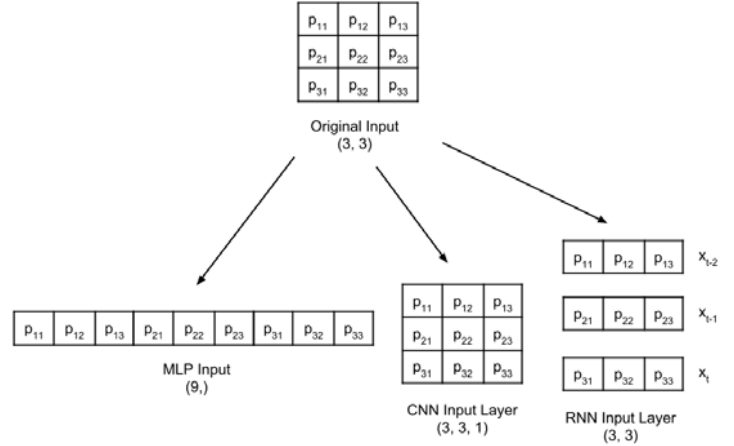
Antes de entrar en el clasificador de Perceptrón Multicapa, es fundamental tener en cuenta que, si bien los datos del MNIST constan de tensores bidimensionales, devem ser remodelados, segundo o tipo de camada de entradao "camada de entrada" refere-se ao nível inicial em um processo de análise de dados ou em arquiteturas de redes neurais. Sua principal função é receber e processar informações brutas antes de serem transformadas por camadas subsequentes. No contexto do aprendizado de máquina, A configuração adequada da camada de entrada é crucial para garantir a eficácia do modelo e otimizar seu desempenho em tarefas específicas.....
Muda-se a forma de uma imagem em escala de cinzentos de 3 × 3 para as camadas de entrada MLP, CNN e RNN:
As etiquetas têm a forma de dígitos, do 0 al 9.
num_labels = len(np.unique(y_train))
imprimir("total de etiquetas:t{}".formato(num_labels))
imprimir("rótulos:ttt{0}".formato(np.unique(y_train)))
⚠️ Esta representação não é adequada para a camada de previsão que gera probabilidade por classe. O formato mais adequado é one-hot, um vetor de 10 dimensões como todos os valores 0, exceto o índiceo "Índice" É uma ferramenta fundamental em livros e documentos, que permite localizar rapidamente as informações desejadas. Geralmente, é apresentado no início de um trabalho e organiza os conteúdos de forma hierárquica, incluindo capítulos e seções. Sua correta preparação facilita a navegação e melhora a compreensão do material, tornando-se um recurso essencial para estudantes e profissionais de várias áreas.... de classe. Por exemplo, se a etiqueta for 4, o vetor equivalente é [0,0,0,0, 1, 0,0,0,0,0].
En Deep Learning, os dados são armazenados em um tensorOs tensores são estruturas matemáticas que generalizam conceitos como escalares e vetores. São utilizados em diversas disciplinas, incluindo física, engenharia e aprendizagem automática, para representar dados multidimensionais. Um tensor pode ser visualizado como uma matriz de múltiplas dimensões, o que permite modelar relações complexas entre diferentes variáveis. A sua versatilidade e capacidade para lidar com grandes volumes de informação tornam-no uma ferramenta fundamental na análise e processamento de dados..... O termo tensor aplica-se a um tensor escalar (tensor 0D), vetor (tensor 1D), matriz (tensor bidimensional) e tensor multidimensionalOs tensores multidimensionais são estruturas matemáticas que generalizam a noção de escalares, vetores e matrizes para dimensões superiores. Se utilizan ampliamente en campos como la física, la ingeniería y el aprendizaje automático, permitiendo representar y manipular datos complejos de manera eficiente. Su capacidad para almacenar información en múltiples dimensiones facilita el análisis y la modelización de fenómenos reales, contribuyendo a avances en diversas disciplinas científicas y tecnológicas.....
#converter em one-hot
from tensorflow.keras.utils import to_categorical
y_train = to_categorical(y_train)
y_test = to_categorical(y_test)
Nuestro modelo es un MLP, por lo que sus entradas deben ser un tensor 1D. Como tal, x_train y x_test deben transformarse en [60,000, 2828] e [10,000, 2828],
Em suma, el tamaño de -1 significa permitir que la biblioteca calcule la dimensión correta. En el caso de x_train, isto é 60.000.
image_size = x_train.shape[1]
input_size = image_size * image_size

print("x_train:t{}".formato(x_train.forma))
imprimir("x_test:tt{}n".formato(x_test.forma))

x_train = np.reshape(x_train, [-1, input_size])
x_train = x_train.astype('float32') / 255

x_test = np.reshape(x_test, [-1, input_size])
x_test = x_test.astype('float32') / 255

imprimir("x_train:t{}".formato(x_train.forma))
imprimir("x_test:tt{}".formato(x_test.forma))
OUTPUT:
x_train:	(60000, 28, 28)
x_test:		(10000, 28, 28)

x_train:	(60000, 784)
x_test:		(10000, 784)
Construyendo el modelo
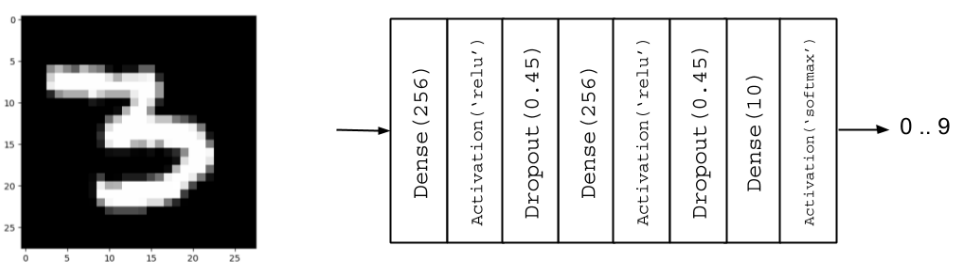
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import Dense, Ativação, Cair fora

# Parameters
batch_size = 128 # É o tamanho da amostra de entradas a serem processadas em cada etapa de treinamento.
hidden_units = 256
dropout = 0.45

# Nossa  MLP com ReLU e Dropout
model = Sequential()

model.add(Denso(hidden_units, input_dim=input_size))
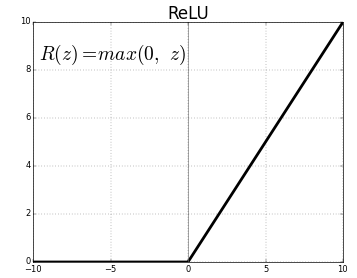
model.add(Ativação('relu'))
model.add(Cair fora(cair fora))

model.add(Denso(hidden_units))
model.add(Ativação('relu'))
model.add(Cair fora(cair fora))

model.add(Denso(num_labels))
Regularização
Una red neuronal tiende a memorizar sus datos de entrenamiento, especialmente si contiene capacidad más que suficiente. Neste caso, la red falla catastróficamente cuando se somete a los datos de prueba.
Este es el caso clásico en el que la red no logra generalizar (SobreajusteSobreajuste, ou sobreajuste, É um fenômeno no aprendizado de máquina em que um modelo se encaixa muito bem com os dados de treinamento, Capturando ruídos e padrões irrelevantes. Isso resulta em baixo desempenho em dados não vistos, já que o modelo perde capacidade de generalização. Para mitigar o sobreajuste, Técnicas como regularização podem ser usadas, validação cruzada e redução da complexidade do modelo.... / Ajuste insuficienteEl underfitting es un problem común en el aprendizaje automático que ocurre cuando un modelo es too simple para capturar la complejidad de los datos. Esto se traduce en un rendimiento deficiente tanto en el conjunto de entrenamiento como en el de prueba. Las causas del underfitting pueden incluir un modelo inadecuado, características irrelevantes o insuficientes datos. Para resolver isso, se puede optar por modelos más complejos o mejorar la calidad...). Para evitar esta tendência, el modelo utiliza una capa reguladora. Sair.
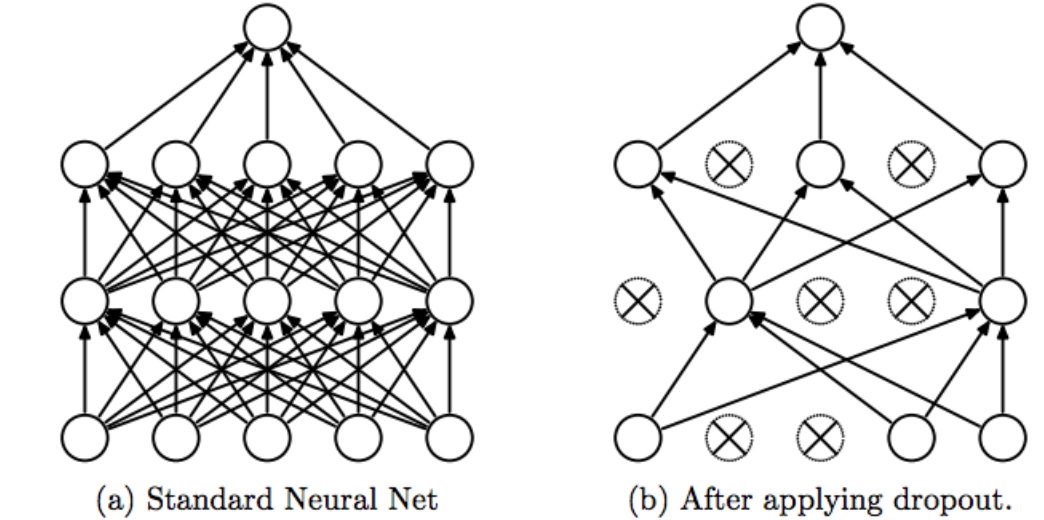
La idea de Dropout es simple. Dada una tasa de descarte (en nuestro modelo, establecemos = 0,45), la capa elimina aleatoriamente esta fracción de unidades.
Por exemplo, si la primera capa tiene 256 unidades, después de que se aplica el abandono (0.45), só (1 – 0.45) * 255 = 140 unidades participarán en la siguiente capa
La deserción hace que las redes neuronales sean más robustas para los datos de entrada imprevistos, porque la red está entrenada para predecir corretamente, incluso si algunas unidades están ausentes.
⚠️ El abandono solo participa en “Toque” 🤷🏻 ♂️ durante el entrenamiento.
Activación
o Camada de saídao "Camada de saída" é um conceito utilizado no campo da tecnologia da informação e design de sistemas. Refere-se à última camada de um modelo ou arquitetura de software que é responsável por apresentar os resultados ao usuário final. Essa camada é crucial para a experiência do usuário, uma vez que permite a interação direta com o sistema e a visualização dos dados processados.... tenho 10 unidades, seguidas de una función de activación softmax. As 10 unidades corresponden a las 10 posibles etiquetas, clases o categorías.
La activación de softmax se puede expresar matemáticamente, de acuerdo con la siguiente ecuación:
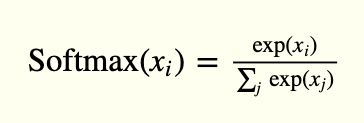
model.add(Ativação('softmax'))
model.summary()
OUTPUT:
Modelo: "sequencial"
_________________________________________________________________
Camada (modelo)                 Parâmetros de forma de saída #
=================================================================
dense (Denso)                (Nenhum, 256)               200960
_________________________________________________________________
activation (Ativação)      (Nenhum, 256)               0
_________________________________________________________________
dropout (Cair fora)            (Nenhum, 256)               0
_________________________________________________________________
dense_1 (Denso)              (Nenhum, 256)               65792
_________________________________________________________________
activation_1 (Ativação)    (Nenhum, 256)               0
_________________________________________________________________
dropout_1 (Cair fora)          (Nenhum, 256)               0
_________________________________________________________________
denso_2 (Denso)              (Nenhum, 10)                2570
_________________________________________________________________
activation_2 (Ativação)    (Nenhum, 10)                0
========================================================== ===============
Params totais: 269,322
Parâmetros treináveis: 269,322
Params não treináveis: 0
_________________________________________________________________
Visualización de modelos
Melhoria
El propósito de la Optimización es minimizar la función de pérdida. La idea es que si la pérdida se reduce a un nivel aceptable, el modelo aprendió indiretamente la función que asigna las entradas a las salidas. Las métricas de rendimiento se utilizan para determinar si su modelo ha aprendido.
model.compile(perda ="categorical_crossentropy", otimizador ="Adão", metrics =['accuracy'])
-
- Categorical_crossentropy, se utiliza para one-hot
- La precisión es una buena métrica para las tareas de clasificación.
- Adam es un algoritmo de otimizaçãoUm algoritmo de otimização é um conjunto de regras e procedimentos concebidos para encontrar a melhor solução para um problema específico, maximizando ou minimizando uma função objetivo. Estes algoritmos são fundamentais em diversas áreas, como a engenharia, a economia e a inteligência artificial, onde se procura melhorar a eficiência e reduzir custos. Existem múltiplas abordagens, incluindo algoritmos genéticos, programação linear e métodos de otimização combinatória.... que se pode utilizar em vez do procedimento clássico de descida de gradienteGradiente é um termo usado em vários campos, como matemática e ciência da computação, descrever uma variação contínua de valores. Na matemática, refere-se à taxa de variação de uma função, enquanto em design gráfico, Aplica-se à transição de cores. Esse conceito é essencial para entender fenômenos como otimização em algoritmos e representação visual de dados, permitindo uma melhor interpretação e análise em... estocástico
📌 Dado o nosso conjunto de treino, a escolha do Função de perdaA função de perda é uma ferramenta fundamental no aprendizado de máquina que quantifica a discrepância entre as previsões do modelo e os valores reais. Seu objetivo é orientar o processo de treinamento, minimizando essa diferença, permitindo assim que o modelo aprenda de forma mais eficaz. Existem diferentes tipos de funções de perda, como erro quadrático médio e entropia cruzada, cada um adequado para diferentes tarefas e..., o otimizador e o regularizador, podemos começar a treinar o nosso modelo.
model.fit(x_train, y_train, epochs=20, batch_size = batch_size)
OUTPUT:
Época 1/20
469/469 [================================] - 1s 3ms/passo - perda: 0.4230 - precisão: 0.8690
....
Época 20/20
469/469 [================================] - 2s 4ms / passo - perda: 0.0515 - precisão: 0.9835
Avaliação
Neste ponto, o nosso modelo de classificador de dígitos MNIST está completo. A sua avaliação de desempenho será o próximo passo para determinar se o modelo treinado apresentará uma solução subótima
_, acc = model.evaluate(x_test,
                        y_test,
                        batch_size = batch_size,
                        verbose = 0)
imprimir("nAcurácia: %.1f%%n" % (100.0 * acc))
OUTPUT:
Precisão: 98.4%
continuará…





