
Dieser Artikel wurde im Rahmen der Data Science Blogathon
Einführung
Rotes neuronales RezidivRekurrente neuronale Netze (RNN) sind eine Art von neuronaler Netzwerkarchitektur, die für die Verarbeitung von Datenströmen entwickelt wurde. Im Gegensatz zu herkömmlichen neuronalen Netzen, RNNs verwenden interne Verbindungen, die es ermöglichen, Informationen aus früheren Einträgen zu speichern. Dies macht sie besonders nützlich für Aufgaben wie die Verarbeitung natürlicher Sprache, Maschinelle Übersetzung und Zeitreihenanalyse, wo Kontext und Reihenfolge für die... (RNN) fue uno de los mejores conceptos introducidos que podría hacer uso de elementos de memoria en nuestra rotes neuronalesNeuronale Netze sind Rechenmodelle, die von der Funktionsweise des menschlichen Gehirns inspiriert sind. Sie nutzen Strukturen, die als künstliche Neuronen bekannt sind, um Daten zu verarbeiten und daraus zu lernen. Diese Netze sind grundlegend im Bereich der künstlichen Intelligenz, Dies ermöglicht erhebliche Fortschritte bei Aufgaben wie der Bilderkennung, Verarbeitung natürlicher Sprache und Vorhersage von Zeitreihen, unter anderen. Ihre Fähigkeit, komplexe Muster zu erlernen, macht sie zu mächtigen Werkzeugen... Davor, Wir hatten ein neuronales Netzwerk, das sich hin und her ausbreiten konnte, um Gewichte zu aktualisieren und Fehler im Netzwerk zu reduzieren. Aber, wie wir wissen, Viele Probleme in der realen Welt sind vorübergehender Natur und stark zeitabhängig.
Viele Sprach-Apps sind immer sequentiell und das nächste Wort in einem Satz hängt vom vorherigen ab. Diese Probleme wurden durch ein einfaches RNN gelöst. Aber wenn wir RNN verstehen, Wir wissen es zu schätzen, dass selbst RNN uns nicht helfen kann, wenn wir die Wörter verfolgen möchten, die zuvor in unserem Satz verwendet wurden. In diesem Artikel, Ich werde einige der Hauptnachteile von RNN diskutieren und warum wir für die meisten sprachbasierten Anwendungen ein besseres Modell verwenden.
Backpropagation im Laufe der Zeit verstehen (BPTT)
RNN utiliza una técnica llamada BackpropagierungDie Rückpropagation ist ein grundlegender Algorithmus beim Training künstlicher neuronaler Netze. Sie basiert auf dem Prinzip des Gradientenabstiegs, und ermöglicht es, die Gewichte des Netzes so anzupassen, dass der Fehler in den Vorhersagen minimiert wird. Durch die Weiterleitung des Fehlers von der Ausgabeschicht zu den vorherigen Schichten, optimiert diese Methode das Lernen des Netzes, und verbessert seine Fähigkeit, auf noch nicht gesehene Daten zu verallgemeinern.... a través del tiempo para retropropagar a través de la red para ajustar sus pesos para que podamos reducir el error en la red. Habe seinen Namen „durch die Zeit“, da wir in RNN mit sequentiellen Daten umgehen und jedes Mal, wenn wir zurückgehen, ist es wie eine Zeitreise in die Vergangenheit. So funktioniert BPTT:
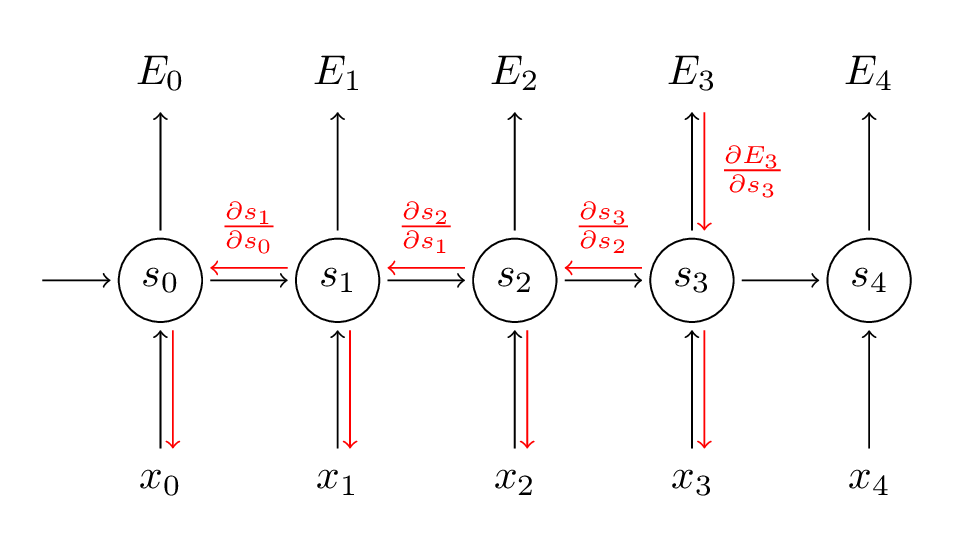
Quelle: (http://www.wildml.com/2015/10/recurrent-neural-networks-tutorial-part-3-backpropagation-through-time-and-vanishing-gradients/)
In Schritt BPTT, berechnen wir die partielle Ableitung bei jedem Gewicht im Netzwerk. Dann, wenn wir in der Zeit t = . sind 3, dann betrachten wir die Ableitung von E3 nach der von S3. Jetzt, x3 ist auch mit s3 verbunden. Dann, seine Ableitung wird auch berücksichtigt. Jetzt, wenn wir sehen, dass s3 mit s2 verbunden ist, dann hängt s3 vom Wert von s2 ab und hier wird auch die Ableitung von s3 nach s2 berücksichtigt. Dies fungiert als Kettenregel und wir akkumulieren die gesamte Abhängigkeit mit ihren Ableitungen und verwenden sie, um den Fehler zu berechnen.
En E3 tenemos un SteigungGradient ist ein Begriff, der in verschiedenen Bereichen verwendet wird, wie Mathematik und Informatik, um eine kontinuierliche Variation von Werten zu beschreiben. In Mathematik, bezieht sich auf die Änderungsrate einer Funktion, während des Studiums im Grafikdesign, Gilt für den Farbübergang. Dieses Konzept ist unerlässlich, um Phänomene wie die Optimierung von Algorithmen und die visuelle Darstellung von Daten zu verstehen, ermöglicht eine bessere Interpretation und Analyse in... que es de S3 y su ecuación en ese momento es:
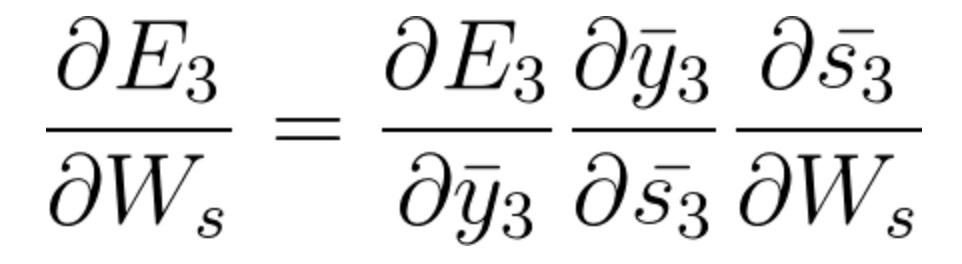
Jetzt haben wir auch s2 mit s3 verknüpft so,
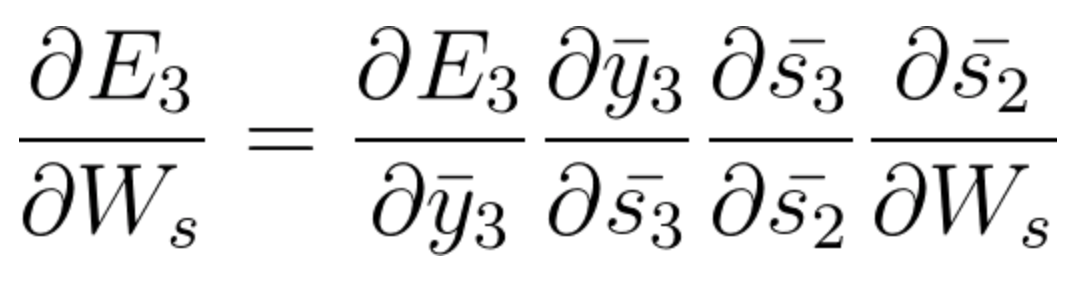
Und s1 ist auch mit s2 verbunden und, Daher, jetzt alles s1, s2, s3 und wirkt auf E3,
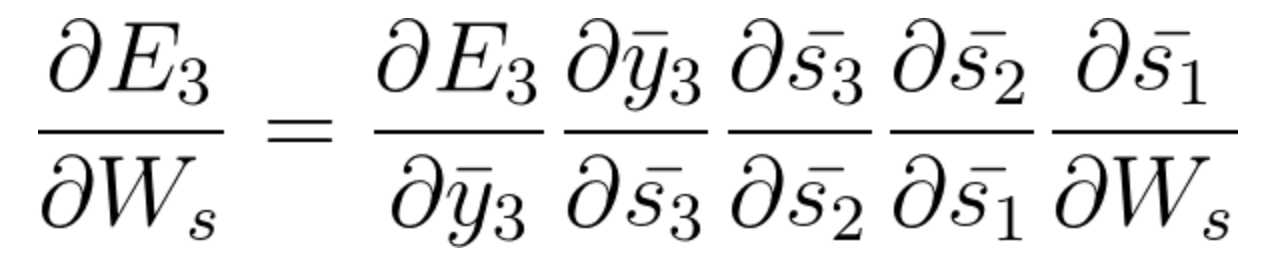
Indem wir alles akkumulieren, erhalten wir am Ende die folgende Gleichung, die Ws zum Zeitpunkt t = zu diesem Netzwerk beigetragen hat 3,
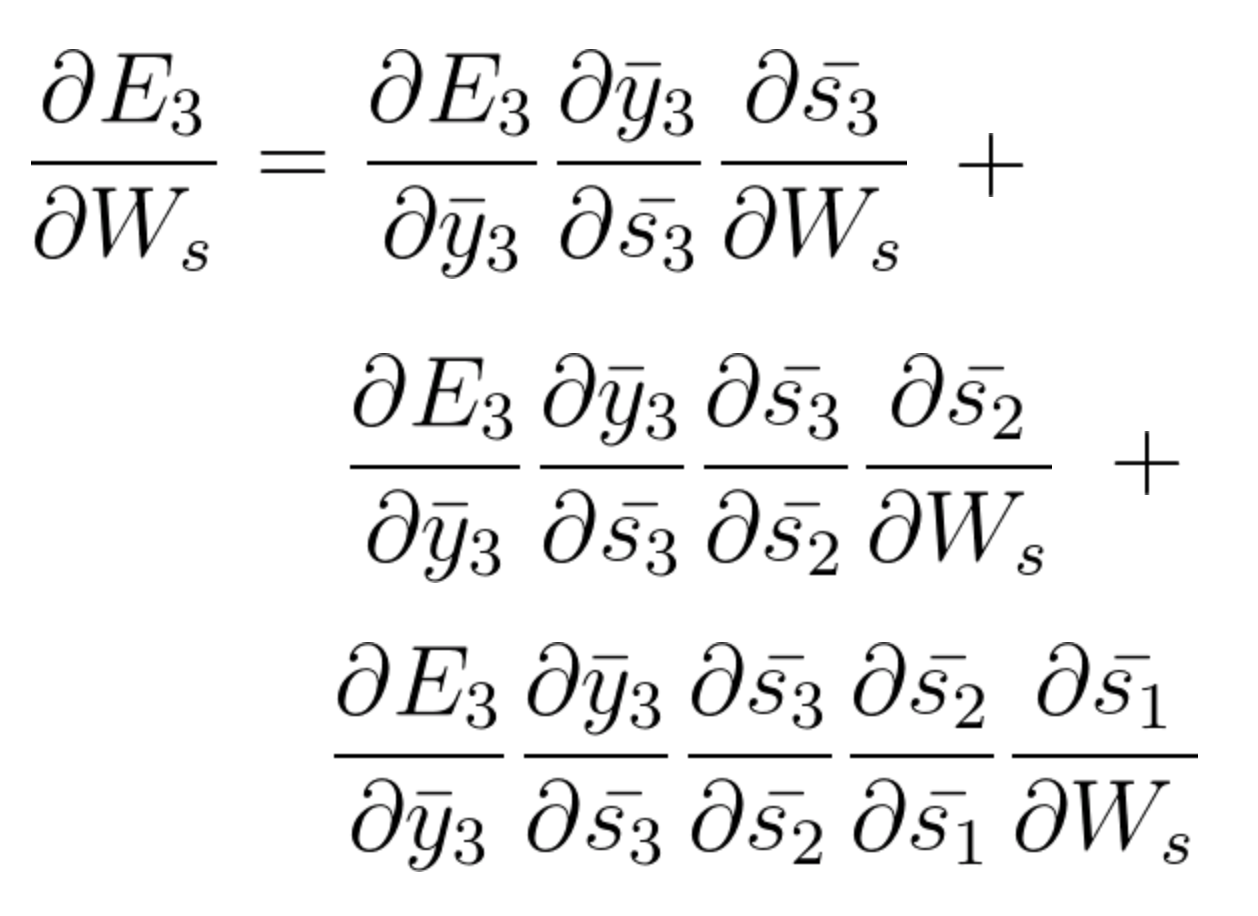
Die allgemeine Gleichung, für die wir Ws in unserem BPTT-Netzwerk anpassen, kann geschrieben werden als,
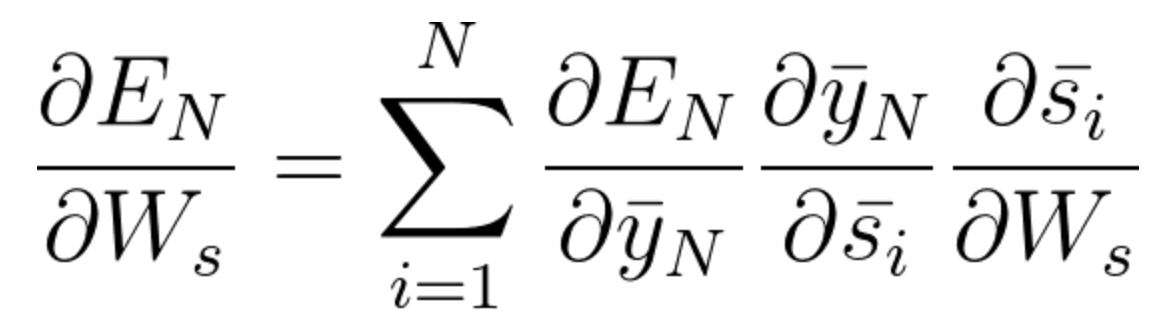
Jetzt, wie wir gemerkt haben, Wx ist auch mit dem Netzwerk verbunden. Dann, indem du dasselbe tust, wir können normalerweise schreiben,
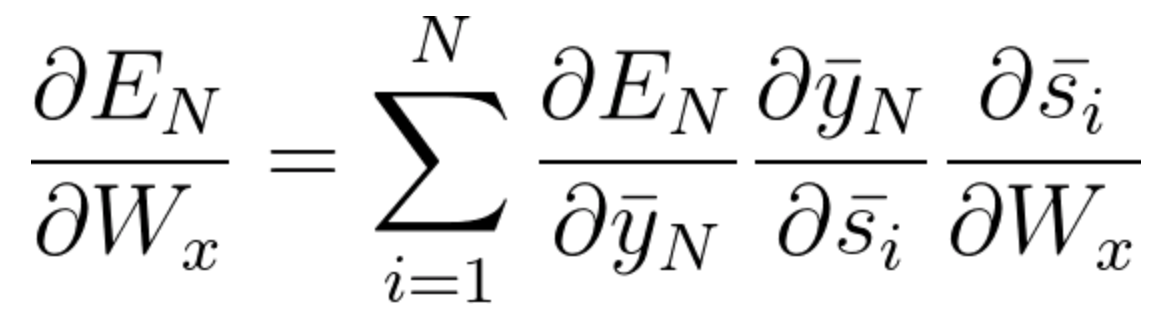
Jetzt haben Sie verstanden, wie BPTT funktioniert, es geht im Wesentlichen darum, wie RNN seine Gewichte anpasst und den Fehler reduziert. Jetzt, Der Hauptfehler hier ist, dass dies im Grunde nur für ein kleines Netzwerk mit 4 deckt. Aber stellen Sie sich vor, wir hätten Hunderte von Schichten und, auf einmal, sagen wir t = 100, Wir würden am Ende alle partiellen Ableitungen berechnen, die mit dem Netzwerk verbunden sind, und dies ist eine riesige Multiplikation und dies kann den Gesamtwert auf einen sehr kleinen Wert oder einen sehr kleinen Wert reduzieren, so dass es nutzlos sein kann, den Fehler zu korrigieren. Dieses Problem heißt Gradientenproblem verschwindet.
Gradientenproblem verschwindet
Wie wir alle wissen, en RNN para predecir una salida usaremos una WeckfunktionDie Aktivierungsfunktion ist eine Schlüsselkomponente in neuronalen Netzen, da es den Output eines Neurons auf der Grundlage seiner Eingabe bestimmt. Sein Hauptzweck besteht darin, Nichtlinearitäten in das Modell einzuführen, Ermöglicht das Erlernen komplexer Muster in Daten. Es gibt verschiedene Aktivierungsfunktionen, wie das Sigmoid, ReLU und tanh, jedes mit besonderen Eigenschaften, die sich auf die Leistung des Modells in verschiedenen Anwendungen auswirken.... sigmoidea para que podamos obtener la salida de probabilidad para una clase en particular. Wie wir im vorherigen Abschnitt gesehen haben, wenn es darum geht, E3 . zu sagen, es besteht eine langfristige Abhängigkeit. Das Problem tritt auf, wenn wir die Ableitung nehmen und die Ableitung des Sigmoids immer darunter liegt 0.25 Ja, Daher, wenn wir viele Ableitungen nach der Kettenregel miteinander multiplizieren, Am Ende haben wir einen Leckwert, den wir nicht für die Fehlerberechnung verwenden können. .
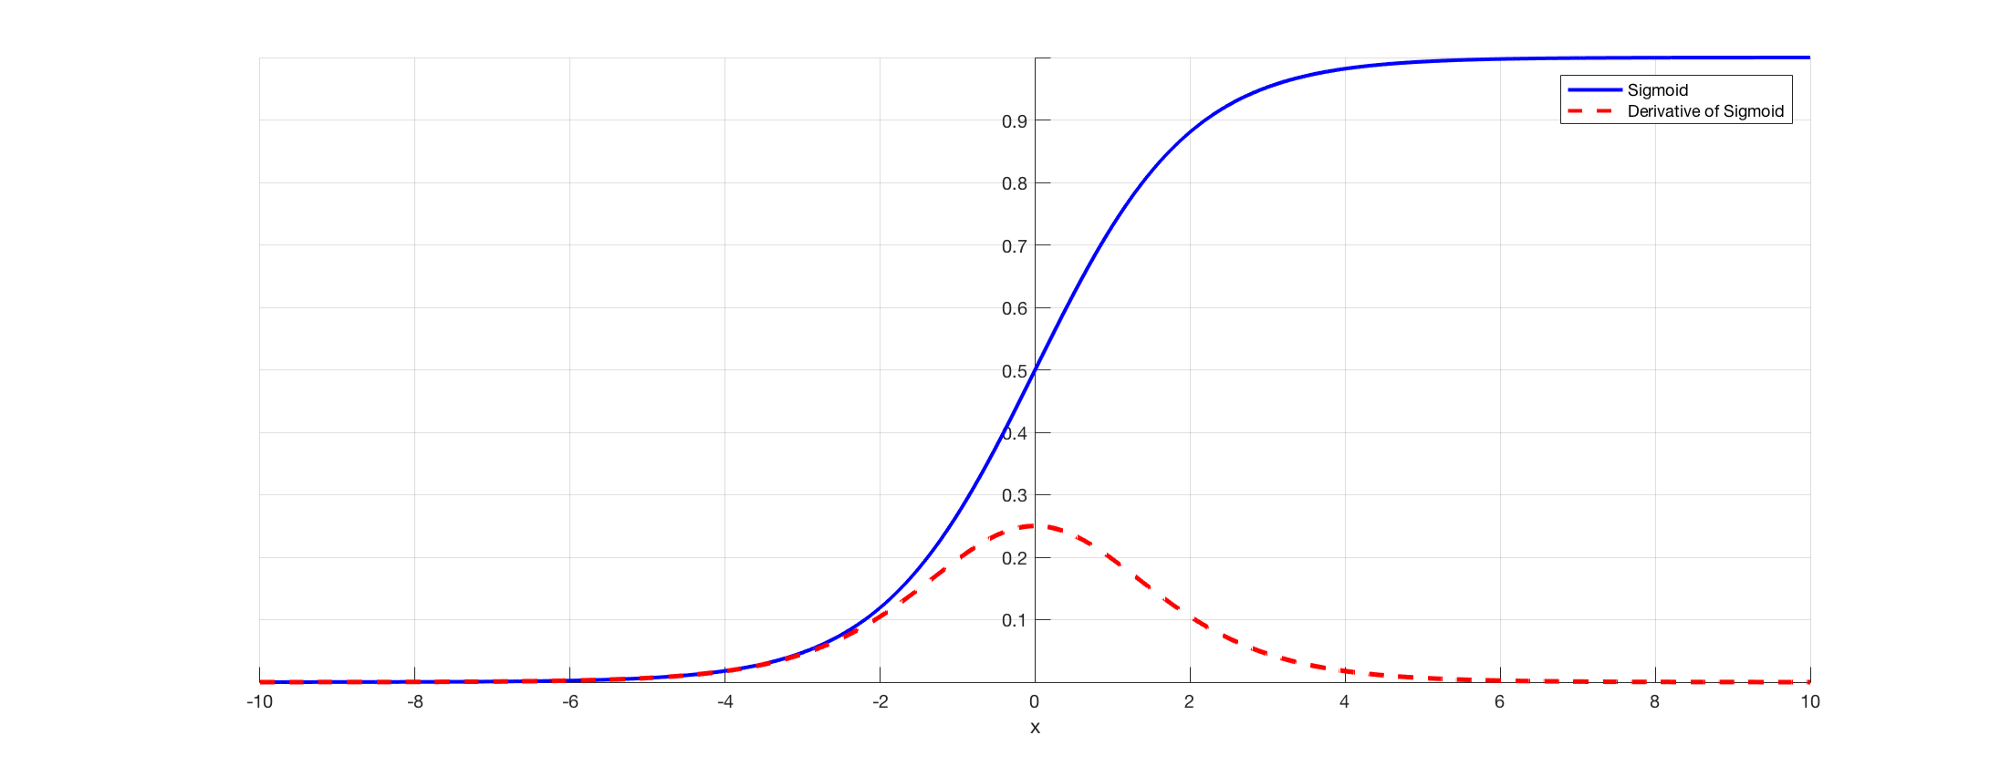
Quelle: (https://directiondatascience.com/the-vanishing-gradient-problem-69bf08b15484)
Deswegen, Gewichtungen und Verzerrungen werden nicht korrekt aktualisiert und, wenn die Schichten weiter zunehmen, wir sind weiter hineingefallen und unser Modell funktioniert nicht richtig und erzeugt Ungenauigkeiten im gesamten Netzwerk.
Algunas formas de resolver este problema son inicializar la matriz de peso correctamente o optar por algo como un LebenslaufDie Aktivierungsfunktion von ReLU (Gleichgerichtete Lineareinheit) Es wird aufgrund seiner Einfachheit und Effektivität häufig in neuronalen Netzen verwendet. Definiert als ( F(x) = max(0, x) ), ReLU lässt Neuronen nur dann feuern, wenn die Eingabe positiv ist, Dies hilft, das Problem des Gradientenverblassens zu mildern. Es hat sich gezeigt, dass seine Verwendung die Leistung bei verschiedenen Deep-Learning-Aufgaben verbessert, ReLU zu einer Option machen.. en lugar de funciones sigmoideas o tanh.
Explosives Gradientenproblem
Die Gradientenexplosion ist ein Problem, bei dem der Wert des Gradienten sehr groß wird und dies passiert oft, wenn wir größere Gewichte initialisieren und am Ende NaN . erhalten. Wenn unser Modell unter diesem Problem litt, Wir können die Gewichte überhaupt nicht aktualisieren. Aber glücklicherweise, Gradient Cropping ist ein Verfahren, das wir dafür verwenden können. Bei einem vordefinierten Schwellenwert, Wir schneiden den Farbverlauf ab. Dies verhindert, dass der Gradientenwert den Schwellenwert überschreitet und wir werden nie mit großen Zahlen oder NaN . enden.
Langfristige Abhängigkeit von Wörtern
Jetzt, Betrachten wir einen Satz wie, "Die Wolken sind im ____". Nuestro modelo RNN puede predecir fácilmente ‚Himmel‘ hier und das liegt am Kontext der Wolken und sehr bald kommt es als Input für deine vorherige Ebene. Aber es kann nicht immer so sein.
Bild, wenn wir einen Satz hätten wie: „Jane wurde in Kerala geboren. Jane hat früher für die Frauenfußballmannschaft gespielt und hat auch die Staatsprüfungen bestanden. Jane spricht ____ fließend „.
Dies ist ein sehr langer Satz und das Problem hier ist, dass, als Mensch, Ich kann das sagen, seit Jane in Kerala geboren wurde und ihr Staatsexamen bestanden hat, Es ist offensichtlich, dass Sie das beherrschen sollten „malayalam“ sehr fließend. Aber, Woher weiß unsere Maschine davon? An dem Punkt, an dem das Modell Wörter vorhersagen möchte, Sie haben vielleicht den Kontext von Kerala vergessen und mehr über etwas anderes. Dies ist das Problem der langfristigen Abhängigkeit von RNN.
Unidirektional in RNN
Wie wir bereits kommentiert haben, RNN nimmt Daten sequentiell und Wort für Wort oder Buchstabe für Buchstabe auf. Jetzt, wenn wir versuchen, ein bestimmtes Wort vorherzusagen, wir denken nicht in seinem zukünftigen Kontext. Nämlich, Sagen wir, wir haben so etwas wie: "Die Maus ist wirklich gut. Die Maus wird verwendet, um ____ die Verwendung von Computern zu erleichtern „. Jetzt, wenn wir bidirektional reisen können und wir auch den zukünftigen Kontext sehen können, Wir können das sagen ‚Desplazamiento‘ ist hier das passende Wort. Aber, wenn es unidirektional ist, unser Modell hat noch nie Computer gesehen, dann, Woher wissen Sie, ob es sich um die Tiermaus oder die Computermaus handelt??
Diese Probleme werden später mit Sprachmodellen wie BERT . gelöst, wo wir ganze Sätze eingeben und den Selbstaufmerksamkeitsmechanismus nutzen können, um den Kontext des Textes zu verstehen.
Nutzen Sie das Langzeit-Kurzzeitgedächtnis (LSTM)
Eine Möglichkeit, das Problem des Streugradienten und der langfristigen Abhängigkeit vom RNN zu lösen, besteht darin, sich für LSTM-Netze zu entscheiden. LSTM hat eine Einführung in drei Türen, die als Eingangstüren bezeichnet werden, Ausgang und Vergessen. In dem sich die Türen des Vergessens um die Informationen kümmern, die durch das Netzwerk passieren müssen. Daher, Wir können ein Kurz- und Langzeitgedächtnis haben. Wir können die Informationen durch das Netzwerk weiterleiten und sogar zu einem viel späteren Zeitpunkt abrufen, um den Vorhersagekontext zu identifizieren. Das folgende Diagramm zeigt das LSTM-Netzwerk.
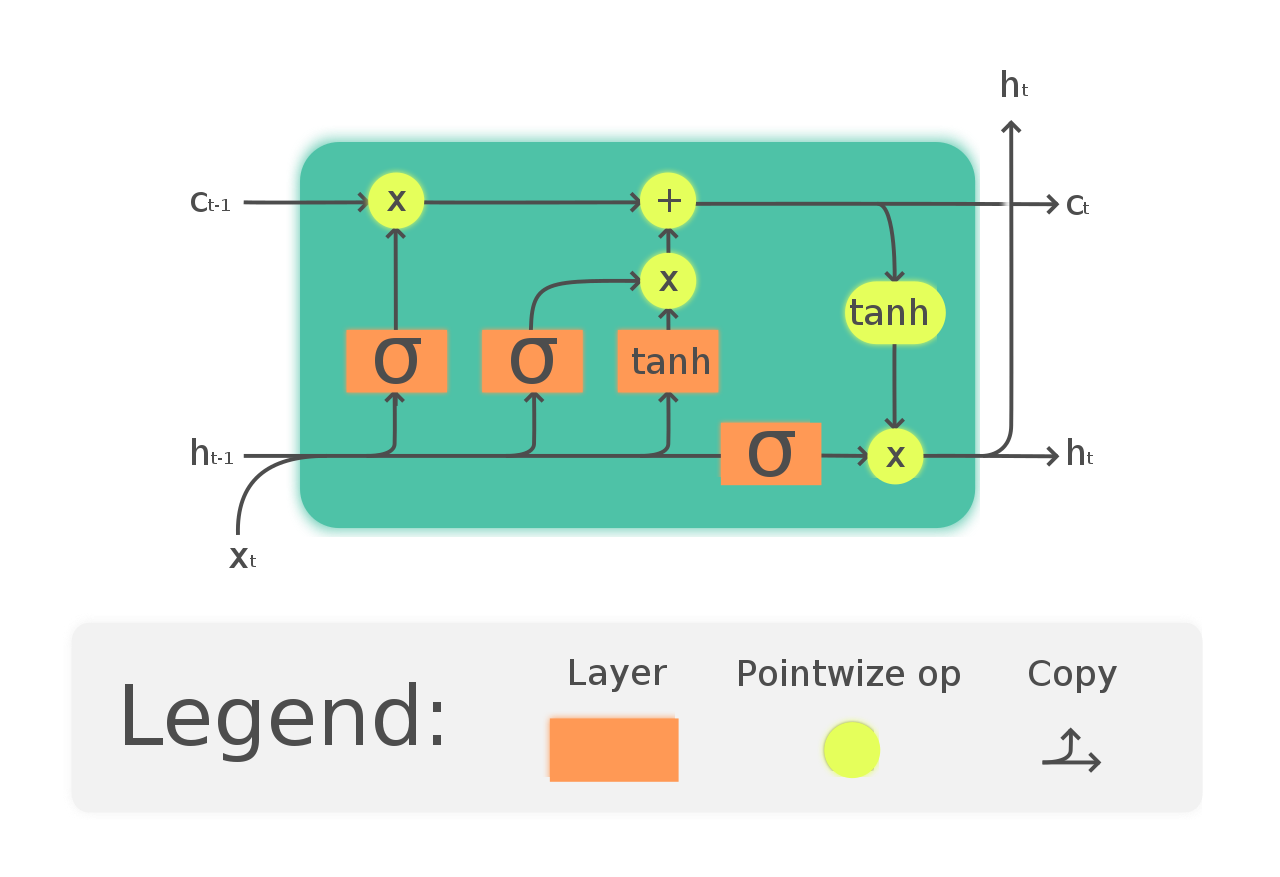
(https://de.wikipedia.org/wiki/Long_short-term_memory#/media/File:The_LSTM_Cell.svg)
Folgen Sie diesem Tutorial für ein besseres Verständnis und ein intuitives Beispiel von LSTM: https://directiondatascience.com/illustrated-guide-to-lstms-and-gru-sa-step-by-step-explanation-44e9eb85bf21
Hoffentlich, Jetzt haben Sie die Probleme bei der Verwendung eines RNN verstanden und warum wir uns für komplexere Netzwerke wie LSTM entschieden haben.
Verweise
1.http: //www.wildml.com/2015/10/recurrent-neural-networks-tutorial-part-3-backpropagation-through-time-and-vanishing-gradients/
2. https://analyticsindiamag.com/was-sind-die-herausforderungen-des-trainings-rekurrente-neurale-netzwerke/
3. https://directiondatascience.com/the-vanishing-gradient-problem-69bf08b15484
4. https://de.wikipedia.org/wiki/Long_short-term_memory
5. https://www.udacity.com/course/deep-learning-nanodegree–nd101
6. Vorschaubild: https://unsplash.com/photos/Sot0f3hQQ4Y
Fazit
Fühlen Sie sich frei, mit mir in Kontakt zu treten unter:
1. https://www.linkedin.com/in/siddharth-m-426a9614a/
2. https://github.com/Siddharth1698
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





