
Dieser Artikel wurde im Rahmen der Data Science Blogathon.
Einführung
Der erste Schritt in einem Data-Science-Projekt ist die Zusammenfassung, die Daten beschreiben und visualisieren. Versuchen Sie, verschiedene Aspekte der Daten und ihrer Attribute zu kennen. Die besten Modelle werden von denen erstellt, die ihre Daten verstehen.
Untersuchen Sie Datenmerkmale und -attribute mithilfe deskriptiver Statistiken. Die Erkenntnisse und die numerische Zusammenfassung, die Sie aus deskriptiven Statistiken gewinnen, helfen Ihnen, Daten für maschinelle Lernaufgaben besser zu verstehen oder effizienter zu handhaben..
Deskriptive Statistik ist der Standardprozess in der Datenanalyse. Explorative Datenanalyse (EDA) ohne deskriptive statistische Analyse nicht vollständig.
Dann, In diesem Artikel, Ich erkläre die Attribute des Datensatzes mit deskriptiven Statistiken. Es ist in zwei Teile gegliedert: Messung zentraler Datenpunkte und Messung der Ausbreitung. Bevor Sie mit unserer Analyse beginnen, wir müssen den Datenerfassungs- und Bereinigungsprozess abschließen.
Datenerhebung und Datenbereinigung
Wir erheben Daten von hier. Ich werde Testdaten nur zur Analyse verwenden. Sie können Test und Daten aus AusbildungTraining ist ein systematischer Prozess zur Verbesserung der Fähigkeiten, körperliche Kenntnisse oder Fähigkeiten. Es wird in verschiedenen Bereichen angewendet, wie Sport, Aus- und Weiterbildung. Zu einem effektiven Trainingsprogramm gehört auch die Zielplanung, Regelmäßiges Üben und Bewerten der Fortschritte. Anpassung an individuelle Bedürfnisse und Motivation sind Schlüsselfaktoren, um in jeder Disziplin erfolgreiche und nachhaltige Ergebnisse zu erzielen.... für die Analyse. Hier ist ein Code für den Datenbereinigungsprozess der Zugdaten.
Aus Code entfernen
- Spalte Item_Weight und Outlet_Size haben Nullwerte. Das sind die Optionen:
-
- Zeilen mit Nullwerten entfernen
- Spalten mit Nullwerten entfernen
- oder Nullwerte ersetzen.
- Der Erste 2 Optionen sind möglich, wenn Daten Zeilen in Millionen haben oder die Anzahl der Werte klein ist. Dann, Ich wähle die dritte Option, um das Nullwertproblem zu lösen.
- Zuerst, finde den Item_Identifier und seinen entsprechenden Item_Weight. Dann ersetzen Sie, was fehlt / null in Item_Weight mit dem bekannten Item_weight des jeweiligen item_identifier.
- Wie wir wissen, die Sichtbarkeit von Artikeln in einem Geschäft kann nahe Null sein, aber nicht Null. Dann, Wir erwägen 0 als Nullwert und wir folgen dem vorherigen Schritt für Item_Visibility.
- Outlet_Size ist bei unserer Analyse und Vorhersage von Modellen nicht sehr wichtig. Dann, Ich lasse diese Kolumne fallen.
- Ersetzen Sie LF und reg in der Spalte Item_fat_content durch Low Fat und Regular Fat.
- Berechnen Sie das Alter der Geschäfte und speichern Sie diese Werte in der Spalte Outlet_years und löschen Sie die Spalte Outlet_Establishment_year.
Beginnen wir mit der Datenanalyse der deskriptiven Statistik.
Das Maß des zentralen Datenpunktes
Ermittlung des numerischen und kategorialen Rechenzentrums anhand des Mittelwerts, das MedianDer Median ist ein statistisches Maß, das den zentralen Wert eines Satzes geordneter Daten darstellt. Um es zu berechnen, Die Daten werden von der niedrigsten zur höchsten sortiert und die Zahl in der Mitte wird identifiziert. Wenn es eine gerade Anzahl von Beobachtungen gibt, Die beiden Kernwerte werden gemittelt. Dieser Indikator ist besonders nützlich bei asymmetrischen Verteilungen, da es nicht von Extremwerten beeinflusst wird.... und die Mode ist bekannt als Central Data Point Measurement. Berechnen der Mittelwerte der Spaltendaten mit dem Mittelwert, Median und Modus unterscheiden sich voneinander.
Gut, dann, lass uns den Mittelwert berechnen, der Median, die Anzahl und den Modus von Datensatzattributen mit Python.
- Erzählen
Das Zählen hilft nicht direkt, den Mittelpunkt der Datensatzattribute zu finden. Aber es wird bei der Berechnung des Mittelwertes verwendet, Median und Modus. Wir berechnen die Gesamtzahl in jeder Kategorie der kategorialen Variablen. Berechnet auch die Gesamtzahl der numerischen Spaltendaten.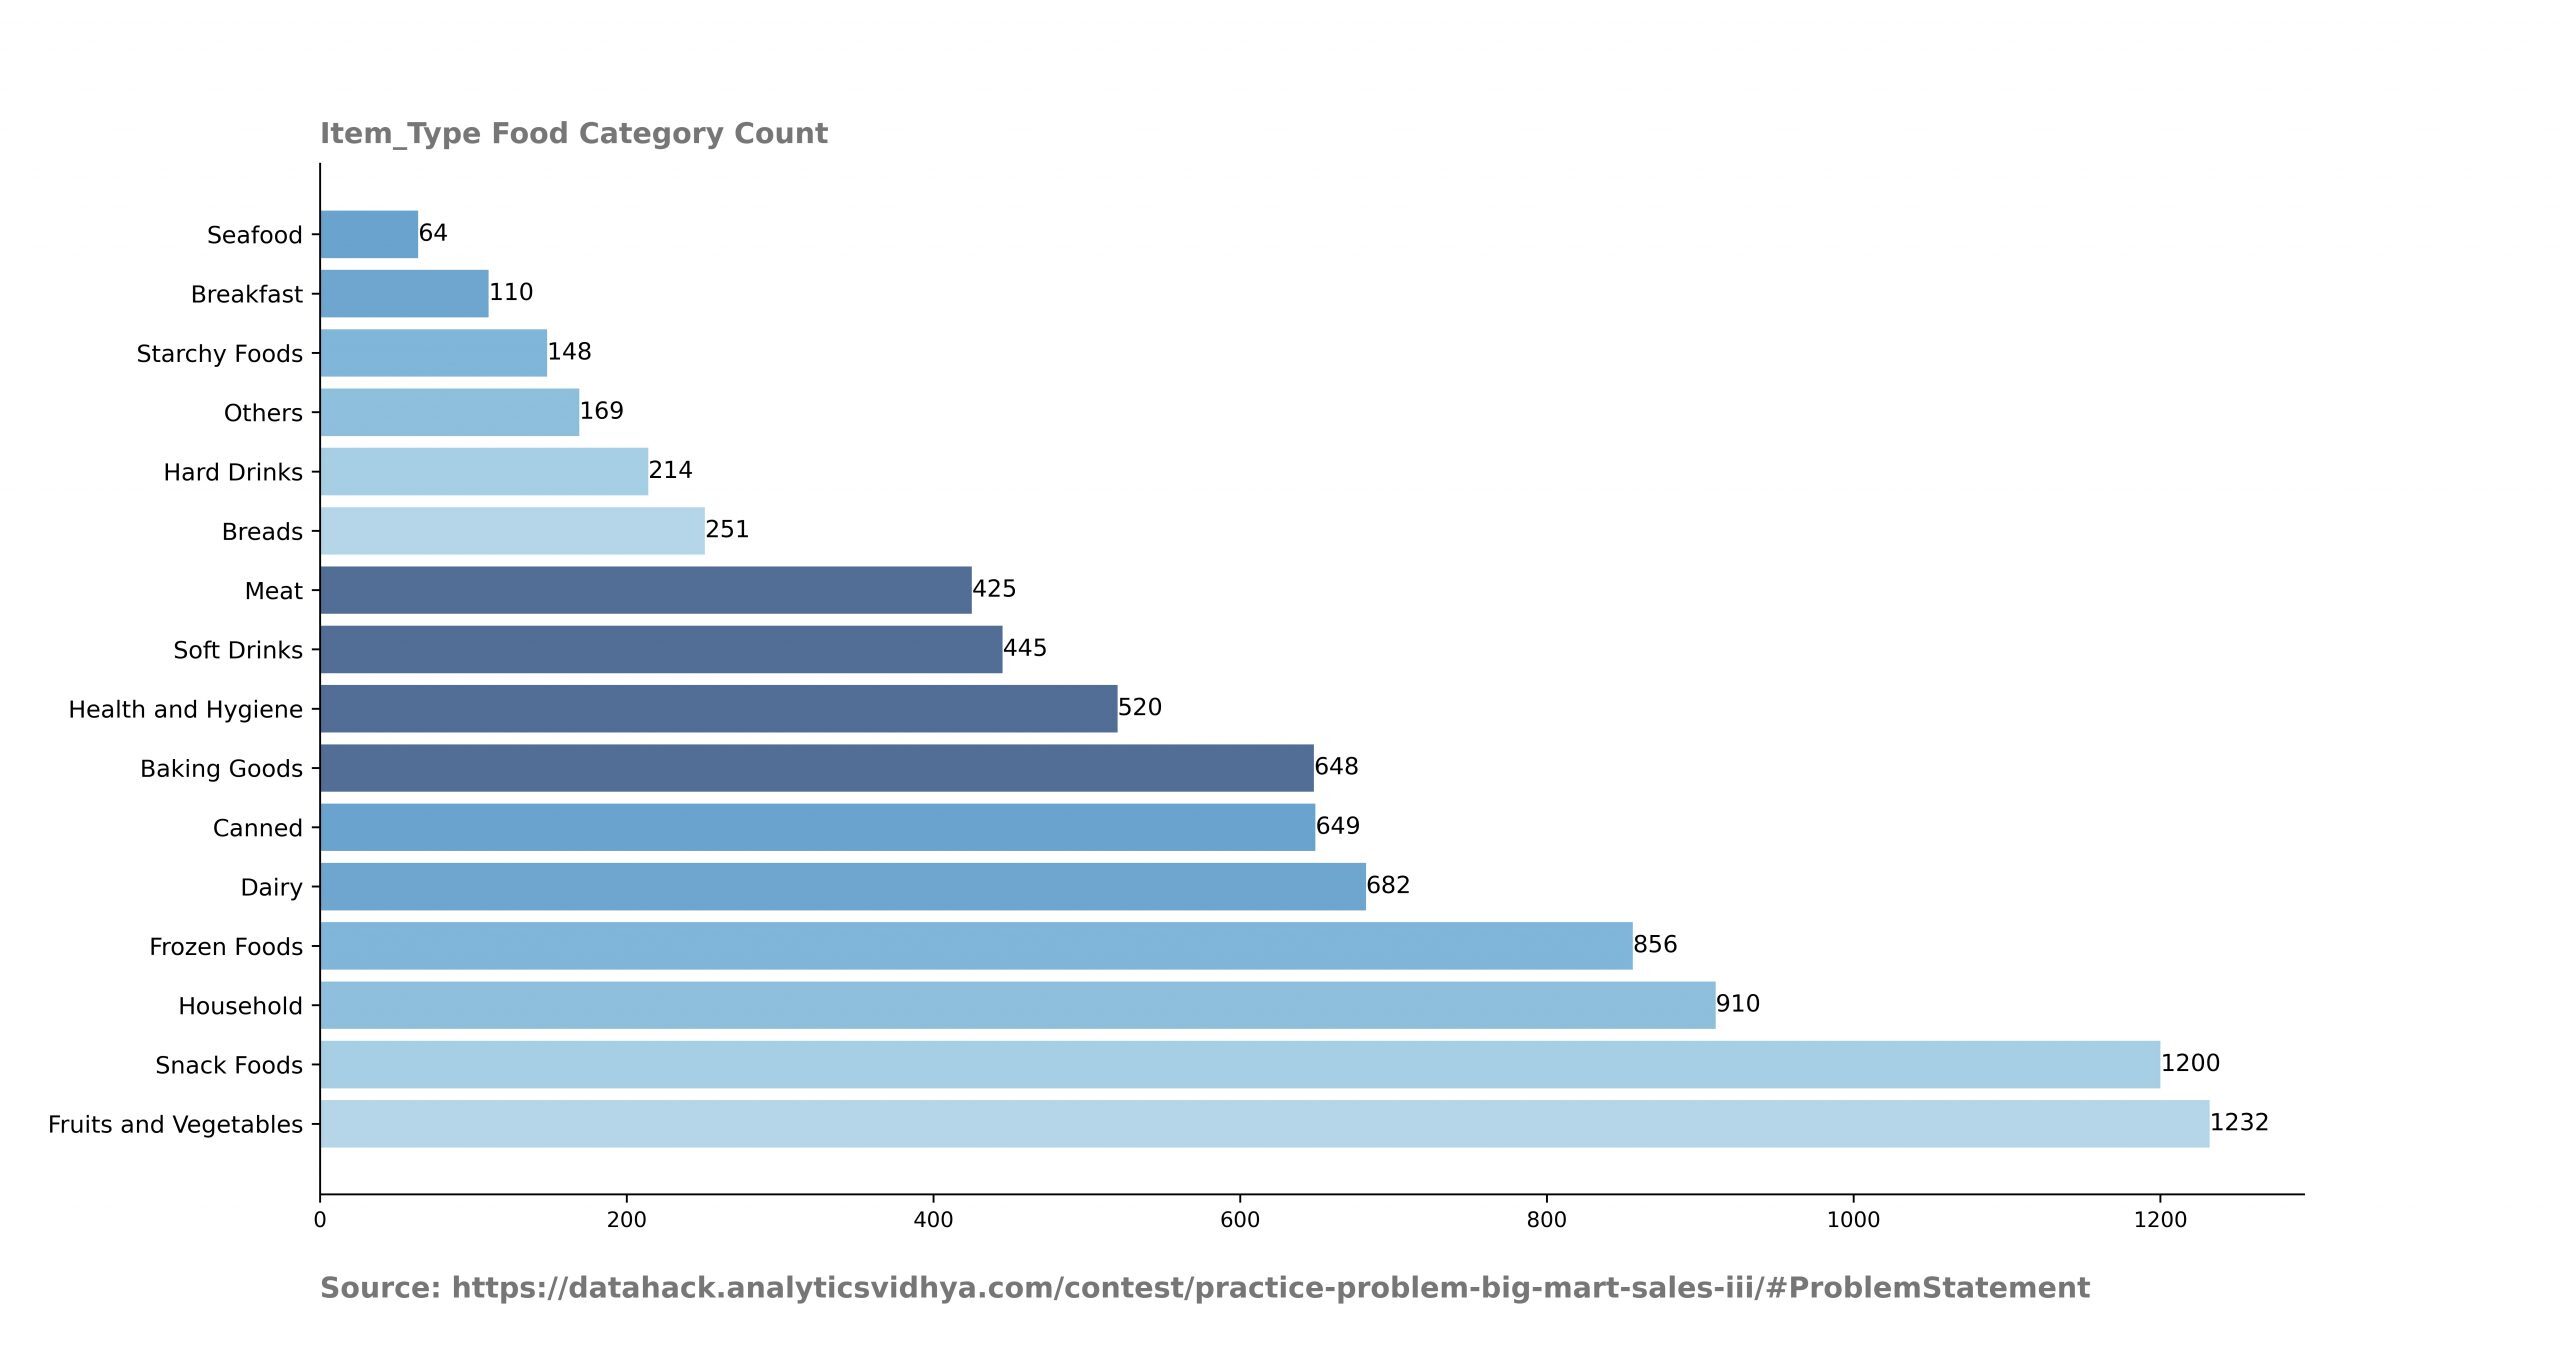
Aus Code entfernen.
- Gehen Sie durch die kategorialen Spalten, um die Kategorie und ihre Anzahl darzustellen.
Output-Analyse.
- Diese Zählungen helfen Ihnen herauszufinden, ob die Daten ausgeglichen sind oder nicht. Aus dieser Grafik, Ich kann sagen, dass die Ränge der Kategorie Obst und Gemüse viel mehr sind als die Kategorie der Meeresfrüchte.
- Wir können auch davon ausgehen, dass der Umsatz in der Kategorie Obst und Gemüse deutlich höher ist als in der Kategorie Meeresfrüchte..
-
Meinen
Die Summe der in der Spalte vorhandenen Werte geteilt durch die Gesamtzahl der Zeilen in dieser Spalte wird als Mittelwert bezeichnet. Auch als Durchschnitt bekannt.
Benutzen train.mean () um den Mittelwert der numerischen Spalten des Zugdatensatzes zu berechnen.
Hier ist ein Code für kategoriale Spalten aus dem Zug-Dataset.
drucken(Bahn[['Item_Outlet_Sales','Outlet_Type']].gruppiere nach(['Outlet_Type']).ag({'Item_Outlet_Sales':'mean'}))
Output-Analyse
- Das durchschnittliche Austrittsalter beträgt 15 Jahre.
- Der durchschnittliche Outlet-Umsatz beträgt 2100.
- Die Kategorie des Supermarkttyps 3 Outlet_Type's hat viel mehr Verkäufe als die Kategorie Lebensmittelgeschäfte.
- Wir können auch davon ausgehen, dass die Kategorie Supermarkt beliebter ist als die Kategorie Lebensmittelgeschäfte..
-
Median
Der zentrale Wert eines Attributs wird als Median bezeichnet. Wie berechnen wir den Medianwert? Zuerst, Spaltendaten in aufsteigender oder absteigender Reihenfolge sortieren. Dann finde die Summe der Zeilen und dividiere sie durch 2.
Dieser Ausgabewert ist der Median dieser Spalte.
Der Medianwert teilt die Datenpunkte in zwei Teile. Das bedeutet die 50% der Datenpunkte liegen oberhalb des Medians und der 50% unter.
Allgemein, Median- und Mittelwerte sind für die gleichen Daten unterschiedlich.
Median wird nicht von Ausreißern beeinflusst. Aufgrund von Ausreißern, die Differenz zwischen Mittel- und Medianwerten nimmt zu.
Benutzen train.median () um den Mittelwert der numerischen Spalten des Zugdatensatzes zu berechnen.
Hier ist ein Code für kategoriale Spalten aus dem Zug-Dataset.
drucken(Bahn[['Item_Outlet_Sales','Outlet_Type']].gruppiere nach(['Outlet_Type']).ag({'Item_Outlet_Sales':'median'}))
Output-Analyse
- Die meisten Beobachtungen stimmen mit dem Mittelwert überein.
- Die Differenz zwischen Mittel- und Medianwert ist auf Ausreißer zurückzuführen. Sie können diesen Unterschied auch bei kategorialen Variablen beobachten.
- Weg
Der Modus ist der Datenpunkt, dessen Anzahl das Maximum in einer Spalte ist. Es gibt nur einen Mittel- und Medianwert für jede Spalte. Aber Attribute können mehr als einen Moduswert haben. Benutzen train.mode () um den Mittelwert der numerischen Spalten des Zugdatensatzes zu berechnen. Hier ist ein Code für die kategorialen Spalten des Zugdatensatzes.drucken(Bahn[['Item_Outlet_Sales', 'Outlet_Type', 'Outlet_Identifier', 'Item_Identifier']].gruppiere nach(['Outlet_Type']).ag(Lambda x:x.value_counts().Index[0]))
Output-Analyse
- Outlet_Type hat einen Moduswert. Supermarkttyp 1. Die Supermarkt-Typenkategorie 1 Der meistverkaufte Artikel- oder Moduswert beträgt FDZ15.
- Item_Identifier FDH50 ist der meistverkaufte Artikel in der Kategorie Outlet_Type.
Ausbreitungsmaße
Ein Streuungsmaß erklärt, wie unterschiedlich die Attributwerte im Datensatz sind. Auch bekannt als Maß für die Ausbreitung. Aus dieser Statistik, Erfahren Sie, wie und warum Daten von einem Punkt zum anderen weitergegeben werden.
Dies sind die Statistiken, die in das Ausbreitungsmaß einfließen.
- Distanz
- Perzentile oder Quartile
- Standardabweichung
- Unterschied
- Schiefe
-
Distanz
Die Differenz zwischen dem Maximalwert und dem Minimalwert in einer Spalte wird als Bereich bezeichnet.
Hier ist ein Code, um die Reichweite zu berechnen.
für ich in num_col:
    drucken(F"Spalte: {ich} Max_Wert: {max(Bahn[ich])} Min_Wert: {Mindest(Bahn[ich])} Bereich: {runden(max(Bahn[ich]) - Mindest(Bahn[ich]),2)}")
Sie können auch den Rang von kategorialen Spalten berechnen. Hier ist ein Code, um die Mindest- und Höchstwerte in jeder Ausgabekategorie herauszufinden.
Output-Analyse
- Die Reichweite von Item_MRP und Item_Outlet_sales ist hoch und muss möglicherweise transformiert werden.
- In Item_MRP gibt es große Unterschiede in der Kategorie Supermarkttyp 3.
- Perzentile oder QuartileWir können die Verteilung der Spaltenwerte beschreiben, indem wir die Zusammenfassung mehrerer Perzentile berechnen. Der Median wird auch als Perzentil bezeichnet 50 der Daten. Hier ist ein anderes Perzentil.
- Der Mindestwert ist gleich dem Perzentil 0.
- Der Maximalwert entspricht dem Perzentil 100.
- Das erste Quartil entspricht dem Perzentil 25.
- Das dritte Quartil entspricht dem Perzentil 75.
Hier ist ein Code zur Berechnung der Quartile.
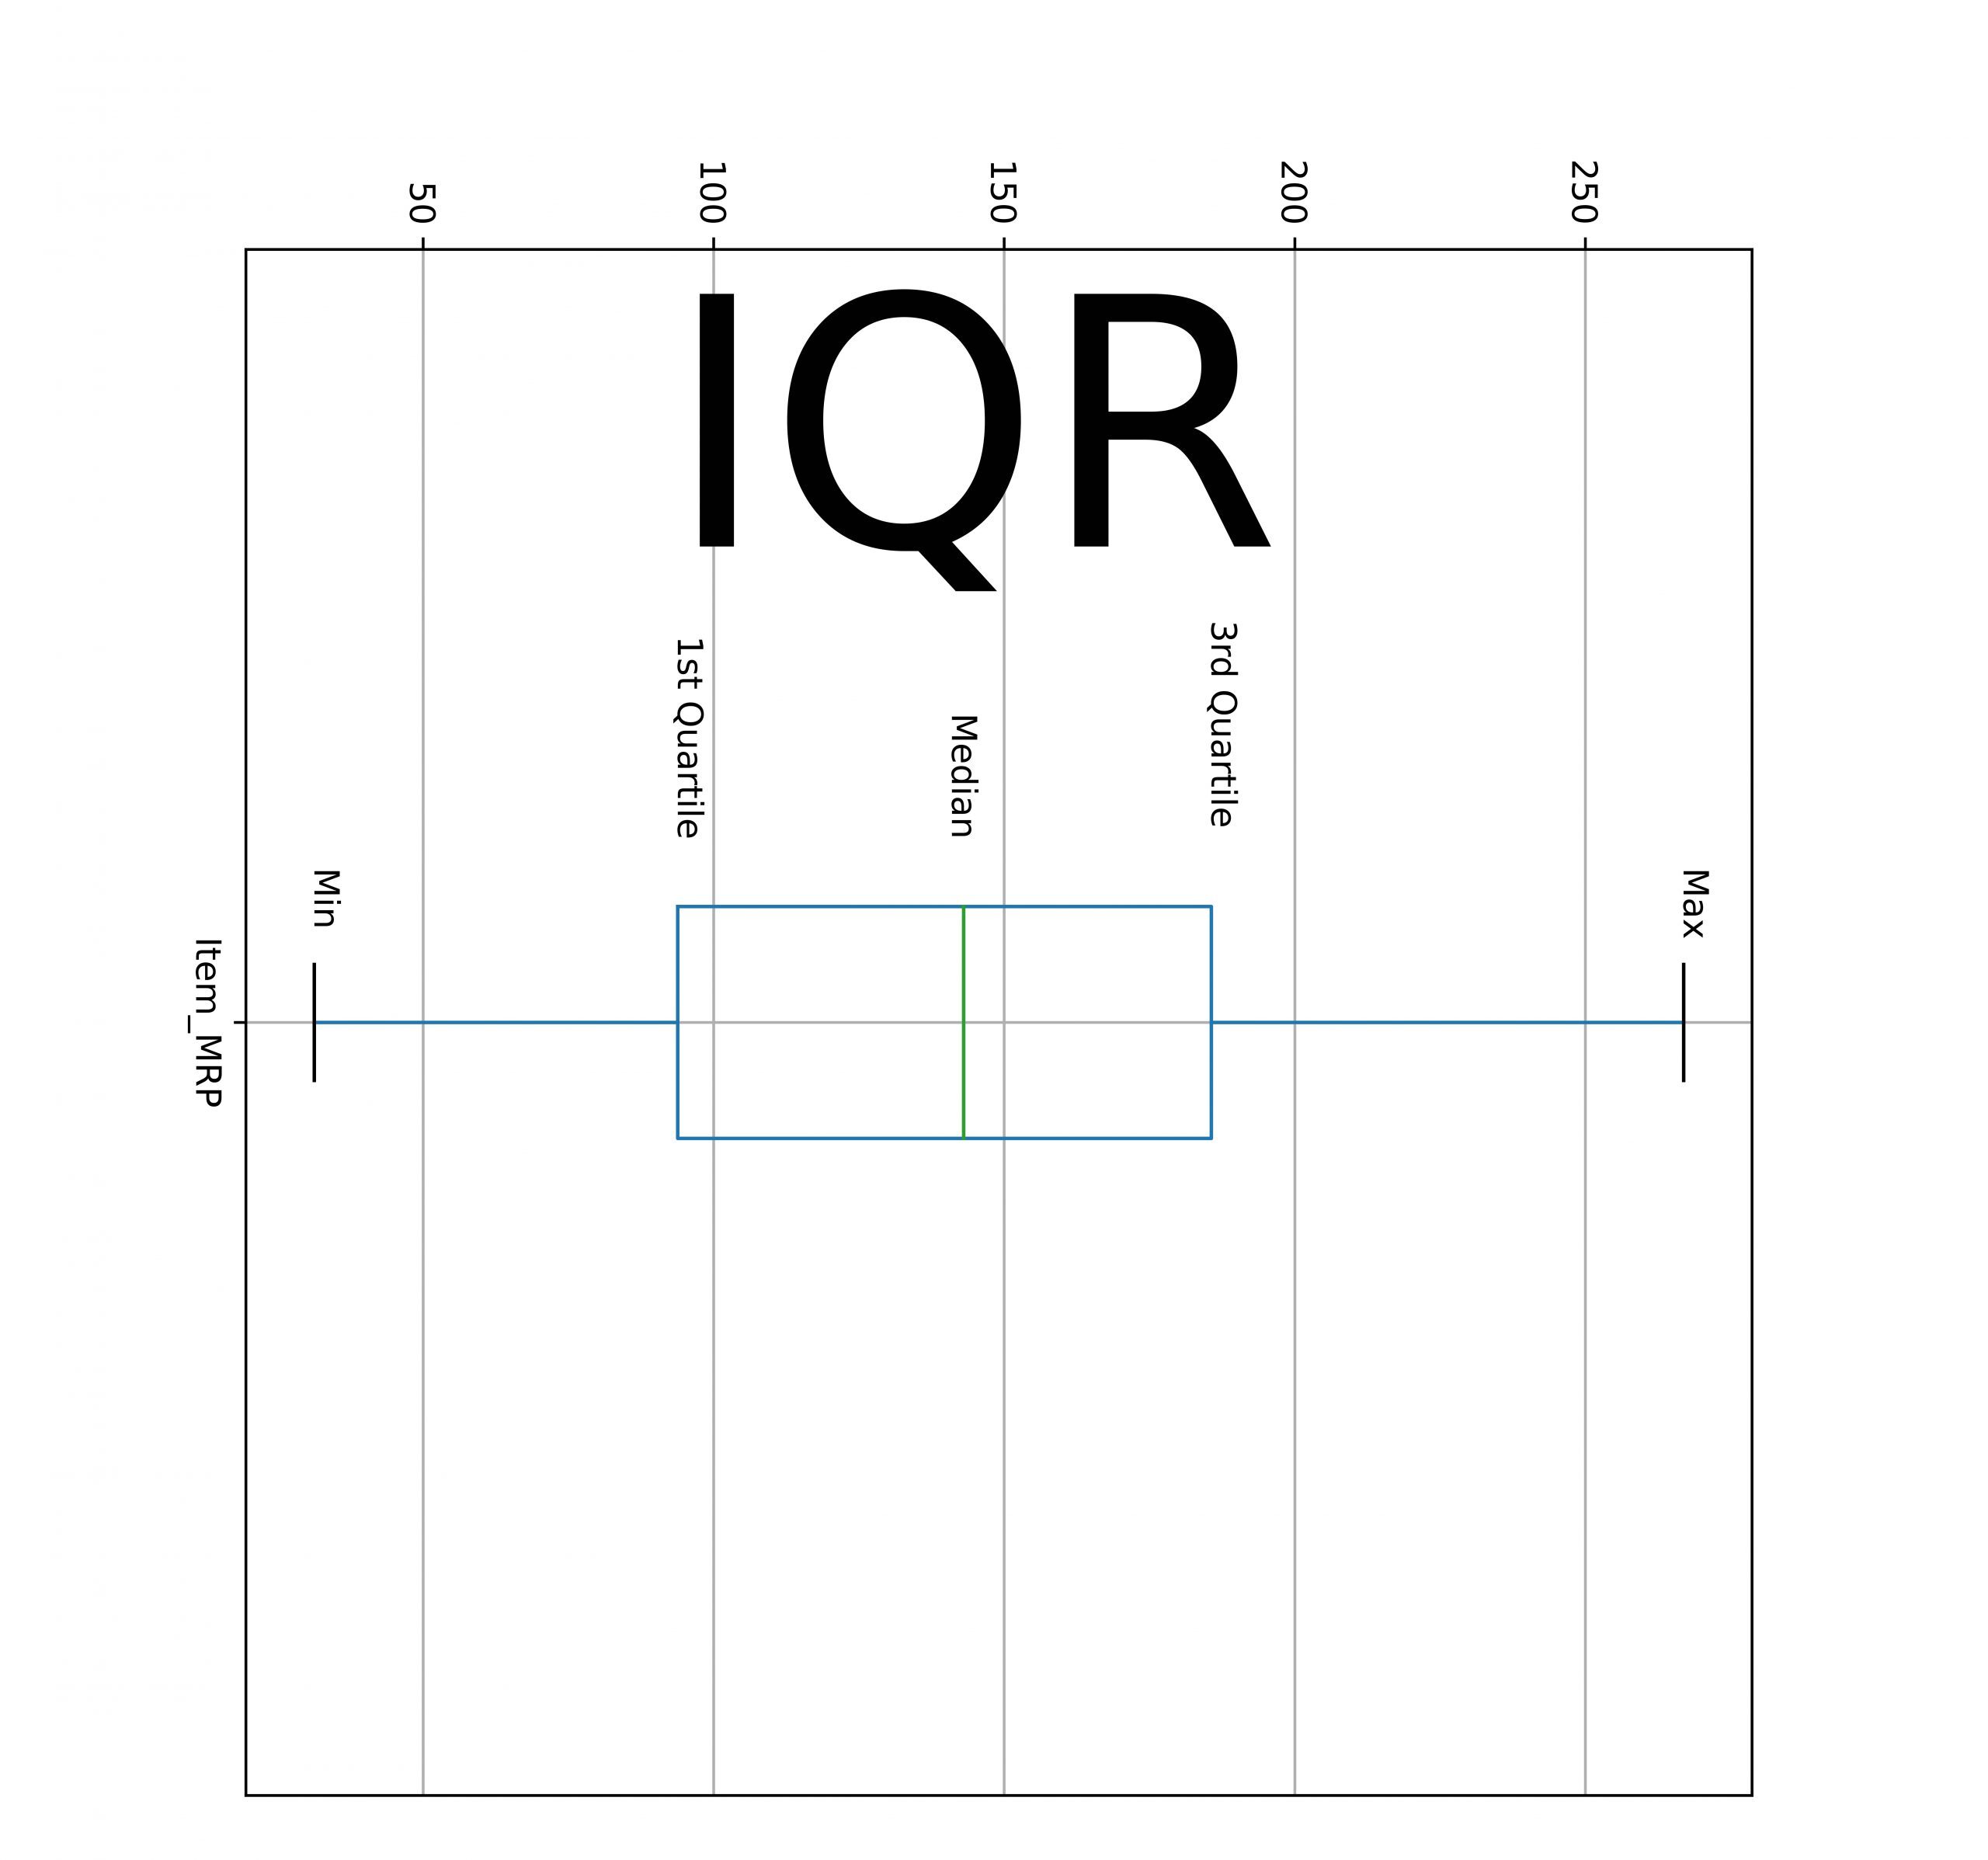
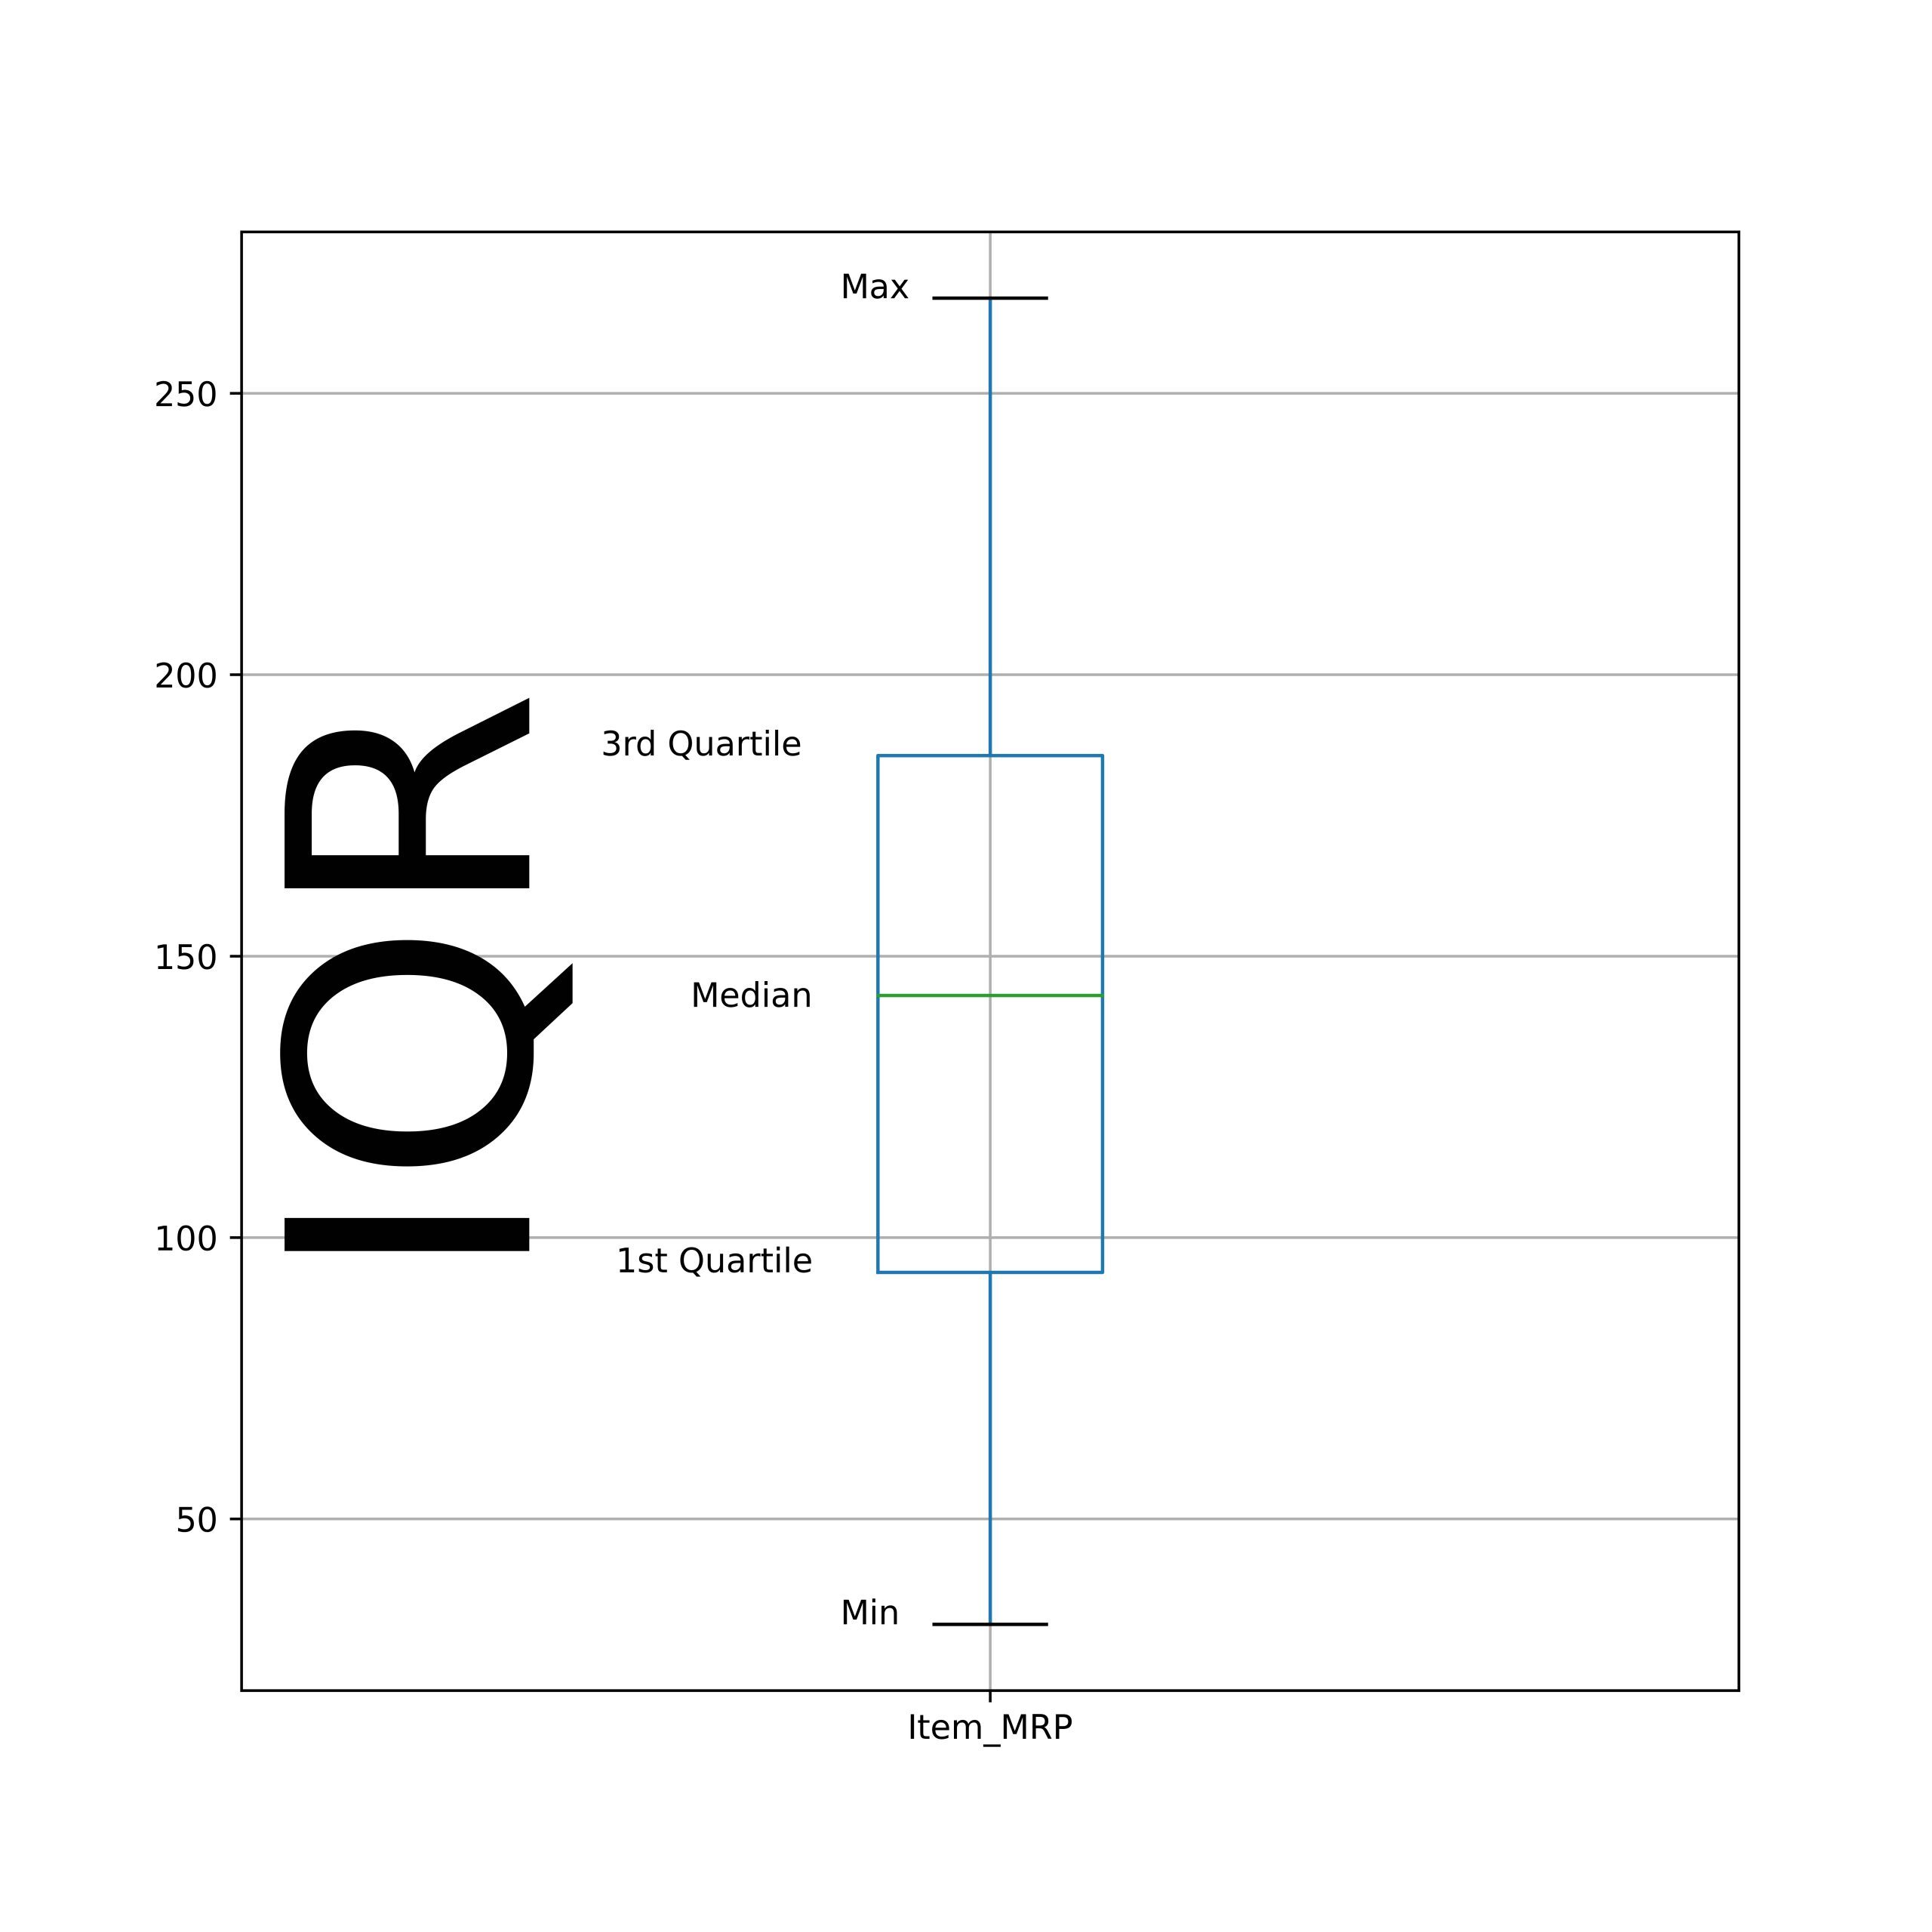
Der Unterschied zwischen 3rd und das 1NS Das Quartil wird auch als Interquartil bezeichnet (IQR). Was ist mehr, maximale Datenpunkte sind im IQR enthalten.
-
Standardabweichung
Der Wert der Standardabweichung sagt uns, wie stark alle Datenpunkte vom Mittelwert abweichen. Die Standardabweichung wird von Ausreißern beeinflusst, da sie den Mittelwert für ihre Berechnung verwendet.
Hier ist ein Code zur Berechnung der Standardabweichung.
für ich in num_col:
    drucken(ich , runden(Bahn[ich].std(),2))
Pandas haben auch eine Verknüpfung, um alle oben genannten Statistikwerte zu berechnen.
Zug.beschreiben()
- UnterschiedDie Varianz ist das Quadrat der Standardabweichung. Bei Ausreißern, der Wert der Varianz wird groß und spürbar. Deswegen, ist auch von Ausreißern betroffen. Hier ist ein Code zur Berechnung der Varianz
für ich in num_col:
    drucken(ich , runden(Bahn[ich].wo(),2))
Output-Analyse.
- Die Spalten Item_MRP und Item_Outlet_sales weisen aufgrund von Ausreißern eine große Varianz auf.
-
Schiefe
Im Idealfall, die Datenverteilung sollte in Gaußscher Form vorliegen (Glockenkurve). Aber praktisch, Datenformen sind verzerrt oder verzerrt. Dies wird als Schiefe in den Daten bezeichnet..
Sie können die Schiefe der Zugdaten berechnen mit train.skew (). Der Bias-Wert kann negativ sein (links) Das Positive (rechts). Sein Wert muss nahe Null liegen.
Abschließende Anmerkungen
Dies sind die Statistiken, auf die wir zurückgreifen, wenn wir eine explorative Datenanalyse des Datensatzes durchführen. Sie sollten auf die durch diese Statistiken generierten Werte achten und fragen, warum diese Zahl. Diese Statistiken helfen uns, die Attribute für die Datentransformation und das Entfernen von Variablen aus der Nachbearbeitung zu bestimmen..
Die Pandas-Bibliothek hat wirklich gute Funktionen, die Ihnen helfen, beschreibende Statistikwerte in einer Codezeile zu erhalten.





