
Dieser Beitrag wurde im Rahmen der . veröffentlicht Data Science Blogathon.
Einführung
In diesem Beitrag, intentaremos mitigar eso a través de el uso del VerstärkungslernenReinforcement Learning ist eine Technik der künstlichen Intelligenz, die es einem Agenten ermöglicht, durch Interaktion mit einer Umgebung zu lernen, Entscheidungen zu treffen. Durch Feedback in Form von Belohnungen oder Bestrafungen, Der Agent optimiert sein Verhalten, um die kumulierten Belohnungen zu maximieren. Dieser Ansatz wird in einer Vielzahl von Anwendungen eingesetzt, Von Videospielen über Robotik bis hin zu Empfehlungssystemen, Er zeichnet sich durch seine Fähigkeit aus, komplexe Strategien zu erlernen.....
Techniken, mit denen wir Aktienkurse vorhersagen können
Da es sich um eine Vorhersage kontinuierlicher Werte handelt, jede Art von Regressionstechnik kann verwendet werden:
- Lineare Regression hilft Ihnen, kontinuierliche Werte vorherzusagen
- Zeitreihenmodelle sind Modelle, die für zeitbezogene Daten verwendet werden können.
- ARIMA ist eines dieser Modelle, das verwendet wird, um futuristische Vorhersagen im Zusammenhang mit der Zeit vorherzusagen..
- LSTM ist auch eine dieser Techniken, die für Aktienkursvorhersagen verwendet wurde.. LSTM bezieht sich auf das Langzeitgedächtnis und nutzt neuronale Netze, um kontinuierliche Werte vorherzusagen. LSTMs sind sehr leistungsstark und dafür bekannt, dass sie das Langzeitgedächtnis behalten.
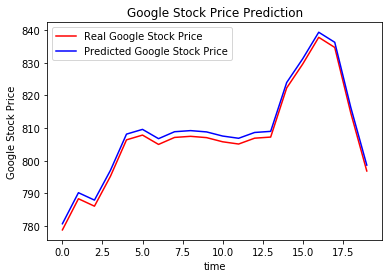
Trotz dieses, es gibt eine andere Technik, die für Aktienkursvorhersagen verwendet werden kann, und das ist Reinforcement Learning.
Was ist Reinforcement Learning??
El aprendizaje por refuerzo es otro tipo de aprendizaje automático al mismo tiempo del überwachtes LernenÜberwachtes Lernen ist ein Ansatz des maschinellen Lernens, bei dem ein Modell mit einem Satz von beschrifteten Daten trainiert wird. Jede Eingabe im Dataset ist mit einer bekannten Ausgabe verknüpft, So kann das Modell lernen, Ergebnisse für neue Eingaben vorherzusagen. Diese Methode wird häufig in Anwendungen wie der Bildklassifizierung eingesetzt., Spracherkennung und Trendvorhersage, und unterstreicht seine Bedeutung in... und unbeaufsichtigt. Es ist ein agentenbasiertes Lernsystem, bei dem der Agent Aktionen in einer Umgebung ausführt, in der das Ziel darin besteht, die Registrierung zu maximieren. Reinforcement Learning erfordert keine Verwendung von gekennzeichneten Daten wie überwachtes Lernen.
Reinforcement Learning funktioniert hervorragend mit weniger historischen Daten. Es verwendet die Wertfunktion und berechnet sie basierend auf der Richtlinie, die für diese Aktion festgelegt wurde.
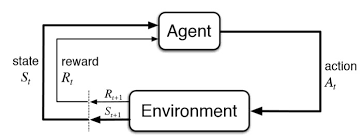
Reinforcement Learning wird als Markov-Entscheidungsverfahren modelliert (MDP):
-
Eine Umgebung E und Agentenzustände S
-
Eine Reihe von Aktionen A, die vom Agenten ausgeführt werden.
-
P (S, S ‚) => P (NS + 1 = s‘ | st = s, at = a) ist die Übergangswahrscheinlichkeit von einem Zustand nach s ‚
-
R (S, S ‚): sofortige Belohnung für jede Aktion
Wie können wir mit Reinforcement Learning Börsenkurse vorhersagen??
Das Konzept des verstärkten Lernens kann angewendet werden, um den Aktienkurs für eine bestimmte Aktie zu prognostizieren., da es die gleichen Grundprinzipien verwendet, um kleinere historische Daten zu verlangen, an einem agentenbasierten System arbeiten, um höhere Renditen basierend auf der aktuellen Umgebung vorherzusagen. Wir werden ein Beispiel für die Vorhersage des Kurses einer Aktie für eine bestimmte Aktie nach dem Reinforcement-Learning-Modell sehen. Nutzt das näher erläuterte Q-Lernkonzept.
Die Schritte zum Entwerfen eines Reinforcement-Learning-Modells sind::
- Bibliotheken importieren
- Erstellen Sie den Agenten, der alle Entscheidungen trifft.
- Grundfunktionen zum Formatieren von Werten einstellen, Sigmoidfunktion, Datendatei lesen, etc.
- Den Agenten ausbilden
- Agentenleistung prüfen
Schaffen Sie eine verstärkte Lernumgebung
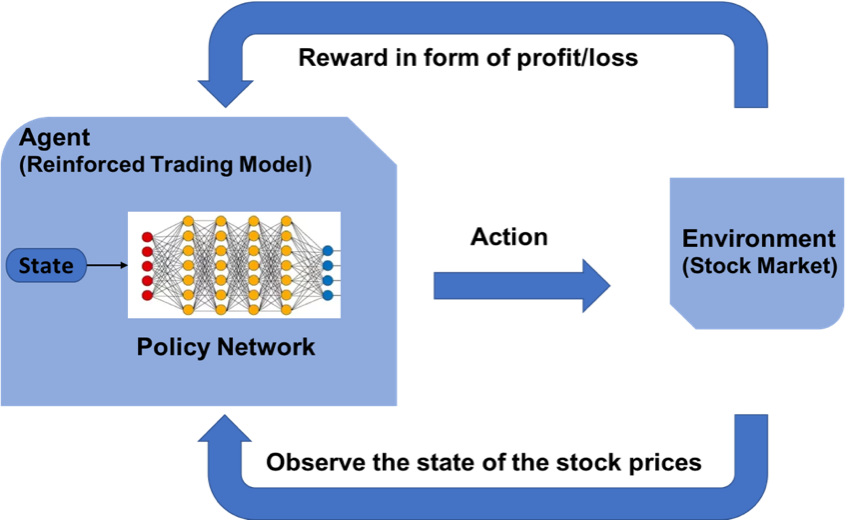
MDP für Aktienkursprognose:
- Agent: ein Agent A, der in der Umgebung E . arbeitet
- Aktion – Kaufen / Markt / Pflegen
- Zustand: Datenwerte
- Belohnung: Profite / Verluste
Qs Rolle – Lernen
Q-Learning ist ein modellloser Reinforcement-Learning-Algorithmus, um die Qualität von Aktionen zu kennen und einem Agenten mitzuteilen, welche Aktion unter welchen Umständen zu ergreifen ist. Q-Learning findet eine optimale Strategie im Sinne der Maximierung des erwarteten Werts der Gesamtvergütung in jedem nachfolgenden Schritt, ausgehend vom aktuellen Stand.
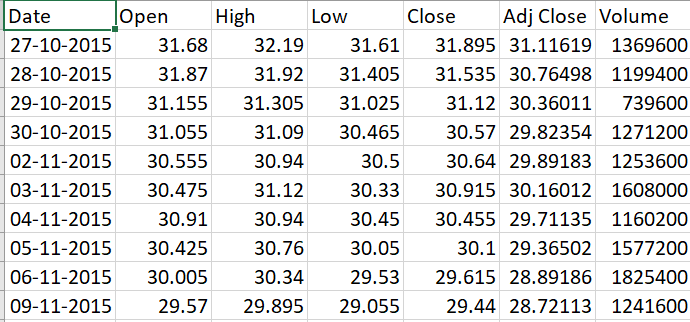
Datensammlung
-
Ich bin ein Yahoo Finanzen
-
Geben Sie den Firmennamen ein, als Beispiel. Banco HDFC
-
Wählen Sie den Zeitraum für, als Beispiel, 5 Jahre
-
Klicken Sie auf Download, um die CSV-Datei herunterzuladen
Lassen Sie uns unser Modell in Python implementieren
Bibliotheken importieren
So erstellen Sie das Reinforcement-Learning-Modell, importe las bibliotecas de Python indispensables para modelar las capas de la rotes neuronalesNeuronale Netze sind Rechenmodelle, die von der Funktionsweise des menschlichen Gehirns inspiriert sind. Sie nutzen Strukturen, die als künstliche Neuronen bekannt sind, um Daten zu verarbeiten und daraus zu lernen. Diese Netze sind grundlegend im Bereich der künstlichen Intelligenz, Dies ermöglicht erhebliche Fortschritte bei Aufgaben wie der Bilderkennung, Verarbeitung natürlicher Sprache und Vorhersage von Zeitreihen, unter anderen. Ihre Fähigkeit, komplexe Muster zu erlernen, macht sie zu mächtigen Werkzeugen.. y la biblioteca NumPy para algunas operaciones básicas.
import keras
from keras.models import Sequential
from keras.models import load_model
from keras.layers import Dense
from keras.optimizers import Adam
import math
import numpy as np
import random
from collections import deque
Erstellen des Agenten
El código del agente comienza con algunas inicializaciones básicas para los distintos ParameterDas "Parameter" sind Variablen oder Kriterien, die zur Definition von, ein Phänomen oder System zu messen oder zu bewerten. In verschiedenen Bereichen wie z.B. Statistik, Informatik und naturwissenschaftliche Forschung, Parameter sind entscheidend für die Etablierung von Normen und Standards, die die Datenanalyse und -interpretation leiten. Ihre richtige Auswahl und Handhabung sind entscheidend, um genaue und relevante Ergebnisse in jeder Studie oder jedem Projekt zu erhalten..... Einige statische Variablen sind als Gamma definiert, Epsilon, epsilon_min und epsilon_decay. Dies sind konstante Schwellenwerte, die verwendet werden, um den gesamten Prozess des Kaufs und Verkaufs von Aktien voranzutreiben und die Parameter ruhig zu halten.. Diese Minimal- und Drop-Werte dienen als Schwellenwerte in der Normalverteilung.
Agent entwirft ein mehrschichtiges neuronales Netzwerkmodell zur Durchführung von Kaufaktionen, Verkauf oder Aufbewahrung. Diese Art von Aktion wird durchgeführt, indem Sie Ihre vorherige Vorhersage und auch den Zustand der aktuellen Umgebung beobachten. Die act-Methode wird verwendet, um die nächste zu ergreifende Aktion vorherzusagen. Wenn der Speicher gefüllt ist, Es gibt eine andere Methode namens ExprePlay, die zum Zurücksetzen des Speichers entwickelt wurde.
Klassenagent:
    def __init__(selbst, state_size, is_eval=Falsch, model_name=""):
        self.state_size = state_size # normalized previous days
        self.action_size = 3 # Sitzen, kaufen, sell
        self.memory = deque(maxlen=1000)
        self.inventory = []
        self.model_name = model_name
        self.is_eval = is_eval
        self.gamma = 0.95
        self.epsilon = 1.0
        self.epsilon_min = 0.01
        self.epsilon_decay = 0.995
        self.model = load_model(Modellname) wenn is_eval sonst self._model()
    def _model(selbst):
        Modell = Sequentiell()
        model.add(Dicht(Einheiten=64, input_dim=self.state_size, Aktivierung="Lebenslauf"))
        model.add(Dicht(Einheiten=32, Aktivierung="Lebenslauf"))
        model.add(Dicht(Einheiten=8, Aktivierung="Lebenslauf"))
        model.add(Dicht(self.action_size, Aktivierung="linear"))
        model.compile(Verlust="mse", Optimierer=Adam(lr=0,001))
        return model
    def act(selbst, Zustand):
        wenn nicht self.is_eval und random.random()<= self.epsilon:
            return random.randrange(self.action_size)
        options = self.model.predict(Zustand)
        np.argmax zurückgeben(Optionen[0])
    def expReplay(selbst, batch_size):
        mini_batch = []
        l = len(self.memory)
        für mich in Reichweite(l - batch_size + 1, l):
            mini_batch.append(self.memory[ich])
        für den Staat, Aktion, Belohnung, next_state, erledigt in mini_batch:
            target = reward
            if not done:
                Ziel = Belohnung + self.gamma * np.amax(self.model.predict(next_state)[0])
            target_f = self.model.predict(Zustand)
            target_f[0][Aktion] = target
            self.model.fit(Zustand, target_f, Epochen=1, ausführlich=0)
        if self.epsilon > self.epsilon_min:
            self.epsilon *= self.epsilon_decay
Establecer funciones básicas
Der formatprice () wird geschrieben, um das Format der Währung zu strukturieren. GetStockDataVec () bringt die Bestandsdaten nach Python. Definieren der Sigmoidfunktion als mathematische Infinitesimalrechnung. GetState () so codiert ist, dass es den aktuellen Zustand der Daten bereitstellt.
def formatPreis(n):
    Rückkehr("-Rs." wenn nein<0 anders "Rs.")+"{0:.2F}".Format(Abs(n))
def getStockDataVec(Schlüssel):
    vec = []
    Linien = offen(Taste+".csv","R").lesen().Splitlines()
    für Zeile in Zeile[1:]:
        #drucken(Leitung)
        #drucken(schweben(Zeile.split(",")[4]))
        vec.append(schweben(Zeile.split(",")[4]))
        #drucken(Vec)
    return vec
def sigmoid(x):
    Rückkehr 1/(1+math.exp(-x))
def getState(Daten, T, n):
    d = t - n + 1
    block = Daten[D:T + 1] wenn d >= 0 else -d * [Daten[0]] + Daten[0:T + 1] # pad with t0
    res = []
    für mich in Reichweite(n - 1):
        res.append(sigmoid(Block[ich + 1] - Block[ich]))
    np.array zurückgeben([res])
Schulung des Agenten
Abhängig von der vom Modell vorhergesagten Aktion, Der Kaufaufruf / Verkauf addiert oder subtrahiert Geld. Sei mit dem Medikament der Episoden in der Folge, in der die Episoden der Bücher sind, die die Episoden verlassen haben tiefes LernenTiefes Lernen, Eine Teildisziplin der Künstlichen Intelligenz, verlässt sich auf künstliche neuronale Netze, um große Datenmengen zu analysieren und zu verarbeiten. Diese Technik ermöglicht es Maschinen, Muster zu lernen und komplexe Aufgaben auszuführen, wie Spracherkennung und Computer Vision. Seine Fähigkeit, sich kontinuierlich zu verbessern, wenn mehr Daten zur Verfügung gestellt werden, macht es zu einem wichtigen Werkzeug in verschiedenen Branchen, von Gesundheit.... Dann, Das Modell wird später gespeichert.
import sys
stock_name = input("Geben Sie stock_name ein, window_size, Episode_count")
window_size = Eingabe()
episode_count = Eingabe()
stock_name = str(stock_name)
window_size = int(window_size)
episode_count = int(episode_count)
Agent = Agent(window_size)
Daten = getStockDataVec(stock_name)
l = len(Daten) - 1
batch_size = 32
für e im Bereich(episode_count + 1):
    drucken("Episode " + str(e) + "/" + str(episode_count))
    Zustand = getState(Daten, 0, window_size + 1)
    total_profit = 0
    agent.inventory = []
    für T im Bereich(l):
        Aktion = agent.act(Zustand)
        # sit
        next_state = getState(Daten, T + 1, window_size + 1)
        Belohnung = 0
        wenn Aktion == 1: # buy
            agent.inventory.append(Daten[T])
            drucken("Kaufen: " + formatPreis(Daten[T]))
        ELIF-Aktion == 2 und len(Agent.Inventar) > 0: # sell
            bought_price = window_size_price = agent.inventory.pop(0)
            Belohnung = max(Daten[T] - bought_price, 0)
            total_profit += Daten[T] - bought_price
            print("Verkaufen: " + formatPreis(Daten[T]) + " | Gewinn: " + formatPreis(Daten[T] - bought_price))
        done = True, wenn t == l - 1 else False
        agent.memory.append((Zustand, Aktion, Belohnung, next_state, fertig))
        state = next_state
        if done:
            drucken("--------------------------------")
            drucken("Gesamtgewinn: " + formatPreis(total_profit))
            drucken("--------------------------------")
        wenn len(agent.memory) > batch_size:
            agent.expReplay(batch_size)
    Wenn e % 10 == 0:
        agent.model.save(str(e))
Salida de AusbildungTraining ist ein systematischer Prozess zur Verbesserung der Fähigkeiten, körperliche Kenntnisse oder Fähigkeiten. Es wird in verschiedenen Bereichen angewendet, wie Sport, Aus- und Weiterbildung. Zu einem effektiven Trainingsprogramm gehört auch die Zielplanung, Regelmäßiges Üben und Bewerten der Fortschritte. Anpassung an individuelle Bedürfnisse und Motivation sind Schlüsselfaktoren, um in jeder Disziplin erfolgreiche und nachhaltige Ergebnisse zu erzielen.... al final del primer episodio:
Gesamtgewinn: Rs.340.03
Modellbewertung
Sobald das Modell basierend auf den neuen Daten trainiert wurde, Sie können das Modell testen, um die Gewinne festzulegen / Angebotene Verluste. Folglich, kann die Glaubwürdigkeit des Modells prüfen.
stock_name = Eingabe("Geben Sie Stock_name ein, Model_name")
model_name = Eingabe()
model = load_model(Modellname)
window_size = model.layers[0].input.shape.as_list()[1]
Agent = Agent(window_size, Wahr, Modellname)
Daten = getStockDataVec(stock_name)
drucken(Daten)
l = len(Daten) - 1
batch_size = 32
Zustand = getState(Daten, 0, window_size + 1)
drucken(Zustand)
total_profit = 0
agent.inventory = []
drucken(l)
für T im Bereich(l):
    Aktion = agent.act(Zustand)
    drucken(Aktion)
    # sit
    next_state = getState(Daten, T + 1, window_size + 1)
    Belohnung = 0
    wenn Aktion == 1: # buy
        agent.inventory.append(Daten[T])
        drucken("Kaufen: " + formatPreis(Daten[T]))
    ELIF-Aktion == 2 und len(Agent.Inventar) > 0: # sell
        bought_price = agent.inventory.pop(0)
        Belohnung = max(Daten[T] - bought_price, 0)
        total_profit += Daten[T] - bought_price
        print("Verkaufen: " + formatPreis(Daten[T]) + " | Gewinn: " + formatPreis(Daten[T] - bought_price))
    done = True, wenn t == l - 1 else False
    agent.memory.append((Zustand, Aktion, Belohnung, next_state, fertig))
    state = next_state
    if done:
        drucken("--------------------------------")
        drucken(stock_name + " Gesamtgewinn: " + formatPreis(total_profit))
        drucken("--------------------------------")
        drucken ("Der Gesamtgewinn beträgt:",formatPreis(total_profit))
Abschließende Anmerkungen
Reinforcement Learning liefert positive Ergebnisse für Wertvorhersagen. Durch den Einsatz von Q-Lernen, verschiedene Experimente können durchgeführt werden. Mehr Forschung zum Reinforcement Learning wird es ermöglichen, Reinforcement Learning in einer sichereren Phase anzuwenden.
Sie können mit kommunizieren





