
Dieser Artikel wurde im Rahmen der Data Science Blogathon.
Einführung
wird verwendet, um zukünftige Werte basierend auf zuvor beobachteten Werten vorherzusagen und eines der besten Tools für Trendanalysen und Zukunftsprognosen.
Was sind Zeitreihendaten??
Es wird in regelmäßigen Zeitabständen aufgezeichnet und die Reihenfolge dieser Datenpunkte ist wichtig. Deswegen, Jedes Vorhersagemodell, das auf Zeitreihendaten basiert, hat die Zeit als VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... Unabhängig. Die Ausgabe eines Modells wäre der vorhergesagte Wert oder Rang zu einem bestimmten Zeitpunkt.
Zeitreihenanalyse vs. Zeitreihenprognose
Sprechen wir über mögliche Verwirrung bei der Zeitreihenanalyse und -prognose. Zeitreihenprognosen sind ein Beispiel für prädiktive Modellierung, während die Zeitreihenanalyse eine Form der deskriptiven Modellierung ist.
Für einen neuen Investor, die allgemeine Recherche im Zusammenhang mit der Börse oder dem Aktienmarkt reicht nicht aus, um die Entscheidung zu treffen. Der gemeinsame Trend zum Aktienmarkt in der Gesellschaft ist hoch riskant für Investitionen, daher können die meisten Menschen keine Entscheidungen basierend auf gemeinsamen Trends treffen. Die saisonale Variation und der konstante Fluss IndexDas "Index" Es ist ein grundlegendes Werkzeug in Büchern und Dokumenten, Dies ermöglicht es Ihnen, die gewünschten Informationen schnell zu finden. Allgemein, Sie wird am Anfang einer Arbeit präsentiert und organisiert die Inhalte hierarchisch, mit Kapiteln und Abschnitten. Die richtige Vorbereitung erleichtert die Navigation und verbessert das Verständnis des Materials, was es zu einer unverzichtbaren Ressource sowohl für Studenten als auch für Fachleute in verschiedenen Bereichen macht.... Sie werden neuen und bestehenden Anlegern helfen, die Entscheidung zu verstehen und zu treffen, in den Aktienmarkt zu investieren.
Um diese Art von Problemen zu lösen, Zeitreihenprognosen sind die beste Technik.
Börse
Aktienmärkte sind die Orte, an denen private und institutionelle Anleger zusammenkommen, um Aktien an einem öffentlichen Ort zu kaufen und zu verkaufen.. Heute, diese Börsen existieren als elektronische Marktplätze.
Dass Angebot und Nachfrage dazu beitragen, den Preis jedes Wertpapiers oder das Niveau zu bestimmen, auf dem die Teilnehmer am Aktienmarkt (Investoren und Händler) sind bereit zu kaufen oder zu verkaufen.
Das Konzept hinter der Funktionsweise der Börse ist recht einfach.. Funktioniert ähnlich wie ein Auktionshaus, die Börse ermöglicht es Käufern und Verkäufern, Preise zu verhandeln und Transaktionen durchzuführen.
Definición de ‚stock‘
Eine Aktion oder Aktion (auch bekannt als „Hauptstadt“ eines Unternehmens) ist ein Finanzinstrument, das das Eigentum an einem Unternehmen darstellt
Maschinelles Lernen an der Börse
Der Aktienmarkt ist sehr unberechenbar, jede geopolitische Veränderung kann die Entwicklung der Aktien an der Börse beeinflussen, Wir haben kürzlich gesehen, wie sich Covid-19 auf die Aktienkurse ausgewirkt hat, Daher ist es bei Finanzdaten sehr schwierig, eine zuverlässige Trendanalyse durchzuführen. . Der effizienteste Weg, diese Art von Problemen zu lösen, ist mit Hilfe von maschinellem Lernen und tiefes LernenTiefes Lernen, Eine Teildisziplin der Künstlichen Intelligenz, verlässt sich auf künstliche neuronale Netze, um große Datenmengen zu analysieren und zu verarbeiten. Diese Technik ermöglicht es Maschinen, Muster zu lernen und komplexe Aufgaben auszuführen, wie Spracherkennung und Computer Vision. Seine Fähigkeit, sich kontinuierlich zu verbessern, wenn mehr Daten zur Verfügung gestellt werden, macht es zu einem wichtigen Werkzeug in verschiedenen Branchen, von Gesundheit....
In diesem Tutorial, Wir werden dieses Problem mit dem ARIMA-Modell lösen.
Um die Saisonalität zu kennen, Check meinen vorherigen Blog. Und um ein grundlegendes Verständnis von ARIMA zu bekommen, Ich würde dir empfehlen diesen Blog zu lesen, Dies wird Ihnen helfen, besser zu verstehen, wie die Zeitreihenanalyse funktioniert.
Implementieren Sie die Aktienkursprognose
ich werde benützen nsep Bibliothek zum Extrahieren historischer Daten aus SBIN.
Importe
Importieren von OS
Importwarnungen
Warnungen.Filterwarnungen('ignorieren')
aus pylab importieren rcParams
rcParams['figure.figsize'] = 10, 6
von statsmodels.tsa.stattools import adfuller
von statsmodels.tsa.seasonal import season_decompose
von statsmodels.tsa.arima_model import ARIMA
von pmdarima.arima importieren auto_arima
aus sklearn.metrics import mean_squared_error, mittlerer_absoluter_Fehler
Mathematik importieren
numpy als np importieren
aus nsepy import get_history
ab DatumZeit Importdatum
import matplotlib.pyplot als plt
Seegeboren als sns importieren
Pandas als pd importieren
Führen Sie den folgenden Code aus, um die historischen Daten zu extrahieren:
sbin = get_history(Symbol="SBIN",
                   Start=Datum(2000,1,1),
                   Ende=Datum(2020,11,1))
sbin.kopf()
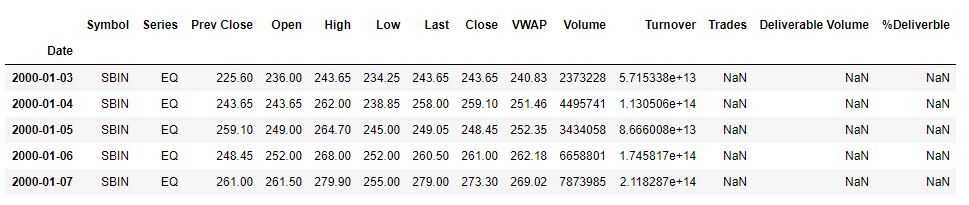
Die Daten zeigen den Aktienkurs von SBIN von 2020-1-1 zu 2020-11-1. Das Ziel ist es, ein Modell zu erstellen, das Vorhersagen macht
der Schlusskurs der Aktie.
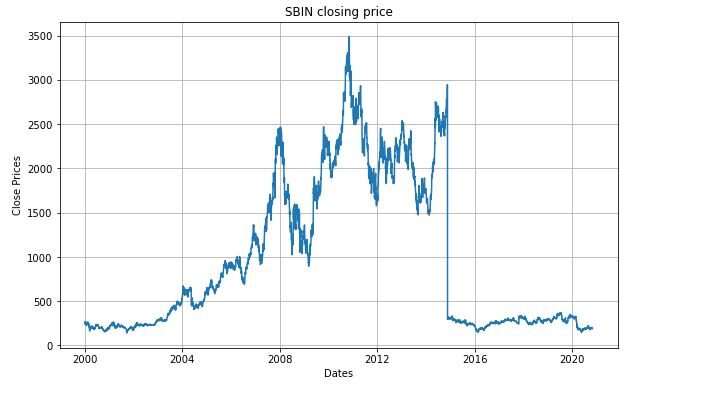
Lassen Sie uns eine Visualisierung erstellen, die den täglichen Schlusskurs der Aktie anzeigt.
plt.figur(Feigengröße=(10,6))
plt.grid(Wahr)
plt.xlabel('Dates')
plt.ylabel('Close Prices')
plt.plot(sbin['Close'])
plt.titel('SBIN closing price')
plt.zeigen()
plt.figur(Feigengröße=(10,6))
df_close = sbin['Close']
df_close.plot(Stil="k.")
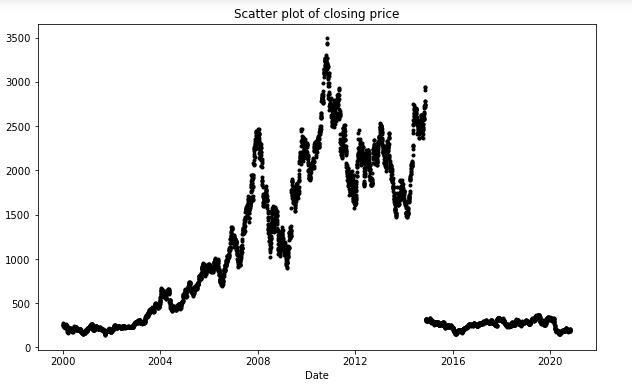
plt.titel('StreudiagrammEin Streudiagramm ist eine grafische Darstellung, die die Beziehung zwischen zwei Variablen zeigt. Jeder Punkt im Diagramm entspricht einem Wertepaar, die es ermöglicht, Muster zu erkennen, Trends oder Korrelationen. Dieses Tool ist in verschiedenen Disziplinen nützlich, wie Statistik und wissenschaftliche Forschung, Da es die visuelle Analyse von Daten und das Verständnis der Beziehung zwischen den untersuchten Elementen erleichtert.... des Schlusskurses")
plt.zeigen()
plt.figur(Feigengröße=(10,6))
df_close = sbin['Close']
df_close.plot(Stil="k.",kind='hist')
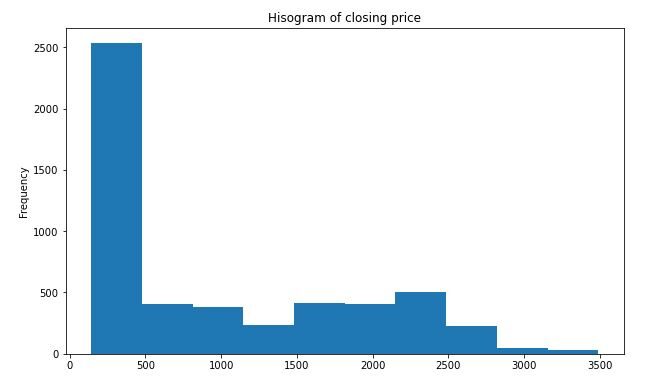
plt.titel('Hisogram of closing price')
plt.zeigen()
Zuerst, Wir müssen prüfen, ob eine Reihe stationär ist oder nicht, da die Zeitreihenanalyse nur mit stationären Daten funktioniert.
Test der Stationarität:
Um die Art der Daten zu identifizieren, wir werden die benutzen NullhypotheseDie Nullhypothese ist ein grundlegendes Konzept in der Statistik, das eine anfängliche Aussage über einen Populationsparameter festlegt. Sein Zweck ist es,, falls widerlegt, ermöglicht es uns, die Alternativhypothese zu akzeptieren. Dieser Ansatz ist für die wissenschaftliche Forschung unerlässlich, da sie einen Rahmen für die Bewertung empirischer Evidenz und das Treffen datengestützter Entscheidungen bietet. Seine Formulierung und Analyse sind für statistische Studien von entscheidender Bedeutung.....
H0: Die Nullhypothese: Es handelt sich um eine Aussage über die Bevölkerung, die für wahr gehalten oder zur Argumentation verwendet wird, es sei denn, sie kann zweifelsfrei als falsch nachgewiesen werden.
H1: Die Alternativhypothese: Es ist eine Aussage über die Bevölkerung, die widersprüchlich ist h0 und was wir schließen, wenn wir ablehnen h0.
#Ho: es ist nicht stationär
# H1: ist gestoppt
Wenn wir die Nullhypothese nicht verwerfen, wir können sagen, dass die Reihe nicht stationär ist. Dies bedeutet, dass die Reihe linear sein kann.
Wenn sowohl die Standardabweichung als auch der Mittelwert flache Linien sind (konstanter Mittelwert und konstante Varianz), die Reihe wird stationär.
von statsmodels.tsa.stattools import adfuller
def test_stationarity(Zeitfolgen):
    #Rolling-Statistiken ermitteln
    rolmean = timeseries.rolling(12).bedeuten()
    rolstd = timeseries.rolling(12).std()
    #Rolling-Statistiken darstellen:
    plt.plot(Zeitfolgen, Farbe="Gelb",Etikett="Original")
    plt.plot(rolmean, Farbe="rot", Etikett="Rollendes Mittel")
    plt.plot(rolstd, Farbe="Schwarz", Etikett="Rolling Std")
    plt.legende(loc ="Beste")
    plt.titel('Rolling Mean and Standard Deviation')
    plt.zeigen(block=Falsch)
    drucken("Ergebnisse des Dickey-Fuller-Tests")
    adft = adfuller(Zeitfolgen,autolag='AIC')
    # Die Ausgabe für dft wird uns liefern, ohne die Werte zu definieren.
    #Daher schreiben wir manuell, welche Werte es mit einer for-Schleife erklärt
    Ausgang = pd.Serie(adft[0:4],index=['Test Statistics','p-Wert','Nein. of lags used','Number of observations used'])
    für Schlüssel,werte in adft[4].Produkte():
        Ausgang['critical value (%S)'%key] = Werte
    drucken(Ausgang)

test_stationarität(sbin['Close'])
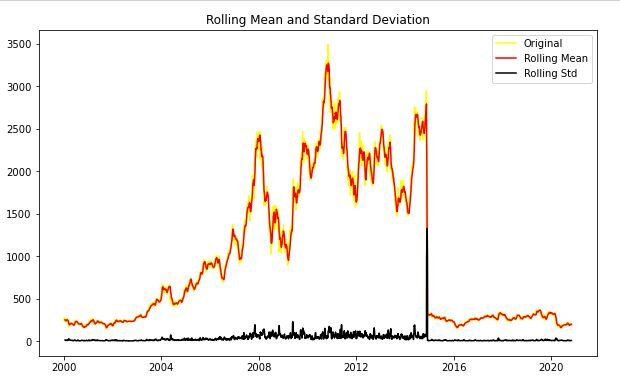
Nach der Analyse der obigen Grafik, Wir können den zunehmenden Mittelwert und die Standardabweichung sehen und daher ist unsere Reihe nicht stationär.
Ergebnisse des Dickey-Fuller-Tests
Teststatistik                  -1.914523
p-Wert                           0.325260
Nein. von Lags verwendet                  3.000000
Anzahl der verwendeten Beobachtungen    5183.000000
kritischer Wert (1%)              -3.431612
kritischer Wert (5%)              -2.862098
kritischer Wert (10%)             -2.567067
dtyp: float64
Wir sehen, dass der p-Wert größer ist als 0.05 also können wir das nicht ablehnen Nullhypothese. Was ist mehr, Teststatistiken sind größer als kritische Werte. die Daten sind also nicht stationär.
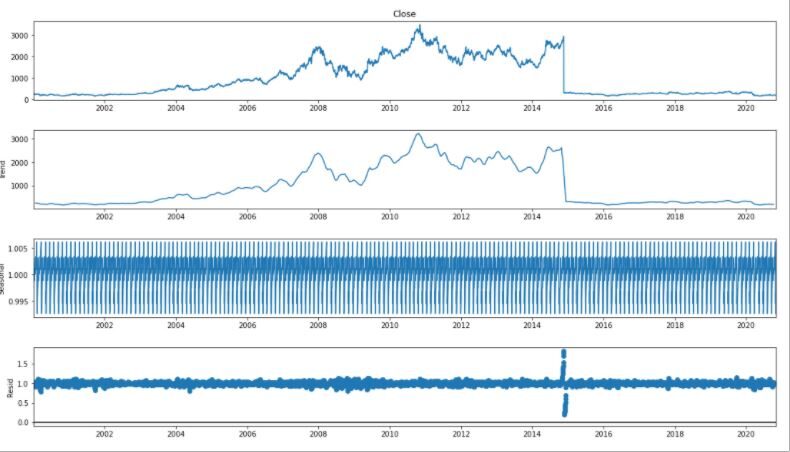
Zur Zeitreihenanalyse, Wir trennen Trend und Saisonalität von den Zeitreihen.
result = saisonal_decompose(df_close, Modell="multiplikativ", Frequenz = 30)
fig = plt.figur()
fig = result.plot()
fig.set_size_inches(16, 9)
aus pylab importieren rcParams
rcParams['figure.figsize'] = 10, 6
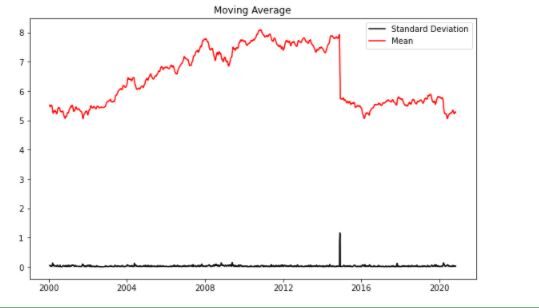
df_log = np.log(sbin['Close'])
Moving_avg = df_log.rolling(12).bedeuten()
std_dev = df_log.rolling(12).std()
plt.legende(loc ="Beste")
plt.titel('Moving Average')
plt.plot(std_dev, Farbe ="Schwarz", Etikett = "Standardabweichung")
plt.plot(Moving_avg, Farbe="rot", Etikett = "Bedeuten")
plt.legende()
plt.zeigen()
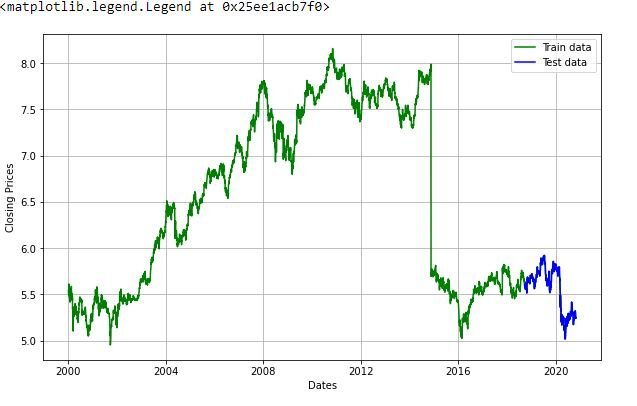
Jetzt erstellen wir ein ARIMA-Modell und trainieren es mit dem Schlusskurs der Aktie in den Zugdaten. Lassen Sie uns also die Daten aufschlüsseln in AusbildungTraining ist ein systematischer Prozess zur Verbesserung der Fähigkeiten, körperliche Kenntnisse oder Fähigkeiten. Es wird in verschiedenen Bereichen angewendet, wie Sport, Aus- und Weiterbildung. Zu einem effektiven Trainingsprogramm gehört auch die Zielplanung, Regelmäßiges Üben und Bewerten der Fortschritte. Anpassung an individuelle Bedürfnisse und Motivation sind Schlüsselfaktoren, um in jeder Disziplin erfolgreiche und nachhaltige Ergebnisse zu erzielen.... und testen, einstellen und visualisieren.
train_data, test_data = df_log[3:int(len(df_log)*0.9)], df_log[int(len(df_log)*0.9):]
plt.figur(Feigengröße=(10,6))
plt.grid(Wahr)
plt.xlabel('Dates')
plt.ylabel('Closing Prices')
plt.plot(df_log, 'green', Etikett="Zugdaten")
plt.plot(Testdaten, 'blue', Etikett="Testdaten")
plt.legende()
model_autoARIMA = auto_arima(train_data, start_p=0, start_q=0,
test="adf",       # use adftest to find optimal 'd'
max_p=3, max_q=3, # maximal p und q
m=1,              # Häufigkeit der Serie
d=Keine,           # let model determine 'd'
saisonal=Falsch,   # Keine Saisonalität
start_P=0,
D=0,
trace=Wahr,
error_action='ignorieren',
suppress_warnings=Wahr,
schrittweise=Wahr)
drucken(model_autoARIMA.summary())
Durchführen einer schrittweisen Suche zum Minimieren von aic
 ARIMA(0,1,0)(0,0,0)[0] abfangen   : AIC=-16607.561, Zeit=2,19 Sek.
 ARIMA(1,1,0)(0,0,0)[0] abfangen   : AIC=-16607.961, Zeit = 0,95 Sek.
 ARIMA(0,1,1)(0,0,0)[0] abfangen   : AIC=-16608.035, Zeit=2,27 Sek.
 ARIMA(0,1,0)(0,0,0)[0]             : AIC=-16609.560, Zeit=0,39 Sek.
 ARIMA(1,1,1)(0,0,0)[0] abfangen   : AIC=-16606.477, Zeit=2,77 Sek.

Bestes Modell:  ARIMA(0,1,0)(0,0,0)[0]
Gesamtanpassungszeit: 9.079 Sekunden
                               SARIMAX-Ergebnisse
================================================ ============================
Ab. Variable:                      und nein. Beobachtungen:                 4665
Modell:               SARIMAX(0, 1, 0)   Log-Wahrscheinlichkeit                8305.780
Datum:                Di, 24 November 2020   AIC                         -16609.560
Zeit:                        20:08:50   BIC                         -16603.113
Stichprobe:                             0   HQIC                        -16607.293
                               - 4665
Kovarianztyp:                  opg
================================================ ============================
                 coef std err z P>|Mit|      [0.025      0.975]
------------------------------------------------------------------------------
sigma2         0.0017   1.06e-06   1566.660      0.000       0.002       0.002
============================================= === =============================
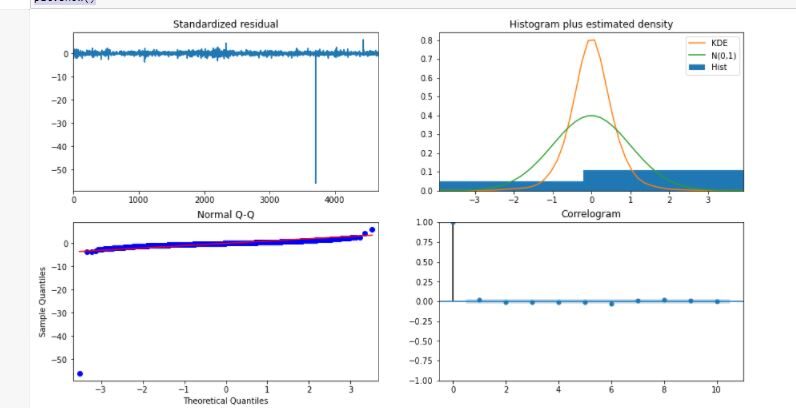
Ljung-Box (Q):                       24.41   Jarque-Bera (JB):         859838819.58
Prob(Q):                              0.98   Prob(JB):                         0.00
Heteroskedastizität (h):               7.16   Schiefe:                           -37.54
Prob(h) (zweiseitig):                  0.00   Kurtosis:                      2105.12
================================================ =================================
model_autoARIMA.plot_diagnostics(Feigengröße=(15,8))
plt.zeigen()
Modell = ARIMA(train_data, bestellen=(3, 1, 2))
ausgestattet = model.fit(disp = -1)
drucken(montiert.Zusammenfassung())
                             Ergebnisse des ARIMA-Modells
================================================ ============================
Ab. Variable:                D.Schließen Nein. Beobachtungen:                 4664
Modell:                 ARIMA(3, 1, 2)   Log-Wahrscheinlichkeit                8309.178
Methode:                       css-ml S.D.. von Innovationen              0.041
Datum:                Di, 24 November 2020   AIC                         -16604.355
Zeit:                        20:09:37   BIC                         -16559.222
Stichprobe:                             1   HQIC                        -16588.481

================================================ ===============================
                    coef std err z P>|Mit|      [0.025      0.975]
---------------------------------------------------------------------------------
Konstante 8.761e-06      0.001      0.015      0.988      -0.001       0.001
ar.L1.D.Schließen     1.3689      0.251      5.460      0.000       0.877       1.860
ar.L2.D.Schließen    -0.7118      0.277     -2.567      0.010      -1.255      -0.168
ar.L3.D.Schließen     0.0094      0.021      0.445      0.657      -0.032       0.051
ma.L1.D.Schließen    -1.3468      0.250     -5.382      0.000      -1.837      -0.856
ma.L2.D.Schließen     0.6738      0.282      2.391      0.017       0.122       1.226
                                    Wurzeln
================================================ ===========================
                  Reale imaginäre Modulfrequenz
-----------------------------------------------------------------------------
AR.1            0.9772           -0.6979J            1.2008           -0.0987
AR.2            0.9772           +0.6979J            1.2008            0.0987
AR.3           74.0622           -0.0000J           74.0622           -0.0000
MA.1            0.9994           -0.6966J            1.2183           -0.0969
MA.2            0.9994           +0.6966J            1.2183            0.0969
-----------------------------------------------------------------------------
# Vorhersage

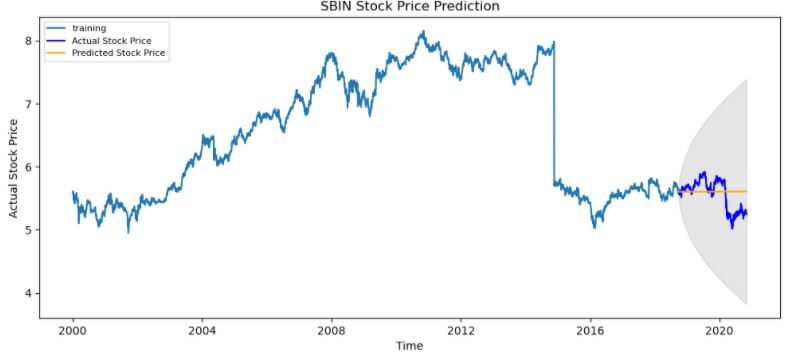
fc, Ich kenne, conf = angepasst.Vorhersage(519, Alpha=0,05)  # 95% Vertrauen
fc_series = pd.Series(fc, index=test_data.index)
lower_series = pd.Series(conf[:, 0], index=test_data.index)
upper_series = pd.Series(conf[:, 1], index=test_data.index)
plt.figur(Feigengröße=(12,5), dpi=100)
plt.plot(train_data, Etikett="Ausbildung")
plt.plot(Testdaten, Farbe="Blau", Etikett="Aktueller Aktienkurs")
plt.plot(fc_series, Farbe="Orange",Etikett="Vorhergesagter Aktienkurs")
plt.fill_between(lower_series.index, untere_serie, obere_serie,
                 Farbe="k", alpha=.10)
plt.titel('SBIN Stock Price Prediction')
plt.xlabel(Uhrzeit)
plt.ylabel('Actual Stock Price')
plt.legende(loc ="Oben links", Schriftgröße=8)
plt.zeigen()
Fazit
Zeitreihenprognosen sind sehr nützlich, wenn wir zukünftige Entscheidungen treffen oder Analysen durchführen müssen, Wir können es schnell mit ARIMA . machen, Es gibt viele andere Modelle, mit denen wir Zeitreihenprognosen durchführen können, aber ARIMA ist wirklich leicht zu verstehen.
Ich hoffe, dieser Artikel hilft Ihnen und spart Ihnen viel Zeit. Lassen Sie es mich wissen, wenn Sie Vorschläge haben..
GLÜCKLICHES CODIEREN.
Prabhat Pathak (LinkedIn Profil) ist Senior Analyst und Innovationsenthusiast.





