
Einführung
ist ein wichtiger Bestandteil, sowie einer der am meisten unterschätzten Schritte in jedem Data-Science-Projekt. EDA ist für eine gut definierte und strukturierte Datenanalyse unerlässlich und sollte vor der Modellierungsphase des maschinellen Lernens durchgeführt werden.
Es geht darum, nach sorgfältiger Beobachtung Ideen aus den Daten zu finden und ihre Hauptmerkmale weiter zusammenzufassen.. Allgemein, die realen Daten, mit denen wir arbeiten, enthalten viel „Lärm“ Ja, Daher, Die manuelle Datenanalyse solcher Datensätze wird zu einem komplizierten und mühsamen Prozess.
Einführung in Python-Tutorial: wissenschaftliche Berechnung mit Pandas | von Datenanalyse-Enthusiasten | Halb
Felshaken ist eine der am häufigsten verwendeten Sprachen für Datenwissenschaft insbesondere aufgrund des Vorhandenseins verschiedener Bibliotheken und Pakete, die die Datenanalyse erleichtern.
Bzw, Pandas ist eine der beliebtesten Python-Bibliotheken, die dabei hilft, Daten auf eine für die Analyse geeignete Weise darzustellen Serie Ja Datenrahmen Datenstrukturen. Bietet verschiedene Funktionen und Methoden zur Vereinfachung und Beschleunigung des Datenanalyseprozesses.
Hier verwenden wir den Datensatz "TITANIC", um die praktische Umsetzung aller Funktionen durchzuführen.
Zuerst, wir importieren die Numpy- und Pandas-Bibliothek und lesen dann den Datensatz.

Jetzt fangen wir an
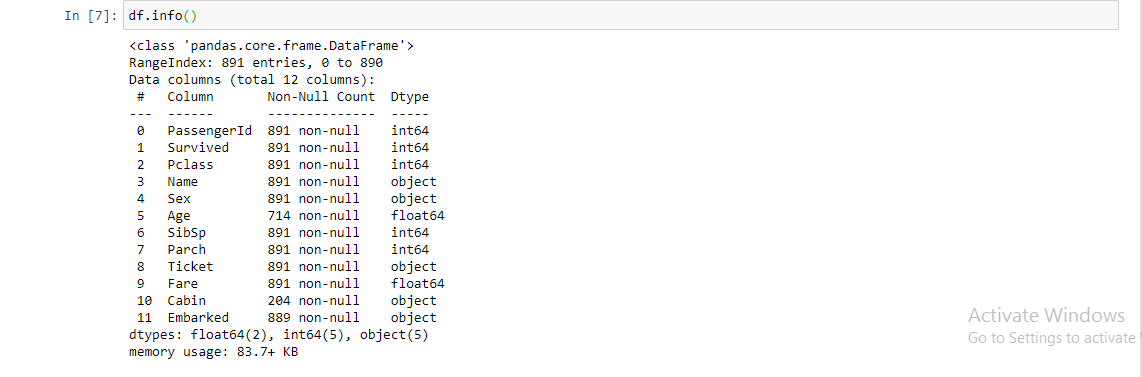
1. df.kopf (): Standardmäßig, gibt die erste zurück 5 Datenrahmenzeilen. So ändern Sie den Standardwert, Sie können einen Wert in Klammern einfügen, um die Anzahl der zurückgegebenen Zeilen zu ändern.
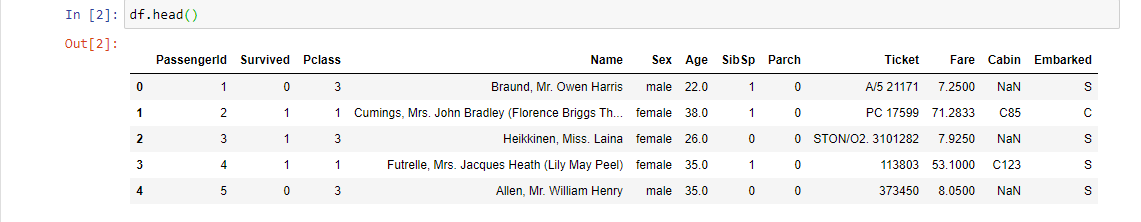
2. df.tail (): Standardmäßig, gibt das letzte zurück 5 Datenrahmenzeilen. Diese Funktion wird verwendet, um die letzten n Zeilen zu erhalten. Diese Funktion gibt die letzten n Zeilen des Objekts basierend auf Position zurück.
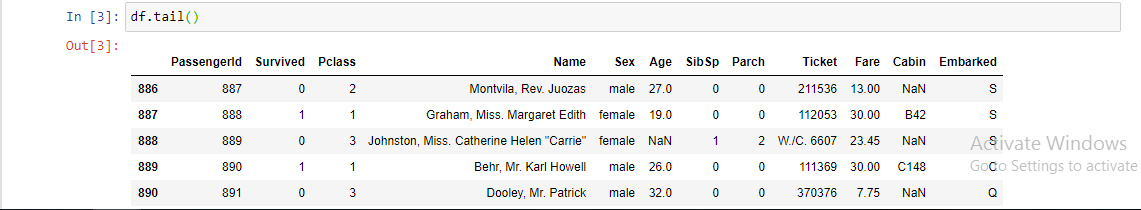
3. df.info (): Hilft, sich einen schnellen Überblick über den Datensatz zu verschaffen. Diese Funktion wird verwendet, um eine kurze Zusammenfassung des Datenrahmens zu erhalten. Diese Methode druckt Informationen über einen DataFrame, einschließlich der Art der IndexDas "Index" Es ist ein grundlegendes Werkzeug in Büchern und Dokumenten, Dies ermöglicht es Ihnen, die gewünschten Informationen schnell zu finden. Allgemein, Sie wird am Anfang einer Arbeit präsentiert und organisiert die Inhalte hierarchisch, mit Kapiteln und Abschnitten. Die richtige Vorbereitung erleichtert die Navigation und verbessert das Verständnis des Materials, was es zu einer unverzichtbaren Ressource sowohl für Studenten als auch für Fachleute in verschiedenen Bereichen macht.... und Spaltentypen, Nicht-Null-Werte und Speichernutzung.
4. df. Form: Zeigt die Anzahl der Dimensionen sowie die Größe in jeder Dimension an Abmessungen"Dimension" Es handelt sich um einen Begriff, der in verschiedenen Disziplinen verwendet wird, wie z.B. Physik, Mathematik und Philosophie. Er bezieht sich auf das Ausmaß, in dem ein Objekt oder Phänomen analysiert oder beschrieben werden kann. In der Physik, zum Beispiel, Es ist die Rede von räumlichen und zeitlichen Dimensionen, während es sich in der Mathematik auf die Anzahl der Koordinaten beziehen kann, die notwendig sind, um einen Raum darzustellen. Es zu verstehen, ist grundlegend für das Studium und.... Da die Datenrahmen zweidimensional sind, die zurückgegebene Form ist die Anzahl der Zeilen und Spalten.

5. df. Größe: Gibt ein Int zurück, das die Anzahl der Elemente in diesem Objekt darstellt. Gibt die Anzahl der Zeilen zurück, wenn es sich um Series . handelt; Andernfalls, gibt die Anzahl der Zeilen multipliziert mit der Anzahl der Spalten zurück, wenn es sich um einen DataFrame handelt.

6. df.ndim: Gibt die Dimension des Rahmens zurück / Datenreihen. 1 für eine Dimension (Serie), 2 für zwei Dimensionen (Datenrahmen).

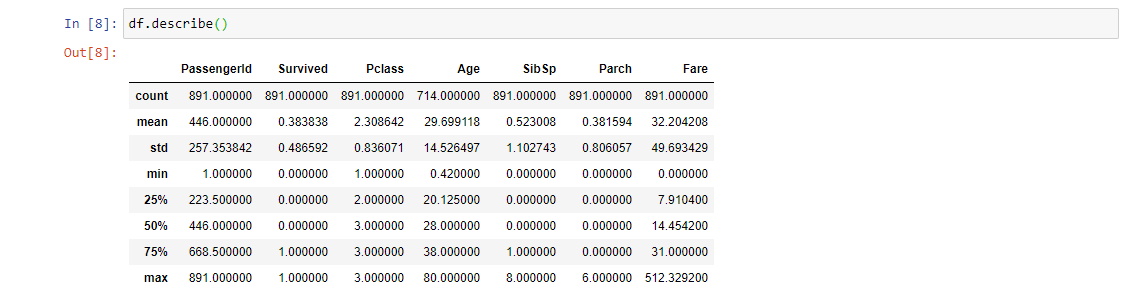
7. df.describe (): Gibt eine statistische Zusammenfassung der im Datensatz vorhandenen numerischen Spalten zurück. Diese Methode berechnet einige statistische Maße wie das Perzentil, der Mittelwert und die Standardabweichung der numerischen Werte der Serie oder des DataFrame.
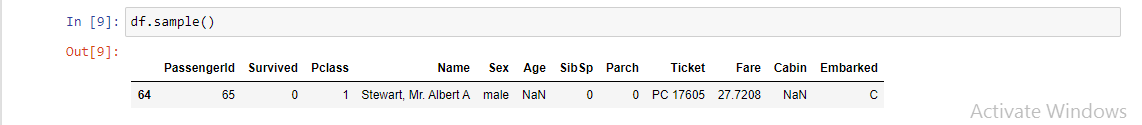
8. df.probe (): Wird verwendet, um nach dem Zufallsprinzip in einer Reihe oder in einer Spalte zu proben. Ermöglicht die zufällige Auswahl von Werten aus einer Reihe oder einem DataFrame. Es ist nützlich, wenn wir eine Zufallsstichprobe aus einer Verteilung auswählen möchten.
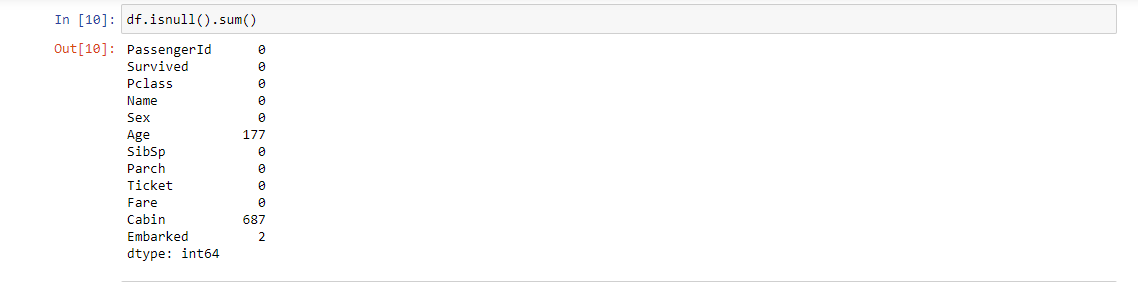
9. df.isnull () .Summe (): Gibt die Anzahl der fehlenden Werte in jeder Spalte zurück.
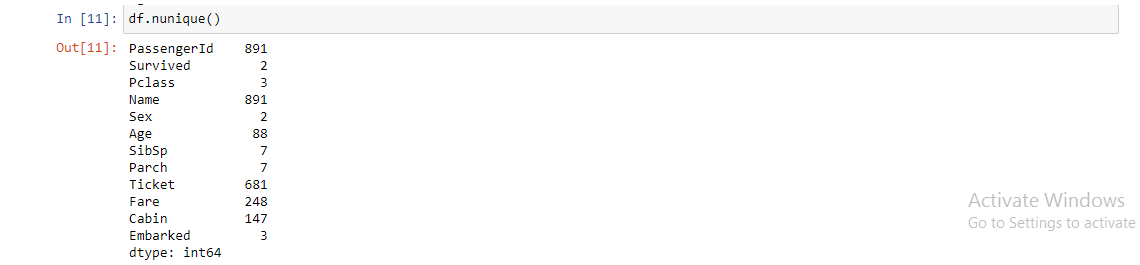
10. df.nunique (): Gibt die Anzahl der eindeutigen Elemente im Objekt zurück. Zählt die Anzahl der eindeutigen Einträge in Spalten oder Zeilen. Es ist sehr nützlich bei kategorialen Merkmalen, insbesondere in Fällen, in denen wir die Anzahl der Kategorien nicht im Voraus kennen.
11. df.index: Diese Funktion sucht nach einem bestimmten Element am Anfang der Liste und gibt den niedrigsten Index zurück, an dem das Element vorkommt.

12. df-Spalten .: Gibt die Spaltenbeschriftungen des Datenrahmens zurück.

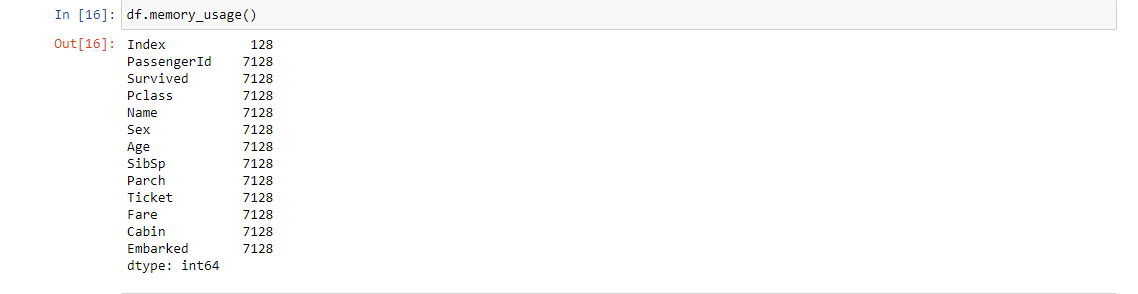
13. df.memory_usage (): Gibt zurück, wie viel Speicher jede Spalte in Byte verwendet. Es ist besonders nützlich, wenn Sie mit großen Datenrahmen arbeiten.
14. df.dropna (): Diese Funktion wird verwendet, um eine Zeile oder Spalte aus einem Datenrahmen zu entfernen, in dem NaN oder Werte fehlen.

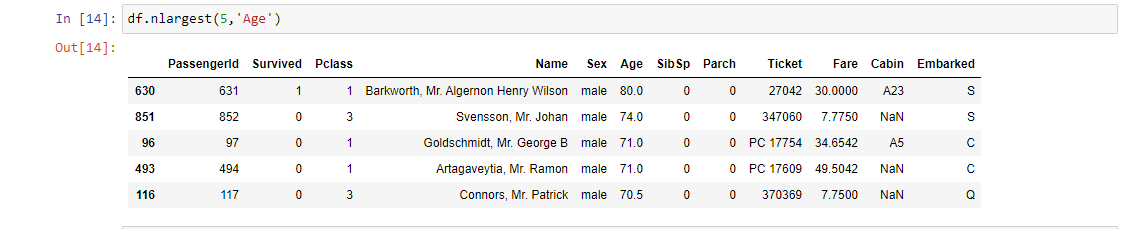
15. df.nlargest (): Gibt das erste zurück Norden Reihen geordnet nach Säulen in absteigender Reihenfolge.
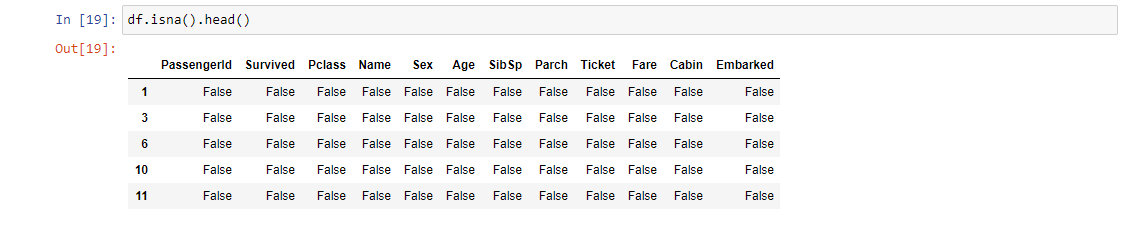
16. df.isna (): Diese Funktion gibt einen mit booleschen Werten gefüllten Datenrahmen zurück, wobei true fehlende Werte anzeigt.
17. df.dupliziert (): Gibt einen booleschen String zurück, der doppelte Zeilen angibt.

18. value_counts (): Diese Funktion wird verwendet, um eine Reihe zu erhalten, die Zählungen von eindeutigen Werten enthält. Das resultierende Objekt wird in absteigender Reihenfolge angezeigt, sodass das erste Element das Element ist, das am häufigsten vorkommt. Fehlende Werte standardmäßig ausschließen. Diese Funktion ist nützlich, wenn wir das Problem des Klassenungleichgewichts auf eine VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... Kategorisch.

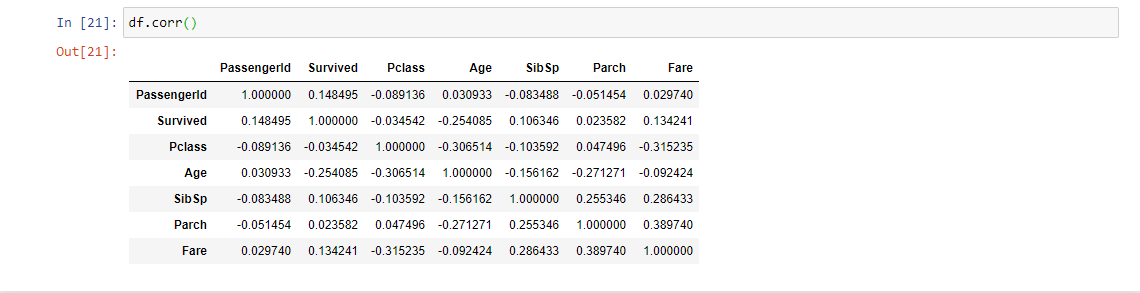
19. df.korr (): Diese Funktion wird verwendet, um die paarweise Korrelation aller Spalten im Datenrahmen zu finden. Fehlende Werte werden automatisch ausgeschlossen. Für jede Spalte mit nicht numerischem Datentyp im Datenrahmen, es wird ignoriert. Diese Funktion ist bei der Merkmalsauswahl nützlich, indem man die Korrelation zwischen den Merkmalen und der Zielvariablen oder zwischen den Variablen betrachtet.
20. Arten von df.d: Diese Funktion zeigt den Datentyp jeder Spalte an.
Abschließende Anmerkungen
Danke fürs Lesen!
Wenn dir das gefallen hat und du mehr wissen möchtest, Besuchen Sie meine anderen Artikel zu Data Science und Machine Learning, indem Sie auf den Link klicken
Kontaktieren Sie mich gerne unter Linkedin, Email.
Alles was nicht erwähnt wurde oder du deine Gedanken teilen möchtest? Fühlen Sie sich frei, unten einen Kommentar zu hinterlassen und ich melde mich bei Ihnen.
Bis dann, zu Hause bleiben, Bleiben Sie sicher, um die Ausbreitung von zu verhindern COVID-19, Und lerne weiter!
Über den Autor
Chirag Goyal
Heutzutage, Ich studiere meinen Bachelor of Technology (B.Tech) in Informatik und Ingenieurwissenschaften von Indisches Technologieinstitut Jodhpur (IITJ). Ich freue mich sehr über maschinelles Lernen, das tiefes LernenTiefes Lernen, Eine Teildisziplin der Künstlichen Intelligenz, verlässt sich auf künstliche neuronale Netze, um große Datenmengen zu analysieren und zu verarbeiten. Diese Technik ermöglicht es Maschinen, Muster zu lernen und komplexe Aufgaben auszuführen, wie Spracherkennung und Computer Vision. Seine Fähigkeit, sich kontinuierlich zu verbessern, wenn mehr Daten zur Verfügung gestellt werden, macht es zu einem wichtigen Werkzeug in verschiedenen Branchen, von Gesundheit... und Künstliche Intelligenz.
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





