
Überblick
- Open-Source-Data-Science-Projekte werten Ihren Lebenslauf auf und helfen Ihnen, sich in einem Vorstellungsgespräch abzuheben
- Hier gibt es 7 Open-Source-Data-Science-Projekte, an denen Sie diesen Monat arbeiten sollten
Einführung
Ich werde Ihnen einige Ratschläge geben, von denen ich wünschte, dass sie mir jemand gegeben hätte, als ich meine Karriere in der Datenwissenschaft begann.. Als ich die mit Hindernissen gefüllte Reise durch die Backwaters der Data Science bewältigte, Ich hatte einen großen Kampf, bevor ich meine erste Rolle bekam.. Hatte alle Qualifikationen (oder so dachte ich) aber irgendwas schien nicht zu stimmen.
Diese Kluft zwischen dem, was ich an den Tisch brachte, und dem, was der Interviewer erwartete, war Erfahrung in Data-Science-Projekten..
Data-Science-Projekte werten Ihren Lebenslauf sehr auf, besonders wenn du ein anfänger bist. Die meisten Neuankömmlinge haben Zertifizierungen, Aber das Hinzufügen von Open-Source-Data-Science-Projekten verschafft Ihnen einen erheblichen Vorteil gegenüber der Konkurrenz. Und glaub mir, es gibt eine überwältigende Anzahl von Open Source Data Science-Projekten für Sie.

Hier, Ich habe eine Liste der besten Open-Source-Data-Science-Projekte zusammengestellt, die im Juni erstellt oder gestartet wurden. Dies ist Teil meiner monatlichen Projektreihe, in der ich die besten Open-Source-Data-Science-Projekte auf GitHub vorstelle.
Wenn Sie die vorherigen Projekte sehen möchten, Ich habe sie gesammelt in Form von kostenloser Kurs. Sie sind nach Domänen strukturiert (Computer Vision Projekte, NLP-Projekte, etc.) damit Sie sich auf das gewünschte Projekt konzentrieren können. Und wenn Sie neu bei GitHub sind, stellen Sie sicher, dass Sie in diesem eingeschrieben sind kostenloser Einführungskurs in Git und GitHub.
Open Source Data Science-Projekte zur Verbesserung Ihres Lebenslaufs

Ich habe die Projekte nach ihrer Domäne in drei Kategorien eingeteilt:
- Maschinelles Lernen
- Computer Vision
- Andere Open-Source-Data-Science-Projekte, inklusive beeindruckendem Datensatz
Schauen wir uns jede Kategorie einzeln an.
Open-Source-Projekte für maschinelles Lernen
Hier erhalten Sie das Terrain für maschinelles Lernen.. Hier werden wir drei nützliche Open-Source-Projekte im Zusammenhang mit maschinellem Lernen behandeln.. Sie können ein Projekt nach Ihren Interessen auswählen oder alle ausprobieren. Ich habe versucht, sie so vielfältig wie möglich zu halten, damit Sie ein Projekt zu Machine-Learning-Dokumenten und ein weiteres zum Erstellen von Machine-Learning-Pipelines sehen können.
Wenn Sie nach Orientierung suchen oder neu in diesem Bereich sind, Ich werde Sie auf einige hilfreiche Lernressourcen verweisen:
Das Lesen von Forschungsartikeln über maschinelles Lernen ist für die meisten Fachleute eine überwältigende Aussicht., viel weniger für Anfänger. Data Scientists und Machine Learning-Forscher neigen dazu, extrem technische Artikel zu schreiben, die selbst Experten nur schwer entschlüsseln können.. In Wirklichkeit, das ist eine der größten schwachstellen in unserem bereich.
Deswegen, Jeder Versuch, die Komplexität zu durchbrechen, ist immer willkommen. Dieses nützliche Projekt ist eine Sammlung von Artikeln über Data Science und maschinelles Lernen „mit Illustrationen, Anmerkungen und kurze Erläuterungen zu technischen Schlüsselwörtern, Begriffe und frühere Studien, die das Lesen des Artikels und der Hauptidee erleichtern“.
Dieses Projekt war letzte Woche Open Source auf GitHub, daher wird es regelmäßig aktualisiert. Im Augenblick, Wir können dort bereits einige Artikel sehen, damit Sie sie überprüfen und sich ein Bild davon machen können, wie die Anmerkungen gemacht wurden. Ich liebe besonders die YOLOv1-Anmerkung:

Sehr cool! Machen Sie weiter und erkunden Sie dieses und die anderen Dokumente. Es gibt viel zu lernen!
Dies ist ein ziemlich interessantes Projekt für alle, die ein wenig Kenntnisse in Data Science haben.

NeoML ist ein umfassendes Framework für maschinelles Lernen, mit dem wir erstellen können, Modelle für maschinelles Lernen trainieren und implementieren. Zusammenfassend, Wir können eine End-to-End-Pipeline für maschinelles Lernen erstellen, ohne viel Geld für gebrauchsfertige Lösungen ausgeben zu müssen.
Data Scientists und Data Engineers können es für Computer Vision und die Verarbeitung natürlicher Sprache verwenden (NLP), als Bildvorverarbeitung, Einstufung, Analyse des Dokumentendesigns, OCR und Datenextraktion aus strukturierten und unstrukturierten Dokumenten.
Hier ist die wichtigste NeoML-Funktion, die ich aus ihrem GitHub-Repository übernommen habe:
- Neuronale Netze kompatibel mit mehr als 100 Arten von Schichten
- Traditionelles maschinelles Lernen: mehr von 20 Algorithmen (Einstufung, Rückschritt, Clusterbildung, etc.)
- CPU- und GPU-Unterstützung, schnelle Schlussfolgerung
- ONNX-Unterstützung
- Sprachen: C ++, Java, Ziel c
- Multiplattform: derselbe Code kann unter Windows ausgeführt werden, Linux, Mac OS, iOS und Android
Hier ist ein Artikel für Anfänger zum Erstellen von Pipelines für maschinelles Lernen:
Hier ist ein weiteres Projekt, das jedem Datenwissenschaftler gefallen würde, vor allem, wenn Sie zur Forschung neigen. Wir haben oft Schwierigkeiten, von einer Testumgebung zu einer vollständigen Bereitstellung zu wechseln; Es ist kein einfacher Schritt (Wir sollten die Rolle der Dateningenieure wirklich schätzen).
Google, Natürlich, hat eine mögliche Lösung für uns in Form von Caliban. Dies ist ein Tool, mit dem Sie Ihre numerischen Experimente in einer isolierten und reproduzierbaren Computerumgebung starten und verfolgen können.. Caliban wurde von Forschern und Ingenieuren für maschinelles Lernen bei Google entwickelt.

Wie sie sagen, Caliban "erleichtert den Übergang von einem einfachen Prototyp, der auf einer Workstation ausgeführt wird, zu Tausenden von experimentellen Jobs, die in der Cloud ausgeführt werden". Das sind die Highlights, die Sie beachten sollten:
- Entwickeln Sie Ihren experimentellen Code lokal und testen Sie ihn in einer isolierten Umgebung (Docker)
- Desplácese fácilmente sobre los ParameterDas "Parameter" sind Variablen oder Kriterien, die zur Definition von, ein Phänomen oder System zu messen oder zu bewerten. In verschiedenen Bereichen wie z.B. Statistik, Informatik und naturwissenschaftliche Forschung, Parameter sind entscheidend für die Etablierung von Normen und Standards, die die Datenanalyse und -interpretation leiten. Ihre richtige Auswahl und Handhabung sind entscheidend, um genaue und relevante Ergebnisse in jeder Studie oder jedem Projekt zu erhalten.... Experimental-
- Senden Sie Ihre Experimente als Cloud-Jobs, wo sie in derselben Sandbox laufen
- Aufträge steuern und verfolgen
Open-Source-Projekte für maschinelles Sehen
Ich bin beeindruckt von den Fortschritten, die wir in der Computer Vision sehen (Kein Wortspiel beabsichtigt!). Es scheint wie jeden Monat, wenn ich mich hinsetze um diesen Artikel zu schreiben, Ich stoße auf immer mehr innovative Frameworks und neue Ansätze, die den Stand der Technik in diesem Bereich verbessern.
Unternehmen durchsuchen derzeit die Welt nach Talenten für Computer Vision, Es ist also eine gute Zeit, an diesen Projekten zu arbeiten und in das Feld einzusteigen. Wenn Sie noch nicht angefangen haben, über maschinelles Sehen zu lesen, Hier sind einige nützliche Ressourcen:
Was wäre, wenn ich Ihnen ein Zielbild geben und Sie bitten würde, ein Computer-Vision-Programm zu schreiben, das das Bild von Grund auf neu erstellt?? Jawohl, Das ist die Macht der Computer Vision!
Dieses wirklich coole Open-Source-Projekt ermöglicht es uns, einen Zeichenprozess nachzuahmen, wenn uns ein Zielbild zur Verfügung gestellt wird. Hier ist eine kleine Demo, wie der Prozess aussieht:

Ich kann es kaum erwarten, das in die Finger zu bekommen und alle möglichen Dinge zu zeichnen.. Sie benötigen die folgenden Python-Bibliotheken, um dies auszuführen:
- OpenCV 3.4.1
- NumPy 1.16.2
- matplotlib 3.0.3
Der Entwickler hat uns auch ein Beispiel gegeben, damit Sie es ausführen und sehen können, wie sich die Magie der Computer Vision entfaltet. Ich empfehle Ihnen auch, die folgenden OpenCV-Artikel zu lesen, wenn Sie noch nicht damit gearbeitet haben:
Dieses Open-Source-Projekt richtet sich an etwas fortgeschrittene Datenwissenschaftler. Um zu verstehen, worum es in diesem Projekt geht, wir müssen das Konzept der Einzelbild-Superauflösung verstehen. In einfachen Worten, el objetivo aquí es construir una imagen de alta AuflösungDas "Auflösung" bezieht sich auf die Fähigkeit, feste Entscheidungen zu treffen und gesetzte Ziele zu erreichen. Im persönlichen und beruflichen Kontext, Dabei geht es darum, klare Ziele zu definieren und einen Aktionsplan zu entwickeln, um diese zu erreichen. Entschlossenheit ist entscheidend für persönliches Wachstum und Erfolg in verschiedenen Lebensbereichen, denn es ermöglicht Ihnen, Hindernisse zu überwinden und sich auf das zu konzentrieren, was wirklich wichtig ist.... a partir de una entrada correspondiente de baja resolución.
Klingt nach einem klassischen Computer-Vision-Projekt!!
PULSE ist eine neuartige Lösung für diese Problemstellung. IMPULS, Abkürzung für Photo Upsampling via Latent Space Exploration, erzeugt ultrarealistische, hochauflösende Bilder mit unglaublich hohen Auflösungen. Y esto se logra de una manera totalmente auto-supervisada y no se limita a un operador de degradación específico utilizado durante el AusbildungTraining ist ein systematischer Prozess zur Verbesserung der Fähigkeiten, körperliche Kenntnisse oder Fähigkeiten. Es wird in verschiedenen Bereichen angewendet, wie Sport, Aus- und Weiterbildung. Zu einem effektiven Trainingsprogramm gehört auch die Zielplanung, Regelmäßiges Üben und Bewerten der Fortschritte. Anpassung an individuelle Bedürfnisse und Motivation sind Schlüsselfaktoren, um in jeder Disziplin erfolgreiche und nachhaltige Ergebnisse zu erzielen.....
Dann, ein Beispiel für die Funktionsweise von PULSE wird gezeigt:
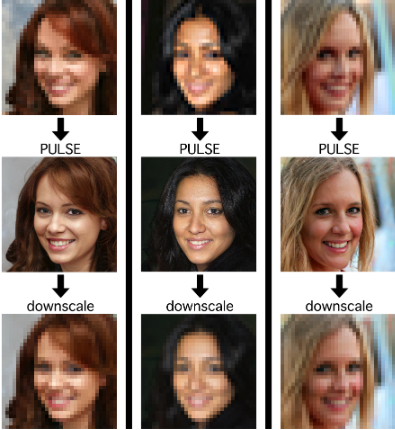
Ich ermutige Sie, zuerst die zu lesen Forschungsarbeit bevor du dir den Code anschaust. Dadurch bekommst du eine bessere Vorstellung davon, wie PULSE unten funktioniert, sodass du viel klarer an den Code herangehen kannst.
Andere Open-Source-Data-Science-Projekte
Hier sind ein paar Open-Source-Data-Science-Projekte, die nicht in die beiden oben genannten Kategorien passen. In Wirklichkeit, das sind zwei gegensätzliche Projekte: one richtet sich an Data Science-Einsteiger, mientras que el otro se ocupa del mundo del VerstärkungslernenReinforcement Learning ist eine Technik der künstlichen Intelligenz, die es einem Agenten ermöglicht, durch Interaktion mit einer Umgebung zu lernen, Entscheidungen zu treffen. Durch Feedback in Form von Belohnungen oder Bestrafungen, Der Agent optimiert sein Verhalten, um die kumulierten Belohnungen zu maximieren. Dieser Ansatz wird in einer Vielzahl von Anwendungen eingesetzt, Von Videospielen über Robotik bis hin zu Empfehlungssystemen, Er zeichnet sich durch seine Fähigkeit aus, komplexe Strategien zu erlernen.....
Wählen Sie diejenige aus, die für Sie am besten geeignet ist, und beginnen Sie, sie zu erkunden.
Ich bin sicher, die meisten von Ihnen haben mit dem Iris-Datensatz gearbeitet. Eigentlich, Es könnte sogar der erste Datensatz gewesen sein, mit dem Sie das Konzept der Klassifikation beim maschinellen Lernen verstanden haben. Ich liebe es, wie einfach es ist, den Datensatz zu verstehen und zu erkunden.
Aber mit dem gleichen Datensatz zu arbeiten kann etwas langweilig werden, vor allem, wenn Sie die Besonderheiten des maschinellen Lernens erlernen.
Hier kommt der PalmerPenguins-Datensatz ins Spiel.. Dieser Datensatz, Open Source letzten Monat, ist als Alternative zu Iris positioniert und zielt darauf ab, einen großen Datensatz für die Datenexploration und -visualisierung bereitzustellen, speziell für Anfänger. Hier ist ein Beispiel für die Visualisierungen, die Sie sich ausdenken können:

Der oben erwähnte Link enthält Beispiele dafür, wie Sie mit der Erkundung dieser Daten beginnen können. Sie haben sogar Details zu den verschiedenen Variablen bereitgestellt, aber möchtest du das nicht selbst erkunden? 🙂
Sie können PalmerPenguins mit dem folgenden Code auf Ihrem Computer installieren:
# install.pakete("Fernbedienungen")
Fernbedienungen::install_github("allisonhorst/palmerpinguine")
Ich empfehle auch, die folgenden beliebten Artikel zum Erkunden und Visualisieren von Daten zu lesen.:
Ah, hier ist ein Open Source Projekt für euch alle, Freunde des Verstärkungslernens. SlimeVolleyGym ist eine einfache Fitnessstudio-Umgebung zum Testen von Verstärkungslernalgorithmen mit einem und mehreren Agenten. Dies wurde erstellt und Open Source von hardmaru, eine Legende im Bereich des maschinellen Lernens.
So funktioniert das Spiel seiner Meinung nach (er hat das Spiel selbst in JavaScript erstellt):
Das Spiel ist sehr einfach: das Ziel des Agenten ist es, den Ball auf der gegnerischen Seite zu Boden fallen zu lassen, was dazu führt, dass sein Gegner ein Leben verliert. Jeder Agent beginnt mit fünf Leben. Die Episode endet, wenn einer der Agenten alle fünf Leben verliert., oder nachdem sie bestanden haben 3000 Schritte. Ein Agent erhält eine Belohnung von +1 wenn dein Gegner verliert oder -1 wenn du ein Leben verlierst.

Sie können installieren Limovolleygym direkt von pip:
Pip installieren Slimevolleygym
Hier sind ein paar tolle Tutorials von unserem Resident Reinforcement Learning Experten Ankit Choudhary:
Abschließende Anmerkungen
Uf, es gibt viele projekte. Mein Ziel, wie immer, war es, die Projekte so vielfältig wie möglich zu halten, damit Sie diejenigen auswählen können, die zu Ihrer Data Science-Reise passen. Wenn Sie ein Anfänger sind, Ich schlage vor, Sie beginnen mit dem PalmerPenguins-Datensatz, da die meisten Leute es gerade nicht wissen. Eine tolle Gelegenheit mit einem Vorteil zu starten.
Ich würde gerne Ihre Meinung dazu hören, welches Open-Source-Projekt für Sie am nützlichsten war.. Oder lassen Sie es mich wissen, wenn Sie möchten, dass ich hier oder in der nächsten Ausgabe weitere Data Science-Projekte vorstelle..





