
Dieser Artikel wurde im Rahmen der Data Science Blogathon
Überblick
- Lernen Sie das Grundkonzept des Data Mining kennen
- Verstehen Sie die Anwendungen von Data Mining
Voraussetzungen
- Grundverständnis von Python
- Grundkenntnisse der Datenbank
Willkommen Leute!
Hier werde ich Ihnen einen kurzen Einblick in die Grundlagen des Data Mining geben. Sabemos que en todas partes hay datos en varios formatos que se almacenarán en una DatenbankEine Datenbank ist ein organisierter Satz von Informationen, mit dem Sie, Effizientes Verwalten und Abrufen von Daten. Einsatz in verschiedenen Anwendungen, Von Unternehmenssystemen bis hin zu Online-Plattformen, Datenbanken können relational oder nicht-relational sein. Das richtige Design ist entscheidend für die Optimierung der Leistung und die Gewährleistung der Informationsintegrität, und erleichtert so eine fundierte Entscheidungsfindung in verschiedenen Kontexten..... Nach der Datenskala, wir können eine geeignete Datenbank auswählen. Dann, Es gibt beliebte Datenbanken, die wir kennen, als PostgreSQL, NoSQL, MongoDB, Microsoft SQL Server und viele mehr.
In diesem Artikel, Sie bekommen eine Vorstellung von Data Mining.
Also lass uns weitermachen …
Was ist Data-Mining??
„Datenverarbeitung“, das extrahiert die Daten. In einfachen Worten, definiert sich als das Finden verborgener Einsichten (Information) aus der Datenbank, Muster aus Daten extrahieren.
Es gibt unterschiedliche Algorithmen für unterschiedliche Aufgaben. Die Funktion dieser Algorithmen besteht darin, das Modell anzupassen. Diese Algorithmen identifizieren die Eigenschaften der Daten. Es gibt 2 Arten von Modellen.
1) Vorhersagemodell
2) Beschreibendes Modell
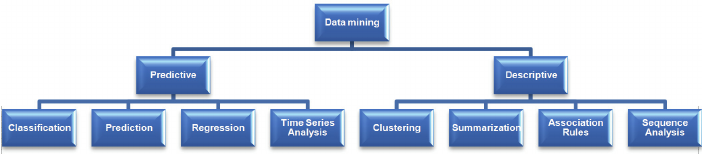
Grundlegende Data-Mining-Aufgaben
In diesem Abschnitt, wir werden einige der funktionen sehen / Bergbauaufgaben.
1) Einstufung
Este término viene bajo überwachtes LernenÜberwachtes Lernen ist ein Ansatz des maschinellen Lernens, bei dem ein Modell mit einem Satz von beschrifteten Daten trainiert wird. Jede Eingabe im Dataset ist mit einer bekannten Ausgabe verknüpft, So kann das Modell lernen, Ergebnisse für neue Eingaben vorherzusagen. Diese Methode wird häufig in Anwendungen wie der Bildklassifizierung eingesetzt., Spracherkennung und Trendvorhersage, und unterstreicht seine Bedeutung in.... Klassifikationsalgorithmen erfordern die Definition von Klassen basierend auf Variablen. Die Merkmale der Daten definieren, zu welcher Klasse sie gehören. Mustererkennung ist eine der Arten von Klassifikationsproblemen, bei denen Eingaben (Muster) wird aufgrund ihrer definierten Klassenähnlichkeit in verschiedene Klassen eingeteilt.
2) Vorhersage
Im echten Leben, wir sehen oft Dinge vorhersagen / zukünftige Werte / oder anderweitig basierend auf vergangenen Daten und gegenwärtigen Daten. Vorhersage ist auch eine Art von Klassifikationsaufgabe. Je nach Art der Bewerbung, zum Beispiel, Vorhersagen von Überschwemmungen, bei denen die abhängigen Variablen der Flusswasserstand sind, seine Feuchtigkeit, Regenwaage, etc. sind die Attribute.
3) Rückschritt
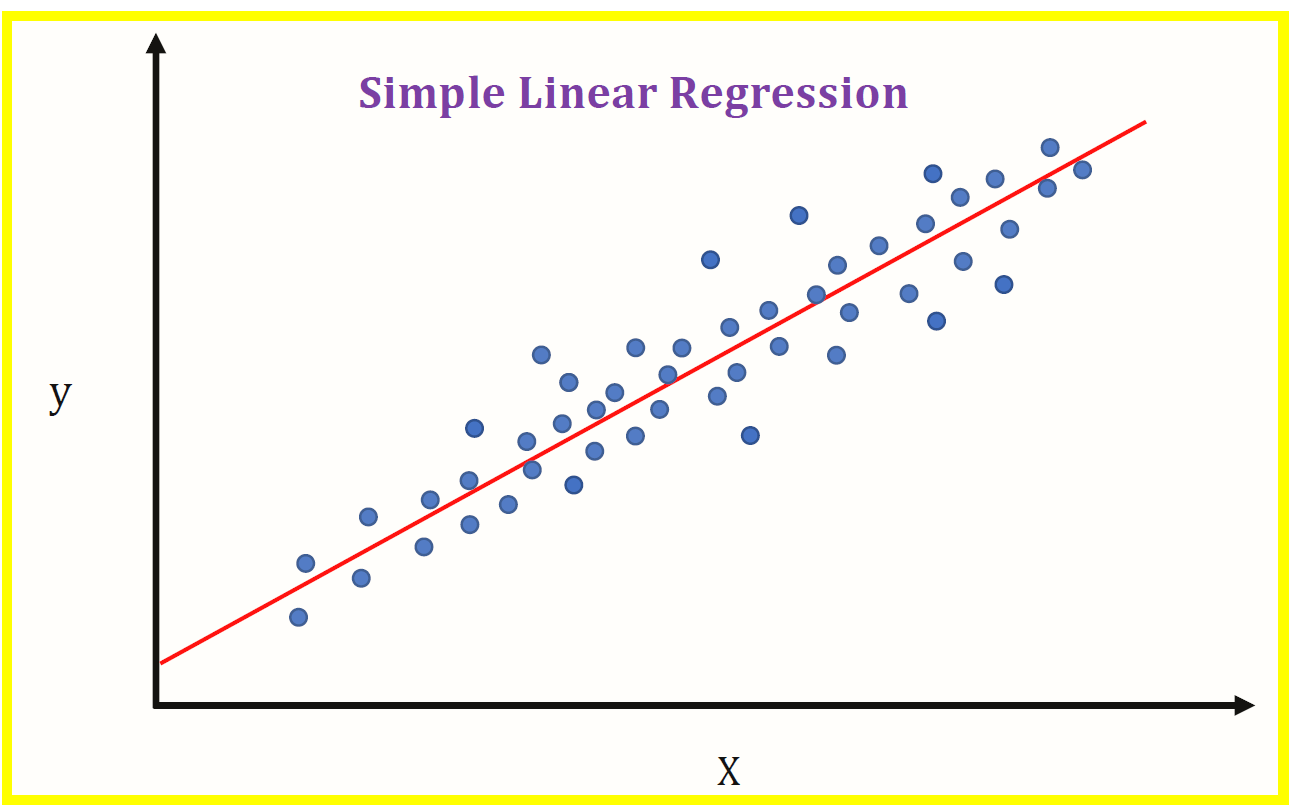
Regression ist eine statistische Technik, die verwendet wird, um die Beziehung zwischen Variablen zu bestimmen (x) und die abhängigen Variablen (Ja). Es gibt nur wenige Regressionsarten wie Linear, Logistik, etc. Lineare Regression wird für kontinuierliche Werte verwendet (0,1,1,5,… .und so weiter) und logistische Regression wird verwendet, wenn die Möglichkeit besteht, dass nur zwei Ereignisse auftreten / Versagen, Stimmt / gefälscht, Jawohl / Nein, etc.
4) Zeitreihenanalyse
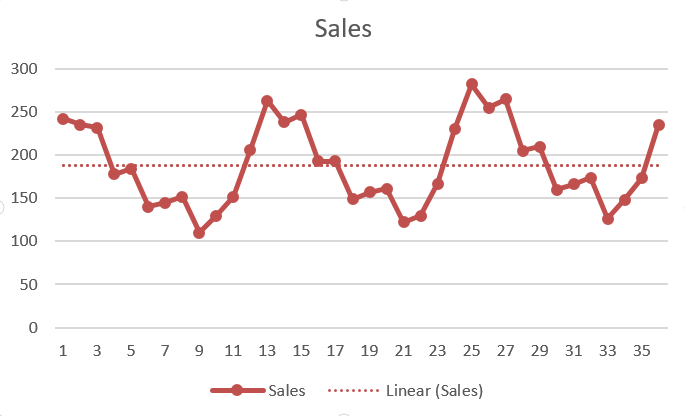
In Zeitreihenanalyse, ein VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... cambia su valor según el tiempo. Das bedeutet, dass die Analyse über einen bestimmten Zeitraum Datenidentifikationsmuster durchläuft. Kann saisonale Schwankungen aufweisen, unregelmäßige Variation, säkularer Trend und zyklische Schwankungen. Zum Beispiel, jährlicher Regen, Taschenpreis, etc.
5) Gruppierung
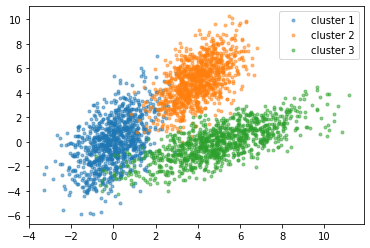
Die Gruppierung ist die gleiche wie die Klassifizierung, nämlich, gruppiere die Daten. Clustering ist im unbeaufsichtigten maschinellen Lernen enthalten. Es ist ein Prozess, bei dem die Daten auf der Grundlage ähnlicher Datentypen in Gruppen unterteilt werden.
6) Zusammenfassung
Die Zusammenfassung ist nichts anderes als eine Charakterisierung oder Verallgemeinerung. Gewinnen Sie aussagekräftige Informationen aus Daten. Es bietet auch eine Zusammenfassung numerischer Variablen als Mittelwert, Mode, MedianDer Median ist ein statistisches Maß, das den zentralen Wert eines Satzes geordneter Daten darstellt. Um es zu berechnen, Die Daten werden von der niedrigsten zur höchsten sortiert und die Zahl in der Mitte wird identifiziert. Wenn es eine gerade Anzahl von Beobachtungen gibt, Die beiden Kernwerte werden gemittelt. Dieser Indikator ist besonders nützlich bei asymmetrischen Verteilungen, da es nicht von Extremwerten beeinflusst wird...., etc.
7) Vereinsregeln
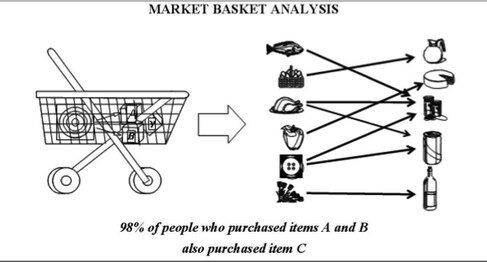
Es ist die Hauptaufgabe des Data Mining. Hilft, geeignete Muster und aussagekräftiges Wissen aus der Datenbank zu finden. Assoziationsregel ist ein Modell, das Arten von Assoziationen aus Daten extrahiert. Zum Beispiel, Warenkorbanalyse, bei der die Assoziationsregeln auf die Datenbank angewendet werden, um zu wissen, welche Artikel der Kunde zusammen kauft.
8) Sequenzerkennung
Auch Sequenzanalyse genannt. Es wird verwendet, um das sequentielle Muster in den Daten zu entdecken oder zu finden.
Sequentielles Muster bedeutet das Muster, das rein auf einer zeitlichen Abfolge basiert. Diese Muster ähneln den in der Datenbank gefundenen Assoziationsregeln oder die Ereignisse hängen zusammen, aber ihre Beziehung basiert ausschließlich auf "Zeit"..
Bisher, wir haben alle grundlegenden Funktionen oder Aufgaben von Data Mining gesehen. Lassen Sie uns weitermachen, um mehr über Data Mining zu erfahren …
Data Mining VS KDD (Wissensentdeckung in der Datenbank)
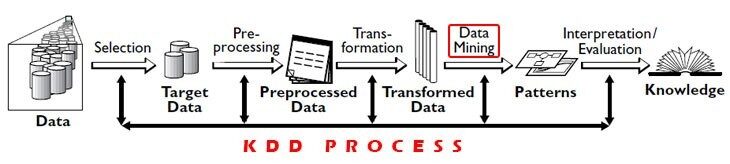
Datenverarbeitung: Prozess der Verwendung von Algorithmen, um aus dem KDD-Prozess abgeleitete aussagekräftige Informationen und Muster zu extrahieren. Es ist ein Schritt in KDD.
KDD: Es ist ein bedeutender Prozess zur Identifizierung von Mustern und aussagekräftigen Informationen in den Daten. Der Input für diesen Prozess sind die Daten und der Output liefert nützliche Informationen aus den Daten.
Der KDD-Prozess besteht aus 5 Schritte:
1) Auswahl: Sie müssen Daten aus verschiedenen Datenquellen abrufen, Datenbanken.
2) Vorverarbeitung: Dieser Datenbereinigungsprozess in Bezug auf schlechte Daten, fehlende Werte, falschen Daten.
3) Transformation: Daten aus verschiedenen Quellen müssen für die Vorverarbeitung konvertiert und in ein bestimmtes Format kodiert werden.
4) Data-Mining: In diesem Prozess, Algorithmen werden auf die transformierten Daten angewendet, um die gewünschte Ausgabe oder Ergebnisse zu erzielen.
5) Interpretation / Auswertung: Sie müssen einige Visualisierungen erstellen, um Data-Mining-Ergebnisse zu präsentieren, die sehr wichtig sind.
Data-Mining-Anwendungen
1) E-Commerce
E-Commerce ist eine seiner Anwendungen im wirklichen Leben. E-Commerce-Unternehmen sind wie Amazon, Flipkart, Myntra, etc. Sie verwenden Data-Mining-Techniken, um die Funktionalität jedes Produkts so zu sehen, dass "welches Produkt vom Kunden am meisten gesehen wird und was anderen gefallen hat"..
2) Einzelhandel
Es ist eine weitere Data-Mining-App für den Einzelhandel. Einzelhändler finden das Muster von „Frische, Frequenz, Geld (in Bezug auf die Währung)“. Einzelhändler verfolgen Produktverkäufe und Transaktionen.
3) Ausbildung
Bildung ist heute ein aufstrebendes und trendiges Feld. Es geht um die Entdeckung von Wissen aus Bildungsdaten. Das Hauptziel dieser Anwendung besteht darin, das Verhaltensmuster des Schülers im Hinblick auf das zukünftige Lernen zu untersuchen oder zu identifizieren, Studieneffekte, erweitertes Lernwissen, etc. Diese Data-Mining-Techniken werden von Institutionen verwendet, um genaue Entscheidungen zu treffen und auch geeignete Ergebnisse vorherzusagen..
Data-Mining-Tools
– MESSER
-WEKA
-ORANGE
Data-Mining-Algorithmen
- Gruppierung von K-Strümpfen
- Support-Vektor-Maschinen
- A priori
- KNN
- Bayes ingenuo
- WARENKORB und vieles mehr …
Dies sind einige Algorithmen.
* Nun gebe ich Ihnen nachfolgend Informationen zu den benötigten Bibliotheken.
– A priori:
aus apyori importieren apriori
– Gruppierung von K-Strümpfen:
from kneed import KneeLocator
from sklearn.datasets import make_blobs
from sklearn.cluster import KMeans
from sklearn.metrics import silhouette_score
from sklearn.preprocessing import StandardScaler
– Support-Vektor-Maschinen:
von sklearn import svm
-Naive Bayes:
von sklearn.naive_bayes importieren GaussianNB
-WAGEN:
aus sklearn.tree import DecisionTreeRegressor
-KNN:
fromsklearn.neighborsimportKNeighborsClassifier
Hier sind also einige Bibliotheken, die installiert werden müssen, während der Algorithmus ausgeführt wird.
Fazit
Ich hoffe dir hat mein Artikel gefallen. Wenn Sie eine Frage haben, Sie können unten Kommentare hinterlassen. Vielen Dank!
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





