
Einführung
Datenmanipulation ist eine unvermeidliche Phase der Vorhersagemodellierung. Ein robustes Vorhersagemodell kann nicht einfach mit maschinellen Lernalgorithmen erstellt werden. Aber, mit einem Ansatz zum Verständnis des Geschäftsproblems, die zugrunde liegenden Daten, die notwendigen Datenmanipulationen durchführen und dann Geschäftsinformationen extrahieren.
Unter diesen verschiedenen Phasen des Modellbaus, die meiste Zeit wird normalerweise damit verbracht, die zugrunde liegenden Daten zu verstehen und die notwendigen Manipulationen durchzuführen. Dies wäre auch das zentrale Thema dieses Artikels: Pakete für schnellere Datenmanipulation in R.
Was ist Datenmanipulation?
Wenn Sie immer noch mit diesem verwirrt sind ‚fertig‘, lassen Sie mich erklären. Datenmanipulation ist ein Begriff, der lose verwendet wird mit „Datenexploration“. Impliziert ‚manipulieren‘ Daten mit einem Satz verfügbarer Variablen. Dies geschieht, um die Genauigkeit und Präzision der Daten zu verbessern..
In Wirklichkeit, Der Datenerhebungsprozess kann viele Lücken aufweisen. Es gibt mehrere unkontrollierbare Faktoren, die zu Ungenauigkeiten in den Daten führen, wie die psychische Situation der Befragten, persönliche Vorurteile, Unterschiede / Fehler in Maschinenmesswerten, etc. Um diese Ungenauigkeiten abzumildern, Daten werden manipuliert, um die Genauigkeit zu erhöhen (maximal) in den Daten möglich.
Manchmal, diese Phase wird auch als Datenstreit oder Datenbereinigung bezeichnet.
Verschiedene Möglichkeiten zu manipulieren / Prozessdaten:
Es gibt keinen richtigen oder falschen Weg, Daten zu manipulieren, solange Sie diese verstehen und am Ende der Übung die notwendigen Maßnahmen ergriffen haben. Aber trotzdem, Hier sind einige allgemeine Möglichkeiten, wie Menschen versuchen, sich der Datenmanipulation zu nähern. Sind hier:
- Wie gewöhnlich, Anfänger in R fühlen sich wohl Daten mit integrierten R-Basisfunktionen manipulieren. Dies ist ein guter erster Schritt., aber es ist oft repetitiv und zeitaufwendig. Deswegen, ist ein weniger effizienter Weg, das Problem zu lösen.
- Verwenden von Paketen zur Datenmanipulation. CRAN hat mehr als 7000 aktuell verfügbare Pakete. In einfachen Worten, Diese Pakete sind nichts anderes als eine Sammlung häufig verwendeter vorgefertigter Codes. Helfen Sie bei sich wiederholenden Aufgaben auf nüchternen Magen, Reduzieren Sie Codierungsfehler und erhalten Sie Hilfe von fachmännisch geschriebenem Code (im gesamten Open-Source-Ökosystem für R) um Ihren Code effizienter zu machen. Dies ist normalerweise die gebräuchlichste Methode zur Datenmanipulation.
- Einsatz von ML-Algorithmen zur Datenmanipulation. Sie können baumbasierte Bewehrungsalgorithmen verwenden, um mit fehlenden Daten und Ausreißern umzugehen. Während diese definitiv weniger Zeit benötigen, Bei diesen Ansätzen wünscht man sich in der Regel am Ende ein besseres Verständnis der Daten.
Deswegen, Meistens, die Verwendung von Paketen ist die De-facto-Methode zur Durchführung von Datenmanipulationen. In diesem Artikel, Ich habe mehrere Pakete erklärt, die das Leben von ‚R‘ während der Datenmanipulationsphase.
Notiz: Dieser Artikel ist eher für Anfänger in der Sprache R geeignet. Sie können ein Paket installieren mit:
install.packages('package name')
Paketliste
Zum besseren Verständnis, Ich habe seine Verwendung auch demonstriert, indem ich häufig verwendete Operationen durchführte. Unten ist die Liste der Pakete, die in diesem Artikel besprochen werden:
- dplyr
- Datentabelle
- ggplot2
- umgestalten2
- Leser
- aufgeräumter
- schmieren
Notiz: Ich verstehe, dass ggplot2 ein grafisches Paket ist. Aber, allgemein, hilft bei der Visualisierung von Daten (Ausschüttungen, Korrelationen) und Manipulationen entsprechend durchführen. Deswegen, Ich habe es zu dieser Liste hinzugefügt. In allen Paketen, Ich habe nur die am häufigsten verwendeten Befehle bei der Datenmanipulation behandelt.
dplyr-Paket
Diese Pakete werden erstellt und verwaltet von Hadley Wickham. Dieses Paket hat alles (fast schon) um Ihre Datenmanipulationsbemühungen zu beschleunigen. Er ist vor allem für Datenexploration und -transformation bekannt. Seine Verkettungssyntax macht die Verwendung hochgradig anpassbar. Es enthält 5 Hauptbefehle zur Datenmanipulation:
- Filter: Daten basierend auf einer Bedingung filtern
- zur Auswahl: Wird verwendet, um interessante Spalten aus einem Datensatz auszuwählen
- Organisieren: wird verwendet, um die Datensatzwerte in aufsteigender oder absteigender Reihenfolge zu organisieren.
- drehen: verwendet, um neue Variablen aus vorhandenen Variablen zu erstellen
- abstrakt (con group_by): verwendet, um Analysen mit häufig verwendeten Operationen durchzuführen, Als Minimum, maximal, mittlere Anzahl, etc.
Konzentrieren Sie sich auf diese Befehle und machen Sie einen großartigen Job beim Erkunden von Daten. Lassen Sie uns diese Befehle nacheinander verstehen. Ich habe benutzt 2 vorinstallierte R-Datensätze, nämlich, mtcars und iris.
> Bücherei(dplyr)
> Daten("mtcars")
> Daten('iris')
> meine Daten <- mtcars
#Daten lesen
> Kopf(meine Daten)
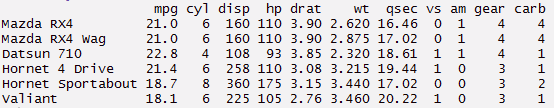
#Erstellen eines lokalen Datenrahmens. Lokale Datenrahmen sind leichter zu lesen

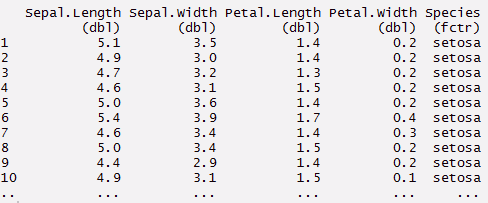
> Zugangsdaten <- tbl_df(meine Daten)
> myirisdaten <- tbl_df(Iris)
#jetzt werden die Daten in tabellarischer Struktur angezeigt > Zugangsdaten> myirisdaten
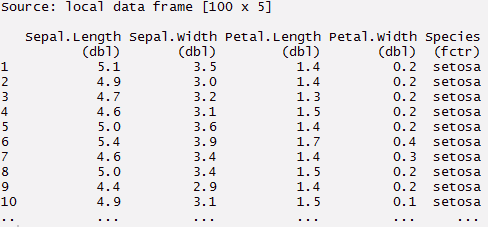
#Verwenden Sie den Filter, um Daten mit der erforderlichen Bedingung zu filtern > Filter(Zugangsdaten, Zyl > 4 & Ausrüstung > 4 )> Filter(Zugangsdaten, Zyl > 4)
> Filter (myirisdaten, Spezies% in% c (Setosa, Virginica))
#benutzen auswählenDer Befehl "AUSWÄHLEN" ist in SQL von grundlegender Bedeutung, Wird zum Abfragen und Abrufen von Daten aus einer Datenbank verwendet. Ermöglicht das Angeben von Spalten und Tabellen, Filtern von Ergebnissen mithilfe von Klauseln wie "WO" und Bestellung mit "SORTIEREN NACH". Seine Vielseitigkeit macht es zu einem unverzichtbaren Werkzeug für die Datenmanipulation und -analyse, Erleichterung der effizienten Beschaffung spezifischer Informationen.... Spalten nach Namen auszuwählen > auswählen(Zugangsdaten, Zyl,mpg,PS)#hier kannst du verwenden (-) Spalten ausblenden > auswählen(Zugangsdaten, -Zyl, -mpg )
# eine Reihe von Spalten ausblenden> zur Auswahl (Zugangsdaten, -C (Zyl, mpg))
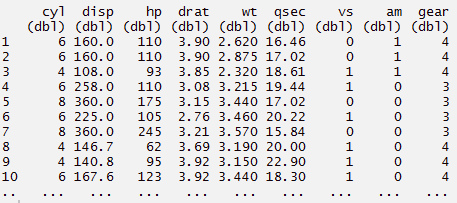
#Verkettung oder Pipelining - eine Möglichkeit, mehrere Operationen durchzuführen
#in einer Zeile
> betreten%>%
     auswählen(Zyl, wt, Ausrüstung)%>%
     Filter(wt > 2)
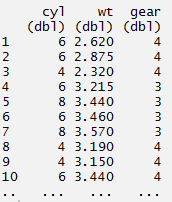
#Arrangieren kann verwendet werden, um Zeilen neu anzuordnen
> betreten%>%
     auswählen(Zyl, wt, Ausrüstung)%>%
     arrangieren(wt)
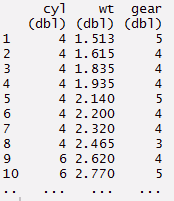
#oder
> betreten%>%
     auswählen(Zyl, wt, Ausrüstung)%>%
     arrangieren(Beschreibung(wt))
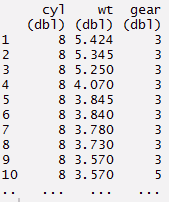
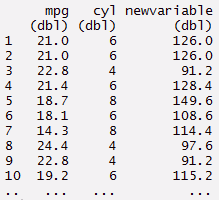
#mutieren - neue Variablen erstellen

> betreten%>%
      auswählen(mpg, Zyl)%>%
      mutieren(neuevariable = mpg*cyl)
#oder
> neuevariable <- betreten%>% mutieren(neuevariable = mpg*cyl)
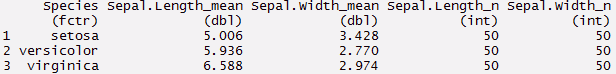
#zusammenfassen - Dies wird verwendet, um Erkenntnisse aus Daten zu gewinnen
> myirisdaten%>%
       gruppiere nach(Spezies)%>%
       zusammenfassen(Durchschnitt = Mittelwert(Kelch.Länge, na.rm = WAHR))
#oder verwenden Sie jeweils zusammenfassen
> myirisdaten%>%
gruppiere nach(Spezies)%>%
zusammenfassen_each(Spaß(bedeuten, n()), Kelch.Länge, Kelch.Breite)
 #Mit diesen können Sie komplexe Kettenbefehle erstellen 5 Verben.
#Sie können die Variablen mit dem Befehl umbenennen umbenennen
> betreten%>% umbenennen(Meilen = mpg)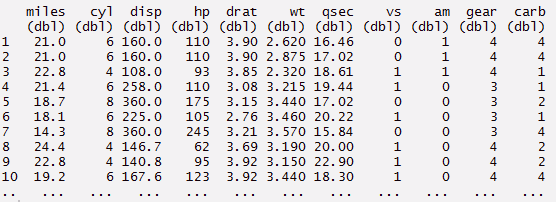
data.table-Paket
Dieses Paket ermöglicht Ihnen eine schnellere Bearbeitung eines Datensatzes. Verabschieden Sie sich von Ihren traditionellen Methoden der Unterkonfiguration von Zeilen und Spalten und verwenden Sie dieses Paket. Mit minimaler Codierung, kann noch viel mehr. Die Verwendung von data.table hilft, die Rechenzeit im Vergleich zu data.frame zu reduzieren. Sie werden von der Einfachheit dieses Pakets begeistert sein.
Eine Datentabelle hat 3 Teile, nämlich, DT[ich,J,von]. Du kannst das verstehen als, können wir R sagen, dass es eine Untermenge der Zeilen mit ‚ich‘, berechnen ‚J‘ die nach gruppiert ist ‚von‘. Meistens, „von“ bezieht sich auf eine VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... Kategorisch. Im folgenden Code, Ich habe benutzt 2 Datensätze (Luftqualität und Iris).
#lade Daten
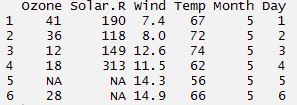
> Daten("Luftqualität")
> meine Daten <- Luftqualität
> Kopf(Luftqualität,6)
> Daten(Iris)
> myiris <- Iris
#Paket laden
> Bücherei(Datentabelle)
> meine Daten <- Datentabelle(meine Daten)
> meine Daten
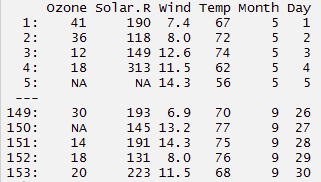
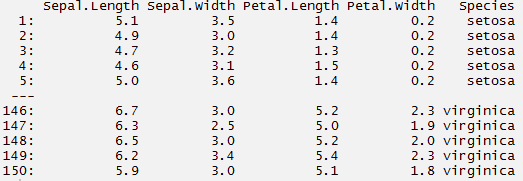
> myiris <- Datentabelle(myiris)
> myiris
#Teilmenge Zeilen - 2. bis 4. Reihe auswählen

> meine Daten[2:4,]
#Spalten mit bestimmten Werten auswählen
> myiris[Species == 'setosa']
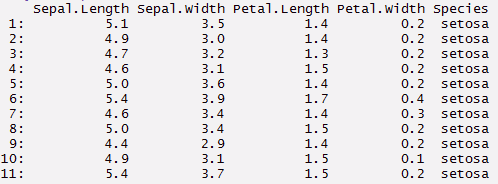
#Spalten mit mehreren Werten auswählen. Dadurch erhalten Sie Spalten mit Setosa
#und virginica-Arten
> myiris[Spezies %in% c(Setosa, Virginica)]

#Spalten auswählen. Gibt einen Vektor zurück
> meine Daten[,Temperatur]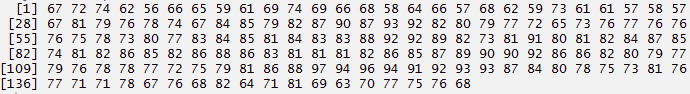
> meine Daten[,.(Temperatur,Monat)]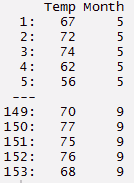
#gibt die Summe der ausgewählten Spalte zurück
> meine Daten[,Summe(Ozon, na.rm = WAHR)]

[1]4887
#gibt Summe und Standardabweichung zurück
> meine Daten[,.(Summe(Ozon, na.rm = WAHR), sd(Ozon, na.rm = WAHR))]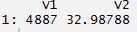
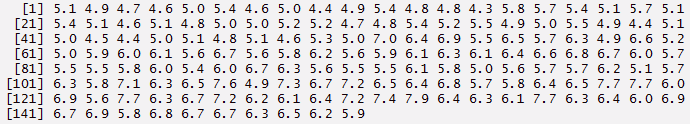
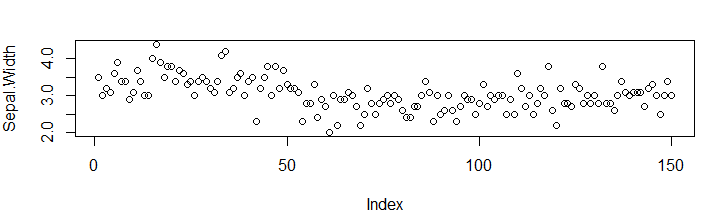
#drucken und plotten
> myiris[,{drucken(Kelch.Länge)
> Handlung(Kelch.Breite)
 NULL}]
#Gruppierung nach einer Variablen
> myiris[,.(Sepalsum = Summe(Kelch.Länge)), von=Arten]
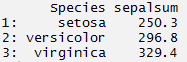
#Wählen Sie eine Spalte für die Berechnung aus, Daher müssen Sie den Schlüssel auf die Spalte setzen
> setkey(myiris, Spezies)

#wählt alle Zeilen aus, die diesem Datenpunkt zugeordnet sind
> myiris[Setosa]
> myiris[C(Setosa, Virginica)]
Ggplot2-Paket
ggplot bietet eine ganz neue Welt an Farben und Mustern. Wenn Sie eine kreative Seele sind, Sie werden dieses Paket bis ins Mark lieben. Aber, wenn Sie lernen möchten, was für den Einstieg notwendig ist, folge den Codes unten. Sie müssen lernen, wie Sie zumindest diese nachverfolgen können 3 Grafik: AusbreitungsdiagrammDas Streudiagramm ist ein grafisches Werkzeug, das in der Statistik verwendet wird, um die Beziehung zwischen zwei Variablen zu visualisieren. Es besteht aus einer Menge von Punkten in einer kartesischen Ebene, wobei jeder Punkt ein Wertepaar darstellt, das den analysierten Variablen entspricht. Diese Art von Diagramm ermöglicht es Ihnen, Muster zu erkennen, Trends und mögliche Korrelationen, Erleichterung der Dateninterpretation und Entscheidungsfindung auf der Grundlage der präsentierten visuellen Informationen...., Balkendiagramm, Histogramm.
Diese 3 Diagrammmuster decken fast alle Arten der Datendarstellung ab, außer Karten. ggplot ist mit benutzerdefinierten Funktionen angereichert, um Ihre Anzeige immer besser zu machen. Es wird noch leistungsfähiger, wenn es mit anderen Paketen wie cowplot gebündelt wird, GitterExtra. Eigentlich, es gibt viele funktionen. Deswegen, Sie müssen sich auf einige Befehle konzentrieren und Ihr Fachwissen darin entwickeln. Ich habe auch die Methode zum Vergleichen von Diagrammen in einem Fenster gezeigt. Erfordert das Paket ‚GitterExtra‘. Deswegen, muss es installieren. Ich habe vorinstallierte R-Datensätze verwendet.
> Bücherei(ggplot2)
> Bücherei(GitterExtra)
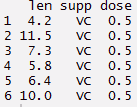
> df <- Zahnwachstum
> df$dosis <- as.faktor(df$dosis)
> Kopf(df)
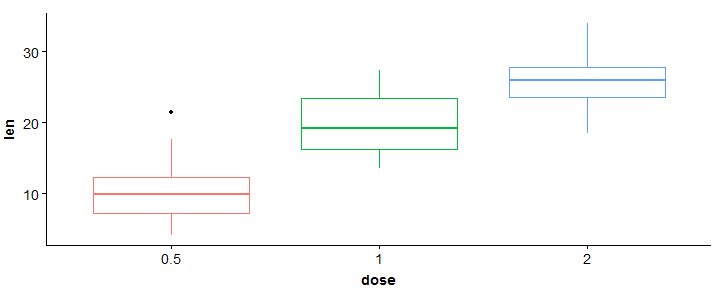
#Box-Plot
> bp <- ggplot(df, aes(x = Dosis, y = len, Farbe = Dosis)) + geom_boxplot() + Thema(legend.position = 'none')
> bp
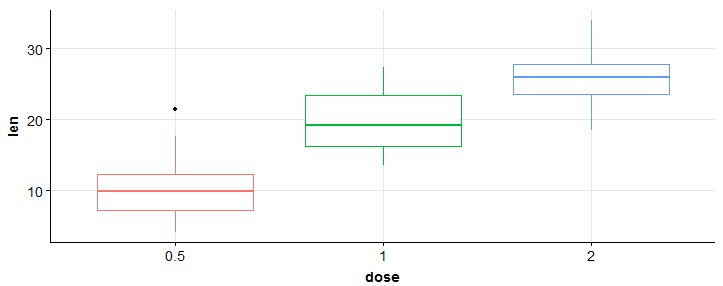
#Rasterlinien hinzufügen
> bp + background_grid(Haupt = "xy", klein="keiner")
#Streudiagramm
> sp <- ggplot(mpg, aes(x = ct, y = Autobahn, Farbe = Faktor(Zyl)))+geom_point(Größe = 2.5)
> sp
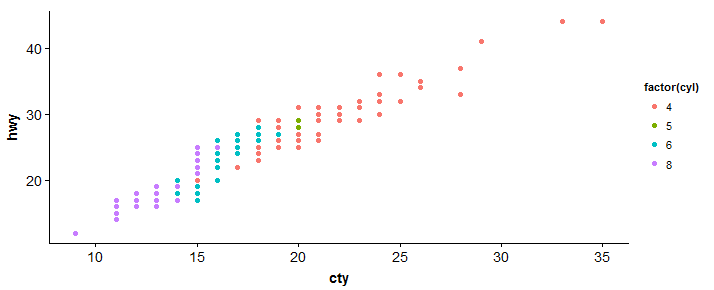
#Balkendiagramm
> bp <- ggplot(Diamanten, aes(Klarheit, füllen = schneiden)) + geom_bar() +Thema(achse.text.x = element_text(Winkel = 70, vjust = 0.5))
> bp
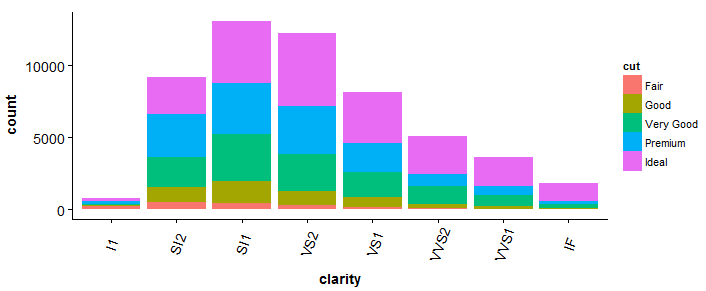
#vergleiche zwei Plots
> plot_grid(sp, bp, Etiketten = c("EIN","B"), ncol = 2, jetzt = 1)
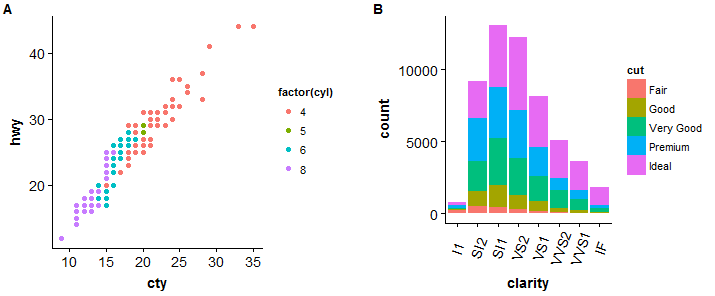 #Histogramm
> ggplot(Diamanten, aes(x = Karat)) + geom_histogramm(binwidth = 0.25, füllen="steelblue")+scale_x_continuous(breaks=seq(0,3, um=0.5))
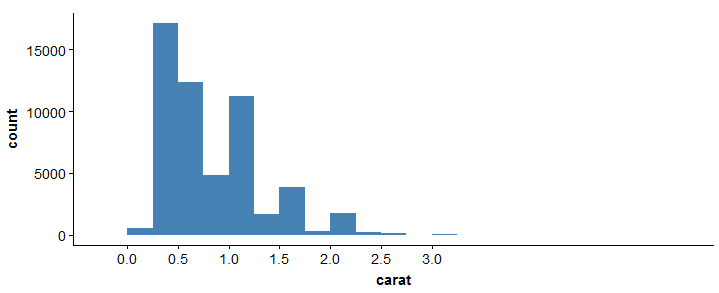
Weitere Informationen zu diesem Paket, siehe Referenzblatt hier: ggplot2 Spickzettel
reshape2-Paket
Wie der Name schon sagt, Dieses Paket ist nützlich, um die Daten umzuformen. Wir alle wissen, dass Daten in vielen Formen vorliegen. Deswegen, wir sind verpflichtet, es nach unseren Bedürfnissen zu zähmen. Wie gewöhnlich, Der Prozess der Umformung von Daten in R ist mühsam und besorgniserregend. Die Basisfunktionen von R bestehen aus der Option ‚Anhäufung‘ wodurch Daten reduziert und in kleinere Formen reorganisiert werden können, aber mit reduzierter Informationsmenge. Die Aggregation umfasst tapply-Basisfunktionen, von und hinzugefügt. Das Umbaupaket löst diese Probleme. Hier versuchen wir Features zu kombinieren, die einzigartige Werte haben. Verfügt über 2 Funktionen zu wissen schmelzen Ja emittieren.
schmelzen : Diese Funktion konvertiert Daten vom Breitformat in das Langformat. Es ist eine Form der Umstrukturierung, bei der mehrere kategorische Spalten ‚zusammengeführt werden‘ in einzigartigen Reihen. Lassen Sie uns den folgenden Code verwenden.
#Daten erstellen
> ICH WÜRDE <- C(1,2,3,4,5)
> Namen <- C('Joseph','Matrin','Joseph','James','Matrin')
> Geburtsdatum <- C(1993,1992,1993,1994,1992)
> Untertan<- C('Mathematik','Biologie','Naturwissenschaften','Psychologie','Physik')
> diese Daten <- data.frame(ICH WÜRDE, Namen, Geburtsdatum, Untertan)
> Datentabelle(diese Daten)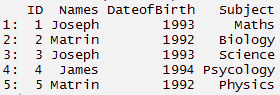
#Paket laden
> install.pakete('reshape2')
> Bücherei(umformen2)
#schmelzen
> mt <- schmelzen(diese Daten, id=(C('ID','Namen')))
> mt
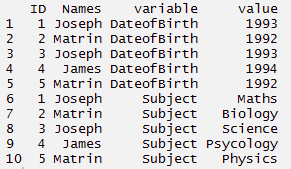
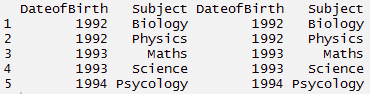
emittieren : Diese Funktion konvertiert die Daten vom Langformat in das Breitformat. Beginnt mit fusionierten Daten und wechselt zum langen Format. Es ist nur das Gegenteil von schmelzen Funktion. Es hat zwei Funktionen, nämlich, dcast Ja eine Besetzung. dcast gibt einen Datenrahmen als Ausgabe zurück. acast gibt einen Vektor zurück / Hauptquartier / Array als Ausgabe. Lassen Sie uns den folgenden Code verwenden.
#werfen
> mcast <- dcast(mt, Geburtsdatum + Betreff ~ variabel)
> mcast
Notiz: Bei der Recherche, Ich habe dieses Bild gefunden, das das Umbaupaket treffend beschreibt.
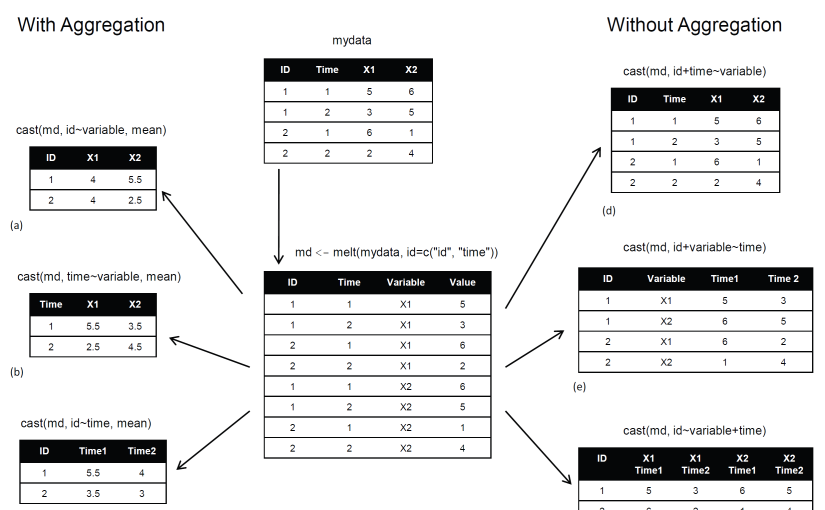 Quelle: r-Statistik
Leserpaket
Wie der Name schon sagt, ‚leser‘ hilft beim Lesen verschiedener Datenformen in R. Mit einer Geschwindigkeit 10 mal schneller. Hier, Charaktere werden nie zu Faktoren (also kein stringAsFactors = FALSE). Dieses Paket kann die traditionellen R-Basisfunktionen read.csv . ersetzen () Sie lesen.Tabelle (). Helfen Sie mit, die folgenden Daten zu lesen:
- Mit getrennte Dateien
read_delim(),read_csv(),read_tsv(), Jaread_csv2(). - Dateien mit fester Breite mit
read_fwf(), Jaread_table(). - Web-Log-Dateien mit
read_log()
Wenn die Datenladezeit länger ist als 5 Sekunden, diese Funktion zeigt Ihnen auch einen Fortschrittsbalken. Sie können den Fortschrittsbalken unterdrücken, indem Sie ihn als FALSE markieren. Sehen wir uns den folgenden Code an:
> install.pakete('readr')
> Bücherei(leser)
> read_csv('test.csv',col_names = WAHR)
Sie können auch den Datentyp jeder in die Daten geladenen Spalte mit dem folgenden Code angeben:
> read_csv("iris.csv", col_types = Liste(
      Kelch.Länge = col_double(),
      Kelch.Breite = col_double(),
      Blütenblatt.Länge = col_double(),
      Blütenblatt.Breite = col_double(),
      Spezies = col_factor(C("seidig", "versicolor", "Virginia"))
))
Aber trotzdem, wenn Sie unwichtige Spalten überspringen, kümmert sich automatisch darum. Dann, der obige Code kann auch umgeschrieben werden als:
> read_csv("iris.csv", col_types = Liste(
           Spezies = col_factor(C("seidig", "versicolor", "Virginia"))
)
PS – readr hat viele Hilfsfunktionen. Dann, beim Schreiben einer CSV-Datei, Verwenden Sie write_csv en su lugar. Es ist viel schneller als write.csv.
aufgeräumter Pack
Dieses Paket kann Ihre Daten aussehen lassen „organisiert“. Verfügt über 4 Hauptfunktionen, um diese Aufgabe auszuführen. Es versteht sich von selbst, dass, wenn Sie in der Phase der Datenexploration stecken bleiben, Sie können sie jederzeit verwenden (zusammen mit dplyr). Dieses Duo ist ein beeindruckendes Team. Sie sind leicht zu erlernen, codieren und implementieren. Sind 4 Funktionen sind:
- versammeln () – ‚versammelt‘ mehrere Spalten. Später, verwandelt sie in Schlüsselpaare: Wert. Diese Funktion wird von einer breiten Datenform in eine lange Datenform umgewandelt. Sie können es als Alternative zu ‚schmelzen‘ im Umbaupaket.
- Verbreitung (): es ist umgekehrt zu sammeln. Nimm ein Schlüsselpaar: Wert und wandelt ihn in separate Spalten um.
- auseinander brechen (): eine Spalte in mehrere Spalten aufteilen.
- Vereinen (): ist umgekehrt oder getrennt. Verbinden Sie mehrere Spalten zu einer einzigen Spalte
Lassen Sie uns mit dem folgenden Code genau verstehen:
#Paket laden
> Bücherei(aufgeräumter)
#einen Dummy-Datensatz erstellen
> Namen <- C('A','B','C','D','E','A','B')
> Last <- C(55,49,76,71,65,44,34)
> Alter <- C(21,20,25,29,33,32,38)
> Klasse <- C('Mathematik','Naturwissenschaften','Sozial','Physik','Biologie','Wirtschaft','Buchhaltung')
#Datenrahmen erstellen > tdata <- data.frame(Namen, Alter, Last, Klasse) > tdata#Verwenden der Sammelfunktion > lange_t <- tdata%>% versammeln(Taste, Wert, Last:Klasse) > lange_t
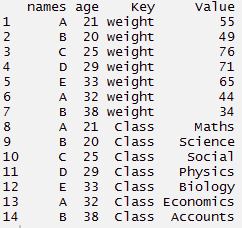
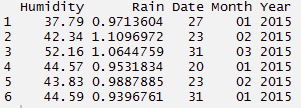
Die separate Funktion wird am besten verwendet, wenn wir eine Datetime-Variable im Datensatz haben. Da die Spalte mehrere Informationen enthält, es ist sinnvoll, es aufzuteilen und diese Werte einzeln zu verwenden. Verwenden des Codes unten, Ich habe eine Spalte im Datum getrennt, Monat und Jahr.
#einen Datensatz erstellen
> Feuchtigkeit <- C(37.79, 42.34, 52.16, 44.57, 43.83, 44.59)
> Regen <- C(0.971360441, 1.10969716, 1.064475853, 0.953183435, 0.98878849, 0.939676146)
> Zeit <- C("27/01/2015 15:44","23/02/2015 23:24", "31/03/2015 19:15", "20/01/2015 20:52", "23/02/2015 07:46", "31/01/2015 01:55")
#einen Datenrahmen erstellen
> d_set <- data.frame(Feuchtigkeit, Regen, Zeit)
#Mit einer separaten Funktion können wir das Datum trennen, Monat, Jahr
> getrennt <- d_set %>% trennen(Zeit, C(Datum, 'Monat','Jahr'))
> getrennt
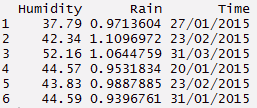
 #Verwenden der Unite-Funktion - Rückseite von getrennt
> vereinigt <- getrennt%>% Vereinen(Zeit, C(Datum, Monat, Jahr), sep = "/")
> vereinigt
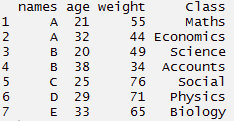
 #mit der Spread-Funktion - Rückwärtskompilierung> wide_t % Verbreitung (Schlüssel, Wert)> wide_t
Schmierpaket
Das Lubridate-Paket reduziert den Aufwand bei der Arbeit mit der Datenzeitvariable in R. Die eingebaute Funktion dieses Pakets bietet eine gute Möglichkeit, die Analyse von Datum und Uhrzeit zu erleichtern. Dieses Paket wird häufig mit Daten verwendet, die Punktdaten umfassen. Hier habe ich drei grundlegende Aufgaben behandelt, die mit Lubridate durchgeführt wurden.
Dazu gehört die Update-Funktion, Dauerfunktion und Datumsextraktion. Als Anfänger, kenne diese 3 Funktionen geben Ihnen genug Erfahrung, um mit Zeitvariablen umzugehen. Selbst wenn, R verfügt über integrierte Funktionen zur Verarbeitung von Datumsangaben, aber das geht viel schneller. Lassen Sie uns den folgenden Code verstehen:
> install.pakete('lubridate')
> Bücherei(schmieren)
#aktuelles Datum und Uhrzeit
> jetzt()
[1] "2015-12-11 13:23:48 IST"
#Zuweisen von aktuellem Datum und Uhrzeit zur Variablen n_time
> n_time <- jetzt()
#mit Update-Funktion
> n_update <- aktualisieren(n_time, Jahr = 2013, Monat = 10)
> n_update
[1] "2013-10-11 13:24:28 IST"
#Tage hinzufügen, Monate, Jahr, Sekunden
> d_time <- jetzt()
> d_time + Tage(1)
[1] "2015-12-12 13:24:54 IST"
> d_time + dWochen(2)
[1] "2015-12-12 13:24:54 IST"

> d_time + Färber(3)
[1] "2018-12-10 13:24:54 IST"

> d_time + dhours(2)
[1] "2015-12-11 15:24:54 IST"

> d_time + Minuten(50)
[1] "2015-12-11 14:14:54 IST"

> d_time + dSekunden(60)
[1] "2015-12-11 13:25:54 IST"
#Datum extrahieren,Zeit
> n_time$hour <- Stunde(jetzt())
> n_time$minute <- Minute(jetzt())
> n_time$Sekunde <- Sekunde(jetzt())
> n_time$Monat <- Monat(jetzt())
> n_time$Jahr <- Jahr(jetzt())
#Überprüfen Sie die extrahierten Daten in separaten Spalten
> neue Daten <- data.frame(n_time$hour, n_time$minute, n_time$Sekunde, n_time$Monat, n_time$Jahr)
> neue Daten
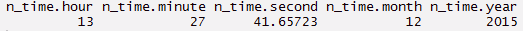
Notiz: Der beste Einsatz dieser Pakete ist nicht isoliert, sondern zusammen. Sie können dieses Paket ganz einfach mit dplyr verwenden, wo Sie einfach eine Datenvariable auswählen und die nützlichen Daten mit dem String-Befehl daraus extrahieren können.
Abschließende Anmerkungen
Diese Pakete würden nicht nur Ihre Datenbearbeitungserfahrung verbessern, sie würden dir auch Gründe geben, R eingehend zu erkunden. Jetzt haben wir es gesehen, Diese Pakete erleichtern die Codierung in R. Keine Notwendigkeit mehr, lange Codes zu schreiben. Stattdessen, Shortcodes schreiben und mehr tun.
Jedes Paket verfügt über Multitasking-Fähigkeiten. Deswegen, Ich schlage vor, Sie erhalten eine wichtige Funktion, die häufig verwendet werden kann. Ja, sobald du sie kennengelernt hast, du kannst tiefer gehen. Ich habe diesen Fehler anfangs gemacht. Ich habe versucht, alle Funktionen von ggplot2 zu erkunden und bin in Verwirrung geraten. Ich schlage vor, Sie üben diese Codes beim Lesen. Dies würde Ihnen helfen, Vertrauen in die Verwendung dieser Pakete aufzubauen..
In diesem Artikel, Ich habe die Verwendung von Paketen erklärt 7 R, das die Datenexploration einfacher und schneller machen kann. R bekannt für seine unglaublichen statistischen Funktionen, mit kürzlich aktualisierten Paketen, macht es auch zu einem beliebten Tool von Data Scientists.





