
Dieser Artikel wurde im Rahmen der Data Science Blogathon
Die Maschinen, die Sprache verstehen, faszinieren mich, und ich überlege oft, mit welchen Algorithmen Aristoteles sich angewöhnt hätte, eine rhetorische Analysemaschine zu bauen, wenn er die Chance gehabt hätte. Wenn Sie neu in der Datenwissenschaft sind, Der Einstieg in NLP kann kompliziert erscheinen, zumal es in letzter Zeit viele Fortschritte auf diesem Gebiet gibt. Es ist schwer zu verstehen, wo man anfangen soll.
Inhaltsverzeichnis
1. Was können Maschinen verstehen?
2.Projekt 1: Wortwolke
3.Projekt 2: Spam-Erkennung
4.Projekt 3: Stimmungsanalyse
5. Fazit
Was können Maschinen verstehen?
Während ein Computer ziemlich gut darin sein kann, Muster zu finden und Dokumente zusammenzufassen, müssen Wörter in Zahlen umwandeln, bevor sie einen Sinn ergeben. Diese Transformation ist sehr notwendig, da die Mathematik mit Wörtern und Maschinen nicht sehr gut funktioniert. „Sie lernen“ dank mathe. Vor der Umwandlung von Wörtern in Zahlen, Datenbereinigung ist erforderlich. Die Datenbereinigung umfasst das Entfernen von Satzzeichen und Sonderzeichen und deren Modifizierung, um sie konsistenter und interpretierbarer zu machen.
Projekt 1: Wortwolke
1.Abhängigkeiten und Datenimport
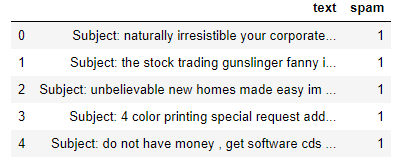
Beginnen Sie mit dem Importieren der Abhängigkeiten und Daten. Die Daten werden als kommagetrennte Wertedatei gespeichert (CSV), Also werde ich Pandas benutzen ‚ read_csv () Funktion zum Öffnen in einem DataFrame.
Pandas als pd importieren
sqlite3 importieren
Regex als re importieren
import matplotlib.pyplot als plt
aus Wordcloud importieren WordCloud
#Datenrahmen aus CSV erstellen
df = pd.read_csv('emails.csv')
df.kopf()
df.kopf()

2.Explorative Analyse
So entfernen Sie doppelte Zeilen und legen einige Grundlinienzählungen fest, es ist besser, eine schnelle Analyse der Daten durchzuführen. Hier verwenden wir pandas drop_duplicates, um doppelte Zeilen zu entfernen.
drucken("Spam-Anzahl: " +str(len(df.loc[df.spam==1])))
drucken("nicht Spam zählen: " +str(len(df.loc[df.spam==0])))
drucken(df.shape)
df['spam'] = df['spam'].astyp(int)
df = df.drop_duplicates()
df = df.reset_index(Inplace = Falsch)[['text','spam']]
drucken(df.shape)
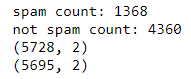
Zählt und formt vorher / nach der Deduplizierung
Was ist eine Wortwolke?
Wortwolken machen es einfach, die Häufigkeiten von Wörtern zu verstehen, Es ist also eine nützliche Möglichkeit, Textdaten zu visualisieren. Die Wörter, die in der Cloud am größten erscheinen, sind diejenigen, die am häufigsten im Text der E-Mail vorkommen. Wortwolken erleichtern die Identifizierung „Schlüsselwörter“.
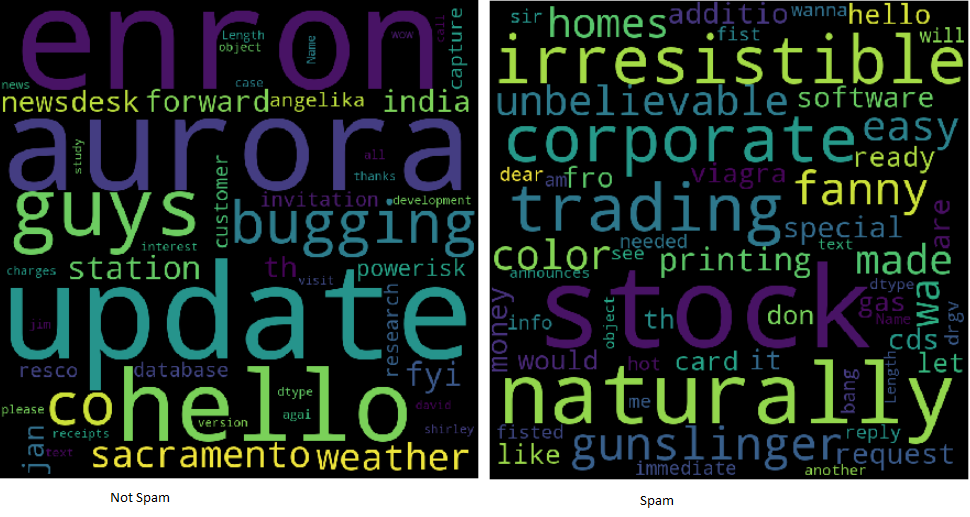
Beispiele für Wortwolken
Der gesamte Text ist im Wortwolkenbild in Kleinbuchstaben. Enthält keine Satz- oder Sonderzeichen. Der Text heißt jetzt sauber und kann analysiert werden. Mit Hilfe von regulären Ausdrücken, Es ist einfach, den Text mit einer Schleife zu reinigen:
clean_desc = []
für w im Bereich(len(df.text)):
   desc = df['text'][w].untere()
   #Satzzeichen entfernen
   desc = re.sub('[^ a-zA-Z]', 'Review', Beschreibung)
   #Tags entfernen
   desc=re.sub("</?.*?>"," <> ",Beschreibung)
   #Ziffern und Sonderzeichen entfernen
   desc=re.sub("(D|W)+"," ",Beschreibung)
   clean_desc.append(Beschreibung)
#Ordnen Sie die bereinigten Beschreibungen dem Datenrahmen zu
df['text'] = clean_desc
df.kopf(3)
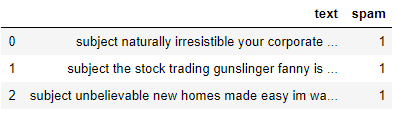
Beachten Sie, dass wir hier eine leere Liste erstellen clean_desc, dann verwenden wir a in Schleife um den Text Zeile für Zeile zu überprüfen, auf Kleinbuchstaben setzen, Satz- und Sonderzeichen entfernen und zur Liste hinzufügen. Dann ersetzen wir die Textspalte durch die Daten in der clean_desc-Liste.
Für Worte
Stoppwörter sind die häufigsten Wörter wie „das“ Ja „von“. Wenn Sie sie aus dem E-Mail-Text entfernen, können die am häufigsten vorkommenden Wörter quadriert werden. Das Eliminieren von Stoppwörtern kann eine gängige Technik sein!! Einige Python-Bibliotheken wie NLTK sind mit einer Stoppwortliste vorinstalliert, aber es ist einfach, einen von Grund auf neu zu formen.
stop_words = ['is','you','your','and', 'the', 'to', 'from', 'or', 'I', 'for', 'do', 'get', 'not', 'here', 'in', 'im', 'have', 'on', 're', 'new', 'subject']
Bitte beachten Sie, dass ich einige E-Mail-bezogene Wörter einfüge, Was „betreffend“ Ja „Affäre“. Es liegt am Analytiker, zu sehen, welche Wörter eingeschlossen oder ausgeschlossen werden sollen. Manchmal ist es von Vorteil, alle Wörter zu integrieren!
Bilde das Wort könnte
Bequem, Es gibt eine Python-Bibliothek zum Erstellen von Wortwolken. Es wird mit pip . installiert.
pip installiere Wordcloud
Beim Aufbau der Wortwolke, es posible alinear varios ParameterDas "Parameter" sind Variablen oder Kriterien, die zur Definition von, ein Phänomen oder System zu messen oder zu bewerten. In verschiedenen Bereichen wie z.B. Statistik, Informatik und naturwissenschaftliche Forschung, Parameter sind entscheidend für die Etablierung von Normen und Standards, die die Datenanalyse und -interpretation leiten. Ihre richtige Auswahl und Handhabung sind entscheidend, um genaue und relevante Ergebnisse in jeder Studie oder jedem Projekt zu erhalten.... como alto y ancho, leere Worte und maximale Worte. es ist sogar möglich, es zu formen, anstatt das Standardrechteck anzuzeigen.
Wortwolke = Wortwolke(Breite = 800, Höhe = 800, background_color="Schwarz", stopwords = stop_words, max_words = 1000
                     , min_font_size = 20).generieren(str(df1['text']))
#Plotten Sie die Wortwolke
fig = plt.figur(Feigengröße = (8,8), Gesichtsfarbe = Keine)
plt.imshow(Wortwolke)
plt.achse('off')
plt.zeigen()
Um die Wortwolke zu speichern und anzuzeigen. Matplotlib und show werden verwendet (). Egal ob Spam, ist das Ergebnis aller Aufzeichnungen.
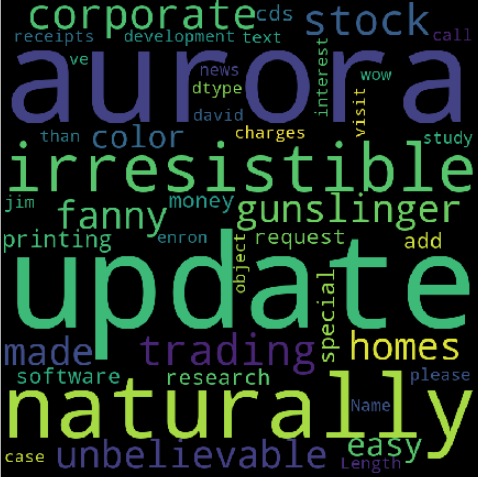
Treiben Sie die Übung noch weiter, indem Sie den Informationsrahmen aufteilen und Zwei-Wort-Wolken erstellen, um den Unterschied zwischen in Spam verwendeten und nicht in Spam verwendeten Schlüsselwörtern zu analysieren..
Projekt 2: Spam-Erkennung
Betrachten Sie es als ein binäres Klassifizierungsproblem, da eine E-Mail Spam sein kann, gekennzeichnet durch „1“ o im Spam gekennzeichnet durch „0“. Ich möchte ein Modell für maschinelles Lernen erstellen, das erkennen kann, ob eine E-Mail Spam sein kann oder nicht. Ich besuche die Python Scikit-Learn-Bibliothek, um die Tokenisierungsalgorithmen zu erkunden, Vektorisierung und statistische Klassifikation.
Abhängigkeiten importieren
Importieren Sie die Funktionalität von Scikit-Learn, die wir ändern möchten und modellieren Sie die Informationen. Ich werde CountVectorizer verwenden, train_test_split, Ensemblemodelle und ein paar Metriken.
aus sklearn.feature_extraction.text import CountVectorizer
aus sklearn.model_selection import train_test_split
von sklearn import ensemble
von sklearn.metrics import Klassifizierung_Bericht, Genauigkeit_Score
Text in Zahlen umwandeln
Im Projekt 1, der text wurde bereinigt. einmal einen Blick auf eine Wortwolke werfen, Beachten Sie, dass dies meist einzelne Wörter sind. Je größer das Wort, je höher seine Frequenz. Um zu verhindern, dass die Wortwolke Sätze erzeugt, der Text durchläuft einen Prozess namens Tokenisierung. ist die Methode, einen Satz in einzelne Wörter zu unterteilen. Einzelne Wörter werden Token genannt.
Mit CountVectorizer () de SciKit-Learn, Es ist einfach, den Textkörper in eine spärliche Zahlenmatrix umzuwandeln, die der Computer an Algorithmen für maschinelles Lernen weitergeben kann. Um das Konzept der Zählvektorisierung zu vereinfachen, stell dir vor du hast zwei sätze:
Der Hund ist weiß
Die Katze ist schwarz
Die Umwandlung der Sätze in ein Vektorraummodell würde sie so transformieren, dass es die Wörter in allen Sätzen betrachtet und dann die Wörter im Satz mit einer Zahl darstellt.
Der Katzenhund ist weiß schwarz
Der Hund ist weiß = [1,1,0,1,1,0]
Die Katze ist schwarz = [1,0,1,1,0,1]
Wir können dies auch mit Code zeigen. Ich füge einen dritten Satz hinzu, um zu zeigen, dass es die Token zählt.
#Liste der Sätze
Text = ["der hund ist weiß", "die Katze ist schwarz", "die katze und der hund sind freunde"]
#die Klasse instanziieren
cv = CountVectorizer()
#Tokenisieren und Vokabeln aufbauen
Lebenslauf(Text)
drucken(cv.vokabular_)
#den Text umwandeln
Vektor = cv.transform(Text)
drucken(vector.toarray())
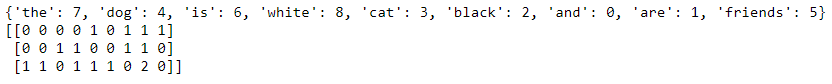
Die spärliche Matrix der Wortzählungen.
Beachten Sie, dass innerhalb des letzten Vektors, du wirst sehen 2 seit dem Wort „das“ erscheint zweimal. CountVectorizer zählt die Token und ermöglicht es mir, das spärliche Array zu erstellen, das die in Zahlen umgewandelten Wörter enthält.
Wortbeutelmethode
Da das Modell die Position der Wörter nicht berücksichtigt und, stattdessen, Er mischt sie wie Chips in einem Scrabble-Spiel, Dies wird oft als Beutel mit Worten Methode bezeichnet. Ich besuche, um die Sparse-Matrix zu erstellen, dann teilen Sie die Informationen mit SK-learn train_test_split ().
text_vec = CountVectorizer().fit_transform(df['text'])
X_Zug, X_test, y_train, y_test = train_test_split(text_vec, df['spam'], test_size = 0.45, random_state = 42, mischen = wahr)
Beachten Sie, dass ich das Sparse-Array text_vec auf X und das df . gesetzt habe['Spam'] Spalte zu Y. Ich schlurfe und nehme eine Testgröße des 45%.
Der Klassifikator
Es wird dringend empfohlen, mit mehreren Klassifikatoren zu experimentieren und festzustellen, welcher für dieses Szenario am besten geeignet ist.. während dieses Beispiels, Ich verwende das GradientBoostingClassifier-Modell () aus der Scikit-Learn Ensemble-Sammlung.
classifier = ensemble.GradientBoostingClassifier(
   n_Schätzer = 100, #wie viele Entscheidungsbäume zu bauen
   Lernrate = 0.5, #Lernrate
   max_tiefe = 6
)
Jeder Algorithmus hat seinen eigenen Parametersatz, den Sie ändern können. das nennt man Hyperparameter-Tuning. Senden Sie die Dokumentation, um mehr über jeden der in den Modellen verwendeten Parameter zu erfahren.
Vorhersagen erstellen
Schließlich, Wir passen die Informationen an, wir rufen vorhersagen auf und generieren den Klassifizierungsbericht. Bei Verwendung von Klassifizierung_Bericht (), einfach einen Textbericht zu erstellen, der die meisten Ranking-Metriken anzeigt.
Klassifikator.fit(X_Zug, y_train)
Vorhersagen = classifier.predict(X_test)
drucken(Klassifizierungsbericht(y_test, Vorhersagen))
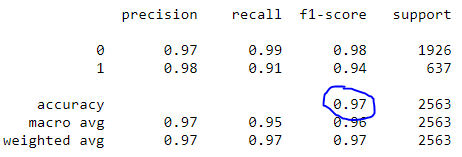
Klassifizierungsbericht
Beachten Sie, dass unser Modell eine Genauigkeit von 97%.
Projekt 3: Stimmungsanalyse
Stimmungsanalyse ist, was ist mehr, eine Art Klassifikationsproblem. Der Text ist im Grunde zu Besuch, um eine positive Stimmung widerzuspiegeln, neutral oder negativ. das fällt durch die Polarität des Textes auf. Es ist auch möglich, die Subjektivität des Textes zu bestimmen und zu erklären! Es gibt viele großartige Ressourcen, die die Spekulationen hinter der Sentimentanalyse abdecken..
Anstatt ein weiteres Modell zu bauen, Dieses Projekt verwendet ein einfaches, sofort einsatzbereites Tool, um die Stimmung namens TextBlob zu untersuchen. Ich werde TextBlob verwenden, um Meinungsspalten im DataFrame darzustellen, damit sie häufig geparst werden.
Was ist TextBlob??
Auf NLTK und Muster aufgebaut, die TextBlob-Bibliothek für Python 2 und drei Versuche, verschiedene Textverarbeitungsaufgaben zu vereinfachen. Bietet Tools für die Klassifizierung, Wortart markieren, Phrasenextraktion, Stimmungsanalyse und mehr. Installieren Sie es mit pip.
pip install -U textblob
python -m textblob.download_corpora
Gefühl von TextBlob
Verwenden der Sentiment-Eigenschaft, TextBlob gibt ein benanntes Tupel der Form Sentiment zurück (Polarität, Subjektivität). Polarität kann innerhalb des Bereichs schweben [-1.0, 1.0] wo -1 ist am negativsten und 1 ist das positivste. Subjektivität könnte in Reichweite schweben [0.0, 1.0] wo 0.0 ist äußerst objektiv und 1.0 es ist extrem subjektiv.
blob = TextBlob("Dies ist ein gutes Beispiel für einen TextBlob")
drucken(Klecks)blob.gefühl
#Gefühl(Polarität=0.7, Subjektivität=0.6000000000000001)
TextBlob anwenden
Bei Verwendung von Verständnislisten, es ist einfach die Textspalte als TextBlob zu laden, Erstellen Sie also zwei neue Spalten, um Polarität und Subjektivität zu speichern.
#lade die beschreibungen in textblob
email_blob = [TextBlob(Text) für Text in df['text']]
#fügen Sie die Sentiment-Metriken zum Datenrahmen hinzu
df['tb_Pol'] = [b.sentiment.polarity für b in email_blob]
df['tb_Subj'] = [b.sentiment.subjectivity für b in email_blob]
#Datenrahmen anzeigen
df.kopf(3)
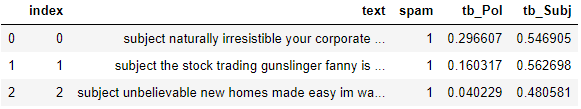
TextBlob macht es sehr einfach, einen grundlegenden Stimmungswert für Polarität und Subjektivität zu erhalten. Um diesen Benutzer noch weiter zu fördern, Sehen Sie, ob Sie diese neuen Funktionen zum Spam-Erkennungsmodell hinzufügen können, um die Genauigkeit zu erhöhen.
Fazit:
Obwohl die sprachliche Kommunikationsverarbeitung ein einschüchterndes Thema sein kann, die grundlegenden stücke scheinen gar nicht so schwer zu verstehen. Viele Bibliotheken erleichtern den Einstieg in Data Science und NLP. Abschluss dieser drei Projekte:
Wortwolke
Spam-Erkennung
Stimmungsanalyse
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





