
Überall fallen Daten in großen Mengen an. Twitter generiert mehr als 12 TB Daten pro Tag, Facebook generiert mehr als 25 TB de datos todos los días y Google genera mucho más que estas cantidades todos los días. Dado que estos datos se producen todos los días, necesitamos crear herramientas para manejar datos con un alto
1. Volumen : En la actualidad se almacenan grandes volúmenes de datos para cualquier industria. Los modelos convencionales con datos tan grandes no son factibles.
2. Geschwindigkeit : Los datos llegan a alta velocidad y exigen algoritmos de aprendizaje más rápidos.
3. Vielfalt : Las diferentes fuentes de datos disponen diferentes estructuras. Todos estos datos contribuyen a el pronóstico. Un buen algoritmo puede absorber tal variedad de datos.
Un algoritmo predictivo simple como Random Forest en aproximadamente 50 mil puntos de datos y 100 dimensiones tarda 10 minutos en ejecutarse en una máquina de 12 GB RAM. Probleme mit Hunderten von Millionen von Beobachtungen sind einfach unmöglich mit dieser Art von Maschinen zu lösen. Deswegen, Uns bleiben nur zwei Optionen: Eine stärkere Maschine zu verwenden oder die Funktionsweise eines Vorhersagealgorithmus zu ändern. Die erste Option ist nicht immer machbar. In diesem Beitrag, Wir werden über Online-Lernalgorithmen lernen, die dafür ausgelegt sind, Daten mit einem so hohen Volumen und hoher Geschwindigkeit auf Maschinen mit begrenzter Leistung zu verarbeiten.
Worin unterscheidet sich das Online-Lernen von Batch-Lernalgorithmen?
Wenn Sie ein Anfänger in der Branche sind AnalyseAnalytics bezieht sich auf den Prozess des Sammelns, Messen und analysieren Sie Daten, um wertvolle Erkenntnisse zu gewinnen, die die Entscheidungsfindung erleichtern. In verschiedenen Bereichen, wie Business, Gesundheit und Sport, Analysen können Muster und Trends erkennen, Prozesse optimieren und Ergebnisse verbessern. Der Einsatz fortschrittlicher Werkzeuge und statistischer Techniken ist unerlässlich, um Daten in anwendbares und strategisches Wissen umzuwandeln...., Alles, von dem Sie wahrscheinlich gehört haben, wird in die Kategorie Batch-Lernen fallen. Versuchen wir uns vorzustellen, worin sich die Funktionsweise der beiden unterscheidet.
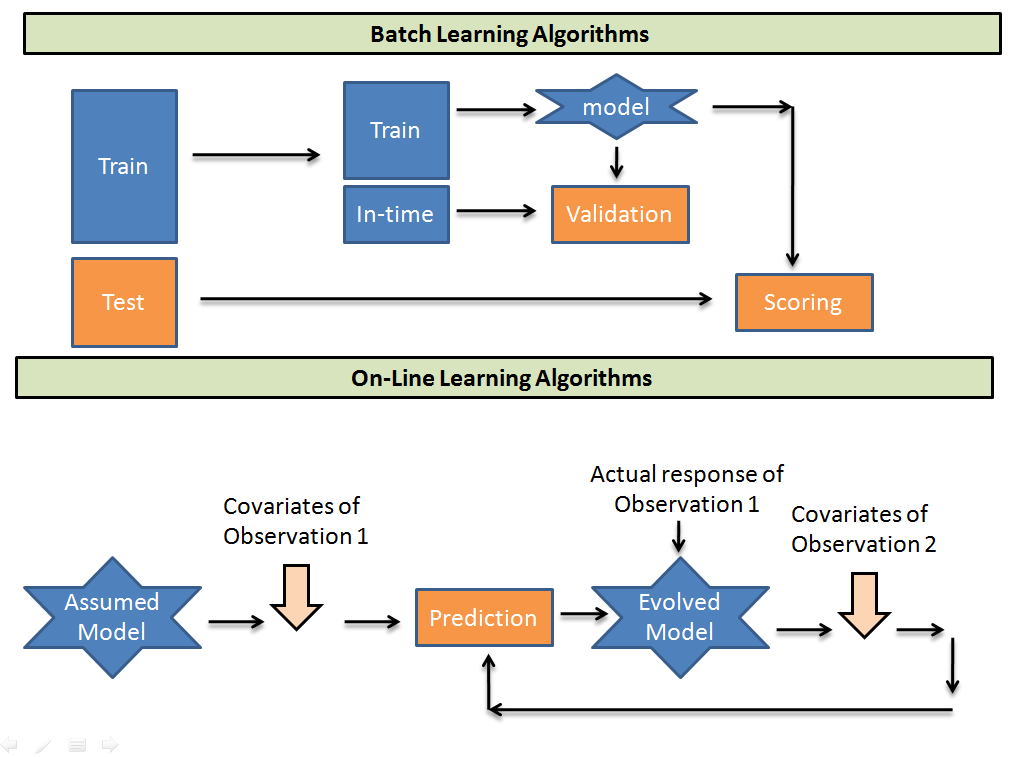
Batch-Lernalgorithmen nehmen Datenpakete von AusbildungTraining ist ein systematischer Prozess zur Verbesserung der Fähigkeiten, körperliche Kenntnisse oder Fähigkeiten. Es wird in verschiedenen Bereichen angewendet, wie Sport, Aus- und Weiterbildung. Zu einem effektiven Trainingsprogramm gehört auch die Zielplanung, Regelmäßiges Üben und Bewerten der Fortschritte. Anpassung an individuelle Bedürfnisse und Motivation sind Schlüsselfaktoren, um in jeder Disziplin erfolgreiche und nachhaltige Ergebnisse zu erzielen.... um ein Modell zu trainieren. Danach sagt es die Testprobe mit der gefundenen Verknüpfung voraus. Bedenkt, dass, Online-Lernalgorithmen nehmen ein Anfangsmodell an Vermutungen und betrachten dann Beobachtungen einzeln aus der Trainingspopulation und passen die Gewichte jedes Eingabeparameters an. Hier sind einige Abwägungen bei der Verwendung der beiden Algorithmen.
- Rechnerisch viel schneller und speichereffizienter. Im Online-Modell, ist es möglich, genau einen Durchgang durch Ihre Daten zu machen, daher sind diese Algorithmen in der Regel viel schneller als ihre Batch-Lern-Äquivalente, da die meisten Batch-Lernalgorithmen mehrfach durchlaufen werden. Zur selben Zeit, da es seine vorherigen Beispiele nicht erneut betrachten kann, speichert sie in der Regel nicht, um sie später im Lernprozess wieder zu verwenden, was bedeutet, dass tendenziell ein kleinerer Speicherbedarf besteht.
- In der Regel ist es einfacher umzusetzen. Da das Online-Modell dazu führt, dass man die Daten durchläuft, verarbeiten wir am Ende ein Beispiel nach dem anderen, nacheinander, wenn sie aus dem Strom eintreffen. Dies vereinfacht den Algorithmus im Allgemeinen, wenn man es von Grund auf macht.
- Schwieriger in der Produktion zu warten. Die Implementierung von Online-Algorithmen in der Produktion erfordert im Allgemeinen, dass ständig Datenpunkte an Ihren Algorithmus weitergegeben werden.. Wenn sich Ihre Daten ändern und Ihre Funktionsselektoren keine nützlichen Ergebnisse mehr liefern., Oder wenn es eine erhebliche Netzwerklatenz zwischen den Servern Ihrer Funktionsselektoren gibt., Oder einer dieser Server ausfällt., oder eigentlich, Jegliche andere Vielzahl von Problemen., Ihr Lernalgorithmus sammelt sich an und Ihre Ausgabe wird unbrauchbar.. Sicherzustellen, dass all dies korrekt funktioniert, kann eine Herausforderung sein..
- Schwieriger online zu prüfen.. Im Online-Lernen., können wir keinen Datensatz zur Verfügung stellen. „Tests“ Zur Evaluierung, da wir keine Verteilungsannahmen treffen.; Wenn wir einen Datensatz für die Prüfung auswählen., estaríamos asumiendo que el conjunto de pruebas es representativo de los datos que estamos operando, y eso es un supuesto distributivo. Angenommen, en el caso más general, no hay forma de obtener un conjunto representativo que caracterice sus datos, su única opción (nochmal, en el caso más general) es simplemente observar qué tan bien ha estado funcionando el algoritmo recientemente.
- Wie gewöhnlich, es más difícil hacerlo „gut“. Como vimos en el último punto, la evaluación en línea del alumno es difícil. Por razones similares, puede resultar muy difícil obtener que el algoritmo se comporte „korrekt“ automáticamente. Puede ser difícil diagnosticar si su algoritmo o su infraestructura se están comportando mal.
En los casos en los que trabajamos con grandes cantidades de datos, Wir haben keine andere Wahl, als Online-Lernalgorithmen zu verwenden. Die einzige andere Alternative besteht darin, ein Batch-Lernen an einer kleineren Stichprobe durchzuführen.
Beispiel zur Verdeutlichung des Konzepts
Wir wollen die Wahrscheinlichkeit vorhersagen, dass es heute regnet. Wir haben ein PanelEin Panel ist eine Gruppe von Experten, die sich trifft, um ein bestimmtes Thema zu diskutieren und zu analysieren. Diese Foren sind bei Konferenzen üblich, Seminare und öffentliche Debatten, wo die Teilnehmer ihr Wissen und ihre Perspektiven teilen. Panels können eine Vielzahl von Bereichen abdecken, Von der Wissenschaft bis zur Politik, Ziel ist es, den Gedankenaustausch und die kritische Reflexion unter den Teilnehmern zu fördern.... von 11 Personen, die die Klasse vorhersagen: Regen und kein Regen in verschiedenen ParameterDas "Parameter" sind Variablen oder Kriterien, die zur Definition von, ein Phänomen oder System zu messen oder zu bewerten. In verschiedenen Bereichen wie z.B. Statistik, Informatik und naturwissenschaftliche Forschung, Parameter sind entscheidend für die Etablierung von Normen und Standards, die die Datenanalyse und -interpretation leiten. Ihre richtige Auswahl und Handhabung sind entscheidend, um genaue und relevante Ergebnisse in jeder Studie oder jedem Projekt zu erhalten..... Wir müssen einen Algorithmus entwerfen, um die Wahrscheinlichkeit vorherzusagen. Zuerst initialisieren wir einige Bezeichnungen.
Ich bin individuelle Prädiktoren
w (ich) ist das Gewicht, das dem i-ten Prädiktor zugewiesen wird
Initial w (ich) für i in [1,11] sind alle 1
Wir werden vorhersagen, dass es heute regnet, wenn,
Summe (w (ich) für alle Regen-Vorhersagen)> Summe (w (ich) für alle Regenlosen-Vorhersagen)
Sobald wir die echte Lösung des VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... Zielsetzung, jetzt senden wir Feedback zu den Gewichten aller Parameter. Unter diesen Umständen werden wir einen sehr einfachen Rückkopplungsmechanismus verwenden. Für jede korrekte Vorhersage, behalten wir das gleiche Gewicht des Prädiktors bei. Während wir für jede falsche Vorhersage, das Gewicht des Prädiktors teilen 1,2 (Lernrate). Im Laufe der Zeit, wir hoffen, dass das Modell mit einem korrekten Parametersatz konvergiert. Wir haben eine Simulation erstellt mit 1000 Vorhersagen, die von jedem der gemacht wurden 11 Prädiktoren. So ist unsere Genauigkeitskurve entstanden,
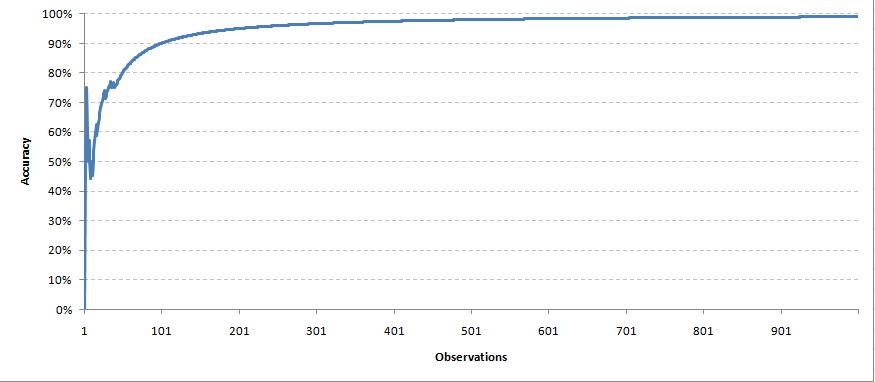
Jede Beobachtung wurde zur gleichen Zeit genommen, um die Gewichte anzupassen. Auf die gleiche Weise, wir werden Vorhersagen für zukünftige Datenpunkte machen.
Abschließende Anmerkungen
Online-Lernalgorithmen werden in der E-Commerce- und Social-Media-Industrie weit verbreitet eingesetzt. Es ist nicht nur schnell, Sino que además tiene la capacidad de capturar cualquier nueva tendencia visible con el tiempo. En este momento se encuentran disponibles una gama de sistemas de retroalimentación y algoritmos convergentes que deben seleccionarse según los requerimientos. En algunos de los siguientes posts, además tomaremos algunos ejemplos prácticos de aplicaciones de algoritmos de aprendizaje en línea.
War der Beitrag hilfreich? ¿Ha utilizado antes algoritmos de aprendizaje en línea? Comparta con nosotros esas experiencias. Teilen Sie uns Ihre Meinung zu diesem Beitrag in der Box unten mit..





