
Überblick:
Dieser KNN-Artikel ist für:
Verstehen Sie die Darstellung und Vorhersage des nächsten K-Algorithmus (KNN).
Verstehen Sie, wie Sie den K-Wert und die Distanzmetrik auswählen.
Erforderliche Datenaufbereitungsmethoden und Vor- und Nachteile des KNN-Algorithmus.
· Python- und Pseudocode-Implementierung.
Einführung:
K El algoritmo del vecino más cercano se incluye en la categoría de überwachtes LernenÜberwachtes Lernen ist ein Ansatz des maschinellen Lernens, bei dem ein Modell mit einem Satz von beschrifteten Daten trainiert wird. Jede Eingabe im Dataset ist mit einer bekannten Ausgabe verknüpft, So kann das Modell lernen, Ergebnisse für neue Eingaben vorherzusagen. Diese Methode wird häufig in Anwendungen wie der Bildklassifizierung eingesetzt., Spracherkennung und Trendvorhersage, und unterstreicht seine Bedeutung in... y se usa para clasificación (häufiger) und Rückschritt. Es ist ein vielseitiger Algorithmus, der auch verwendet wird, um fehlende Werte zu imputieren und Datensätze neu abzutasten.. Wie der Name schon sagt (K nächster Nachbar), Betrachten Sie K nächsten Nachbarn (Datenpunkte) um die Klasse oder den stetigen Wert für den neuen Datenpunkt vorherzusagen.
Das Erlernen des Algorithmus ist:
1. Instanzbasiertes Lernen: aquí no aprendemos ponderaciones de los datos de AusbildungTraining ist ein systematischer Prozess zur Verbesserung der Fähigkeiten, körperliche Kenntnisse oder Fähigkeiten. Es wird in verschiedenen Bereichen angewendet, wie Sport, Aus- und Weiterbildung. Zu einem effektiven Trainingsprogramm gehört auch die Zielplanung, Regelmäßiges Üben und Bewerten der Fortschritte. Anpassung an individuelle Bedürfnisse und Motivation sind Schlüsselfaktoren, um in jeder Disziplin erfolgreiche und nachhaltige Ergebnisse zu erzielen.... para predecir la salida (wie bei modellbasierten Algorithmen), Stattdessen verwenden wir vollständige Trainingsinstanzen, um ungesehene Datenausgaben vorherzusagen.
2. Faules Lernen: das Modell wird vorher nicht anhand von Trainingsdaten gelernt und der Lernprozess wird auf einen Zeitpunkt verschoben, zu dem die Vorhersage in der neuen Instanz angefordert wird.
3. im parametrischen: Ein KNN, es gibt keine vordefinierte Form der Abbildungsfunktion.
Wie funktioniert KNN?
-
Anfang:
Considere la siguiente Abbildung"Abbildung" ist ein Begriff, der in verschiedenen Zusammenhängen verwendet wird, Von der Kunst zur Anatomie. Im künstlerischen Bereich, bezieht sich auf die Darstellung menschlicher oder tierischer Formen in Skulpturen und Gemälden. In der Anatomie, bezeichnet die Form und Struktur des Körpers. Was ist mehr, in der Mathematik, "Abbildung" Es hängt mit geometrischen Formen zusammen. Seine Vielseitigkeit macht es zu einem grundlegenden Konzept in mehreren Disziplinen..... Nehmen wir an, wir haben Datenpunkte aus unserem Trainingsset in einem zweidimensionalen Merkmalsraum geplottet. Wie gezeigt, wir haben insgesamt 6 Datenpunkte (3 Rot und 3 Blau). Los puntos de datos rojos pertenecen a ‚class1‘ y los puntos de datos azules pertenecen a ‚class2‘. Und der gelbe Datenpunkt in einem Feature-Space stellt den neuen Punkt dar, für den eine Klasse vorhergesagt werden soll. Offensichtlich, decimos que pertenece a ‚class1‘ (rote Punkte)
Warum?
Weil Ihre nächsten Nachbarn zu dieser Klasse gehören!!
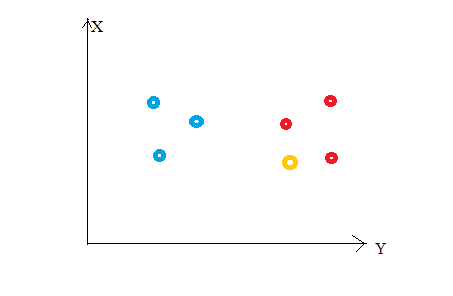
Jawohl, das ist das Prinzip von K Neighbours Neighbours. Hier, die nächsten Nachbarn sind die Datenpunkte, die einen Mindestabstand im Merkmalsraum von unserem neuen Datenpunkt haben. Und K ist die Anzahl der Datenpunkte, die wir bei unserer Implementierung des Algorithmus berücksichtigen. Deswegen, Abstandsmetrik und K-Wert sind zwei wichtige Überlegungen bei der Verwendung des KNN-Algorithmus. Die euklidische Distanz ist die beliebteste Distanzmetrik. Sie können auch die Hamming-Distanz verwenden, die Entfernung von Manhattan, die Minkowski-Distanz nach Ihren Bedürfnissen. Klasse vorhersagen / stetiger Wert für einen neuen Datenpunkt, berücksichtigt alle Datenpunkte im Trainingsdatensatz. Finden Sie die nächsten Nachbarn (Datenpunkte) ‚K‘ der neuen Feature-Space-Datenpunkte und ihrer Klassenbeschriftungen oder stetigen Werte.
Später:
Zur Klassifizierung: eine den K nächsten Nachbarn im Trainingsdatensatz zugewiesene Klassenbezeichnung wird als vorhergesagte Klasse für den neuen Datenpunkt betrachtet.
Für Rückschritte: la media o MedianDer Median ist ein statistisches Maß, das den zentralen Wert eines Satzes geordneter Daten darstellt. Um es zu berechnen, Die Daten werden von der niedrigsten zur höchsten sortiert und die Zahl in der Mitte wird identifiziert. Wenn es eine gerade Anzahl von Beobachtungen gibt, Die beiden Kernwerte werden gemittelt. Dieser Indikator ist besonders nützlich bei asymmetrischen Verteilungen, da es nicht von Extremwerten beeinflusst wird.... de los valores continuos asignados a K vecinos más cercanos del conjunto de datos de entrenamiento es un valor continuo predicho para nuestro nuevo punto de datos
-
Modelldarstellung
Hier, wir lernen die gewichte nicht und speichern sie, vielmehr wird der gesamte Trainingsdatensatz im Speicher abgelegt. Deswegen, die Modelldarstellung für KNN ist der komplette Trainingsdatensatz.
So wählen Sie den Wert von K?
K ist ein entscheidender Parameter im KNN-Algorithmus. Einige Vorschläge zur Auswahl des K-Werts sind:
1. Fehlerkurven verwenden: Die folgende Abbildung zeigt die Fehlerkurven für verschiedene K-Werte für die Trainings- und Testdaten.
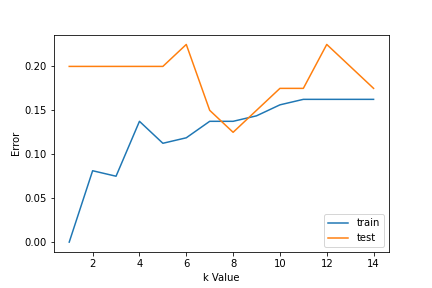
Bei niedrigen K-Werten, es gibt Datenüberanpassung / hohe Varianz. Deswegen, der Testfehler ist hoch und der Zugfehler ist niedrig. Und K = 1 in den Zugdaten, der fehler ist immer null, weil der nächste Nachbar zu diesem Punkt dieser Punkt selbst ist. Deswegen, obwohl der Trainingsfehler gering ist, der Testfehler ist bei niedrigeren K-Werten hoch. Dies wird als Überanpassung bezeichnet.. Wenn wir den Wert von K . erhöhen, Testfehler wird reduziert.
Aber ab einem bestimmten Wert von K, Voreingenommenheit wird eingeführt / Mismatch und Testfehler nehmen zu. Dann, wir können sagen, dass der Fehler der Testdaten anfänglich hoch ist (wegen Abweichung), dann geht es nach unten und stabilisiert sich und mit einem weiteren Anstieg des Wertes von K, erhöht sich wieder (wegen Voreingenommenheit). Der Wert von K, wenn sich der Testfehler stabilisiert und niedrig ist, wird als optimaler Wert für K . angesehen. Aus der obigen Fehlerkurve, wir können K = . wählen 8 für die Implementierung unseres KNN-Algorithmus.
2. Was ist mehr, Die Kenntnis der Domäne ist sehr nützlich, um den K-Wert zu wählen.
3. Der Wert von K muss ungerade sein, wenn die binäre Klassifikation berücksichtigt wird (zwei Klassen).
Erforderliche Datenaufbereitung:
1. Datenskala: um den Datenpunkt im mehrdimensionalen Merkmalsraum zu lokalisieren, es wäre nützlich, wenn alle Funktionen im gleichen Maßstab sind. Deswegen, das StandardisierungNormung ist ein grundlegender Prozess in verschiedenen Disziplinen, , die darauf abzielt, einheitliche Standards und Kriterien zur Verbesserung von Qualität und Effizienz festzulegen. In Kontexten wie dem Ingenieurwesen, Bildung und Verwaltung, Standardisierung erleichtert den Vergleich, Interoperabilität und gegenseitiges Verständnis. Bei der Implementierung von Standards, Der Zusammenhalt wird gefördert und die Ressourcen werden optimiert, die zu einer nachhaltigen Entwicklung und zur kontinuierlichen Verbesserung der Prozesse beiträgt.... o estandarización de los datos ayudará.
2. Dimensionsreduktion: KNN funktioniert möglicherweise nicht gut, wenn zu viele Funktionen vorhanden sind. Deswegen, Dimensionsreduktionstechniken wie Merkmalsauswahl und Hauptkomponentenanalyse können implementiert werden.
3. Behandlung von fehlenden Werten: wenn von M Merkmalen Daten zu einem Merkmal für ein bestimmtes Beispiel im Trainingsset fehlen, dann können wir die Entfernung von diesem Punkt nicht lokalisieren oder berechnen. Deswegen, es ist notwendig, diese Zeile oder Imputation zu löschen.
Python-Implementierung:
K Implementierung des Nearest Neighbor-Algorithmus mit Pythons Scikit-Learn-Bibliothek:
Paso 1: Daten beschaffen und aufbereiten
Pandas als pd importieren
numpy als np importieren
import matplotlib.pyplot als plt
aus sklearn.datasets import make_classification
aus sklearn.model_selection import train_test_split
aus sklearn.preprocessing importieren StandardScaler
von sklearn.neighbors importieren KNeighborsClassifier
von sklearn Importmetriken
Nach dem Laden wichtiger Bibliotheken, Wir erstellen unsere Daten mit sklearn.datasets mit 200 Proben, 8 Eigenschaften und 2 Lektionen. Später, die Daten werden auf den Zug aufgeteilt (80%) und Testdaten (20%) und werden mit StandardScaler . skaliert.
x,Y=make_classification(n_samples= 200,n_features=8,n_informative=8,n_redundant=0,n_repeated=0,n_classes=2,random_state=14)
X_Zug, X_test, y_train, y_test = train_test_split(x, Ja, test_size= 0.2,random_state=32)
sc= StandardSkalierer()
sc.fit(X_Zug)
X_train= sc.transform(X_Zug)
sc.fit(X_test)
X_test= sc.transform(X_test)
X.Form
(200, 8)
Paso 2: Finden Sie den Wert von K
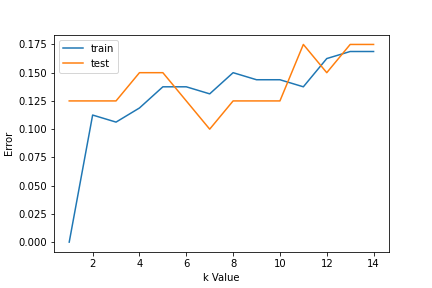
So wählen Sie den K-Wert, wir verwenden Fehlerkurven und K-Werte mit optimaler Varianz, und der Bias-Fehler wird zu Vorhersagezwecken als K-Wert gewählt. Mit der unten aufgetragenen Fehlerkurve, wir wählen K = 7 zur Vorhersage
error1= []
error2= []
für k im Bereich(1,15):
    knn=KNeighborsClassifier(n_nachbarn=k)
    knn.fit(X_Zug,y_train)
    y_pred1= knn.predict(X_Zug)
    error1.append(np.mean(y_train!= y_pred1))
    y_pred2= knn.predict(X_test)
    error2.append(np.mean(y_test!= y_pred2))
# plt.figur(Feigengröße(10,5))
plt.plot(Bereich(1,15),error1,label="Bahn")
plt.plot(Bereich(1,15),error2,label="Prüfung")
plt.xlabel('k Value')
plt.ylabel('Error')
plt.legende()
Paso 3: Vorhersagen:
Im Schritt 2, wir haben gewählt, dass der Wert von K 7. Jetzt ersetzen wir diesen Wert und erhalten den Präzisionswert = 0,9 für Testdaten.
knn=KNeighborsClassifier(n_nachbarn=7)
knn.fit(X_Zug,y_train)
y_pred= knn.predict(X_test)
metrics.accuracy_score(y_test,y_pred)
0.9
Pseudocode für K Nächster Nachbar (Einstufung):
Dies ist ein Pseudocode, um den KNN-Algorithmus von Grund auf neu zu implementieren:
- Trainingsdaten laden.
- Bereiten Sie die Daten mit der Waage vor, Behandlung fehlender Werte und Reduzierung der Dimensionalität nach Bedarf.
- Finden Sie den optimalen Wert für K:
- Einen Klassenwert für neue Daten vorhersagen:
- Berechnen Sie die Entfernung (x, Xi) von i = 1,2,3,…., n.
wobei X = neuer Datenpunkt, Xi = Trainingsdaten, Entfernung basierend auf gewählter Entfernungsmetrik. - Ordnen Sie diese Entfernungen in aufsteigender Reihenfolge mit den entsprechenden Zugdaten.
- Aus dieser geordneten Liste, seleccione las filas ‚K‘ Vorgesetzter.
- Encuentre la clase más frecuente de estas filas ‚K‘ gewählt. Das wird dein geplanter Kurs.
- Berechnen Sie die Entfernung (x, Xi) von i = 1,2,3,…., n.
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





