
Steigern Sie den Algorithmus beim maschinellen Lernen
Impuls kann eine Menge von Algorithmen genannt werden, deren Hauptfunktion ist es, aus schwachen Schülern starke Schüler zu machen. Sie sind Mainstream geworden Datenwissenschaftsbranche weil sie in der Machine-Learning-Community im Laufe der Jahre. Der Impuls wurde zuerst eingegeben von Freund und Schapire im Jahr 1997 mit seinem Algorithmus AdaBoost, und seitdem, Impuls war eine vorherrschende Technik zum Lösen Probleme bei der binären Klassifikation.
Warum sind Boost-Algorithmen so beliebt??
Um das zu wissen, in einfacheren Worten. Boost-Algorithmen kann einfachere Algorithmen wie . übertreffen Zufälliger Wald, Entscheidungsbäume oder logistische Regression. Dies ist einer der Hauptgründe für die zunehmende Förderung von Algorithmen durch viele Konkurrenten des maschinellen Lernens aufgrund der Tatsache, dass Impulsalgorithmen leistungsstark sind.. Auch so, kann verbessern Vorhersagegenauigkeit Ihres Modells durch eine beträchtliche Anzahl von Faktoren. Viele Wettbewerber für maschinelles Lernen verwenden einen einzelnen Boost-Algorithmus oder mehrere Boost-Algorithmen, um die jeweiligen Probleme zu lösen.
Impulsalgorithmus erklärt
Impuls kombiniere schwache Schüler zu einem starken Schüler, wo ein schwacher Lerner setzt einen Klassifikator, der leicht mit der tatsächlichen Klassifizierung korreliert. Im Gegensatz zu einem schwachen Schüler, Ein starker Lerner ist ein Klassifikator, der den richtigen Kategorien zugeordnet ist.
Um das zu wissen, lass uns ein Szenario annehmen:
Angenommen, Sie bauen a Zufälliges Waldmodell das gibt Ihnen eine Genauigkeit von 75% im Validierungsdatensatz und, dann, beschließen, ein anderes Modell mit demselben Datensatz zu testen. Angenommen, Sie versuchen linear Regressionsmodell und kNN auf demselben Validierungsdatensatz, und jetzt gibt Ihnen Ihr Modell eine Genauigkeit von 69% Ja 92%, beziehungsweise. Es ist klar, dass die drei Modelle auf völlig unterschiedliche Weise funktionieren und absolut unterschiedliche Ergebnisse auf demselben Datensatz liefern..
Hast du jemals gedacht, anstatt nur eines dieser Modelle zu verwenden, Was wäre, wenn wir eine Kombination all dieser Modelle verwenden, um die endgültigen Vorhersagen zu treffen??
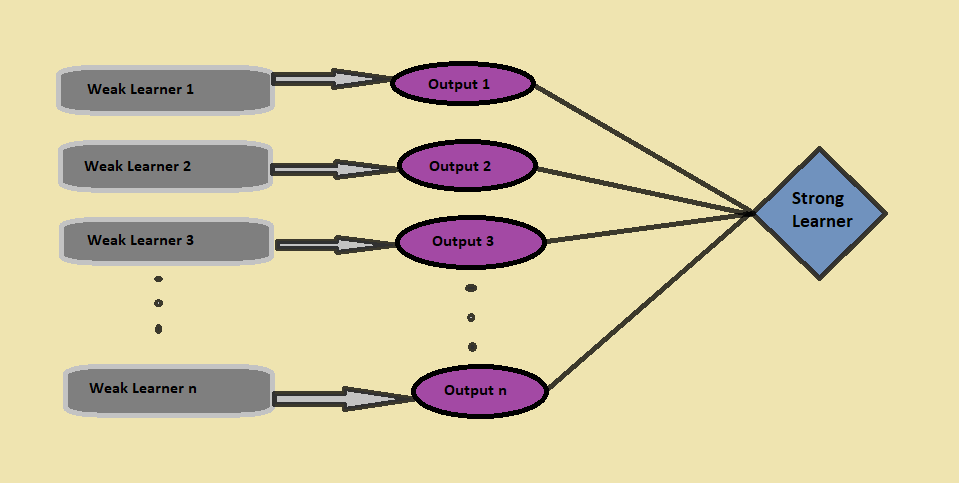
Wir werden mehr Informationen aus den Daten gewinnen, indem wir den Durchschnitt der Vorhersagen aus diesen Modellen nehmen.; Äquivalent, der Boost-Algorithmus kombiniert mehrere einfachere Modelle (auch schwache Schüler genannt) um das Endergebnis zu generieren (auch starker Schüler genannt).
Würden Sie jetzt darüber nachdenken, wie man schwache Schüler erkennt??
Um schwache Schüler zu identifizieren, wir gebrauchen Algorithmen für maschinelles Lernen mit einer anderen Verteilung für jede Iteration und für jeden Algorithmus, erzeugt eine neue schwache Vorhersageregel. Nach vielen Iterationen, Der Boost-Algorithmus kombiniert alle anfälligen Lernenden, um eine Einzelkettenvorhersageregel zu bilden.
Eine weitere wichtige Sache, auf die Sie hier achten sollten, ist, ‚Wie bestimmen wir eine unterschiedliche Verteilung für jede Runde?‘
Es gibt drei Schritte, die wir berücksichtigen müssen, um die richtige Verteilung auszuwählen:
- Der schwache Schüler betrachtet alle Verteilungen und weist dann jeder Beobachtung das gleiche Gewicht zu, nach
- Wenn der Fehler durch die Vorhersage des ersten schwachen Lernalgorithmus erzeugt wird, dem Vorhersagefehler der Beobachtungen wird mehr Aufmerksamkeit geschenkt. Es gilt der folgende schwache Lernalgorithmus.
- Schließlich, Wiederholen Sie den zweiten Schritt, bis der Basislernalgorithmus seine Grenze erreicht oder die gewünschte Genauigkeit erreicht ist.
Schließlich, während, der Boost-Algorithmus kombiniert alle schwachen Schülerausgaben. Präsentiert mit einem stärkeren und stärkeren Schüler, was letztendlich die Genauigkeit der Modellvorhersage verbessert (wie in der Abbildung"Abbildung" ist ein Begriff, der in verschiedenen Zusammenhängen verwendet wird, Von der Kunst zur Anatomie. Im künstlerischen Bereich, bezieht sich auf die Darstellung menschlicher oder tierischer Formen in Skulpturen und Gemälden. In der Anatomie, bezeichnet die Form und Struktur des Körpers. Was ist mehr, in der Mathematik, "Abbildung" Es hängt mit geometrischen Formen zusammen. Seine Vielseitigkeit macht es zu einem grundlegenden Konzept in mehreren Disziplinen.... anterior).
Durch Boosten, anstatt nur die isolierten Klassifikatoren zu kombinieren, verwendet den Mechanismus zum Erhöhen der Gewichte von falsch klassifizierten Datenpunkten in den obigen Klassifikatoren.
Typen von ImpulsalgorithmenS
Es ist jetzt an der Zeit, einige der wesentlichen Arten von Impulsalgorithmen zu diskutieren.
1. Zunahme von SteigungGradient ist ein Begriff, der in verschiedenen Bereichen verwendet wird, wie Mathematik und Informatik, um eine kontinuierliche Variation von Werten zu beschreiben. In Mathematik, bezieht sich auf die Änderungsrate einer Funktion, während des Studiums im Grafikdesign, Gilt für den Farbübergang. Dieses Konzept ist unerlässlich, um Phänomene wie die Optimierung von Algorithmen und die visuelle Darstellung von Daten zu verstehen, ermöglicht eine bessere Interpretation und Analyse in...
Im Steigung erhöhen Algorithmus, wir trainieren mehrere Modelle nacheinander, und für jedes neue Modell, das Modell minimiert nach und nach die Verlust-FunktionDie Verlustfunktion ist ein grundlegendes Werkzeug des maschinellen Lernens, das die Diskrepanz zwischen Modellvorhersagen und tatsächlichen Werten quantifiziert. Ziel ist es, den Trainingsprozess zu steuern, indem dieser Unterschied minimiert wird, Dadurch kann das Modell effektiver lernen. Es gibt verschiedene Arten von Verlustfunktionen, wie z. B. mittlerer quadratischer Fehler und Kreuzentropie, jeder für unterschiedliche Aufgaben geeignet und... unter Verwendung der Methode des Gradientenabstiegs. das Algorithmus zur Gradientenbaum-Erweiterung Sie akzeptieren Entscheidungsbäume wie der schwache dünn weil die Knoten in einem Entscheidungsbaum einen anderen Merkmalszweig berücksichtigen, um die beste Unterteilung zu wählen, was bedeutet, dass nicht alle Bäume gleich sind. Deswegen, kann ständig verschiedene Datenausgaben erfassen.
Der Algorithmus zur Erweiterung des Gradientenbaums wird sequentiell aufgebaut, weil, für jeden neuen Baum, das Modell berücksichtigt die Fehler des letzten Baums, und die Entscheidung jedes nachfolgenden Baums basiert auf den Fehlern des vorherigen Baums.
Gradient Boosting-Algorithmen werden hauptsächlich für Klassifikations- und Regressionsprobleme verwendet.
Python-Code:
from sklearn.ensemble importar GradientBoostingClassifier #Zur Klassifizierung
from sklearn.ensemble import GradientBoostingRegressor #Für Rückschritte
cl = GradientBoostingClassifier (n_Schätzer = 100, Lernrate = 1.0, max_tiefe = 1)
kl.fit (Xtrain, ytrain)
wo:
n_Schätzer Der Parameter wird verwendet, um die Anzahl der schwachen Schüler zu steuern,
Lernrate Der Parameter steuert den Beitrag aller gefährdeten Schüler zum Endergebnis,
Maximale Tiefe Der Parameter ist für die maximale Tiefe der einzelnen Regressionsschätzer, um die Anzahl der Knoten im Baum zu begrenzen.
2. AdaBoost (adaptive Verstärkung)
Der AdaBoost-Algorithmus, kurz für Adaptiver Antrieb, ist eine Boost-Technik im maschinellen Lernen, die als Methode einstellen. In Adaptiver Antrieb, alle Gewichte werden jeder Instanz neu zugewiesen, wenn falsch klassifizierten Modellen höhere Gewichte zugewiesen werden, und passt die Reihenfolge der schwachen Schüler mit unterschiedlichen Gewichten.
Adaboost beginnt mit Vorhersagen über den Originaldatensatz im Klartext treffen, und geben Sie dann jeder Beobachtung das gleiche Gewicht. Wenn die Prognose mit dem ersten Schüler falsch ist, weist die zu höhere Relevanz für falsch vorhergesagte Aussage und iteratives Vorgehen. Fügen Sie weitere Schüler hinzu, bis das Limit im Modell erreicht ist.
Wir können jeden Machine-Learning-Algorithmus mit Adaboost als schwachen Lernenden verwenden, wenn er Gewichte im Datensatz akzeptiert AusbildungTraining ist ein systematischer Prozess zur Verbesserung der Fähigkeiten, körperliche Kenntnisse oder Fähigkeiten. Es wird in verschiedenen Bereichen angewendet, wie Sport, Aus- und Weiterbildung. Zu einem effektiven Trainingsprogramm gehört auch die Zielplanung, Regelmäßiges Üben und Bewerten der Fortschritte. Anpassung an individuelle Bedürfnisse und Motivation sind Schlüsselfaktoren, um in jeder Disziplin erfolgreiche und nachhaltige Ergebnisse zu erzielen.... und wird sowohl für Regressions- als auch für Klassifikationsprobleme eingesetzt.
Python-Code:
from sklearn.ensemble import AdaBoostClassifier #Zur Klassifizierung
from sklearn.ensemble import AdaBoostRegressor #For Regression
aus sklearn.tree import DecisionTreeClassifier
dtree = DecisionTreeClassifier ()
cl = AdaBoostClassifier (n_Schätzer = 100, base_estimator = dtree, Lernrate = 1)
kl.fit (xtrain, ytrain)
wo:
n_Schätzer und der Parameter learning_rate hat den gleichen Zweck wie im Fall des Gradient Boosting-Algorithmus,
base_estimator Der Parameter hilft, verschiedene Algorithmen für maschinelles Lernen zu spezifizieren.
3. XGBoost
Der XGBoost-Algorithmus, Abkürzung für Extreme Gradient Boosting, Es ist einfach eine improvisierte Version des Algorithmus zur Erhöhung der Steigung, und die Arbeitsweise beider ist fast gleich. Ein entscheidender Punkt in XGBoost ist dass Implementiert parallele Verarbeitung auf Ebene von KnotenNodo ist eine digitale Plattform, die die Verbindung zwischen Fachleuten und Unternehmen auf der Suche nach Talenten erleichtert. Durch ein intuitives System, Ermöglicht Benutzern das Erstellen von Profilen, Erfahrungen austauschen und Zugang zu Stellenangeboten erhalten. Der Fokus auf Zusammenarbeit und Networking macht Nodo zu einem wertvollen Werkzeug für diejenigen, die ihr berufliches Netzwerk erweitern und Projekte finden möchten, die mit ihren Fähigkeiten und Zielen übereinstimmen...., Dadurch ist es leistungsstärker und schneller als der Algorithmus zur Erhöhung des Gradienten.. XGBoost reduziert Overfitting und verbessert die Gesamtleistung durch die Einbeziehung verschiedener Techniken von RegulierungDie Regularisierung ist ein administrativer Prozess, der darauf abzielt, die Situation von Personen oder Organisationen zu formalisieren, die außerhalb des gesetzlichen Rahmens tätig sind. Dieses Verfahren ist unerlässlich, um Rechte und Pflichten zu gewährleisten, sowie zur Förderung der sozialen und wirtschaftlichen Inklusion. In vielen Ländern, Die Regularisierung wird in Migrationskontexten angewendet, Arbeit und Steuern, denjenigen, die sich in irregulären Situationen befinden, den Zugang zu Leistungen zu ermöglichen und sich vor möglichen Sanktionen zu schützen.... durch das Festlegen der Hyperparameter des XGBoost-Algorithmus.
Ein wichtiger Punkt, auf den Sie achten sollten XGBoost ist dass Sie müssen sich keine Sorgen um fehlende Werte im Datensatz machen, weil, während des gesamten Trainingsablaufs, das Modell selbst lernt, wo fehlende Werte eingefügt werden müssen, Mit anderen Worten, der linke Knoten oder der rechte Knoten.
XGBoost wird hauptsächlich für Sortierprobleme verwendet, kann aber für Regressionsprobleme verwendet werden.
Python-Code:
xgboost als xgb importieren
xgb_model = xgb.XGBClassifier (Lernrate = 0,001, max_tiefe = 1, n_estimators_100)
xbg_model.fit (x_train, y_train)
SCHLUSSBEMERKUNGEN
Dieser Beitrag befasste sich mit Impulsalgorithmen im maschinellen Lernen, erklärt, was Boost-Algorithmen und Arten von Boost-Algorithmen sind: Adaboost, Gradient Boosting y XGBoost. Außerdem betrachten wir ihre jeweiligen Codes und ParameterDas "Parameter" sind Variablen oder Kriterien, die zur Definition von, ein Phänomen oder System zu messen oder zu bewerten. In verschiedenen Bereichen wie z.B. Statistik, Informatik und naturwissenschaftliche Forschung, Parameter sind entscheidend für die Etablierung von Normen und Standards, die die Datenanalyse und -interpretation leiten. Ihre richtige Auswahl und Handhabung sind entscheidend, um genaue und relevante Ergebnisse in jeder Studie oder jedem Projekt zu erhalten.... von Python beteiligt.
Wenn Sie Zweifel haben, Sie erreichen mich auf meinem LinkedIn @Mrinalwalia.
Die in diesem Beitrag gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





