
Dieser Artikel wurde im Rahmen der Data Science Blogathon.
Einführung
Künstliche Intelligenz hat sich enorm verbessert, ohne dass die zugrunde liegende Hardware-Infrastruktur geändert werden musste. Benutzer können ein KI-Programm auf einem alten Computersystem ausführen. Zweitens, Der Nutzen von maschinellem Lernen ist unbegrenzt. Die Verarbeitung natürlicher Sprache ist einer der Zweige der künstlichen Intelligenz, der Maschinen die Fähigkeit gibt zu lesen, zu verstehen und Bedeutung zu liefern. Die NLU war im Gesundheitswesen sehr erfolgreich, die Medien, die Finanzen und das Personalwesen.
Die gebräuchlichste Form unstrukturierter Daten sind Texte und Reden. Sie ist reichlich vorhanden, aber es ist schwierig, nützliche Informationen zu extrahieren. Andererseits, Es würde viel Zeit benötigen, um die Informationen zu extrahieren. Geschriebener Text und Sprache enthalten wertvolle Informationen. Es ist, weil wir, als intelligente Wesen, Schrift und Sprache als die Hauptform der Kommunikation verwenden. NLP kann diese Daten für uns analysieren und Aufgaben wie Sentiment-Analyse durchführen, kognitiver Assistent, Intervallfilterung, Identifizierung von Fake News und Echtzeit-Übersetzung von Sprachen.
Dieser Artikel behandelt, wie NLP Texte oder Teile der Rede versteht. Hauptsächlich werden wir uns auf Wörter und Sequenzanalyse konzentrieren. Es umfasst Textklassifizierung, Vektorielle Semantik und Wort-Einbettung, wahrscheinlichkeitsbasiertes Sprachmodell, sequenzielle Kennzeichnung und Umstrukturierung der Sprache. Wir werden die Sentiment-Analyse von fünfzigtausend IMDB-Filmkritikern ansehen. Unser Ziel ist es zu identifizieren, ob die auf der IMDB-Website von ihrem Benutzer veröffentlichte Rezension positiv oder negativ ist.
Themenliste
- Verstehen Sie, was NLP ist?
- Wozu dient NLP?
- Wörter und Sequenzen
- Textklassifizierung
- Semantische Einbettung und Wortvektoren
- Probabilistische Sprachmodelle
- Sequenzkennzeichnung
- Parser
- Semantik
- Durchführung einer semantischen Analyse im IMDb-Filmbewertungs-Datenprojekt
NLP wurde umfangreich in Autos verwendet, Smartphones, Lautsprecher, Computer, Webseiten, etc. Automatische Übersetzung mit Google Translator, Was ist das NLP-System. Google Übersetzer schrieb und sprach in natürlicher Sprache für die Sprache, in die die Benutzer übersetzen möchten. NLP hilft dem Google Übersetzer, das Wort im Kontext zu verstehen, zusätzliche Geräusche zu entfernen und CNN zu erstellen, um die Muttersprache zu verstehen.
NLP ist auch bei Chatbots beliebt. Chatbots sind sehr nützlich, weil sie die menschliche Arbeit reduzieren, nach den Bedürfnissen des Kunden zu fragen. Die NLP-Chatbots stellen nacheinander Fragen wie, was das Problem des Benutzers ist und wo die Lösung zu finden ist. Apple und AMAZON haben einen robusten Chatbot in ihrem System. Wenn der Benutzer einige Fragen stellt, der Chatbot wandelt sie in verständliche Sätze im internen System um.
Es wird Toke genannt. Später, Das Token wird an NLP weitergegeben, um sich ein Bild davon zu machen, was die Benutzer fragen.. NLU wird bei der Informationswiedergewinnung eingesetzt. (IR). IR ist ein Softwareprogramm, das sich mit großem Speicher beschäftigt., Bewertung von Informationen aus großen Textdokumenten aus Repositorien.. Es wird nur relevante Informationen abrufen.. Zum Beispiel, Es wird in der Spracherkennung von Google verwendet, um unnötige Wörter zu kürzen..
Anwendung von NLP.
- Automatische Übersetzung, nämlich, Google Übersetzer
- Informationswiedergewinnung.
- Antworten auf Fragen, nämlich, ChatBot.
- Zusammenfassung
- Stimmungsanalyse
- Analyse von sozialen Netzwerken.
- Big Data Mining.
Wörter und Sequenzen
Das NLP-System muss den Text korrekt verstehen., Die Zeichen und die Semantik.. Viele Methoden helfen dem NLP-System, den Text und die Symbole zu verstehen.. Dies sind Textklassifikationen., Vektorielle Semantik., Word Embedding., wahrscheinlichkeitsbasiertes Sprachmodell, Sequenzkennzeichnung und Sprachumstrukturierung.
-
Textklassifizierung
Die Textklassifizierung ist der Prozess, Text in eine Gruppe von Wörtern zu kategorisieren. Bei der Verwendung von NLP, kann die Textklassifizierung den Text automatisch analysieren und dann eine Reihe von vordefinierten Etiketten oder Kategorien nach seinem Kontext zuweisen. NLP wird für Meinungsanalyse verwendet, Themen- und Spracherkennung. Es gibt hauptsächlich drei Ansätze der Textklassifizierung:
- Regelbasierte Systeme,
- Maschinensysteme
- Hybridsysteme.
Im regelbasierten Ansatz, werden Texte in eine organisierte Gruppe unter Verwendung eines Satzes von handgefertigten Sprachregeln aufgeteilt. Diese handwerklichen sprachlichen Regeln enthalten Benutzer, um eine Liste von Wörtern zu definieren, die durch Gruppen gekennzeichnet sind. Zum Beispiel, Wörter wie Donald Trump und Boris Johnson würden in Politik klassifiziert werden. Personen wie LeBron James und Ronaldo würden in Sport klassifiziert werden.
Der auf Maschinen basierende Klassifikator lernt, eine Klassifizierung basierend auf vergangenen Beobachtungen der Datensätze durchzuführen. Die Benutzerdaten sind als Trainings- und Testdaten vormarkiert. Sammelt die Klassifizierungsstrategie der vorherigen Eingaben und lernt kontinuierlich. Der auf Maschinen basierende Klassifikator verwendet einen Ein-Wort-Beutel zur Merkmalsextraktion.
In einem Wortbeutel, Ein Vektor stellt die Häufigkeit von Wörtern in einem vordefinierten Wörterbuch einer Wortliste dar. Wir können NLP mit den folgenden Algorithmen des maschinellen Lernens durchführen: Naive Bayes, SVM und Deep Learning.
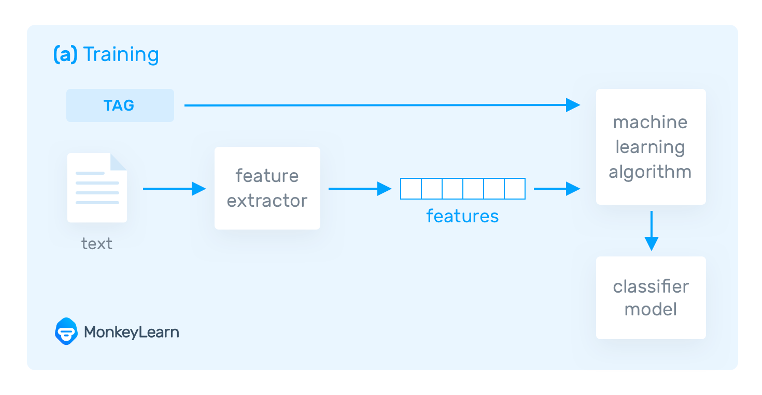
Der dritte Ansatz zur Textklassifikation ist der hybride Ansatz. Die Verwendung des hybriden Ansatzes kombiniert einen regelbasierten Ansatz und einen maschinenbasierten Ansatz. Verwendung des hybriden Ansatzes: Das regelbasierte System wird verwendet, um ein Label zu erstellen, und maschinelles Lernen wird verwendet, um das System zu trainieren und eine Regel zu erstellen. Später, Die Liste der maschinenbasierten Regeln wird mit der Liste der regelbasierten Regeln verglichen. Wenn etwas in den Labels nicht übereinstimmt, Menschen verbessern die Liste manuell. Es el mejor método para implementar la clasificación de texto.
-
Semántica vectorial
Vector Semantic es otra forma de análisis de palabras y secuencias. La semántica vectorial define la semántica e interpreta el significado de las palabras para explicar características como palabras similares y palabras opuestas. La idea principal detrás de la semántica vectorial es que dos palabras son iguales si se han usado en un contexto similar. La semántica vectorial divide las palabras en un espacio vectorial multidimensional. La semántica vectorial es útil en el análisis de sentimientos.
-
Worteinbettung
La incrustación de palabras es otro método de análisis de palabras y secuencias. La incrustación traduce los vectores de reserva en un espacio de baja Abmessungen"Dimension" Es handelt sich um einen Begriff, der in verschiedenen Disziplinen verwendet wird, wie z.B. Physik, Mathematik und Philosophie. Er bezieht sich auf das Ausmaß, in dem ein Objekt oder Phänomen analysiert oder beschrieben werden kann. In der Physik, zum Beispiel, Es ist die Rede von räumlichen und zeitlichen Dimensionen, während es sich in der Mathematik auf die Anzahl der Koordinaten beziehen kann, die notwendig sind, um einen Raum darzustellen. Es zu verstehen, ist grundlegend für das Studium und... das die semantischen Beziehungen bewahrt. Worteinbettung ist eine Art der Wortrepräsentation, die es ermöglicht, dass Wörter mit ähnlicher Bedeutung eine ähnliche Darstellung haben. Es gibt zwei Arten von Worteinbettungen:
Word2Vec ist eine statistische Methode, um effizient eine wortunabhängige Einbettung aus einem Textkorpus zu lernen.
Doc2Vec ist ähnlich wie Doc2Vec, aber analysiert eine Textgruppe wie Seiten.
-
Wahrscheinlichkeitsbasiertes Sprachmodell
Ein anderer Ansatz zur Analyse von Wörtern und Sequenzen ist das wahrscheinlichkeitsbasierte Sprachmodell. Das Ziel des wahrscheinlichkeitsbasierten Sprachmodells ist es, die Wahrscheinlichkeit eines Satzes aus einer Wortsequenz zu berechnen. Zum Beispiel, die Wahrscheinlichkeit, dass das Wort „ein“ in einem gegebenen Wort erscheint „ein“ es ist 0.00013131 Prozent.
-
Sequenzkennzeichnung
Sequenzkennzeichnung ist eine typische NLP-Aufgabe, bei der jedem Token in einer gegebenen Eingabesequenz eine Klasse oder ein Label zugewiesen wird. Wenn jemand sagt „Stell den Tom Hanks-Film ein“. In einer Sequenz, die Kennzeichnung ist [spielen, Film, Tom Hanks]. Das Spiel bestimmt eine Aktion. Filme sind ein Beispiel für eine Aktion. Tom Hanks sucht nach einer Suchentität. Teilen Sie die Eingabe in mehrere Tokens und verwenden Sie LSTM zur Analyse. Es gibt zwei Arten der Sequenzkennzeichnung. Dies sind Token-Kennzeichnung und Segment-Kennzeichnung.
Die Analyse ist eine Phase in der NLP, in der der Parser die syntaktische Struktur eines Textes bestimmt, indem er die Wörter in Bezug auf eine zugrunde liegende Grammatik analysiert. Zum Beispiel, ‘tom aß einen Apfel’ wird aufgeteilt in Eigenname → tom, Verb → aß, Artikel →, Substantiv → Apfel. Das beste Beispiel ist Amazon Alexa.
Wir besprechen, wie Text klassifiziert wird und wie man das Wort und die Sequenz aufteilt, damit der Algorithmus es verstehen und kategorisieren kann. In diesem Projekt, Wir werden eine Sentiment-Analyse von fünfzigtausend Filmkritiken auf IMDB durchführen. Unser Ziel ist es zu identifizieren, ob die auf der IMDB-Website von ihrem Benutzer veröffentlichte Rezension positiv oder negativ ist.
Dieses Projekt behandelt Text-Mining-Techniken wie Texteinbettung, Bag-of-Words, Kontext von Wörtern und andere Methoden. Wir werden auch eine Einführung in einen bidirektionalen LSTM-Sentiment-Klassifizierer behandeln. Wir werden auch sehen, wie man automatisch einen beschrifteten Datensatz von TensorFlow importiert. Dieses Projekt umfasst auch Schritte wie Datenbereinigung, Textverarbeitung, Datenbalance durch Sampling und AusbildungTraining ist ein systematischer Prozess zur Verbesserung der Fähigkeiten, körperliche Kenntnisse oder Fähigkeiten. Es wird in verschiedenen Bereichen angewendet, wie Sport, Aus- und Weiterbildung. Zu einem effektiven Trainingsprogramm gehört auch die Zielplanung, Regelmäßiges Üben und Bewerten der Fortschritte. Anpassung an individuelle Bedürfnisse und Motivation sind Schlüsselfaktoren, um in jeder Disziplin erfolgreiche und nachhaltige Ergebnisse zu erzielen.... und das Testen eines Modells tiefes LernenTiefes Lernen, Eine Teildisziplin der Künstlichen Intelligenz, verlässt sich auf künstliche neuronale Netze, um große Datenmengen zu analysieren und zu verarbeiten. Diese Technik ermöglicht es Maschinen, Muster zu lernen und komplexe Aufgaben auszuführen, wie Spracherkennung und Computer Vision. Seine Fähigkeit, sich kontinuierlich zu verbessern, wenn mehr Daten zur Verfügung gestellt werden, macht es zu einem wichtigen Werkzeug in verschiedenen Branchen, von Gesundheit... para clasificar texto.
Analysieren
El analizador determina la estructura sintáctica de un texto analizando las palabras que lo constituyen en función de una gramática subyacente. Divide las palabras del grupo en partes componentes y separa las palabras.
Para obtener más detalles sobre el análisis, sehen Dieser Beitrag.
Semántico
El texto está en el corazón de cómo nos comunicamos. ¿Lo que es realmente difícil es comprender lo que se dice en una conversación escrita o hablada? Comprender libros y artículos extensos es aún más difícil. La semántica es un proceso que busca comprender el significado lingüístico mediante la construcción de un modelo del principio que el hablante utiliza para transmitir significado. Es wurde zur Analyse von Kundenkommentaren verwendet, Analyse von Artikeln, Fake-News-Erkennung, Semantische Analyse, etc.
Beispielanwendung
Hier ist das Beispiel des Codes:
Importieren der notwendigen Bibliothek
# Es wird durch das kaggle/python Docker-Image definiert: https://github.com/kaggle/docker-python
# Zum Beispiel, here's several helpful packages to load

import numpy as np # Lineare Algebra
Pandas als pd importieren # Datenverarbeitung, CSV-Datei I/O (z.B. pd.read_csv)

# Eingabedateien sind im Nur-Lese-Modus verfügbar "../Eingang/" Verzeichnis
# Zum Beispiel, dies auszuführen (durch Klicken auf Ausführen oder Drücken von Shift+Enter) will list all files under the input directory

import os
for dirname, _, Dateinamen in os.walk('/kaggle/input'):
    für Dateiname in Dateinamen:
        drucken(os.path.join(dirname, Dateiname))

# Sie können bis zu 20GB in das aktuelle Verzeichnis schreiben (/kaggle/working/) das als Ausgabe beibehalten wird, wenn Sie eine Version erstellen mit "Speichern & Alles ausführen"
# Sie können auch temporäre Dateien nach /kaggle/temp/ schreiben,, but they won't be saved outside of the current session

#Importing require Libraries
import os

import matplotlib.pyplot as plt
import nltk
from tkinter import *
import seaborn as sns
import matplotlib.pyplot as plt
sns.set()
import scipy

import tensorflow as tf
import tensorflow_hub as hub
import tensorflow_datasets as tfds
from tensorflow.python import keras

from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import Dense, Einbettung, LSTM

from sklearn.model_selection import train_test_split
from sklearn.metrics import confusion_matrix
from sklearn.metrics import classification_report
Herunterladen der benötigten Datei
# diese Zellen dauern ihre Zeit, bitte einmal ausführen
# Den Trainingssatz aufteilen in 60% und 40%, so dass wir am Ende haben werden 15,000 Beispiele
# für das Training, 10,000 Beispiele zur Validierung und 25,000 Beispiele zum Testen.
original_train_data, original_validation_data, original_test_data = tfds.load(
    name="imdb_reviews",
    split=('train[:60%]', 'train[60%:]', 'test'),
    als_supervised=True)
Den Wortindex der Keras-Datensätze erhalten
#tokanizing by tensorflow
word_index = tf.keras.datasets.imdb.get_word_index(
    Pfad="imdb_word_index.json"
)
In [8]:
{k:v for (k,v) in word_index.items() if v < 20}
Aus[8]:
{'with': 16, 'i': 10, 'as': 14, 'it': 9, 'is': 6, 'in': 8, 'but': 18, 'of': 4, 'this': 11, 'a': 3, 'for': 15, 'br': 7, 'the': 1, 'was': 13, 'and': 2, 'to': 5, 'film': 19, 'movie': 17, 'that': 12}
Comparación de revisión positiva y negativa
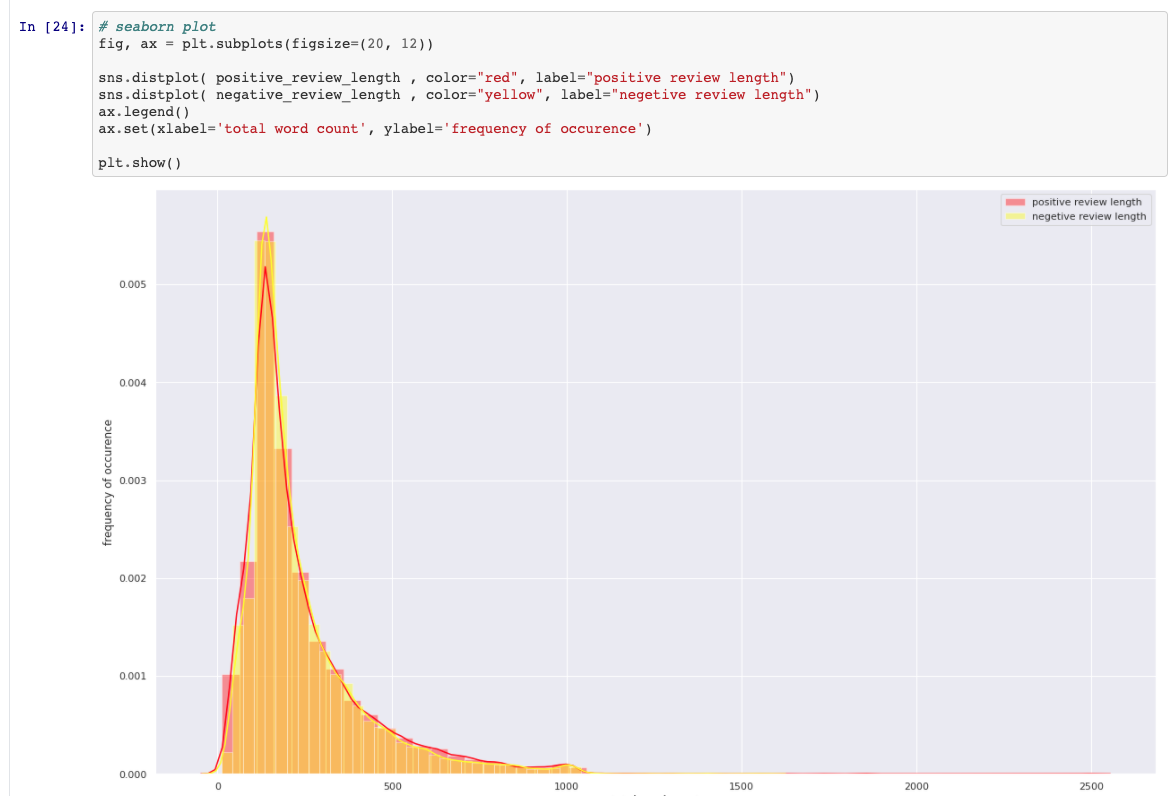
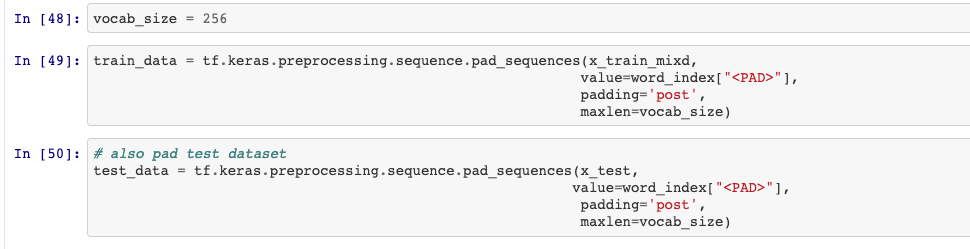
Crear tren, probar datos
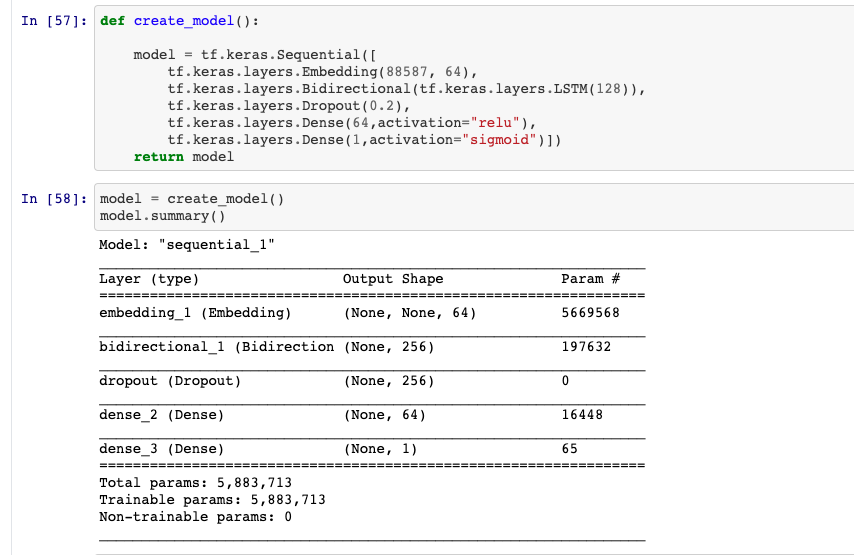
Modelo y resumen del modelo
Dividir datos y ajustar el modelo
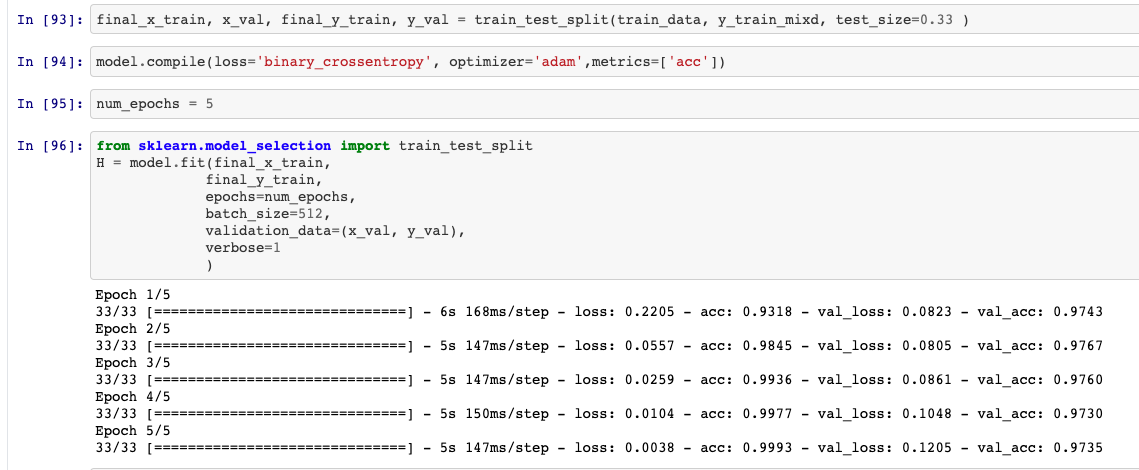
Allgemeiner Überblick über die Wirkung des Modells
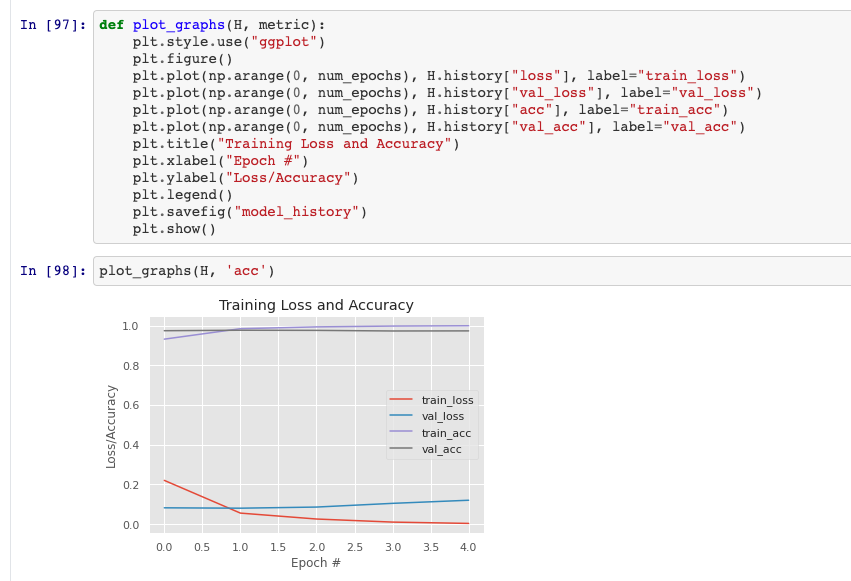
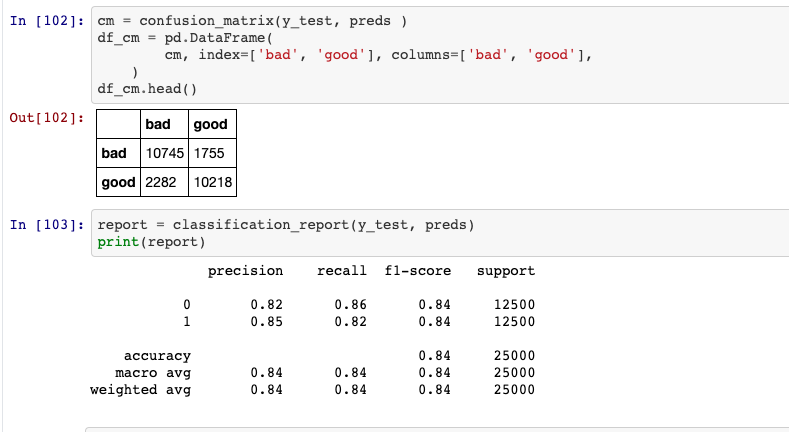
Konfusionsmatrix und Korrelationsbericht
Notiz: Das DatenquelleEIN "Datenquelle" bezieht sich auf jeden Ort oder jedes Medium, an dem Informationen erhalten werden können. Diese Quellen können sowohl primär als auch, wie z.B. Erhebungen und Experimente, als sekundär, als Datenbanken, Wissenschaftliche Artikel oder statistische Berichte. Die richtige Wahl einer Datenquelle ist entscheidend, um die Gültigkeit und Zuverlässigkeit von Informationen in Forschung und Analyse zu gewährleisten.... und die Daten dieses Modells sind öffentlich verfügbar und können über Tensorflow abgerufen werden.
Um den vollständigen Code und die Details zu erhalten, folgen Sie diesem GitHub-Repository.
Abschließend, NLP ist ein Fachgebiet voller Möglichkeiten. NLP hat enorme Auswirkungen darauf, wie Texte und Reden analysiert werden. NLP wird jeden Tag besser. Die Wissensextraktion aus dem großen Datensatz war vor fünf Jahren unmöglich. Der Aufstieg der NLP-Technik machte es möglich und einfach. Es gibt noch viele Möglichkeiten, die in der NLP entdeckt werden können..





