
Überblick
- Verstehen Sie das Konzept von R-Quadrat und R-Quadrat
- Lernen Sie die wichtigsten Unterschiede zwischen R-Quadrat und angepasstem R-Quadrat kennen
Einführung
Als ich meine Reise in die Datenwissenschaft begann, Der erste Algorithmus, den ich untersucht habe, war die lineare Regression. Nach dem Verständnis der Konzepte der linearen Regression und der Funktionsweise des Algorithmus, war wirklich aufgeregt, es zu benutzen und Vorhersagen über eine Problembeschreibung zu treffen. Ich bin mir sicher, dass die meisten von Ihnen dasselbe getan hätten.. Aber sobald wir die Werte vorhergesagt haben, Was kommt als nächstes?
Dann kommt der knifflige Teil. Sobald wir unser Modell gebaut haben, Der nächste Schritt bestand darin, ihre Leistung zu bewerten. Unnötig zu sagen, dass die Aufgabe, das Modell zu bewerten, von grundlegender Bedeutung ist und die Mängel unseres Modells hervorhebt.. Auswahl der am besten geeigneten Bewertungsmetrik ist eine entscheidende Aufgabe. Und ich habe zwei wichtige Metriken gefunden.: R-Quadrat und R-Quadrat angepasst außer MAE / MSE / RMSE. Was ist der Unterschied zwischen diesen beiden?? Welches sollte ich verwenden??
R-Quadrat und R-Quadrat sind zwei dieser Bewertungsmetriken, die für jeden Data-Science-Aspiranten zunächst verwirrend erscheinen können.. Da beide für die Bewertung von Regressionsproblemen extrem wichtig sind, wir werden sie verstehen und im Detail vergleichen. Beide haben ihre Vor- und Nachteile, auf die wir in diesem Artikel ausführlich eingehen werden.
Notiz: Um R-Quadrat und angepasstes R-Quadrat zu verstehen, muss über gute Kenntnisse der linearen Regression verfügen. Schauen Sie sich unseren kostenlosen Kurs an –
Inhaltsverzeichnis
- Restsumme der Quadrate
- Grundlegendes zur R-Quadrat-Statistik
- Probleme mit der R-Quadrat-Statistik
- Bereinigte R-Quadrat-Statistik
Restsumme der Quadrate
Konzepte klar zu verstehen, Wir werden uns mit einem einfachen Regressionsproblem befassen. Hier, estamos tratando de predecir LAS ‚calificaciones obtenidas‘ en función de la cantidad de ‚tiempo dedicado a estudar‘. das Wetter Verbrachte Studienzeit wird unsere sein VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... Unabhängig und das Warenzeichen ausgeführt Im Test ist unsere abhängig Ö Zielvariable.
Wir können ein einfaches Regressionsdiagramm zeichnen, um diese Daten zu visualisieren.
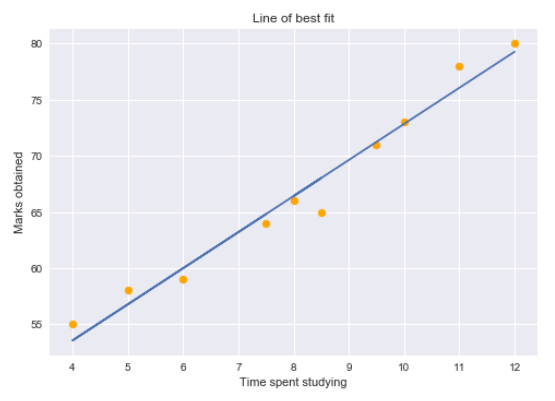
Die gelben Punkte stellen die Datenpunkte dar und die blaue Linie ist unsere vorhergesagte Regressionsgerade.. Wie du siehst, Unser Regressionsmodell sagt nicht alle Datenpunkte perfekt voraus. Dann, Wie bewerten wir Regressionslinienvorhersagen anhand der Daten?? Gut, Wir könnten damit beginnen, die Restwerte für die Datenpunkte zu bestimmen.
Restwert Für einen Punkt in den Daten ist die Differenz zwischen dem tatsächlichen Wert und dem Wert, der von unserem linearen Regressionsmodell vorhergesagt wird.

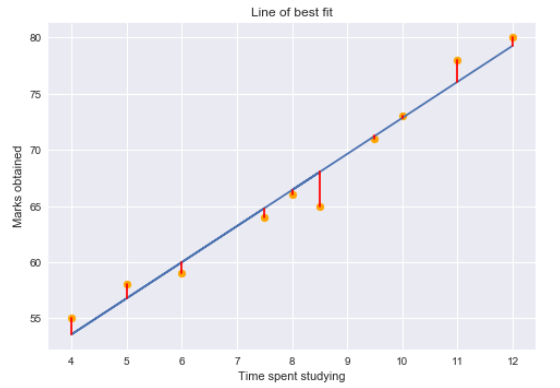
Restdiagramme sagen uns, ob das Regressionsmodell für die Daten geeignet ist oder nicht. In Wirklichkeit, ist eine Annahme des Regressionsmodells, dass es keinen Trend in den Restgraphen gibt. Untersuchung der Annahmen der linearen Regression im Detail, Ich schlage vor, durchzugehen Diese großartige ARLacculum!
Verwenden von Restwerten, Wir können die Summe der Quadrate des Abfalls bestimmen, auch bekannt als Restsumme der Quadrate oder RSS.

Je niedriger der RSS-Wert ist, desto besser sind die Vorhersagen des Modells. Oder wir können sagen, dass eine Regressionslinie eine bessere Passlinie ist, wenn sie den RSS-Wert minimiert.. Aber es gibt einen Fehler darin.: RSS ist eine Skalierungsvariantenstatistik. Da RSS die Summe der quadrierten Differenz zwischen dem tatsächlichen und dem vorhergesagten Wert ist, Der Wert hängt von der Skalierung der Zielvariablen ab.
Beispiel:
Bedenken Sie, dass Ihre Zielvariable der Umsatz ist, der durch den Verkauf eines Produkts generiert wird. Abfall würde vom Umfang dieses Ziels abhängen.. Wenn die Einkommensskala berücksichtigt wird „Hunderte von Rupien“ (nämlich, Das Ziel wäre 1, 2, 3, etc.), dann könnten wir einen RSS von ungefähr 0,54 (hypothetisch sprechen).
Wenn jedoch die Zielvariable des Einkommens berücksichtigt wurde „Rupien“ (nämlich, Das Ziel wäre 100, 200, 300, etc.), dann könnten wir einen höheren RSS wie 5400. Obwohl sich die Daten nicht ändern, RSS-Wert variiert. entsprechend der Skala des Ziels. Dies macht es schwierig zu beurteilen, was ein guter RSS-Wert sein könnte..
Dann, Können wir eine bessere Statistik entwickeln, die invariant skaliert ist?? Hier kommt das R-Quadrat ins Spiel.
Grundlegendes zur R-Quadrat-Statistik
Die R-Quadrat-Statistik oder der Bestimmungskoeffizient ist eine skaleninvariante Statistik, die den Variationsanteil in der Zielvariablen angibt, der durch das lineare Regressionsmodell erklärt wird..
Das mag etwas kompliziert erscheinen., also lassen Sie es mich hier aufschlüsseln. So bestimmen Sie den Anteil der Zielvariation, der durch das Modell erklärt wird, Zuerst müssen wir Folgendes festlegen::
-
Gesamtsumme der Quadrate
Die Gesamtvariation der Zielvariablen ist die Summe der Quadrate der Differenz zwischen den Realwerten und ihrem Mittelwert.
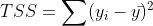
TSS oder Summensumme der Quadrate ergibt die Gesamtvariation in Y. Wir können sehen, dass es der Varianz von Y sehr ähnlich ist. Während Varianz der Durchschnitt der quadratischen Summen der Differenz zwischen reellen Werten und Datenpunkten ist, TSS ist die Summe der Summen zum Quadrat.
Nun, da wir die Gesamtvariation in der Zielvariablen kennen, Wie bestimmen wir den Anteil dieser Variation, der durch unser Modell erklärt wird?? Zurück zu RSS.
-
Restsumme der Quadrate
Wie bereits besprochen, RSS gibt uns das Gesamtquadrat des Abstands der reellen Punkte von der Regressionsgeraden. Aber wenn wir uns auf einen einzigen Abfall konzentrieren, Wir können sagen, dass es die Entfernung ist, die nicht von der Regressionslinie erfasst wird. Deswegen, RSS als Ganzes gibt uns die Variation in der Zielvariablen, die nicht erklärt nach unserem Vorbild.
-
R-Quadrat berechnen
Jetzt, wenn TSS uns die Gesamtvariation in Y ergibt, und RSS gibt uns die Variation in Y, die nicht durch X erklärt wird, dann TSS-RSS gibt uns die Variation in Y, die durch unser Modell erklärt wird! Wir können diesen Wert einfach durch TSS dividieren, um das Variationsverhältnis in Y zu erhalten, das das Modell erklärt. Und das ist unseres. R-Quadrat-Statistik!
R-Quadrat = (TSS-RSS) / TSS
= Variation erklärt / Totale Veränderung
= 1 – Unerklärliche Abweichung / Totale Veränderung
Dann, Quadrat R gibt den Grad der Variabilität in der Zielvariablen an, der durch das Modell oder unabhängige Variablen erklärt wird. Wenn dieser Wert 0,7, bedeutet, dass die unabhängigen Variablen die 70% der Variation der Zielvariablen.
Der Wert des R-Quadrats liegt immer zwischen 0 Ja 1. Ein höherer R-Quadrat-Wert zeigt eine größere Variabilität an, die durch unser Modell erklärt wird und umgekehrt.
Wenn wir einen wirklich niedrigen RSS-Wert hätten, würde bedeuten, dass die Regressionslinie sehr nahe an den tatsächlichen Punkten lag. Dies bedeutet, dass unabhängige Variablen den größten Teil der Variation in der Zielvariablen erklären.. In diesem Fall, wir hätten einen wirklich hohen quadratischen R-Wert.
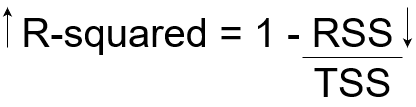
Umgekehrt, wenn wir einen wirklich hohen RSS-Wert hätten, Dies würde bedeuten, dass die Regressionslinie sehr weit von den tatsächlichen Punkten entfernt wäre.. Deswegen, Unabhängige Variablen erklären nicht den größten Teil der Variation in der Zielvariablen. Dies würde uns einen wirklich niedrigen R-Quadrat-Wert geben..
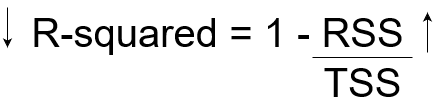
Dann, Dies erklärt, warum der R-Quadrat-Wert uns die Variation in der Zielvariablen gibt, die durch die Variation der unabhängigen Variablen gegeben ist.
Probleme mit der R-Quadrat-Statistik
Die R-Quadrat-Statistik ist nicht perfekt. Eigentlich, leidet an einem schweren Defekt. Sein Wert sinkt nie, egal wie viele Variablen wir unserem Regressionsmodell hinzufügen.. Nämlich, auch wenn wir den Daten redundante Variablen hinzufügen, Der Wert des R-Quadrats nimmt nicht ab. Entweder bleibt es gleich oder erhöht sich mit dem Hinzufügen neuer unabhängiger Variablen. Dies ist eindeutig nicht sinnvoll, da einige der unabhängigen Variablen bei der Bestimmung der Zielvariablen möglicherweise nicht nützlich sind.. Angepasstes R-Quadrat befasst sich mit diesem Problem.
Bereinigte R-Quadrat-Statistik
Das angepasste R-Quadrat berücksichtigt die Anzahl der unabhängigen Variablen, die zur Vorhersage der Zielvariablen verwendet werden.. Dabei, Wir können feststellen, ob das Hinzufügen neuer Variablen zum Modell tatsächlich die Anpassung des Modells erhöht.
Werfen wir einen Blick auf die angepasste R-Quadrat-Formel, um besser zu verstehen, wie sie funktioniert.
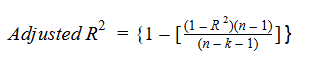
Hier,
- Norden stellt die Anzahl der Datenpunkte in unserem Datensatz dar
- k stellt die Anzahl der unabhängigen Variablen dar, Ja
- R stellt die vom Modell bestimmten R-Quadrat-Werte dar.
Dann, wenn das R-Quadrat mit dem Hinzufügen einer neuen unabhängigen Variablen nicht signifikant zunimmt, dann sinkt der angepasste R-Quadrat-Wert tatsächlich.
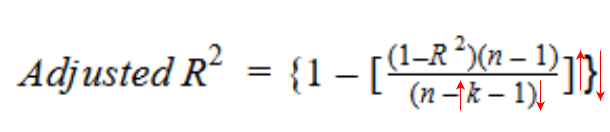
Zweitens, wenn wir beim Addieren der neuen unabhängigen Variablen einen signifikanten Anstieg des Wertes von R im Quadrat sehen, dann steigt auch der Wert des bereinigten R-Quadrats.
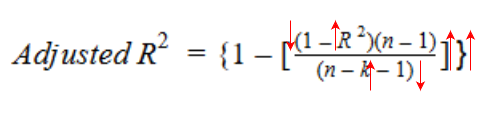
Wir können den Unterschied zwischen den Werten von R-Quadrat und R-Quadrat sehen, wenn wir unserem Modell eine zufällige unabhängige Variable hinzufügen..
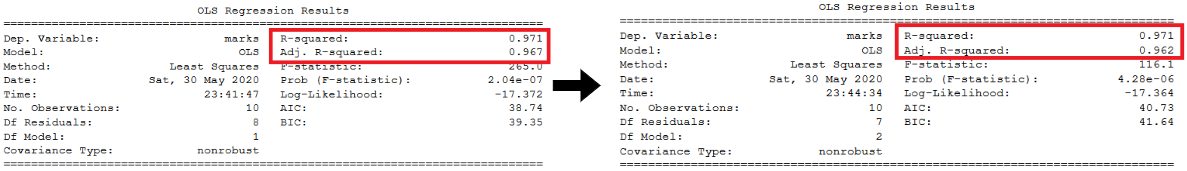
Wie du siehst, Das Hinzufügen einer zufälligen unabhängigen Variablen half nicht, die Variation in der Zielvariablen zu erklären. Unser R-Quadrat-Wert bleibt gleich. Deswegen, gibt uns einen falschen Hinweis darauf, dass diese Variable für die Vorhersage der Ausgabe nützlich sein könnte. Aber trotzdem, der angepasste R-Quadrat-Wert verringerte sich, was darauf hindeutete, dass diese neue Variable den Trend in der Zielvariablen nicht wirklich erfasst.
Deutlich, Es ist besser, das angepasste R-Quadrat zu verwenden, wenn das Regressionsmodell mehrere Variablen enthält. Dies würde es uns ermöglichen, Modelle mit einer unterschiedlichen Anzahl unabhängiger Variablen zu vergleichen..
Abschließende Anmerkungen
In diesem Artikel, Wir analysieren, was die R-Quadrat-Statistik ist und wo sie versagt. Wir werfen auch einen Blick auf das angepasste R-Quadrat.
Hoffentlich, Dies hat Ihnen ein besseres Verständnis der Dinge gegeben. Sie können nun umsichtig bestimmen, welche unabhängigen Variablen für die Vorhersage des Ergebnisses Ihres Regressionsproblems nützlich sind..
So erfahren Sie mehr über andere Bewertungsmetriken, Ich schlage vor, die folgenden ausgezeichneten Ressourcen zu überprüfen:





