
Überblick
- Familiarícese con el Verteiltes DateisystemEin verteiltes Dateisystem (DFS) Ermöglicht die Speicherung und den Zugriff auf Daten auf mehreren Servern, Erleichterung der Verwaltung großer Informationsmengen. Diese Art von System verbessert die Verfügbarkeit und Redundanz, da Dateien an verschiedene Speicherorte repliziert werden, Reduzierung des Risikos von Datenverlusten. Was ist mehr, Ermöglicht Benutzern den Zugriff auf Dateien von verschiedenen Plattformen und Geräten aus, die Zusammenarbeit zu fördern und... die Hadoop (HDFSHDFS, o Verteiltes Hadoop-Dateisystem, Es ist eine Schlüsselinfrastruktur für die Speicherung großer Datenmengen. Entwickelt für die Ausführung auf gängiger Hardware, HDFS ermöglicht die Datenverteilung über mehrere Knoten, Sicherstellung einer hohen Verfügbarkeit und Fehlertoleranz. Seine Architektur basiert auf einem Master-Slave-Modell, wobei ein Master-Knoten das System verwaltet und Slave-Knoten die Daten speichern, Erleichterung der effizienten Verarbeitung von Informationen..)
- Comprender los componentes de HDFS
Einführung
Heutzutage, es habitual tratar con cantidades masivas de datos. Desde su próximo mensaje de WhatsApp hasta su próximo Tweet, está creando datos en cada paso cuando interactúa con la tecnología. Ahora multiplique eso por 4.5 mil millones de personas en Internet: ¡las matemáticas son simplemente alucinantes!
Aber, ¿alguna vez se preguntó cómo manejar esos datos? ¿Está almacenado en una sola máquina? ¿Y si falla la máquina? ¿Perderás tus adorables tweets de las 3 BIN * tos *?
La respuesta es No. Estoy bastante seguro de que ya estás pensando en Hadoop. Hadoop es un marco asombroso. Con Hadoop a su lado, Sie können die erstaunlichen Fähigkeiten des verteilten Dateisystems von Hadoop nutzen (HDFS), die Speicherkomponente von Hadoop. Es ist wahrscheinlich die wichtigste Komponente von Hadoop und erfordert eine ausführliche Erklärung.
Dann, In diesem Artikel, wir werden lernen, was das verteilte Dateisystem von Hadoop wirklich ist (HDFS) und seine verschiedenen Komponenten. Was ist mehr, wir werden sehen, was HDFS funktionieren lässt, das ist es, was es so besonders macht. Lassen Sie uns herausfinden!
Inhaltsverzeichnis
- Was ist das verteilte Dateisystem von Hadoop (HDFS)?
- Was sind die Komponenten von HDFS?
- Blöcke in HDFS?
- NamenodeDer NameNode ist eine grundlegende Komponente des verteilten Dateisystems Hadoop (HDFS). Seine Hauptfunktion besteht darin, die Metadaten der Dateien zu verwalten und zu speichern, z. B. die Position im Cluster und die Größe. Was ist mehr, Koordiniert den Datenzugriff und stellt die Systemintegrität sicher. Ohne den NameNode, Der HDFS-Betrieb wäre stark beeinträchtigt, Da es als Master in der verteilten Speicherarchitektur fungiert.... in HDFS
- Datenknoten in HDFS
- KnotenNodo ist eine digitale Plattform, die die Verbindung zwischen Fachleuten und Unternehmen auf der Suche nach Talenten erleichtert. Durch ein intuitives System, Ermöglicht Benutzern das Erstellen von Profilen, Erfahrungen austauschen und Zugang zu Stellenangeboten erhalten. Der Fokus auf Zusammenarbeit und Networking macht Nodo zu einem wertvollen Werkzeug für diejenigen, die ihr berufliches Netzwerk erweitern und Projekte finden möchten, die mit ihren Fähigkeiten und Zielen übereinstimmen.... Sekundär in HDFS
- Verwaltung der Replikation
- ReplikationReplikation ist ein grundlegender Prozess in Biologie und Wissenschaft, was sich auf die Duplikation von Molekülen bezieht, Zellen oder genetische Informationen. Im Kontext der DNA, Die Replikation sorgt dafür, dass jede Tochterzelle während der Zellteilung eine vollständige Kopie des Erbguts erhält. Dieser Mechanismus ist entscheidend für das Wachstum, Entwicklung und Pflege der Organismen, sowie für die Weitergabe von Erbeigenschaften an zukünftige Generationen.... von Blöcken
- Was ist ein Rack in Hadoop?
- Rack-Bewusstsein
Was ist das verteilte Dateisystem von Hadoop (HDFS)?
Es ist schwierig, große Datenmengen auf einer einzigen Maschine zu speichern. Deswegen, es necesario dividir los datos en fragmentos más pequeños y almacenarlos en varias máquinas.
Los sistemas de archivos que administran el almacenamiento en una red de máquinas se denominan sistemas de archivos distribuidos.
Das verteilte Dateisystem von Hadoop (HDFS) es el componente de almacenamiento de Hadoop. Todos los datos almacenados en Hadoop se almacenan de manera distribuida en un grupo de máquinas. Pero tiene algunas propiedades que definen su existencia.
- Enormes volúmenes – Al ser un sistema de archivos distribuido, es altamente capaz de almacenar petabytes de datos sin ningún problema técnico.
- Zugriff auf Daten – Se basa en la filosofía de que “el patrón de procesamiento de datos más eficaz es escribir una vez y leer muchas veces”.
- Económico – HDFS se ejecuta en un grupo de hardware básico. Estas son máquinas económicas que se pueden comprar a cualquier proveedor.
¿Cuáles son los componentes del sistema de archivos distribuido de Hadoop (HDFS)?
HDFS tiene dos componentes principales, allgemein gesagt: bloques de datos y nodos que almacenan esos bloques de datos. Pero hay más de lo que parece. Dann, veamos esto uno por uno para comprenderlo mejor.
Bloques HDFS
HDFS divide un archivo en unidades más pequeñas. Cada una de estas unidades se almacena en diferentes máquinas del ClusterEin Cluster ist eine Gruppe miteinander verbundener Unternehmen und Organisationen, die im selben Sektor oder geografischen Gebiet tätig sind, und die zusammenarbeiten, um ihre Wettbewerbsfähigkeit zu verbessern. Diese Gruppierungen ermöglichen die gemeinsame Nutzung von Ressourcen, Wissen und Technologien, Förderung von Innovation und Wirtschaftswachstum. Cluster können sich über eine Vielzahl von Branchen erstrecken, Von der Technologie bis zur Landwirtschaft, und sind von grundlegender Bedeutung für die regionale Entwicklung und die Schaffung von Arbeitsplätzen..... Aber trotzdem, esto es transparente para el usuario que trabaja en HDFS. Für Sie, parece almacenar todos los datos en una sola máquina.
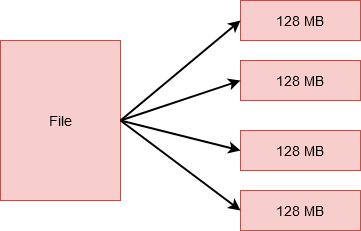
Estas unidades más pequeñas son las Blöcke in HDFS. El tamaño de cada uno de estos bloques es de 128 MB de forma predeterminada, puede cambiarlo fácilmente según los requisitos. Deswegen, si tuviera un archivo de 512 MB, würde in 4 Blöcke aufgeteilt, die speichern 128 MB jeweils.
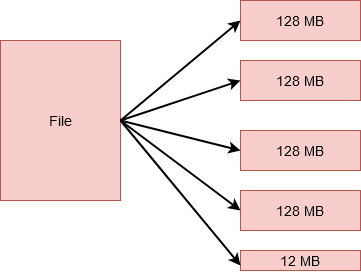
Aber trotzdem, si tuviera un archivo de 524 MB groß, würde in 5 Blöcke. 4 davon würden speichern 128 MB jeweils, was entspricht 512 MB. Und der fünfte würde die 12 verbleibenden MB speichern. Korrekt! Dieser letzte Block wird nicht die 128 vollständigen MB der Festplatte belegen.
Aber, du musst dich fragen, Warum eine so große Menge in einem einzigen Block?? Warum nicht mehrere Blöcke von 10 KB jeweils?? Gut, Die Datenmenge, mit der wir normalerweise in Hadoop arbeiten, liegt im Bereich von Petabyte oder mehr..
Deswegen, Wenn wir kleine Blöcke erstellen,, würden wir mit einer kolossalen Anzahl von Blöcken enden.. Das würde bedeuten, dass wir mit ebenso großen Metadaten bezüglich des Speicherorts der Blöcke umgehen müssten., was viel Overhead erzeugen würde.. Und das wollen wir wirklich nicht.!
Es gibt mehrere Vorteile, Daten in Blöcken zu speichern, anstatt die gesamte Datei zu speichern.
- Die Datei selbst wäre zu groß, um sie auf einer einzelnen Festplatte zu speichern. Deswegen, Es ist ratsam, sie auf verschiedene Maschinen des Clusters zu verteilen.
- Dies würde auch eine angemessene Arbeitslastverteilung ermöglichen und eine Überlastung einer einzelnen Maschine verhindern, indem das Parallelitätsprinzip genutzt wird.
Jetzt, du musst dich fragen, Was ist mit den Maschinen im Cluster?? Wie speichern sie die Blöcke und wo werden die Metadaten gespeichert?? Lassen Sie es uns herausfinden.
Namenode in HDFS
HDFS arbeitet in einer Master-Worker-Architektur, Das bedeutet, dass es einen Master-KnotenDas "Master-Knoten" Es ist eine Schlüsselkomponente in Computernetzwerken und verteilten Systemen. Es ist verantwortlich für die Verwaltung und Koordination des Betriebs anderer Knoten, Gewährleistung einer effizienten Kommunikation und eines effizienten Datenflusses. Zu seiner Hauptfunktion gehört die Entscheidungsfindung, Ressourcenzuweisung und Überwachung der Systemleistung. Die korrekte Implementierung eines Master-Knotens ist unerlässlich, um den Gesamtbetrieb des Netzwerks zu optimieren.... und mehrere Workerknoten im Cluster gibt. Der Master-Knoten ist der Namenode.
Namenode ist der Hauptknoten, der auf einem unabhängigen Knoten des Clusters läuft.
- Verwaltet den Namespace des Dateisystems, Was der Baum des Dateisystems oder die Hierarchie der Dateien und Verzeichnisse ist.
- Speichert Informationen wie Dateibesitzer, Dateiberechtigungen, etc. Für alle Dateien.
- Kennt auch den Speicherort aller Blöcke einer Datei und ihre Größe.
All diese Informationen werden persistent auf der lokalen Festplatte in Form von zwei Dateien gespeichert: Fsimage Ja Edit-Log.
- Fsimage Speichert Informationen über Dateien und Verzeichnisse im Dateisystem. Für Dateien, Speichert den Replikationsgrad, die Änderungs- und Zugriffszeiten, die Zugriffsberechtigungen, die Blöcke, aus denen die Datei besteht, und deren Größen. Für Verzeichnisse, Speichert die Änderungszeit und Berechtigungen.
- Edit-Log Zweitens, verfolgt alle Schreibvorgänge, die der Client durchführt. Dies wird regelmäßig in den In-Memory-Metadaten aktualisiert, um Leseanfragen zu bedienen.
Immer wenn ein Client Informationen in HDFS schreiben oder aus HDFS lesen möchte, verbindet er sich mit dem Namenode. Der Namenode gibt dem Client die Position der Blöcke zurück und die Operation wird durchgeführt.
Jawohl, das ist wahr, Der Namenode speichert die Blöcke nicht. Dafür, Wir haben separate Knoten.
Datenknoten in HDFS
Datenknoten sind die Arbeitknoten. Sie sind kostengünstige Basis-Hardware, die leicht zum Cluster hinzugefügt werden kann.
Datenknoten sie sind verantwortlich für das Speichern, abzurufen, Replizieren, Löschen, etc. von Blöcken, wenn der Namenode dies anfordert.
Sie senden regelmäßig Heartbeats zum Namenode, damit dieser über ihren Zustand informiert bleibt. Damit, ein DatenknotenDataNode ist eine Schlüsselkomponente in Big-Data-Architekturen, Wird zum Speichern und Verwalten großer Informationsmengen verwendet. Seine Hauptfunktion besteht darin, den Zugriff auf und die Manipulation von Daten zu erleichtern, die in Clustern verteilt sind. Durch sein skalierbares Design, DataNode ermöglicht es Unternehmen, die Leistung zu optimieren, Verbessern Sie die Effizienz bei der Datenverarbeitung und stellen Sie die Verfügbarkeit von Informationen in Echtzeit sicher.... Sendet auch eine Liste der Blöcke, die darin gespeichert sind, damit der Namenode die Zuordnung der Blöcke zu den Datanodes in seinem Speicher verwalten kann.
Aber zusätzlich zu diesen beiden Knotentypen im Cluster, Gibt es auch einen weiteren Knoten, der Sekundärnamenknoten genannt wird. Mal sehen, was das ist.
Sekundärnamenknoten in HDFS
Angenommen, wir müssen den Knoten neu starten Namenode, was im Falle eines Ausfalls passieren kann. Das würde bedeuten, dass wir das Fsimage von der Festplatte in den Speicher kopieren müssen. Was ist mehr, wir müssten auch die letzte Kopie des Edit Logs in das Fsimage kopieren, um alle Transaktionen nachzuverfolgen. Aber wenn wir den Knoten nach längerer Zeit neu starten, dann könnte das Edit-Log in der Größe zugenommen haben. Dies würde bedeuten, dass es lange dauern würde, die Transaktionen aus dem Edit-Log anzuwenden. Und während dieser Zeit, wäre das Dateisystem offline. Deswegen, um dieses Problem zu lösen, bringen wir das Sekundärer Namensknoten.
Sekundärer Namensknoten es ist ein weiterer Knoten im Cluster, dessen Hauptaufgabe darin besteht, regelmäßig das Edit-Log mit FsImage zusammenzuführen und Kontrollpunkte für die Metadaten des primären Dateisystems im Speicher zu erzeugen. Dies ist auch bekannt als Checkpointing.
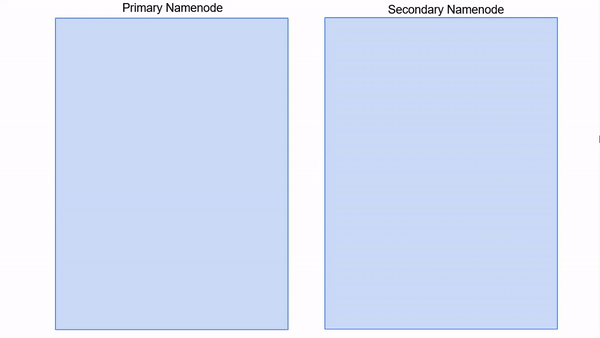
Aber das Verfahren zur Erstellung von Kontrollpunkten ist rechenintensiv und benötigt viel Speicher, weshalb der sekundäre Namenode auf einem separaten Knoten des Clusters ausgeführt wird.
Aber trotzdem, trotz seines Namens, Der sekundäre Namenode fungiert nicht als Namenode. Simplemente está ahí para hacer Checkpointing y mantener una copia de la última Fsimage.
Gestión de la replicación en HDFS
Jetzt, una de las mejores características de HDFS es la replicación de bloques, lo que lo hace muy confiable. Aber, ¿cómo replica los bloques y dónde los almacena? Respondamos esas preguntas ahora.
Replicación de bloques
HDFS es un componente de almacenamiento confiable de Hadoop. Esto se debe a que cada bloque almacenado en el sistema de archivos se replica en diferentes nodos de datos del clúster. Esto hace que HDFS sea tolerante a errores.
El factor de replicación predeterminado en HDFS es 3. Esto significa que cada bloque tendrá dos copias más, cada una almacenada en DataNodes separados en el clúster. Aber trotzdem, Diese Zahl ist konfigurierbar.
Aber Sie müssen sich fragen, Bedeutet das nicht, dass wir zu viel Speicherplatz verwenden? Zum Beispiel, wenn wir haben 5 Blöcke von 128 MB jeweils, das entspricht 5 * 128 * 3 = 1920 MB. Wahr. Aber diese Knoten sind Standard-Hardware. Wir können den Cluster problemlos skalieren, um weitere dieser Maschinen hinzuzufügen. Die Kosten für den Kauf von Maschinen sind viel niedriger als die Kosten für den Verlust von Daten!
Jetzt, du musst dich fragen, Wie entscheidet der Namenode, auf welchem Datanode die Replikate gespeichert werden sollen? Gut, Bevor wir diese Frage beantworten, müssen wir einen Blick darauf werfen, was ein Rack in Hadoop ist.
Was ist ein Rack in Hadoop?
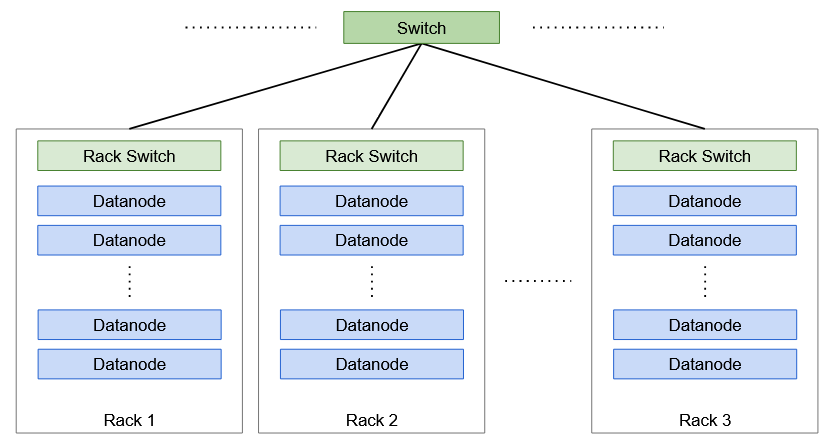
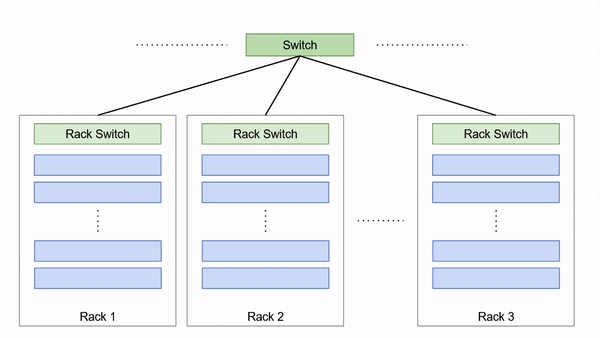
EIN Regal ist eine Sammlung von Maschinen (30-40 in Hadoop) die am selben physischen Standort gespeichert sind. Es gibt mehrere Racks in einem Hadoop-Cluster, alle verbunden über Switches.
Rack-Bewusstsein
Die Replikatspeicherung ist ein Kompromiss zwischen Zuverlässigkeit und Lese-Bandbreite / Schreiben. Um die Zuverlässigkeit zu erhöhen, müssen wir Replikate von Blöcken auf verschiedenen Racks und Datanodes speichern, um die Fehlertoleranz zu erhöhen. Während die Schreibbandbreite geringer ist, wenn die Replikate auf demselben Knoten gespeichert werden. Deswegen, hat Hadoop eine Standardstrategie, um mit diesem Dilemma umzugehen, auch bekannt als Rack-Bewusstsein Algorithmus.
Zum Beispiel, wenn der Replikationsfaktor eines Blocks 3, das erste Replikat auf demselben Datanode gespeichert wird, auf dem der Client schreibt. Das zweite Replikat wird auf einem anderen Datanode, aber in einem anderen Rack gespeichert, zufällig ausgewählt. Während das dritte Replikat im selben Rack wie das zweite, aber auf einem anderen Datanode gespeichert wird, wieder zufällig gewählt. Aber trotzdem, wenn der Replikationsfaktor größer wäre, würden die folgenden Replikate auf zufälligen Datenknoten im Cluster gespeichert.
Abschließende Anmerkungen
Ich hoffe, Sie haben bereits ein solides Verständnis davon, was das verteilte Dateisystem von Hadoop ist (HDFS), welche wichtigen Komponenten es hat und wie es Daten speichert. Aber trotzdem, es gibt noch einige Konzepte, die wir in Bezug auf das verteilte Dateisystem von Hadoop behandeln müssen (HDFS), aber das ist eine Geschichte für einen anderen Artikel.
Zur Zeit, ich empfehle Ihnen, die folgenden Artikel zu lesen, um Hadoop und diese Welt von Big Data besser zu verstehen.
Schließlich, aber nicht weniger wichtig, ich empfehle zu lesen Hadoop: Tom Whites ultimativer Leitfaden. Dieser Artikel wurde stark davon inspiriert.





