
Dieser Artikel wurde im Rahmen der Data Science Blogathon
Einführung
. Un problema de regresión es cuando la VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... de salida es un valor real o continuo.
- Was ist eine Regression??
- Regressionstypen.
- Was ist der Mittelwert der linearen Regression und die Bedeutung der linearen Regression??
- Importancia de la función de costo y el descenso del SteigungGradient ist ein Begriff, der in verschiedenen Bereichen verwendet wird, wie Mathematik und Informatik, um eine kontinuierliche Variation von Werten zu beschreiben. In Mathematik, bezieht sich auf die Änderungsrate einer Funktion, während des Studiums im Grafikdesign, Gilt für den Farbübergang. Dieses Konzept ist unerlässlich, um Phänomene wie die Optimierung von Algorithmen und die visuelle Darstellung von Daten zu verstehen, ermöglicht eine bessere Interpretation und Analyse in... en una regresión lineal.
- Einfluss verschiedener Werte auf die Lernrate.
- Implementieren Sie den Anwendungsfall der linearen Regression mit Python-Code.
Was ist eine Regression??
Im Rückschritt, Wir zeichnen einen Graphen zwischen den Variablen, die am besten zu den gegebenen Datenpunkten passen. Modell für maschinelles Lernen kann Vorhersagen zu Daten liefern. En palabras liberal, „Die Regression zeigt eine Linie oder Kurve an, die durch alle Datenpunkte in einem Zielvorhersagediagramm so verläuft, dass der vertikale Abstand zwischen den Datenpunkten und der Regressionslinie minimal ist“. Es wird hauptsächlich verwendet, um vorherzusagen, Vorhersagen, modellieren Sie Zeitreihen und bestimmen Sie die Kausal-Wirkungs-Beziehung zwischen Variablen.
Arten von Regressionsmodellen
- Lineare Regression
- Polynomialregression
- Logistische Regression
Lineare Regression
Die lineare Regression ist eine einfache und stille statistische Regressionsmethode, die für die prädiktive Analyse verwendet wird und die Beziehung zwischen kontinuierlichen Variablen zeigt. Die lineare Regression zeigt die lineare Beziehung zwischen der unabhängigen Variablen (X-Achse) und die abhängige Variable (Achse y), folglich als lineare Regression bezeichnet. Wenn es eine einzige Eingabevariable gibt (x), besagte lineare Regression heißt Einfache lineare Regression. Und wenn es mehr als eine Eingabevariable gibt, besagte lineare Regression heißt multiple lineare Regression. Das lineare Regressionsmodell liefert eine schräge Gerade, die die Beziehung innerhalb der Variablen beschreibt.
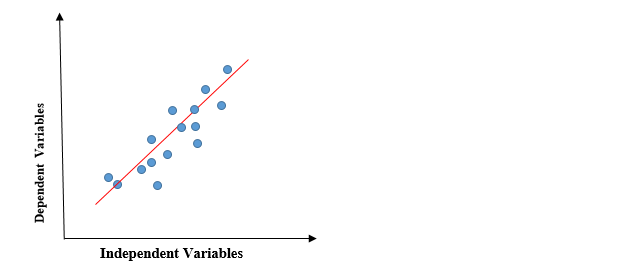
Die vorherige Grafik zeigt die lineare Beziehung zwischen der abhängigen Variablen und den unabhängigen Variablen. Wenn der Wert von x (unabhängige Variable) steigt, der Wert von y (abhängige Variable) nimmt auch zu. Die rote Linie ist als gerade Linie der besten Anpassung bekannt.. Basierend auf den angegebenen Datenpunkten, wir versuchen eine Linie zu zeichnen, die die Punkte besser modelliert.
So berechnen Sie die lineare Regression der Linie der besten Anpassung, es wird eine traditionelle Steigungsabschnittsform verwendet.
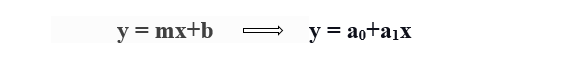
y = Abhängige Variable.
x = unabhängige Variable.
a0 = Schnittpunkt der Geraden.
a1 = Koeffizient der linearen Regression.
Notwendigkeit einer linearen Regression
Wie bereits erwähnt, lineare Regression schätzt die Beziehung zwischen einer abhängigen Variablen und einer unabhängigen Variablen. Lass uns das an einem einfachen Beispiel verstehen:
Nehmen wir an, wir möchten das Gehalt eines Mitarbeiters basierend auf dem Jahr der Erfahrung schätzen. Sie haben die aktuellen Daten des Unternehmens, was darauf hinweist, dass der Zusammenhang zwischen Erfahrung und Gehalt. Dabei ist das Erfahrungsjahr eine unabhängige Variable und das Gehalt eines Mitarbeiters eine abhängige Variable., da das Gehalt eines Mitarbeiters von der Erfahrung eines Mitarbeiters abhängt. Mit diesen Informationen, wir können das zukünftige Gehalt des Mitarbeiters basierend auf aktuellen und vergangenen Informationen vorhersagen.
Eine Regressionsgerade kann eine positive lineare Beziehung oder eine negative lineare Beziehung sein.
Positive lineare Beziehung
Wenn sich die abhängige Variable auf der Y-Achse und die unabhängige Variable auf der X-Achse ausdehnt, diese Beziehung wird als positive lineare Beziehung bezeichnet.
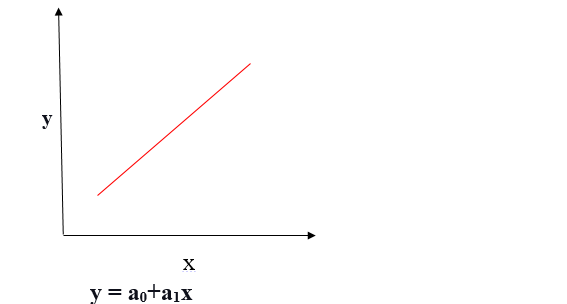
Negative lineare Beziehung
Wenn die abhängige Variable auf der Y-Achse abnimmt und die unabhängige Variable auf der X-Achse zunimmt, diese Beziehung wird als negative lineare Beziehung bezeichnet.
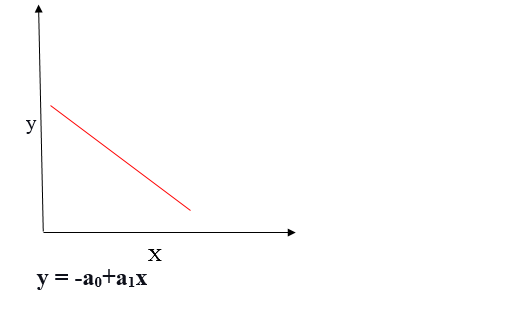
Das Ziel des linearen Regressionsalgorithmus ist es, die besten Werte für a0 und a1 zu erhalten, um die Linie der besten Anpassung zu finden. Die Linie mit der besten Anpassung sollte den geringsten Fehler aufweisen, was bedeutet, dass der Fehler zwischen den prognostizierten Werten und den tatsächlichen Werten minimiert werden sollte.
Kostenfunktion
Die Kostenfunktion hilft bei der Ermittlung der bestmöglichen Werte für a0 und a1, die die beste Anpassungslinie für die Datenpunkte liefert.
Die Kostenfunktion optimiert die Regressionskoeffizienten oder Gewichte und misst die Leistung eines linearen Regressionsmodells. Die Kostenfunktion wird verwendet, um die Genauigkeit der Mapping-Funktion die die Eingabevariable auf die Ausgabevariable abbildet. Diese Abbildungsfunktion ist auch bekannt als die Hypothesenfunktion.
In linearer Regression, Quadratischer Fehler (MSE) Die Kostenfunktion wird verwendet, das ist der Durchschnitt des quadrierten Fehlers, der zwischen den vorhergesagten Werten und den tatsächlichen Werten aufgetreten ist.
Durch einfache lineare Gleichung y = mx + b können wir MSE berechnen als:
Seien wir y = reelle Werte, Jaich = vorhergesagte Werte
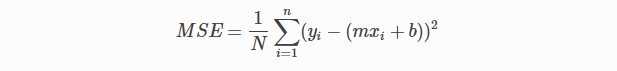
Verwenden der MSE-Funktion, wir werden die Werte von a0 und a1 so ändern, dass der MSE-Wert auf das Minimum gesetzt wird. ParameterDas "Parameter" sind Variablen oder Kriterien, die zur Definition von, ein Phänomen oder System zu messen oder zu bewerten. In verschiedenen Bereichen wie z.B. Statistik, Informatik und naturwissenschaftliche Forschung, Parameter sind entscheidend für die Etablierung von Normen und Standards, die die Datenanalyse und -interpretation leiten. Ihre richtige Auswahl und Handhabung sind entscheidend, um genaue und relevante Ergebnisse in jeder Studie oder jedem Projekt zu erhalten.... des Modells xi, B (ein0,ein1) kann manipuliert werden, um die Kostenfunktion zu minimieren. Diese Parameter können mit der Gradientenabstiegsmethode bestimmt werden, sodass der Wert der Kostenfunktion minimal ist.
Gradientenabstieg
Gradientenabstieg ist eine Methode zum Aktualisieren von a0 und a1, um die Kostenfunktion zu minimieren (MSE). Ein Regressionsmodell verwendet Gradientenabstieg, um die Koeffizienten der Linie zu aktualisieren (a0, a1 => xi, B) durch Reduzieren der Kostenfunktion unter Verwendung einer zufälligen Auswahl von Koeffizientenwerten und anschließendes iteratives Aktualisieren der Werte, um die minimale Kostenfunktion zu erreichen.
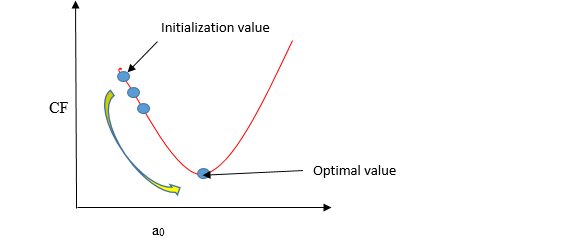
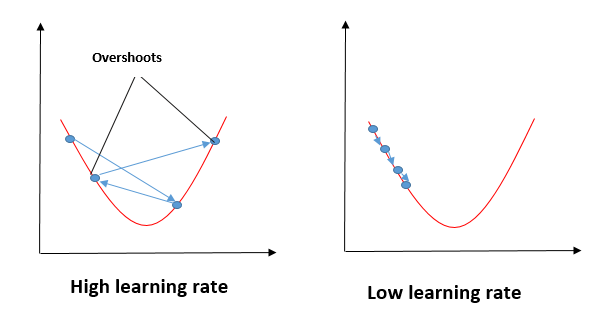
Stellen Sie sich einen U-förmigen Brunnen vor. Du stehst am höchsten Punkt des Brunnens und dein Ziel ist es, den Boden des Brunnens zu erreichen. Es gibt einen Schatz, und du kannst nur eine diskrete Anzahl von Schritten machen, um auf den Grund zu kommen. Wenn Sie sich entscheiden, einen Schritt nach dem anderen zu machen, Du wirst irgendwann den Grund des Brunnens erreichen, aber das dauert länger. Wenn Sie jedes Mal längere Schritte machen möchten, kann früher ankommen, Es besteht jedoch die Möglichkeit, dass es über den Boden des Brunnens geht und nicht in die Nähe des Bodens. Im Gradientenabstiegsalgorithmus, Die Anzahl der Schritte, die Sie machen, ist die Lernrate, und dies entscheidet, wie schnell der Algorithmus gegen die Minima konvergiert.
Aktualisieren0 und ein1, wir nehmen Gradienten aus der Kostenfunktion. Um diese Steigungen zu finden, wir nehmen partielle Ableitungen für a0 und ein1.
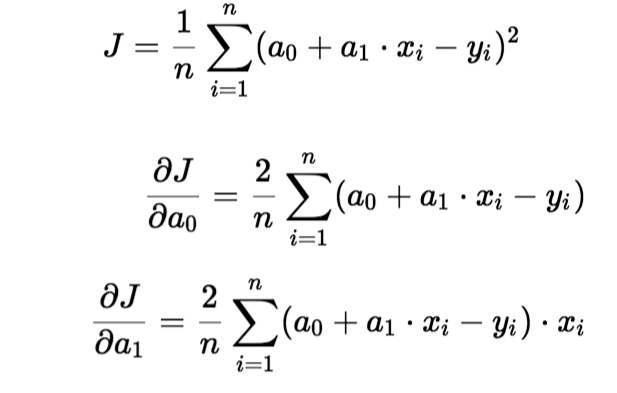
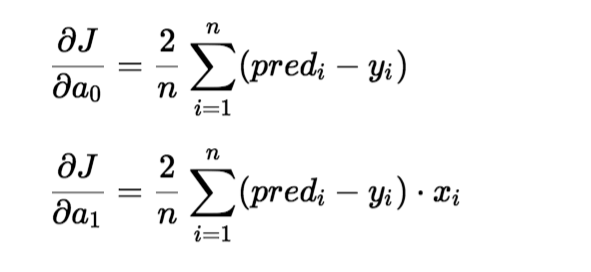
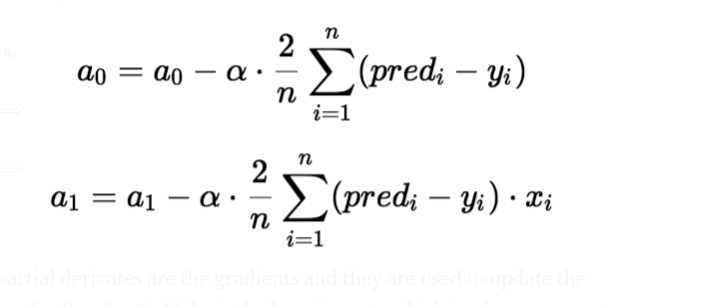
Die partiellen Ableitungen sind die Gradienten und werden verwendet, um die Werte von a . zu aktualisieren0 und ein1. Alpha ist die Lernrate.
Einfluss verschiedener Werte auf die Lernrate
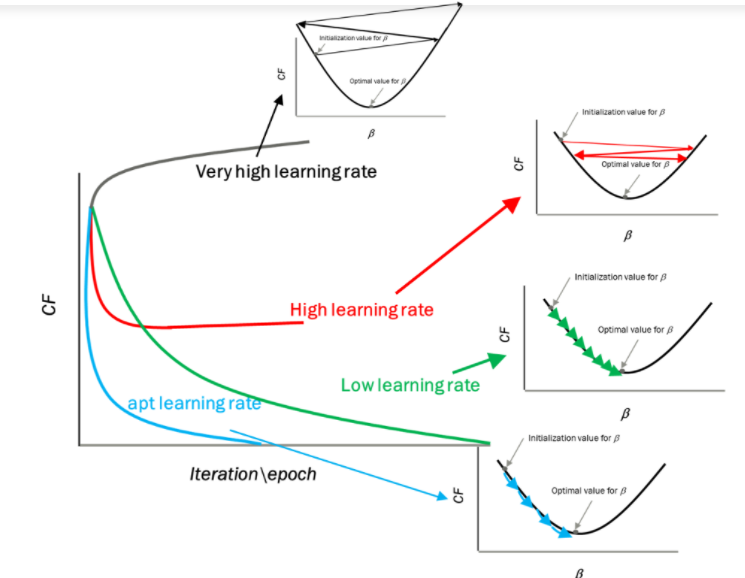
Quelle: mygreatleaning.com
Die blaue Linie stellt den optimalen Wert der Lernrate dar und der Wert der Kostenfunktion wird in wenigen Iterationen minimiert. Die grüne Linie zeigt an, ob die Lernrate unter dem optimalen Wert liegt, dann ist die Anzahl der erforderlichen Iterationen hoch, um die Kostenfunktion zu minimieren. Wenn die gewählte Lernrate sehr hoch ist, die Kostenfunktion könnte mit Iterationen weiter ansteigen und auf einen Wert über dem Mindestwert sättigen, der durch eine rote und schwarze Linie dargestellte.
Anwendungsfall
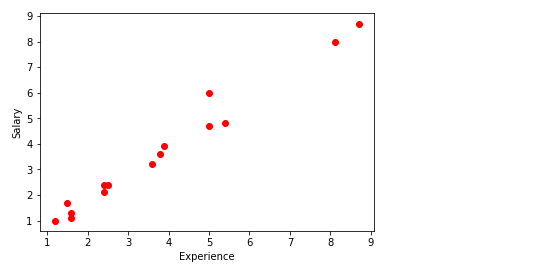
In diesem, Ich nehme Zufallszahlen für die abhängige Variable (Gehalt) und eine unabhängige Variable (Erfahrung) und ich werde vorhersagen, wie sich ein Jahr Erfahrung auf das Gehalt auswirkt.
Schritte zur Implementierung des linearen Regressionsmodells
einige erforderliche Bibliotheken importieren
import matplotlib.pyplot als plt
Pandas als pd importieren
numpy als np importieren
Definieren Sie den Datensatz
x= np.array([2.4,5.0,1.5,3.8,8.7,3.6,1.2,8.1,2.5,5,1.6,1.6,2.4,3.9,5.4])
y = np.array([2.1,4.7,1.7,3.6,8.7,3.2,1.0,8.0,2.4,6,1.1,1.3,2.4,3.9,4.8])
n = np.Größe(x)
Plotten Sie die Datenpunkte
plt.streuung(Erfahrung,Gehalt, Farbe="rot")
plt.xlabel("Erfahrung")
plt.ylabel("Gehalt")
plt.zeigen()
Die Hauptfunktion zur Berechnung von Koeffizientenwerten.
- Parameter initialisieren.
- Sagen Sie den Wert einer abhängigen Variablen bei einer gegebenen unabhängigen Variablen voraus.
- Berechnen Sie den Fehler in der Vorhersage für alle Datenpunkte.
- Berechnen Sie die partielle Ableitung bzgl. a0 und a1.
- Berechnen Sie die Kosten jeder Zahl und addieren Sie sie.
- Aktualisieren Sie die Werte von a0 und a1.
#Parameter initialisieren
a0 = 0                  #abfangen
a1 = 0                  #Steigung
lr = 0.0001             #Lernrate
Iterationen = 1000       # Anzahl der Iterationen
Fehler = []              # Fehlerarray zur Berechnung der Kosten für jede Iteration.
für itr in Reichweite(Iterationen):
    error_cost = 0
    cost_a0 = 0
    cost_a1 = 0
    für mich in Reichweite(len(Erfahrung)):
        y_pred = a0+a1*Erfahrung[ich]   # Vorhersagewert für gegebenes x
        error_cost = error_cost +(Gehalt[ich]-y_pred)**2
        für j im Bereich(len(Erfahrung)):
            partiell_wrt_a0 = -2 *(Gehalt[J] - (a0 + a1*Erfahrung[J]))                #partielle Ableitung bzgl. a0
            partiell_wrt_a1 = (-2*Erfahrung[J])*(Gehalt[J]-(a0 + a1*Erfahrung[J]))   #partielle Ableitung bzgl. a1
            Kosten_a0 = Kosten_a0 + partial_wrt_a0 #berechnen Sie die Kosten für jede Zahl und fügen Sie hinzu
            Kosten_a1 = Kosten_a1 + partial_wrt_a1 #Berechnen Sie die Kosten für jede Zahl und fügen Sie hinzu
        a0 = a0 - lr * cost_a0 #update a0
        a1 = a1 - lr * cost_a1 #update a1
        drucken(itr,a0, a1)          #Überprüfen Sie die Iteration und aktualisieren Sie a0 und a1
    error.append(error_cost)      #Hängen Sie die Daten im Array an
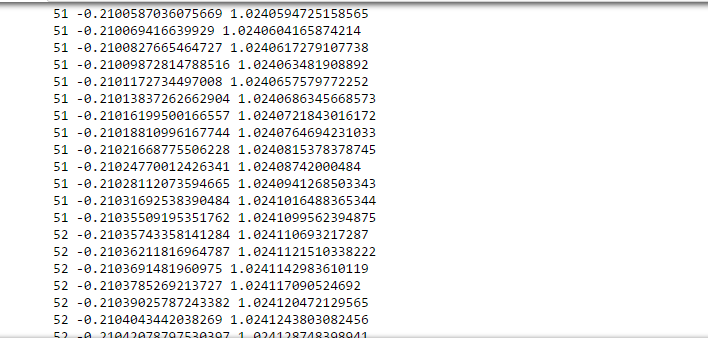
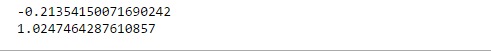
In einer groben Iteration von 50-60, wir haben den Wert von a0 und a1 . erhalten.
drucken(a0)
drucken(a1)
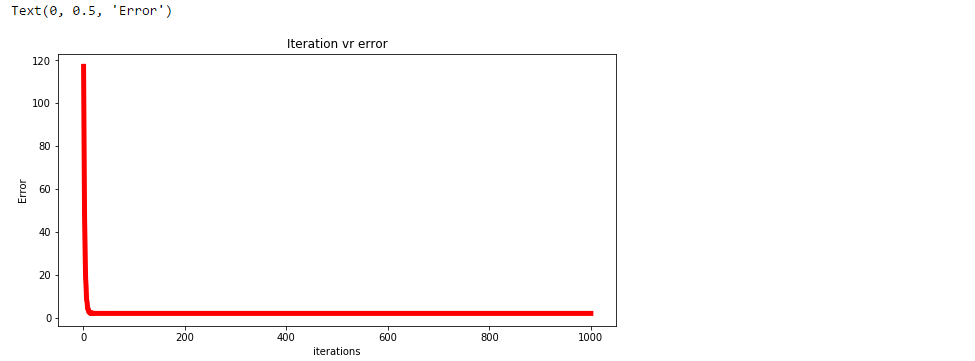
Plotten Sie den Fehler für jede Iteration.
plt.figur(Feigengröße=(10,5))
plt.plot(np.arange(1,len(Error)+1),Error,Farbe="rot",Linienbreite = 5)
plt.titel("Iterations-VR-Fehler")
plt.xlabel("Iterationen")
plt.ylabel("Fehler")
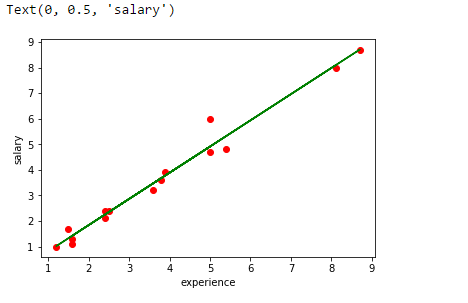
Werte vorhersagen.
pred = a0+a1*Erfahrung
drucken(pred)

Zeichnen Sie die Regressionsgerade.
plt.streuung(Erfahrung,Gehalt,Farbe="rot")
plt.plot(Erfahrung,pred, Farbe="Grün")
plt.xlabel("Erfahrung")
plt.ylabel("Gehalt")
Analysieren Sie die Leistung des Modells, indem Sie den quadratischen Mittelwert berechnen.
Fehler1 = Gehalt - pred
se = np.sum(Fehler1 ** 2)
mse = se/n
drucken("mittlerer quadratischer Fehler ist", mse)

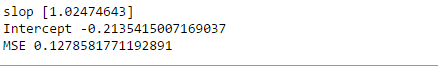
Verwenden Sie die scikit-Bibliothek, um die obigen Schritte zu bestätigen.
aus sklearn.linear_model import LinearRegression
aus sklearn.metrics import mean_squared_error
Erfahrung = Erfahrung.Umformung(-1,1)
Modell = LinearRegression()
model.fit(Erfahrung,Gehalt)
Gehalt_pred = model.predict(Erfahrung)
Mse = mean_squared_error(Gehalt, Gehalt_pred)
drucken('slop', model.coef_)
drucken("Abfangen", model.intercept_)
drucken("MSE", Frau)
Zusammenfassung
Im Rückschritt, Wir zeichnen einen Graphen zwischen den Variablen, die am besten zu den gegebenen Datenpunkten passen. Die lineare Regression zeigt die lineare Beziehung zwischen der unabhängigen Variablen (X-Achse) und die abhängige Variable (Achse y).So berechnen Sie die lineare Regression der Linie der besten Anpassung, es wird eine traditionelle Steigungsabschnittsform verwendet. Eine Regressionsgerade kann eine positive lineare Beziehung oder eine negative lineare Beziehung sein.
Das Ziel des linearen Regressionsalgorithmus ist es, die besten Werte für a0 und a1 zu erhalten, um die Linie der besten Anpassung zu finden, und die Linie der besten Anpassung muss den kleinsten Fehler haben. In linearer Regression, Quadratischer Fehler (MSE) die Kostenfunktion wird verwendet, das hilft bei der Ermittlung der bestmöglichen Werte für a0 und a1, die die beste Anpassungslinie für die Datenpunkte liefert. Verwenden der MSE-Funktion, wir werden die Werte von a0 und a1 so ändern, dass der MSE-Wert auf das Minimum gesetzt wird. Gradientenabstieg ist eine Methode zum Aktualisieren von a0 und a1, um die Kostenfunktion zu minimieren (MSE)
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





