
Verwirrung Matrix: Gar nicht so verwirrend!!
Waren Sie in einer Situation, in der Sie erwartet haben, dass Ihr Machine Learning-Modell wirklich gut funktioniert?, lieferte aber eine schlechte Genauigkeit? Sie haben die ganze harte Arbeit geleistet, dann, Wo ist das Klassifizierungsmodell schief gelaufen?? Wie können Sie das korrigieren??
Es gibt viele Alternativen, um die Leistung Ihres Ranking-Modells zu messen, Aber keiner hat den Test der Zeit als Matrix der Verwirrung bestanden.. Es hilft uns zu untersuchen, wie unser Modell funktioniert hat., Wo es schief gelaufen ist und bietet uns einen Wegweiser, um unseren Weg zu korrigieren.
In diesem Beitrag, Wir werden untersuchen, wie eine Konfusionsmatrix einen ganzheitlichen Überblick über die Leistung Ihres Modells bietet.. Und im Gegensatz zu seinem Namen, Sie werden feststellen, dass eine Verwirrungsmatrix ein ziemlich einfaches, aber mächtiges Konzept ist.. Lassen Sie uns also das Geheimnis um die Matrix der Verwirrung lüften!!
Erlernen der Grundlagen im Bereich des maschinellen Lernens? Diese Kurse werden Ihnen helfen, Ihren Weg zu gehen:
Hier ist, was wir behandeln werden:
- Was ist eine Konfusionsmatrix??
- Richtig positiv
- Richtig negativ
- Falsch positiv: Eingabefehler 1
- Falsch negativ – Eingabefehler 2
- Warum Sie eine Konfusionsmatrix brauchen?
- Genauigkeit vs. Wiederherstellung
- F1-Ergebnis
- Konfusionsmatrix in Scikit-learn
- Konfusionsmatrix für die Klassifizierung mehrerer Klassen
Was ist eine Konfusionsmatrix??
Die Millionen-Dollar-Frage: Was ist, schließlich, Eine Verwirrungsmatrix?
Eine Konfusionsmatrix ist eine N x N-Matrix, die verwendet wird, um die Leistung eines Klassifizierungsmodells zu untersuchen., wobei N die Anzahl der Zielklassen ist. Die Matrix vergleicht die tatsächlichen Sollwerte mit denen, die vom Machine-Learning-Modell vorhergesagt werden. Dies gibt uns einen ganzheitlichen Überblick darüber, wie gut unser Ranking-Modell funktioniert und welche Art von Fehlern es macht..
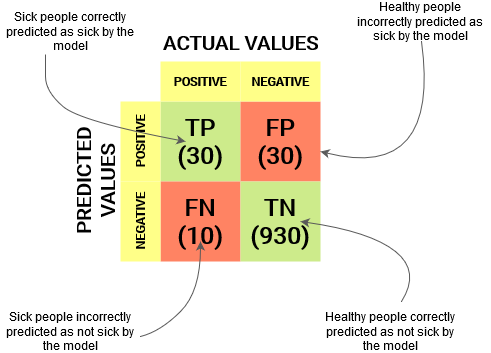
Für ein binäres Klassifizierungshindernis, Wir hätten eine Matrix von 2 x 2 wie unten gezeigt mit 4 Werte:
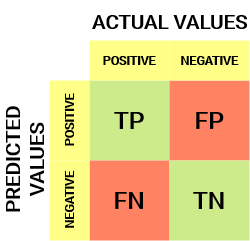
Lassen Sie uns die Matrix entschlüsseln:
- Das VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... Der Zielort hat zwei Werte: Positiv Ö Negativ
- das Säulen repräsentieren die aktuelle Werte der Zielvariablen
- das Reihen repräsentieren die vorhergesagte Werte der Zielvariablen
Aber warte, Was ist TP?, FP, FN und TN hier? Das ist der entscheidende Teil einer Verwirrungsmatrix.. Lassen Sie uns jeden Begriff unten verstehen.
Das wahre Positive verstehen, Das wahre Negativ, Das falsch positive und das falsch negative in einer Konfusionsmatrix
Richtig positiv (KLOPAPIER)
- Der vorhergesagte Wert stimmt mit dem tatsächlichen Wert überein
- Der tatsächliche Wert war positiv, und das Modell prognostizierte einen positiven Wert.
Richtig negativ (TN)
- Der vorhergesagte Wert stimmt mit dem tatsächlichen Wert überein
- Der tatsächliche Wert war negativ und das Modell prognostizierte einen negativen Wert.
Falsch positiv (FP): Eingabefehler 1
- Der vorhergesagte Wert wurde falsch vorhergesagt
- Der tatsächliche Wert war negativ, aber das Modell sagte einen positiven Wert voraus
- Auch bekannt als Tippfehler 1
Falsch negativ (FN): Eingabefehler 2
- Der vorhergesagte Wert wurde falsch vorhergesagt
- Der tatsächliche Wert war positiv, aber das Modell prognostizierte einen negativen Wert
- Auch bekannt als Eingabefehler 2
Lassen Sie mich Ihnen ein Beispiel geben, um dies besser zu wissen. Angenommen, wir haben ein Klassifizierungsdataset mit 1000 Datenpunkte. Wir setzen einen Klassifikator darauf und erhalten die nächste Konfusionsmatrix:
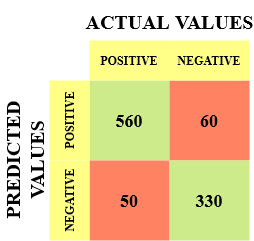
Die verschiedenen Werte der Konfusionsmatrix wären wie folgt::
- Richtig positiv (KLOPAPIER) = 560; was bedeutet, dass 560 Positive Klassendatenpunkte wurden vom Modell korrekt klassifiziert
- Richtig negativ (TN) = 330; was bedeutet, dass 330 Negative Klassendatenpunkte wurden vom Modell korrekt klassifiziert
- Falsch positiv (FP) = 60; was bedeutet, dass das Modell falsch klassifiziert wurde 60 Negative Klassendatenpunkte als zur positiven Klasse gehörend
- Falsch negativ (FN) = 50; was bedeutet, dass das Modell falsch klassifiziert wurde 50 Datenpunkte positiver Klasse, die zur negativen Klasse gehören
Dies erwies sich als ein ziemlich anständiger Klassifikator für unseren Datensatz, wenn man die relativ größere Anzahl positiver wahrer Werte und negativer wahrer Werte bedenkt..
Merken Sie sich Typfehler 1 und Typ 2. Interviewer lieben es, nach dem Unterschied zwischen diesen beiden zu fragen!! Auf all das können Sie sich mit unserem Online-Kurs für maschinelles Lernen
Warum wir eine Verwirrungsmatrix brauchen?
Bevor Sie diese Frage beantworten, Betrachten Sie eine hypothetische Klassifizierungshürde.
Angenommen, Sie möchten vorhersagen, wie viele Menschen mit einem ansteckenden Virus infiziert sind, bevor sie Symptome zeigen, und sie von der gesunden Bevölkerung isolieren. (Hört sich das noch etwas an?? 😷). Die beiden Werte unserer Zielvariablen wären: Krank und nicht krank.
Jetzt, du musst dich fragen: Warum brauchen wir eine Verwirrungsmatrix, wenn wir unseren Allwetterfreund haben?: Präzision? Gut, Mal sehen, wo die Genauigkeit versagt.
Unser Datensatz ist ein Beispiel für Unausgeglichener Datensatz. Es gibt 947 Datenpunkte für die negative Klasse und 3 Datenpunkte für die positive Klasse. So berechnen wir die Genauigkeit: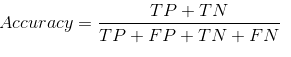
Sehen wir uns an, wie unser Modell funktioniert hat:
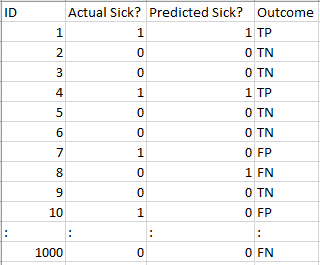
Die Gesamtwerte des Ergebnisses sind:
TP = 30, TN = 930, FP = 30, FN = 10
Dann, Die Genauigkeit unseres Modells erweist sich als:
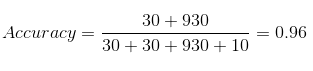
96%! Nicht schlecht!
Aber es vermittelt eine falsche Vorstellung vom Ergebnis.. Denken.
Unser Modell sagt „Ich kann kranke Menschen auf 96% Wetter“. Trotz dieses, tut das Gegenteil. Es sagt den Menschen voraus, dass sie nicht an einem krank werden 96% Präzision, während die Kranken das Virus verbreiten!
Glauben Sie, dass dies angesichts der Schwere des Problems eine korrekte Metrik für unser Modell ist?? Sollten wir nicht messen, wie viele positive Fälle wir richtig vorhersagen können, um die Ausbreitung des ansteckenden Virus zu stoppen?? Oder vielleicht, der korrekt vorhergesagten Fälle, Wie viele positive Fälle gibt es, um die Zuverlässigkeit unseres Modells zu überprüfen??
Hier finden wir das duale Konzept von Präzision und Rückruf..
Genauigkeit vs. Wiederherstellung
Die Genauigkeit gibt Aufschluss darüber, wie viele der richtig vorhergesagten Fälle wirklich positiv ausgefallen sind..
Dann, Erläutert das Berechnen der Genauigkeit:
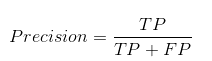
Dies würde darüber entscheiden, ob unser Modell zuverlässig ist oder nicht..
Der Rückruf sagt uns, wie viele der tatsächlich positiven Fälle wir mit unserem Modell richtig vorhersagen konnten.
Und so können wir den Rückruf berechnen:
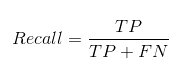
Wir können Precision und Recall für unser Modell leicht berechnen, indem wir die Werte in den obigen Fragen verbinden.:
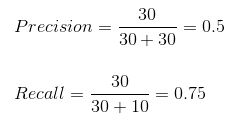
Das 50% der korrekt vorhergesagten Fälle erwiesen sich als positive Fälle. Während unser Modell erfolgreich die 75% der positiven Aspekte. Beeindruckend!
Die Genauigkeit ist eine nützliche Kennzahl in Fällen, in denen falsch positive Ergebnisse ein größeres Problem darstellen als falsch negative Ergebnisse.
Genauigkeit ist bei Musik- oder Videoempfehlungssystemen von entscheidender Bedeutung, E-Commerce-Websites, etc. Falsche Ergebnisse können zu Kundenverlusten führen und dem Unternehmen schaden.
Die Wiederherstellung ist eine nützliche Metrik in Fällen, in denen das falsch negative Ergebnis das falsch positive übertrumpft.
Der Rückruf ist in medizinischen Fällen unerlässlich, in denen es keine Rolle spielt, ob wir einen Fehlalarm auslösen., Aber echte positive Fälle sollten nicht unbemerkt bleiben!!
In unserem Beispiel, Ein Rückruf wäre eine bessere Kennzahl, da wir nicht versehentlich eine infizierte Person entlassen und sie mit der gesunden Bevölkerung vermischen und so das ansteckende Virus verbreiten wollen.. Jetzt können Sie verstehen, warum Genauigkeit eine schlechte Metrik für unser Modell war..
Es wird jedoch Fälle geben, in denen es keine klare Unterscheidung gibt, ob die Genauigkeit wichtiger ist oder ob die Wiederherstellung wichtiger ist.. Was ist in solchen Fällen zu tun?? Wir kombinieren sie!
F1-Ergebnis
In der Praxis, Wenn wir versuchen, die Genauigkeit unseres Modells zu erhöhen, Die Erholung verlangsamt sich und umgekehrt. Der F1-Score fasst beide Trends in einem Wert zusammen:
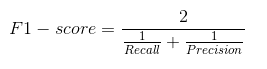
Der F1-Wert ist ein harmonisches Mittel für Genauigkeit und Erholung, Es gibt also eine kombinierte Vorstellung von diesen beiden Metriken. Maximal, wenn "Präzision" gleich "Rückruf" ist.
Aber hier gibt es einen Haken.. Die Interpretierbarkeit des F1-Scores ist schlecht. Das bedeutet, dass wir nicht wissen, was unser Klassifikator maximiert.: Genauigkeit oder Rückruf? Dann, Wir verwenden es in Kombination mit anderen Bewertungsmetriken, die uns ein vollständiges Bild des Ergebnisses geben.
Konfusionsmatrix mit scikit-learn in Python
Sie kennen die Theorie bereits, Lassen Sie es uns nun in die Praxis umsetzen. Lassen Sie uns eine Konfusionsmatrix mit der Scikit-learn-Bibliothek codieren (sklearn) und Python.
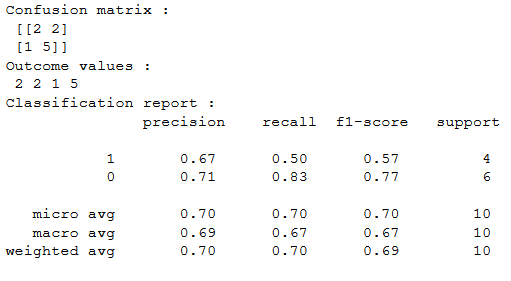
Sklearn hat zwei großartige Funktionen: Verwirrung Matrix() Ja Klassifizierungsbericht ().
- Sklearn Verwirrung Matrix() Gibt die Werte der Konfusionsmatrix zurück. Trotz dieses, Das Ergebnis unterscheidet sich geringfügig von dem, was wir bisher untersucht haben.. Akzeptiert Zeilen als tatsächliche Werte und Spalten als vorhergesagte Werte. Der Rest des Konzepts bleibt gleich.
- Sklearn Klassifizierungsbericht () Erzeugt Genauigkeit, Erholung und F1-Score für jede Zielklasse. Gleichzeitig damit, Es hat auch einige zusätzliche Werte: Mikro-Durchschnitt, Makro-Durchschnitt, Ja gewichteter Durchschnitt
Durchschnittlicher Mirco ist die Präzision / Erholung / F1-Punktzahl für alle Klassen berechnet.
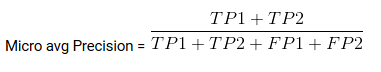
Medien-Makro ist die durchschnittliche Genauigkeit / Ich erinnere mich / F1-Ergebnis.
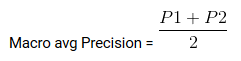
Durchschnittliches Gewicht ist nur der gewichtete Durchschnitt der Genauigkeit / Erholung / F1-Ergebnis.
Konfusionsmatrix für die Klassifizierung mehrerer Klassen
Wie würde eine Konfusionsmatrix für ein Klassifizierungshindernis mit mehreren Klassen funktionieren?? Gut, Kratzen Sie sich nicht am Kopf!! Wir schauen uns das hier an.
Lassen Sie uns eine Verwirrungsmatrix für ein Multi-Klassen-Hindernis zeichnen, bei dem wir vorhersagen müssen, ob eine Person Facebook liebt., Instagram oder Snapchat. Die Konfusionsmatrix wäre eine Matrix von 3 x 3 wie gehts:
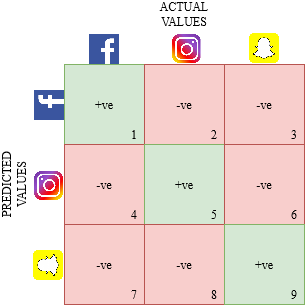
Das wirklich Positive, richtig negativ, Falsch positiv und falsch negativ jeder Klasse werden berechnet, indem die Zellenwerte wie folgt addiert werden:
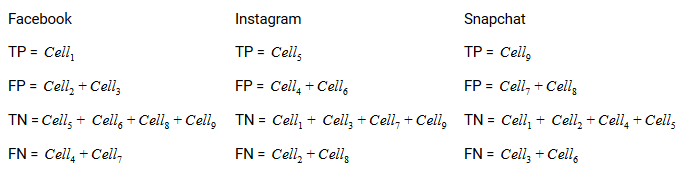
Das ist alles! Sie sind bereit, jede N x N-Verwirrungsmatrix zu entschlüsseln!!
Abschließende Anmerkungen
Und plötzlich!, Die Konfusionsmatrix ist nicht mehr so verwirrend! Dieser Beitrag sollte Ihnen eine solide Grundlage dafür geben, wie Sie eine Konfusionsmatrix für das Ranking von Algorithmen beim maschinellen Lernen interpretieren und verwenden können..
Demnächst werden wir einen Beitrag über die AUC-ROC-Kurve veröffentlichen und unsere Diskussion dort fortsetzen. Bis zum nächsten Mal, Verlieren Sie nicht die Hoffnung auf Ihr Klassifizierungsmodell, Möglicherweise verwenden Sie die falsche Bewertungsmetrik!!





